
主题
27B 大模型塞进 5.9GB:三值量化,凭什么「不崩」?
一张 11GB 显存的老显卡——2017 年的 GTX 1080 Ti——现在能跑 27B 的大模型,速度还有每秒 20 个 token。
不是玩笑。最近开源圈这个模型被反复讨论:Ternary Bonsai 2 27B。全部文件 5.93GB,不到同款全精度模型的九分之一,官方说能力保留了 98.2%。
它是怎么做到的?一句话:它把模型的权重,压成了三种值——-1、0、+1。
这篇讲两件事:这套「三值量化」为什么能 work(而不是像以往的极端量化那样,一压就崩);以及它现在真实的状态——包括我把它装到本机 DGX Spark 上的实测。
一、先把「三值」说明白
大模型里装着几百亿个「旋钮」(权重)。平时每个旋钮用 16 位浮点数记录——一个 27B 的模型,光权重就要 53.8GB 显存。
三值量化做的事:把每个旋钮的刻度,砍到只剩三档:-1、0、+1。
听起来很离谱,但算一笔账就明白动机:一个三值只有约 1.58 比特的信息量,算上缩放系数开销,平均约 1.76 比特。27B 参数这么一压,就是 5.9GB 级别(全精度要 53.8GB)。这就是「1/9 体积」的数学来源。
而且它还能看图:模型里带了一个 0.47B 的视觉塔,多模态能力一起压了进来。
「极端压缩」其实不新。BitNet 早在 2023 年就提出了三值训练。但过去的路线要么得从头重训一个大模型,要么压完就「变傻」——数学题做不动、长句子写不通。
这次不一样:PrismML(一个 Caltech 团队)是拿训练好的 Qwen3.8-27B 直接压。不是重新造一个脑子,是给现成的脑子做「极限瘦身」。
那么问题来了:直接压,为什么不会崩?
二、为什么能 work:三个关键设计
① 先「摊平」,再压缩
极端量化最大的敌人叫离群值:权重里有极少数数值特别大。三值化时,这些「尖峰」要么绑架整个量程,要么被直接削平——无论哪种,模型都会失真。
官方解法很巧:压缩之前,先给权重做一次 Hadamard 旋转。
想象一片崎岖的地形,直接铺三档台阶,怎么铺都不贴合;但如果先换一个角度看这片地(做一次正交变换),起伏就被均匀摊到所有方向上——地形变平了,再铺台阶就处处贴合。
而且这步是「无损」的:旋转只换了记账的坐标系,信息一点没丢;推理时做一个配套的快速变换就能转回去,计算量只有 O(n log n),比主计算小得多,几乎免费。
效果有多直接?有对照测试显示:同样 2-bit 级别的社区量化版(IQ2_XXS),数学题崩到 57.5 分;它做到了 95.8。
② 每 128 个权重,配一把自己的「尺子」
三值只保留了方向(正/负/零),具体幅度靠缩放系数还原。它的做法是:128 个权重编成一组,每组共用一个 FP16 缩放系数来还原幅度。
相当于全班只记「高/中/低」三档成绩,但按小组分别划线——不让个别大值绑架整个量程。最终平均位宽 1.76 比特/权重。
③ 自己写算子,直接在三值上算
如果每次推理都要先把三值「解压」回浮点数,那省下的显存和时间又还回去了。
所以官方给英伟达显卡和苹果芯片各写了一套定制内核,直接在打包格式上计算。这里有个坑我实测踩过:必须用官方 fork 的 llama.cpp——原版要么拒绝加载,要么更危险:静默加载、然后输出乱码。
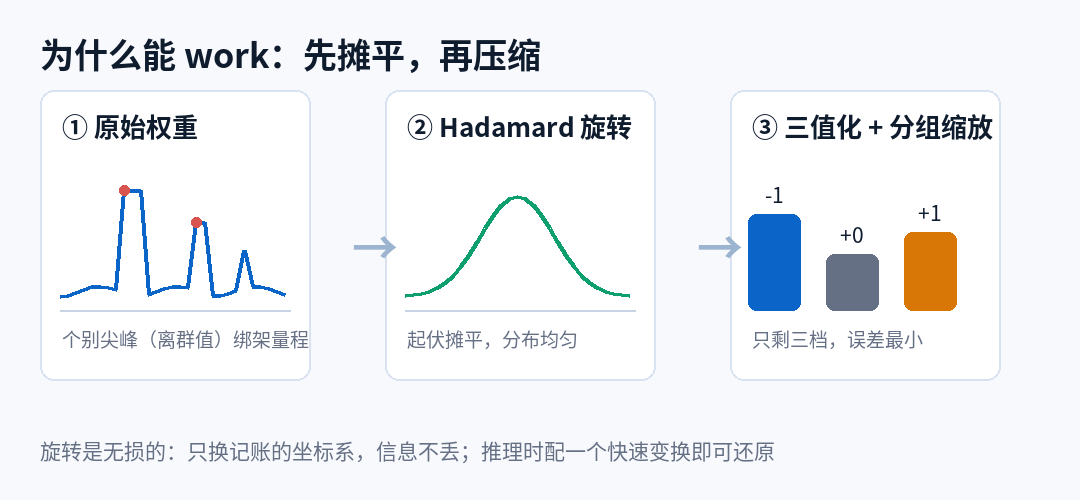
「先摊平、再压缩」:旋转把尖峰摊匀,三值化才不崩
三件事合起来:旋转保证「可量化」、分组缩放保证「精度」、定制内核保证「速度」。三值量化这才从论文状态,变成了能用的状态。
三、现状:能干什么,不能干什么
先说结论:能用,门槛低到意外。
模型已开源(Apache 2.0),ModelScope 和 HuggingFace 都能下载;两种 GGUF 档位(5.95GB / 7.21GB),llama.cpp、MLX、CUDA 三条路都能部署。
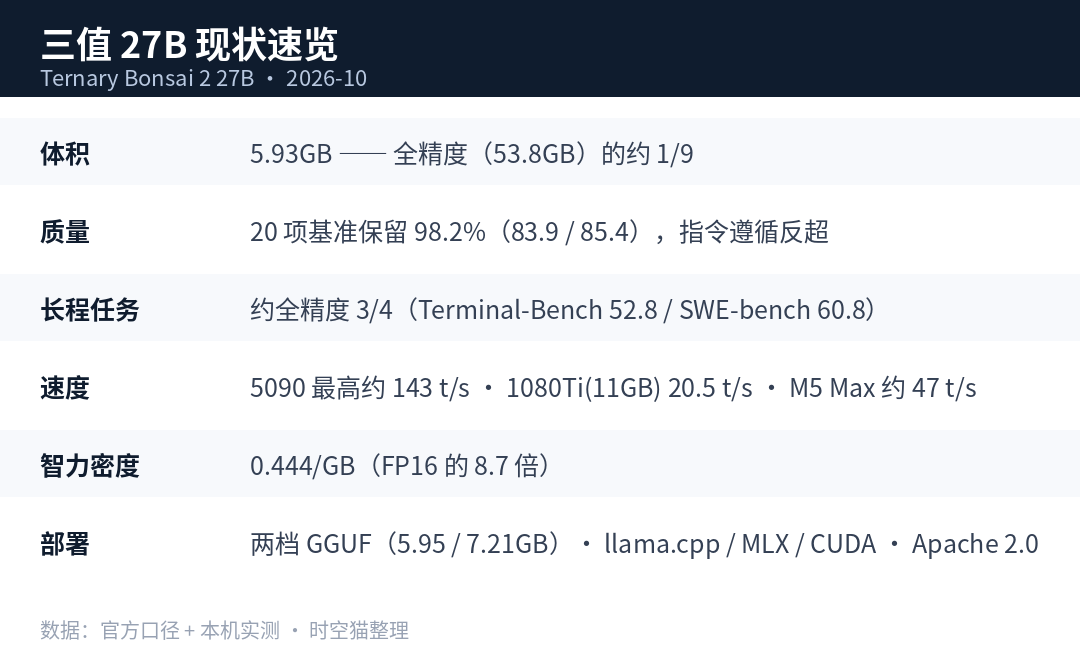
三值 27B 现状速览
质量上,官方 20 项基准平均 83.9 分,对全精度基线保留 98.2%——个别项目(指令遵循)甚至反超。官方还提了个新指标「智力密度」(把分数折算成错误率、再除以体积):它是 FP16 模型的 8.7 倍。
我的本机实测(DGX Spark):
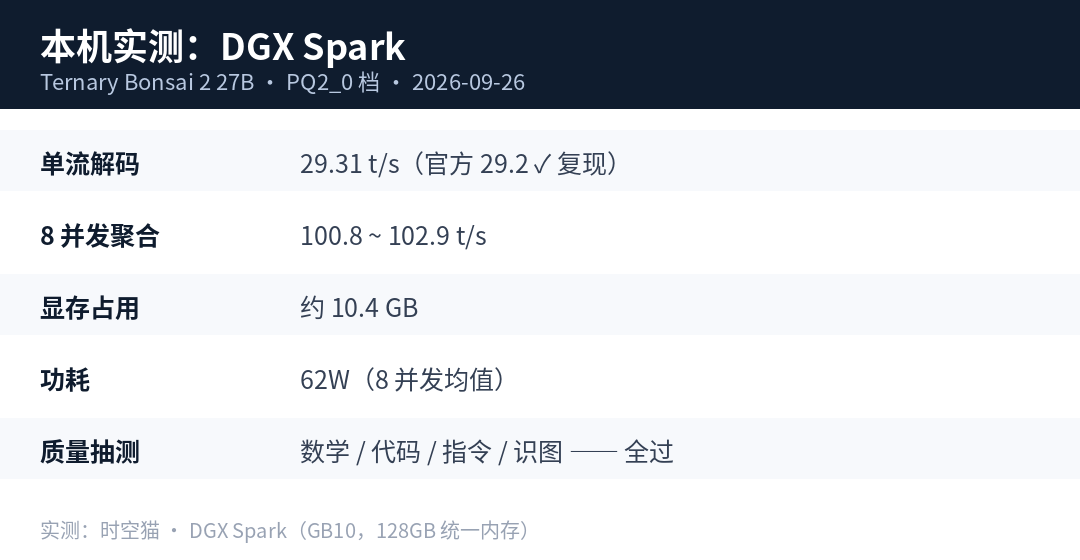
本机实测数据(2026-09-26)
- 单流解码 29.31 t/s,和官方公布的 29.2 几乎完全对上;
- 8 并发聚合 100.8~102.9 t/s——够一个小团队共用;
- 显存约 10.4GB、功耗 62W——可以 7×24 常驻;
- 抽测了数学计数、多线程代码、指令遵循、看图识物,全过。
速度全景:RTX 5090 最高约 143 t/s;11GB 的老卡 1080 Ti 跑 20.5 t/s;M5 Max 约 47 t/s。「27B 本地部署」的门槛,从「显存军备」变成了「压缩效率」。
但别只看 98.2%,短板要说清楚:
第一,长程任务会打折扣。 官方首次测了长链任务:Terminal-Bench 2.1 得 52.8(全精度 69.7)、SWE-bench Verified 60.8(全精度 80.6)——大约是全精度的四分之三。道理不复杂:单步的小误差会在长链条里累积,就像传话游戏——传一轮没事,传二十轮就变样。聊天、知识问答、单步任务没问题;把它当长链路 Agent 的「大脑」,还差一口气。
第二,有个小误会要纠正。 有文章说它配套 DSpark 投机采样、能提速 2.45 倍——我核实过官方仓库:那是上一代模型的能力,Bonsai 2 还没有官方 drafter。
第三,有个待解之谜。 官方没明说压缩过程是 PTQ(训练后量化)还是 QAT(量化感知训练)。这决定这套方法能不能「拿来就压」别的模型——如果纯训练后处理还能保住 98.2%,那意义会大得多。
四、我的判断
这件事最值得注意的,不是「又多了一个开源模型」,而是它标出了新赛道的路标:当 27B 能装进 11GB 的旧显卡,「本地跑大模型」的门槛定义就变了。
适合谁:显存有限、想在本机跑大模型的人;需要离线常驻、低功耗的场景。暂时不适合谁:指望它完全替代全精度模型、跑长链路任务的人。
我会盯三个观察点:Qwen 系会不会跟进三值化;PTQ/QAT 的归属;长程任务能否补齐。这些答案决定它是「一个漂亮的技术样本」,还是「本地部署的新默认选项」。
问答盒时间:如果我在本机拿它做实验,你最想看哪个?
- A:把它接进游戏,给 NPC 当「大脑」
- B:当一周代码助手,看它扛不扛得住真实工作
- C:和 4-bit 量化版做一次同题横评
评论区报字母,票最多的先做。
——
我是时空猫:一个人,一台 DGX Spark,整间公司就这些。 「把大模型装进小机器」是我最近在折腾的事:这个 27B 已经在本机跑着——29.31 t/s、10.4GB 显存、62W。 想看我拿它做什么实验,「问答盒」里说一声。
说明:官方基准与速度为官方口径(截至 2026-10-16);本机实测为我在 DGX Spark 上的记录(2026-09-26);三值量化仍在早期,数字建议以自测为准。
来源与说明
- 文中数字与结论均来自本机实测或公开披露;如与原文有出入,以本页为准。