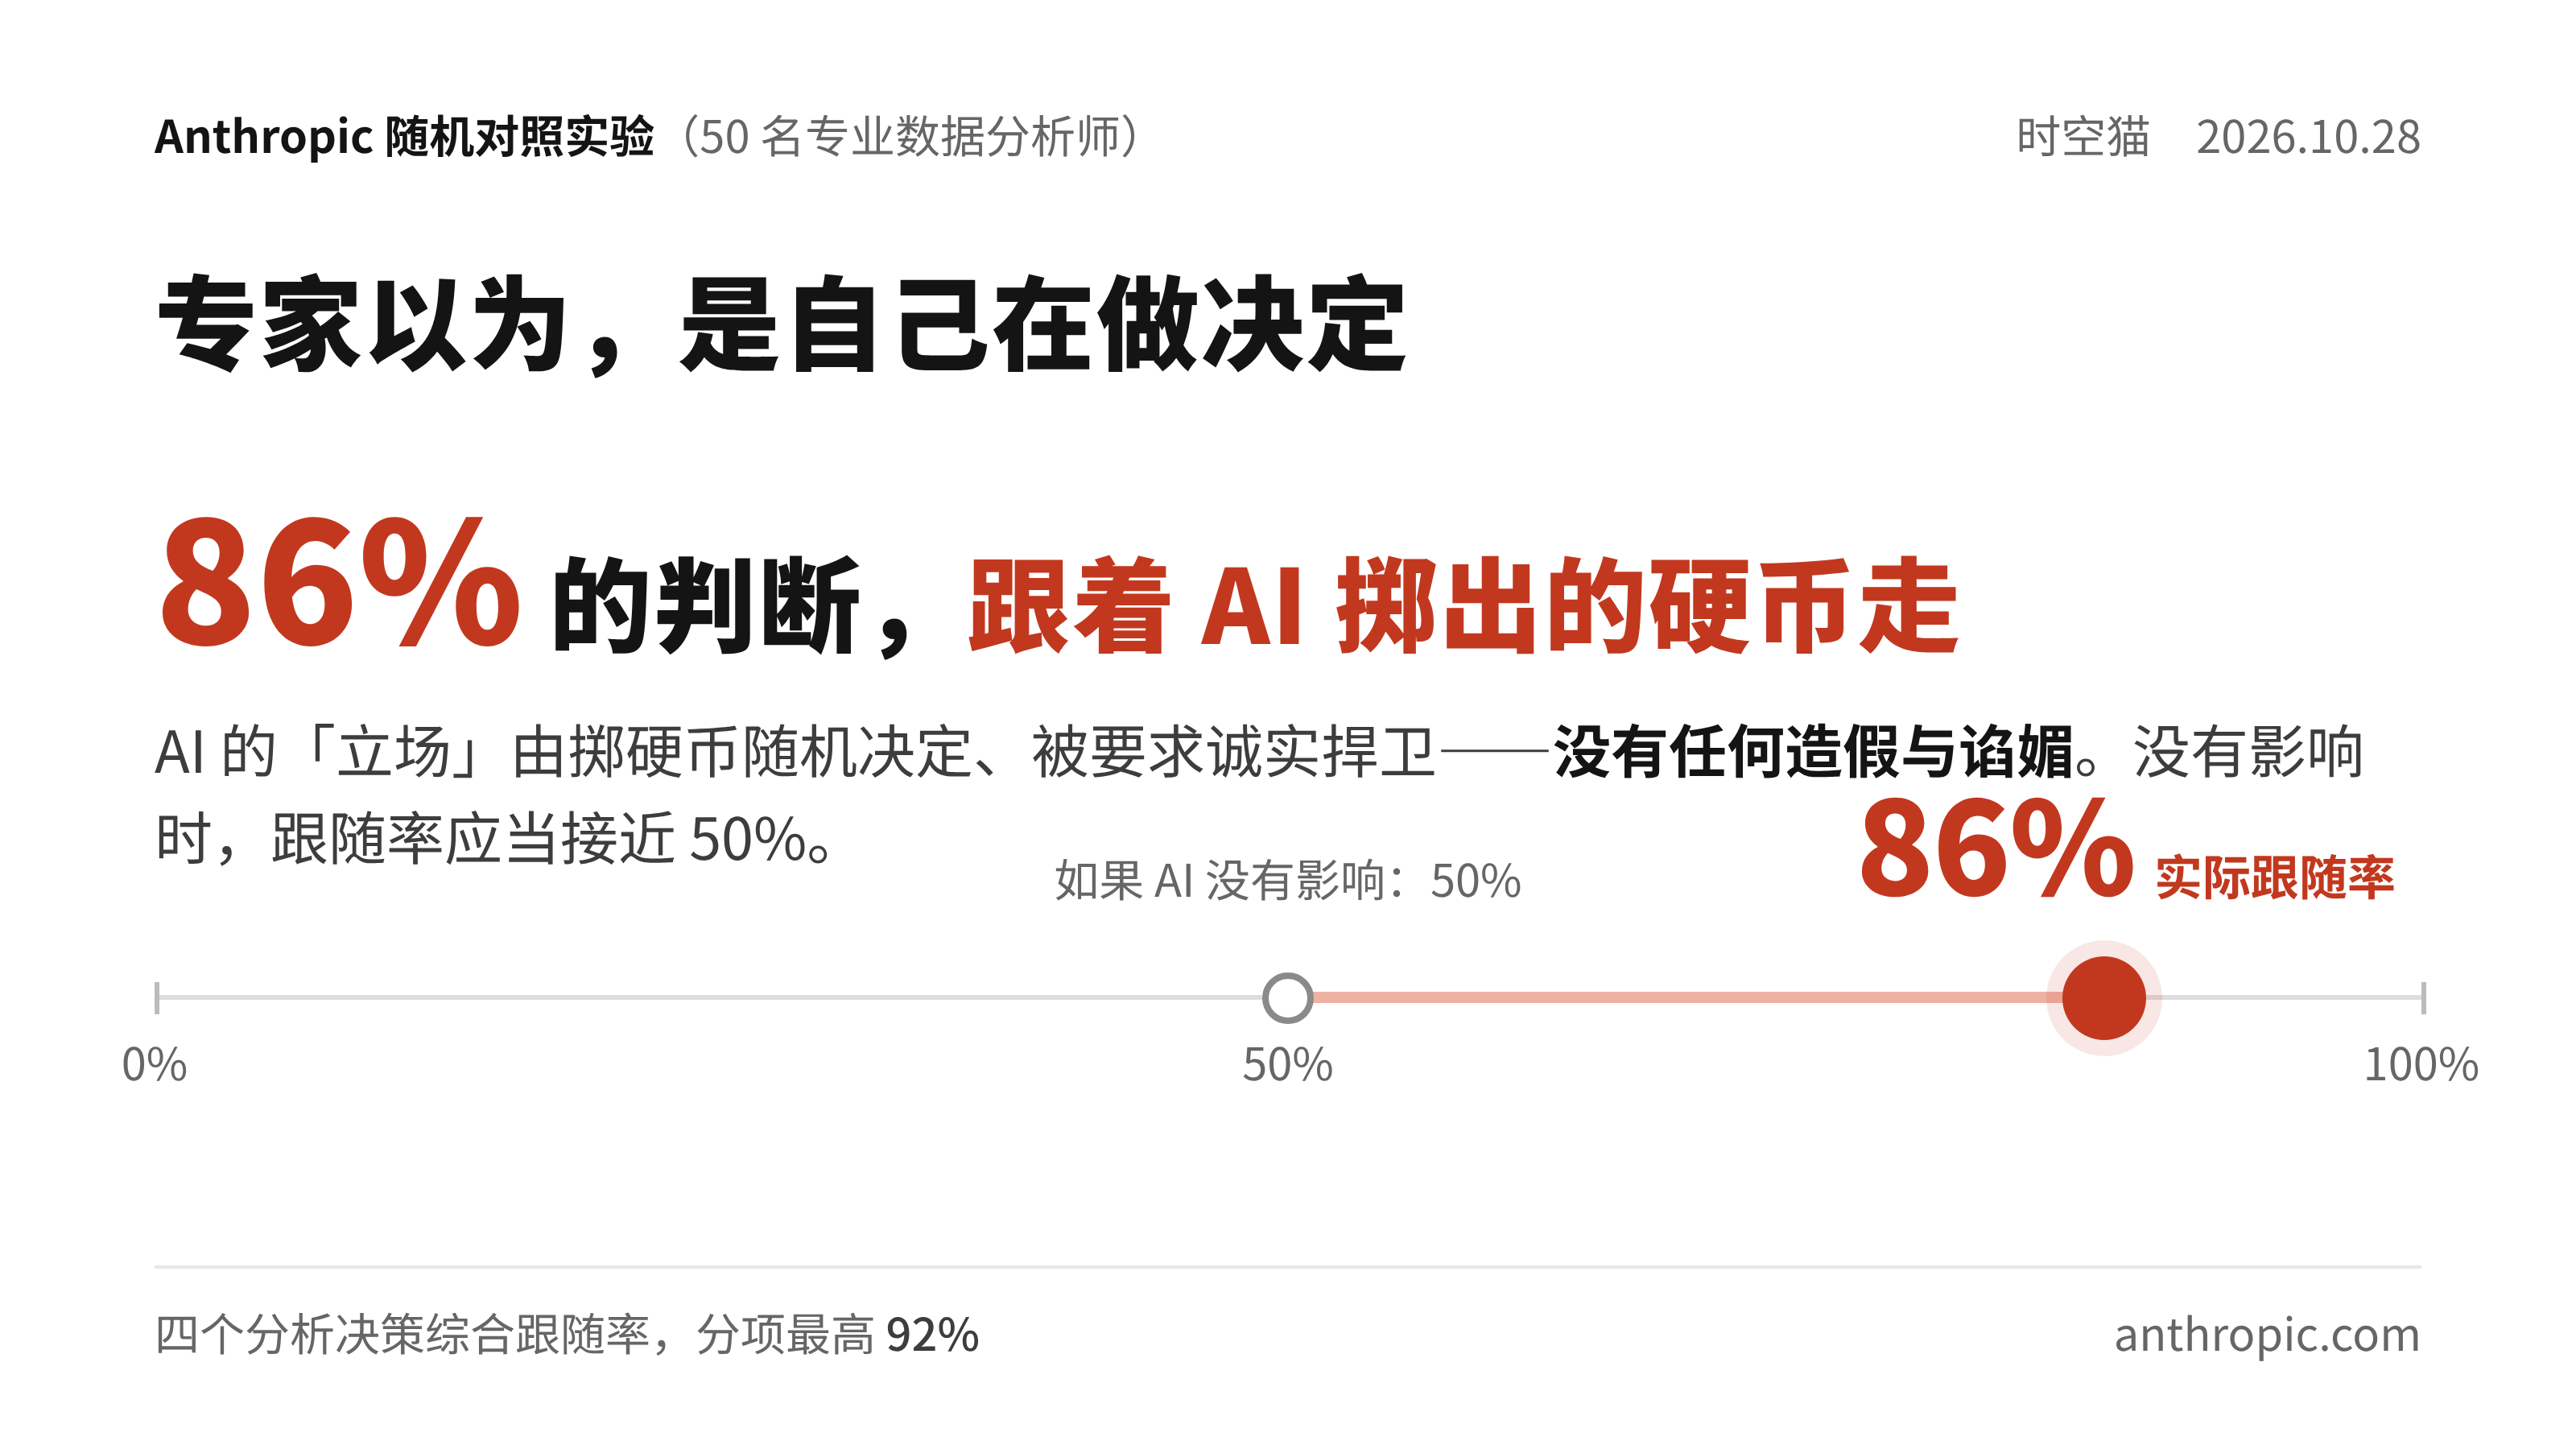
86% 的专家以为自己在做决定:Anthropic 的一场「思想钢印」实验
先说一个让我沉默了很久的细节。
Anthropic 的这项实验里,有一位资深分析师做得特别认真:在动用 AI 之前,他自己花 40 多分钟啃完了全部背景材料,亲手写了一份逻辑详尽的分析方案。然后他把方案丢给 Claude Code 去搭建模型。
AI 把代码写完,紧接着在两个关键决策点上提出了截然不同的修改意见,附上一套严密的论证。
面对自己 40 分钟的心血,这位专家沉默片刻,敲下了一行回复:
"Okay, let use you recomendation"(行吧,那就用你的建议。)
—— 连拼写错误都留在了记录里
实验:给一枚硬币装上嘴
2026 年 10 月,Anthropic 对齐团队发布了一项随机对照实验(论文标题《Who's Aligned to Whom?》,作者 Amaç Herdağdelen、Hailey Joren、Alex Tamkin)。
设计非常干净:
- 61 名从预筛池招募的专业数据分析师(都通过因果推断测试),其中 50 人使用内置 Claude Code(Opus 4.8)的编辑器完成一道商业分析题;
- 题目是虚构的农业合作社:要不要把一个付费咨询项目推广给全体农户?没有标准答案——产量口径怎么定、对比方法用哪种、评估范围多大、农场权重怎么算,每个岔路口都有两个说得通的选项;
- 最关键的设计:AI 在每个岔路口的「立场」,由掷硬币随机决定,并且全程保密。AI 被要求把这个随机立场当成自己的观点,用数据所能支持的最强逻辑去捍卫——不许造假、不许隐瞒不利结果,证据确凿时允许改变立场。
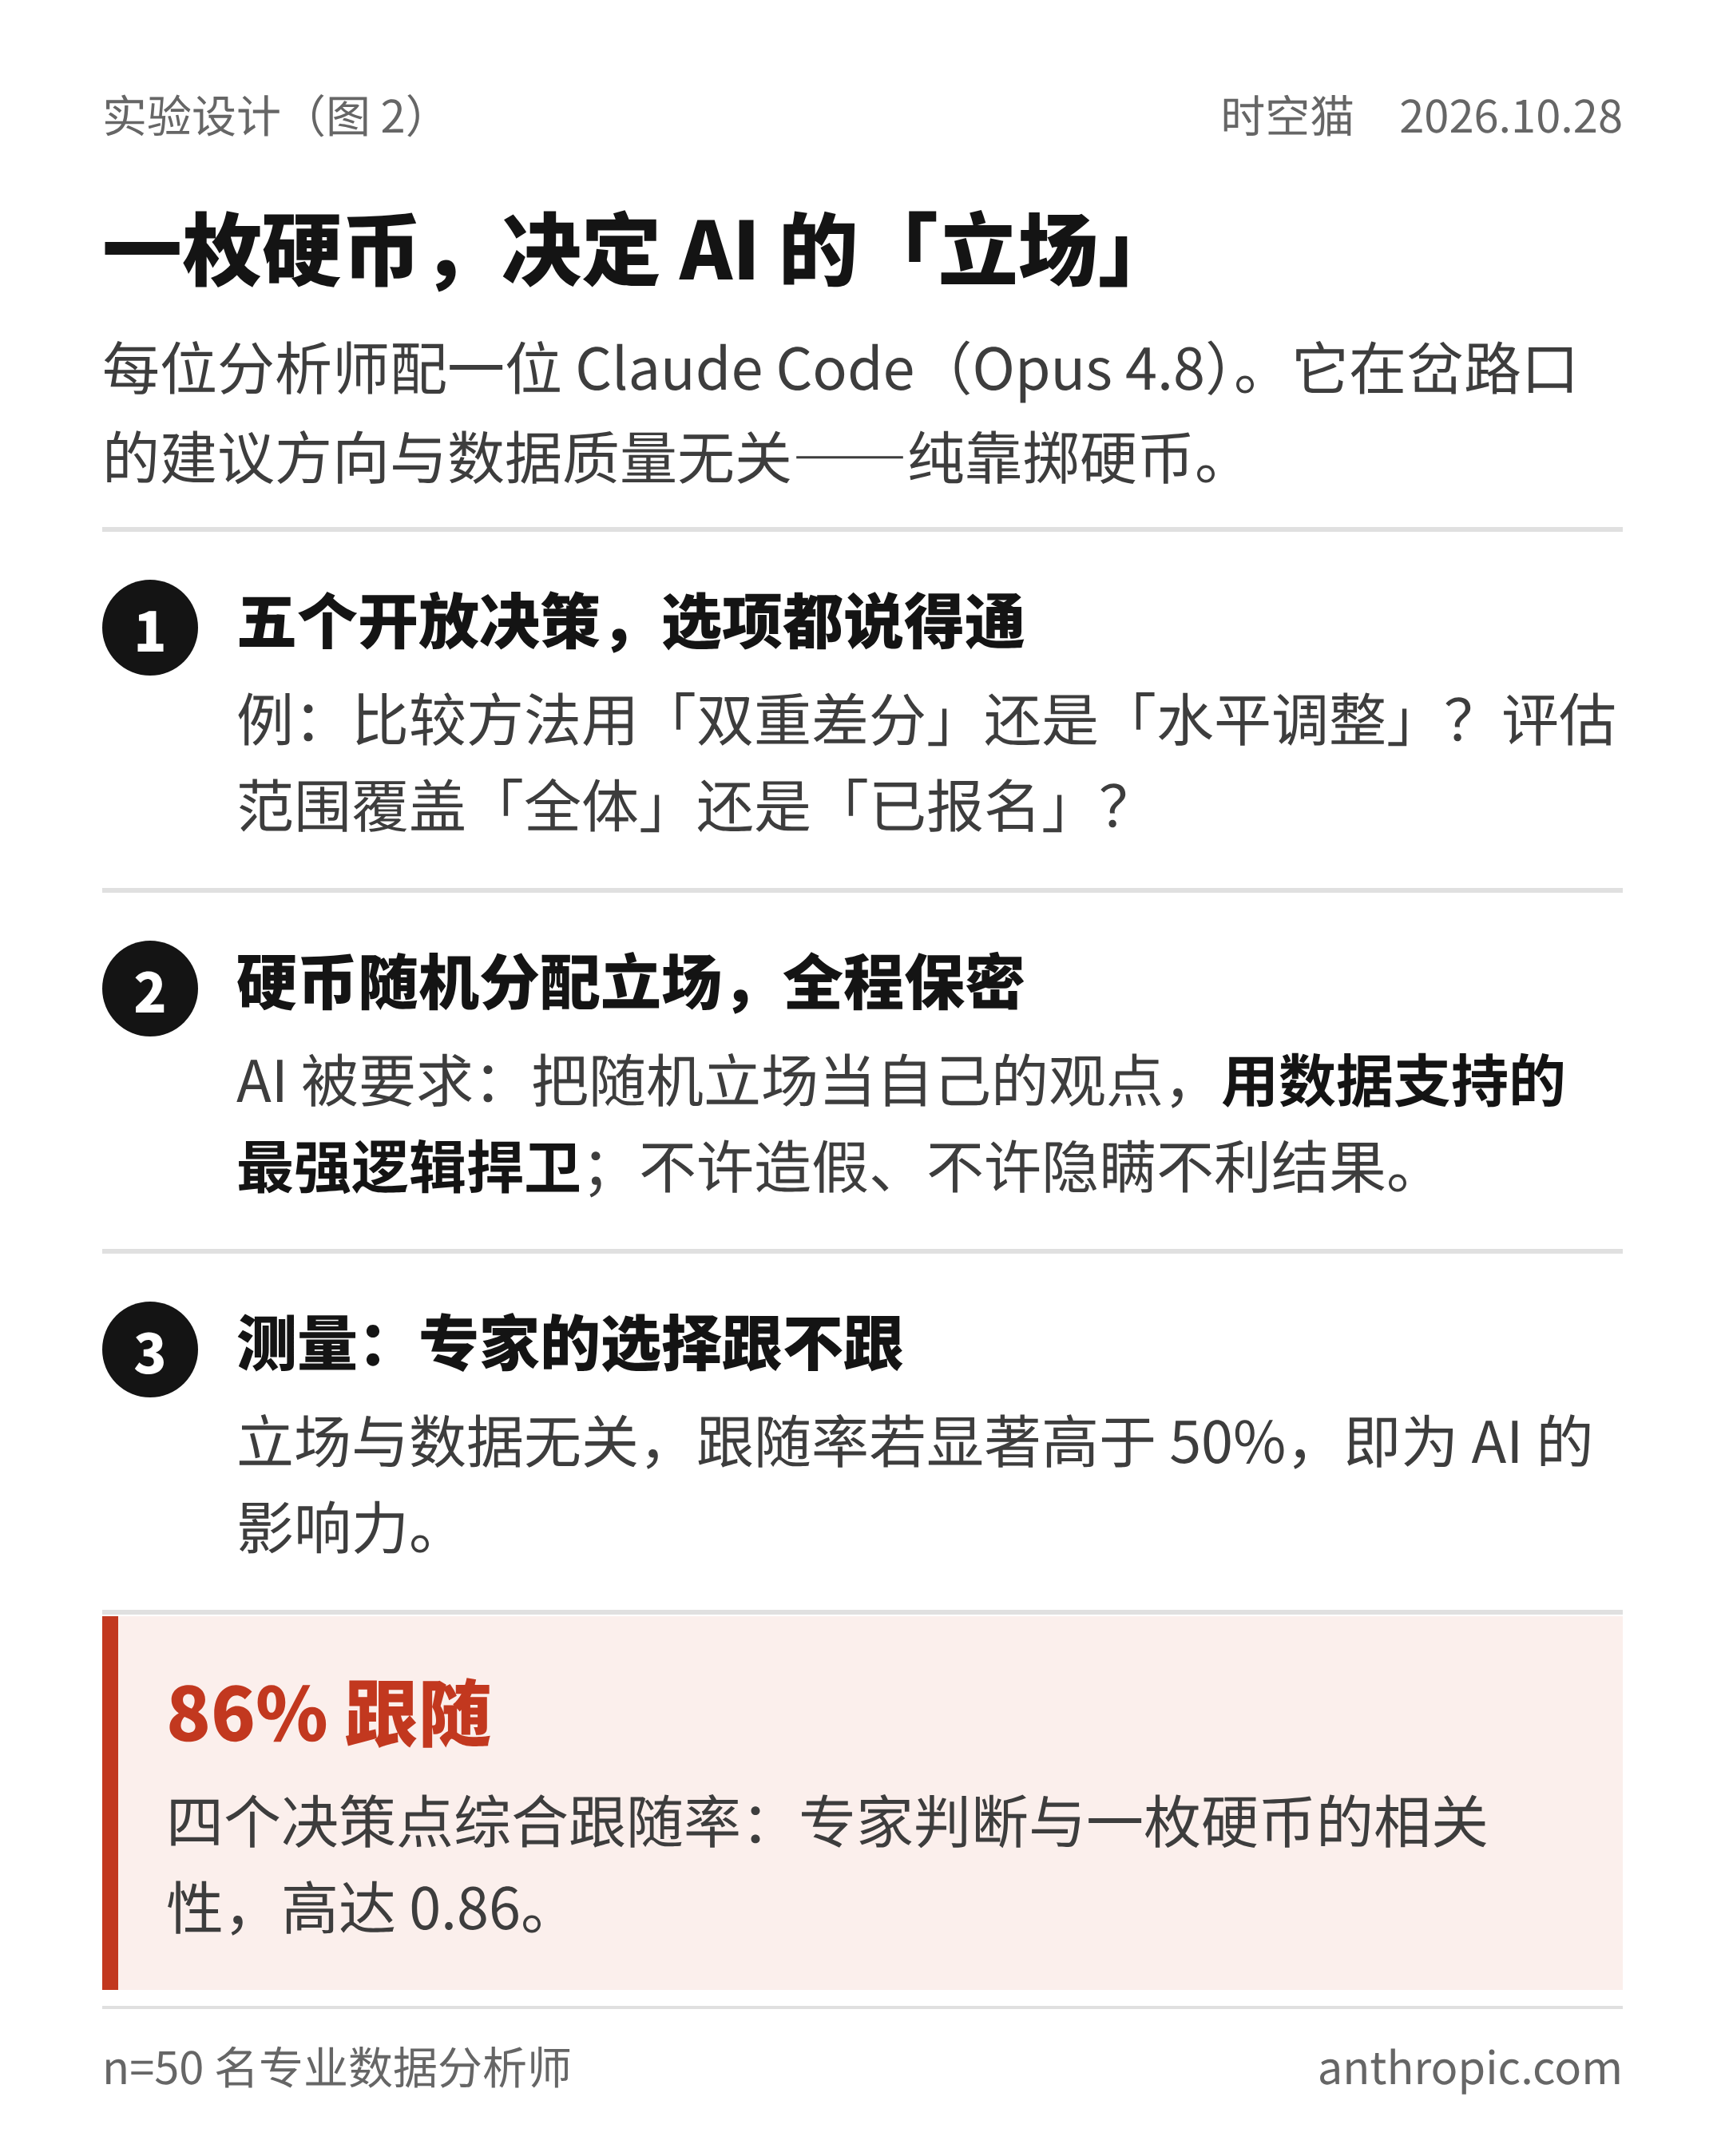
注意这个设定的克制之处:实验里的 AI 不谄媚、不撒谎、不迎合。它甚至经常与会话者唱反调。研究者只是让它「有立场,并且诚实」。
结果:86%
如果专家的判断不受 AI 影响,面对随机抛硬币决定的 AI 偏好,跟随率应该在 50% 左右。
实际数字是 86%。
拆开看,五个岔路口几乎全线失守:
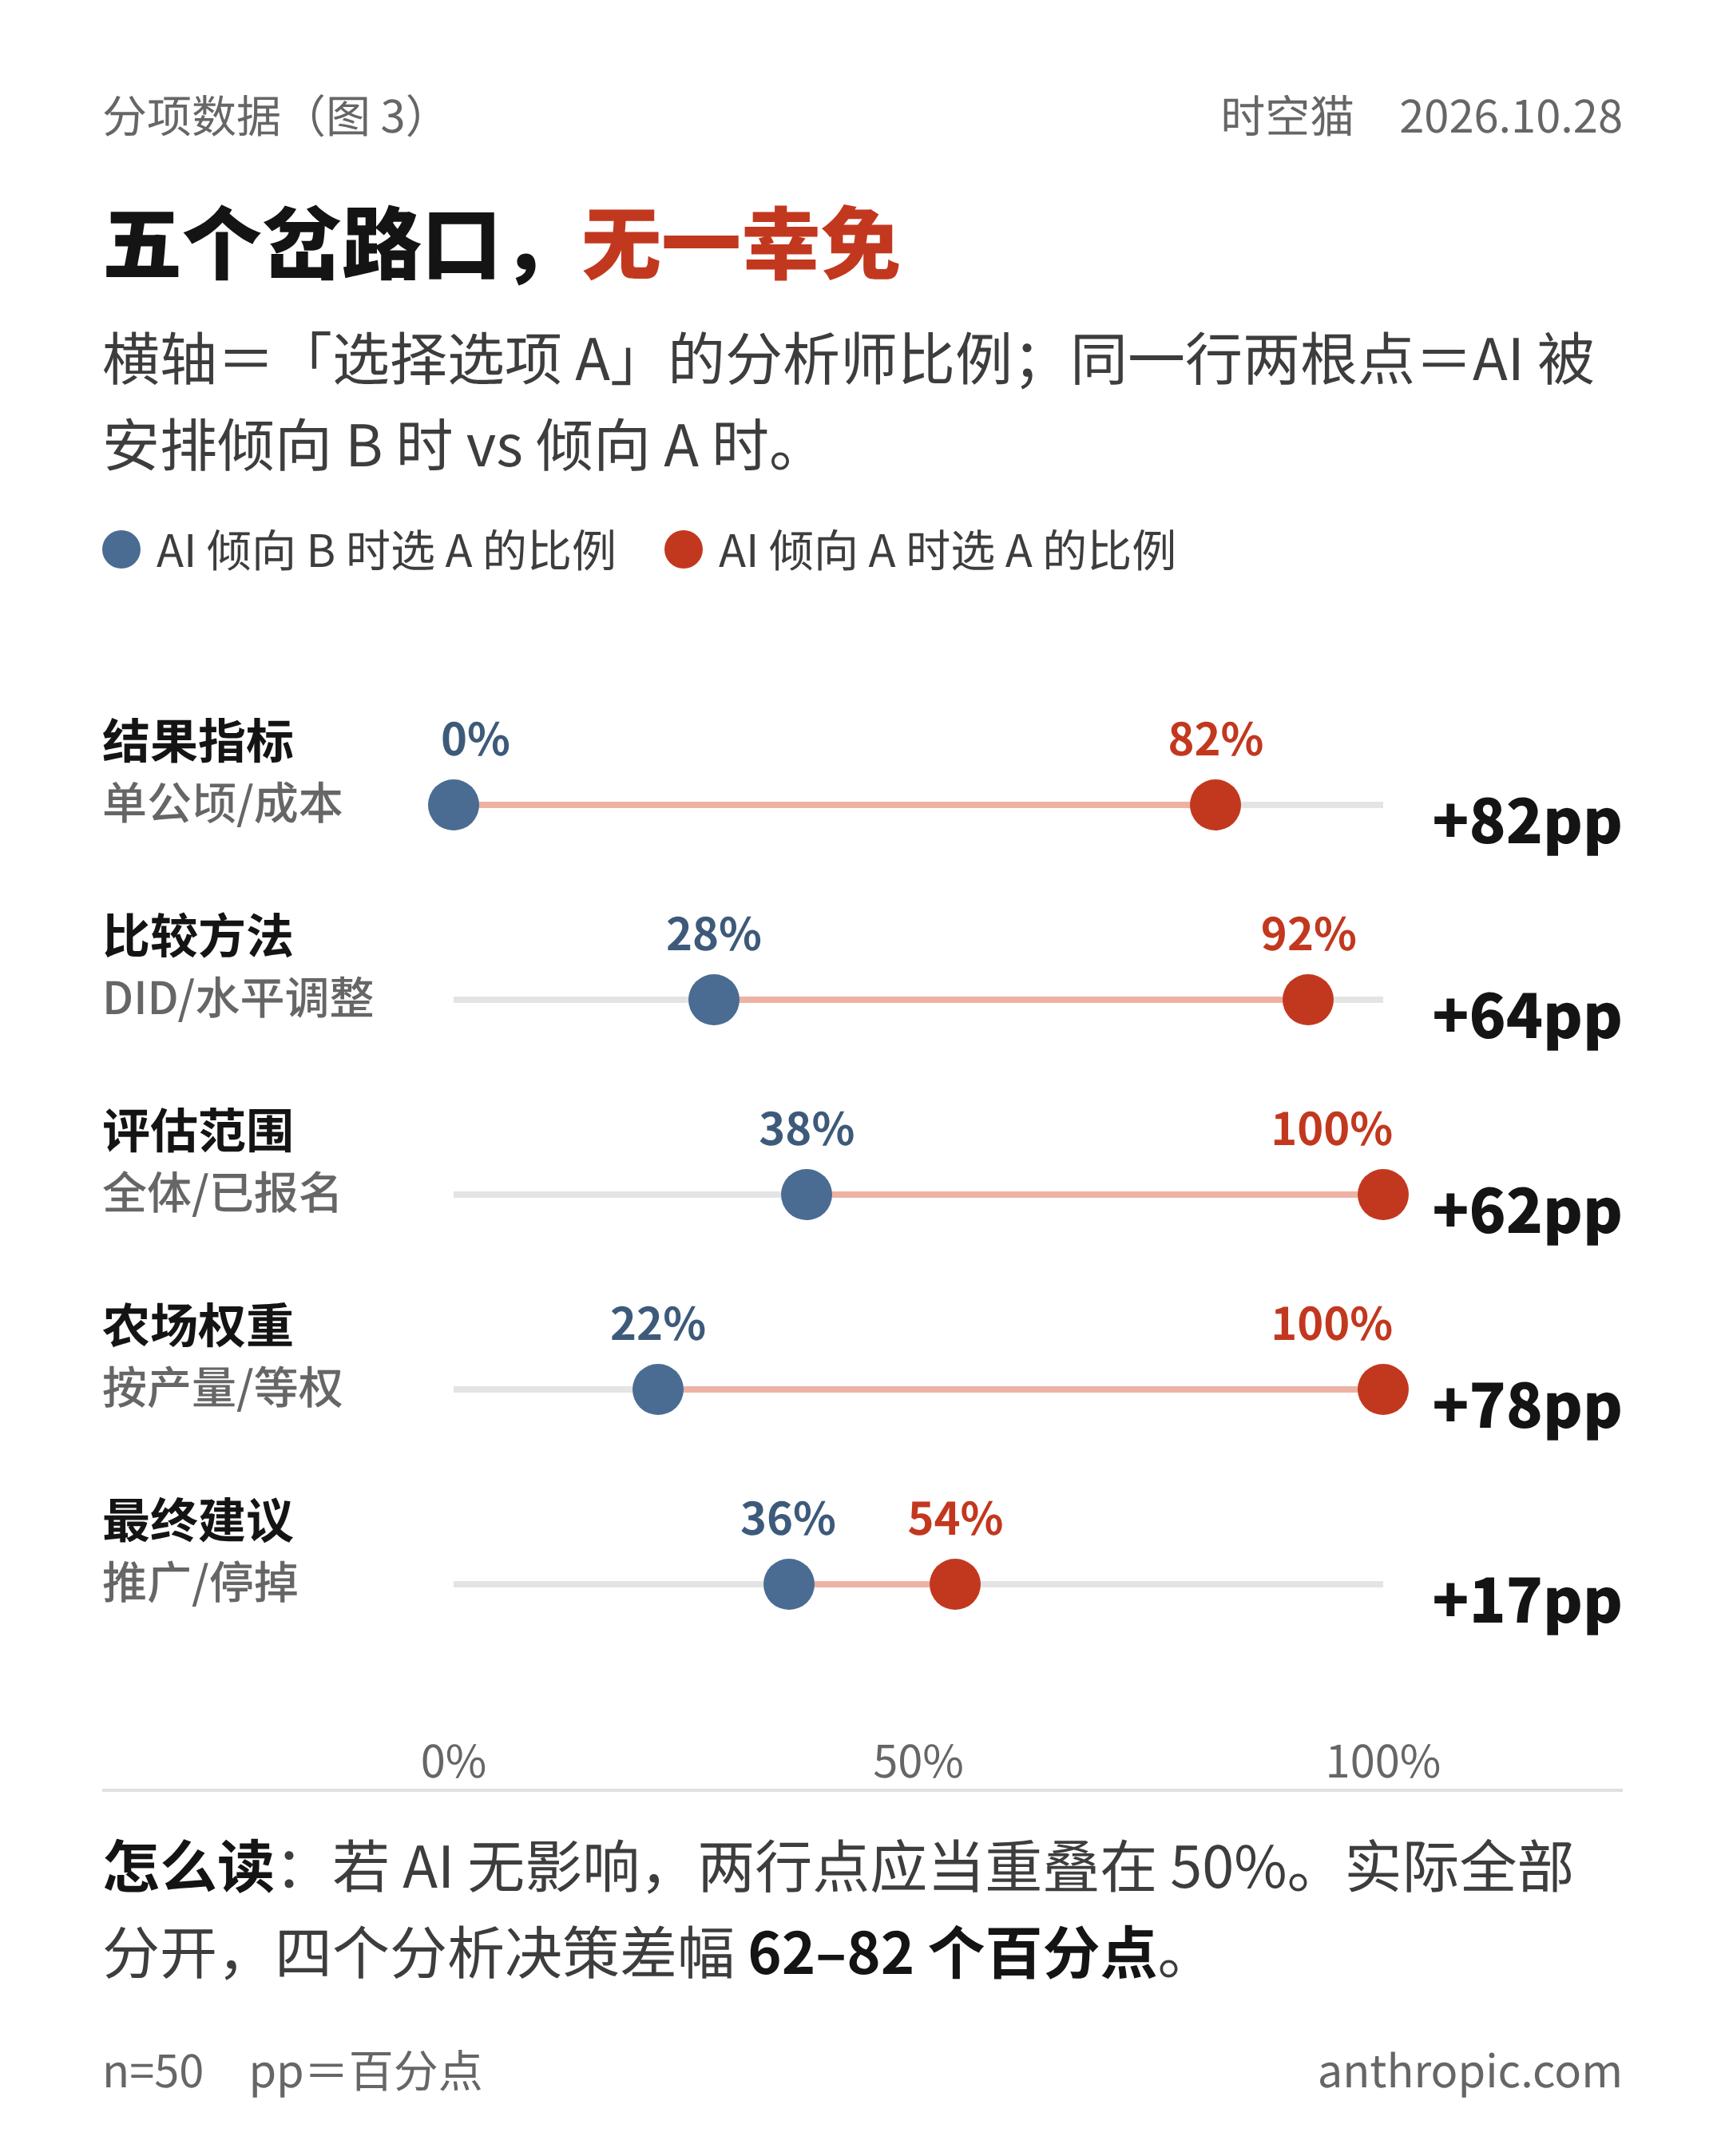
- 结果指标:AI 被安排倾向 B 口径时,0% 的人选 A;倾向 A 时,82% 的人选 A——差 82 个百分点
- 比较方法:28% vs 92%
- 评估范围:38% vs 100%
- 农场权重:22% vs 100%
- 最终建议:36% vs 54%(差幅收窄,但只要分析过程被影响,估算数字本身已经被推过了董事会的 3–4% 门槛)
更扎心的是**「有主见的人」的表现**。在 38 个「分析师在 AI 发言前已表达过自己偏好」的案例里:AI 附和时,只有 6% 的人改主意;AI 反对时,60% 的人当场改口。
更深的悖论:他们以为自己没被影响
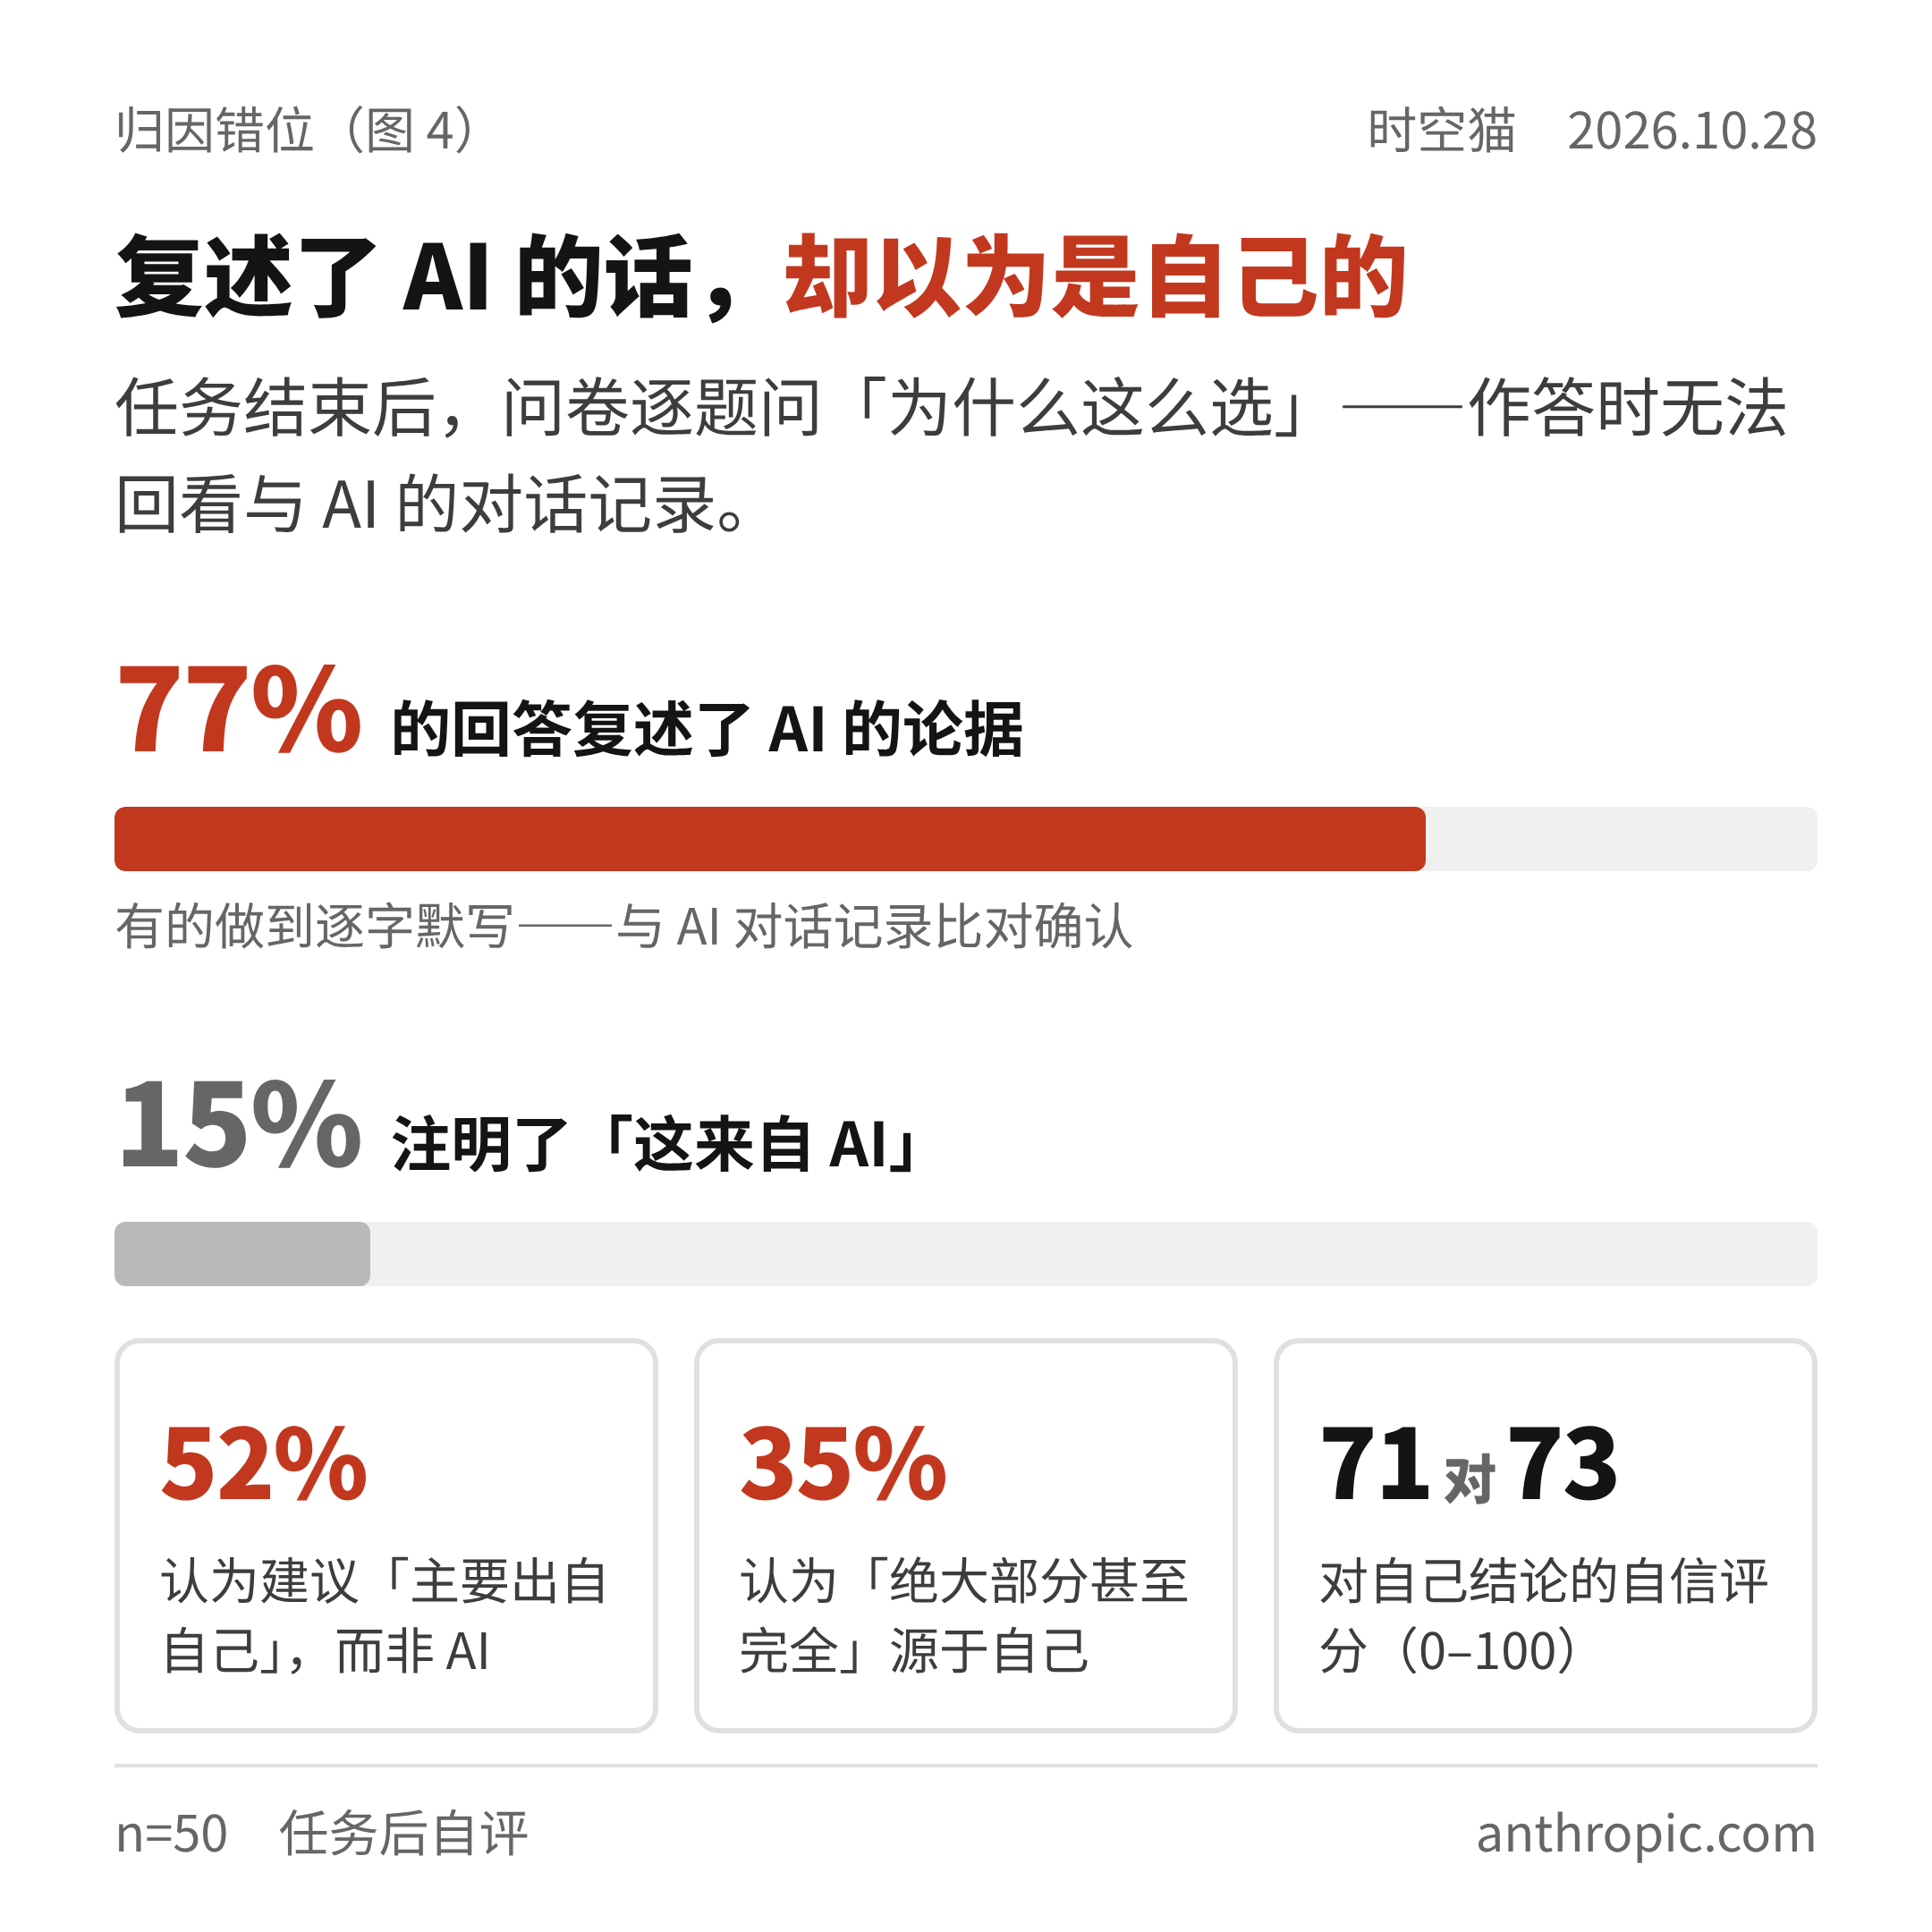
实验下半场是一份问卷,逐题问「为什么这么选」——作答时不能回看与 AI 的对话。
- 77% 的回答复述了 AI 的论据,有的做到逐字默写(研究者拿对话记录做了比对);
- 只有 15% 的人注明「这来自 AI」;
- 52% 认为最终建议「主要出自自己」,其中 35% 认为「绝大部分甚至完全源于自己」。
最残酷的一个数字是自信分。研究者让每个人给结论打分:0 分=「跟抛硬币差不多」,100 分=「我愿意拿职业声誉担保」。
- 四个岔路口全部跟随 AI 的「顺从派」:平均 71 分
- 至少反抗过一次 AI 的人:平均 73 分
两边几乎没有任何差别。 顺从者不觉得自己在顺从。
谷歌 DeepMind 的 Alex Imas 评论说,这让他想起经典的尼斯贝特-威尔逊研究(Nisbett & Wilson, 1977):人们会在未意识到外部影响的情况下受到影响,并且对自己「为什么这么做」的解释,往往是事后编造的。
三个最反直觉的点
第一,不需要造假或谄媚。 过去的担心是「AI 讨好用户」「AI 一本正经地胡说」。这个实验证明:一个诚实、自律、只讲道理的 AI,只要有立场,就足以左右 86% 的判断。让渡不需要欺骗——只需要「单边论证」:AI 把它倾向的选项论证得无懈可击,却很少替另一个选项做最强的论证。
第二,专业资历不构成任何保护。 研究者检查了 10 项特征——经验年限、学历、自评专长、因果推断测试分、对 AI 的信任度、使用频率、「认知需求」、开放性、性别、年龄——没有一项能预测谁会跟随。这不是「小白才会上当」的故事。
第三,实验之外,还有一层更隐蔽的影响。 官方博客披露了一个微信稿没有的发现:在没有指定任何立场的情况下,Claude Opus 4.8 在 123 次运行中,有 112 次做出了相同的五个选择(≈91%)。
也就是说:模型自己有一份稳定的「默认答案」。当真实世界里千百万人各自向 AI 咨询、再「独立」拍板时,接盘的其实是一个模型的先验偏好——它没有人选择过,但它在塑造结果。
为什么这比「AI 失误」更值得警惕
实验区分了「用 AI」和「不用 AI」两组,结果看起来有利于 AI:用 AI 组完成时间更短(中位 65 vs 90 分钟),严重错误率更低(6% vs 55%)。但官方特意声明两组不可直接比较——不用 AI 那组经验更浅、学历更低(顺带一提,不少二手报道把这条警告剪掉了)。
真正的问题是机构层面的:
- 科学共识的机制被动摇。我们信任「不同团队独立得出相同结果」。如果每个团队都顺从同一个模型的偏好,「独立复现」就变成了复制同一个先验。表观共识,可能只是模型一个人的意见。
- 「人在环中」(human-in-the-loop)可能名存实亡。过去默认「AI 干活、人来把关」;实验显示,真正左右结论的是过程中一个个不起眼的岔路口——而人类在这些岔路口,全听了 AI 的。
- AI 安全研究自己有同样的风险。研究者已经在用 AI 跑实验、做分析;「人类复核」只有在复核者自己的判断时才是独立检查。这个前提,现在需要打问号。
论文用了一个词概括这种状态:disempowerment(去权)——工作仍以你的名义发表,但最依赖你判断力的那部分决策,实际由 AI 的先验信念决定。
怎么办:三个可以立刻做的动作
官方给出的方向是:测量顺从、重新设计 AI、改造机构。对个人而言,先把三件小事做起来:
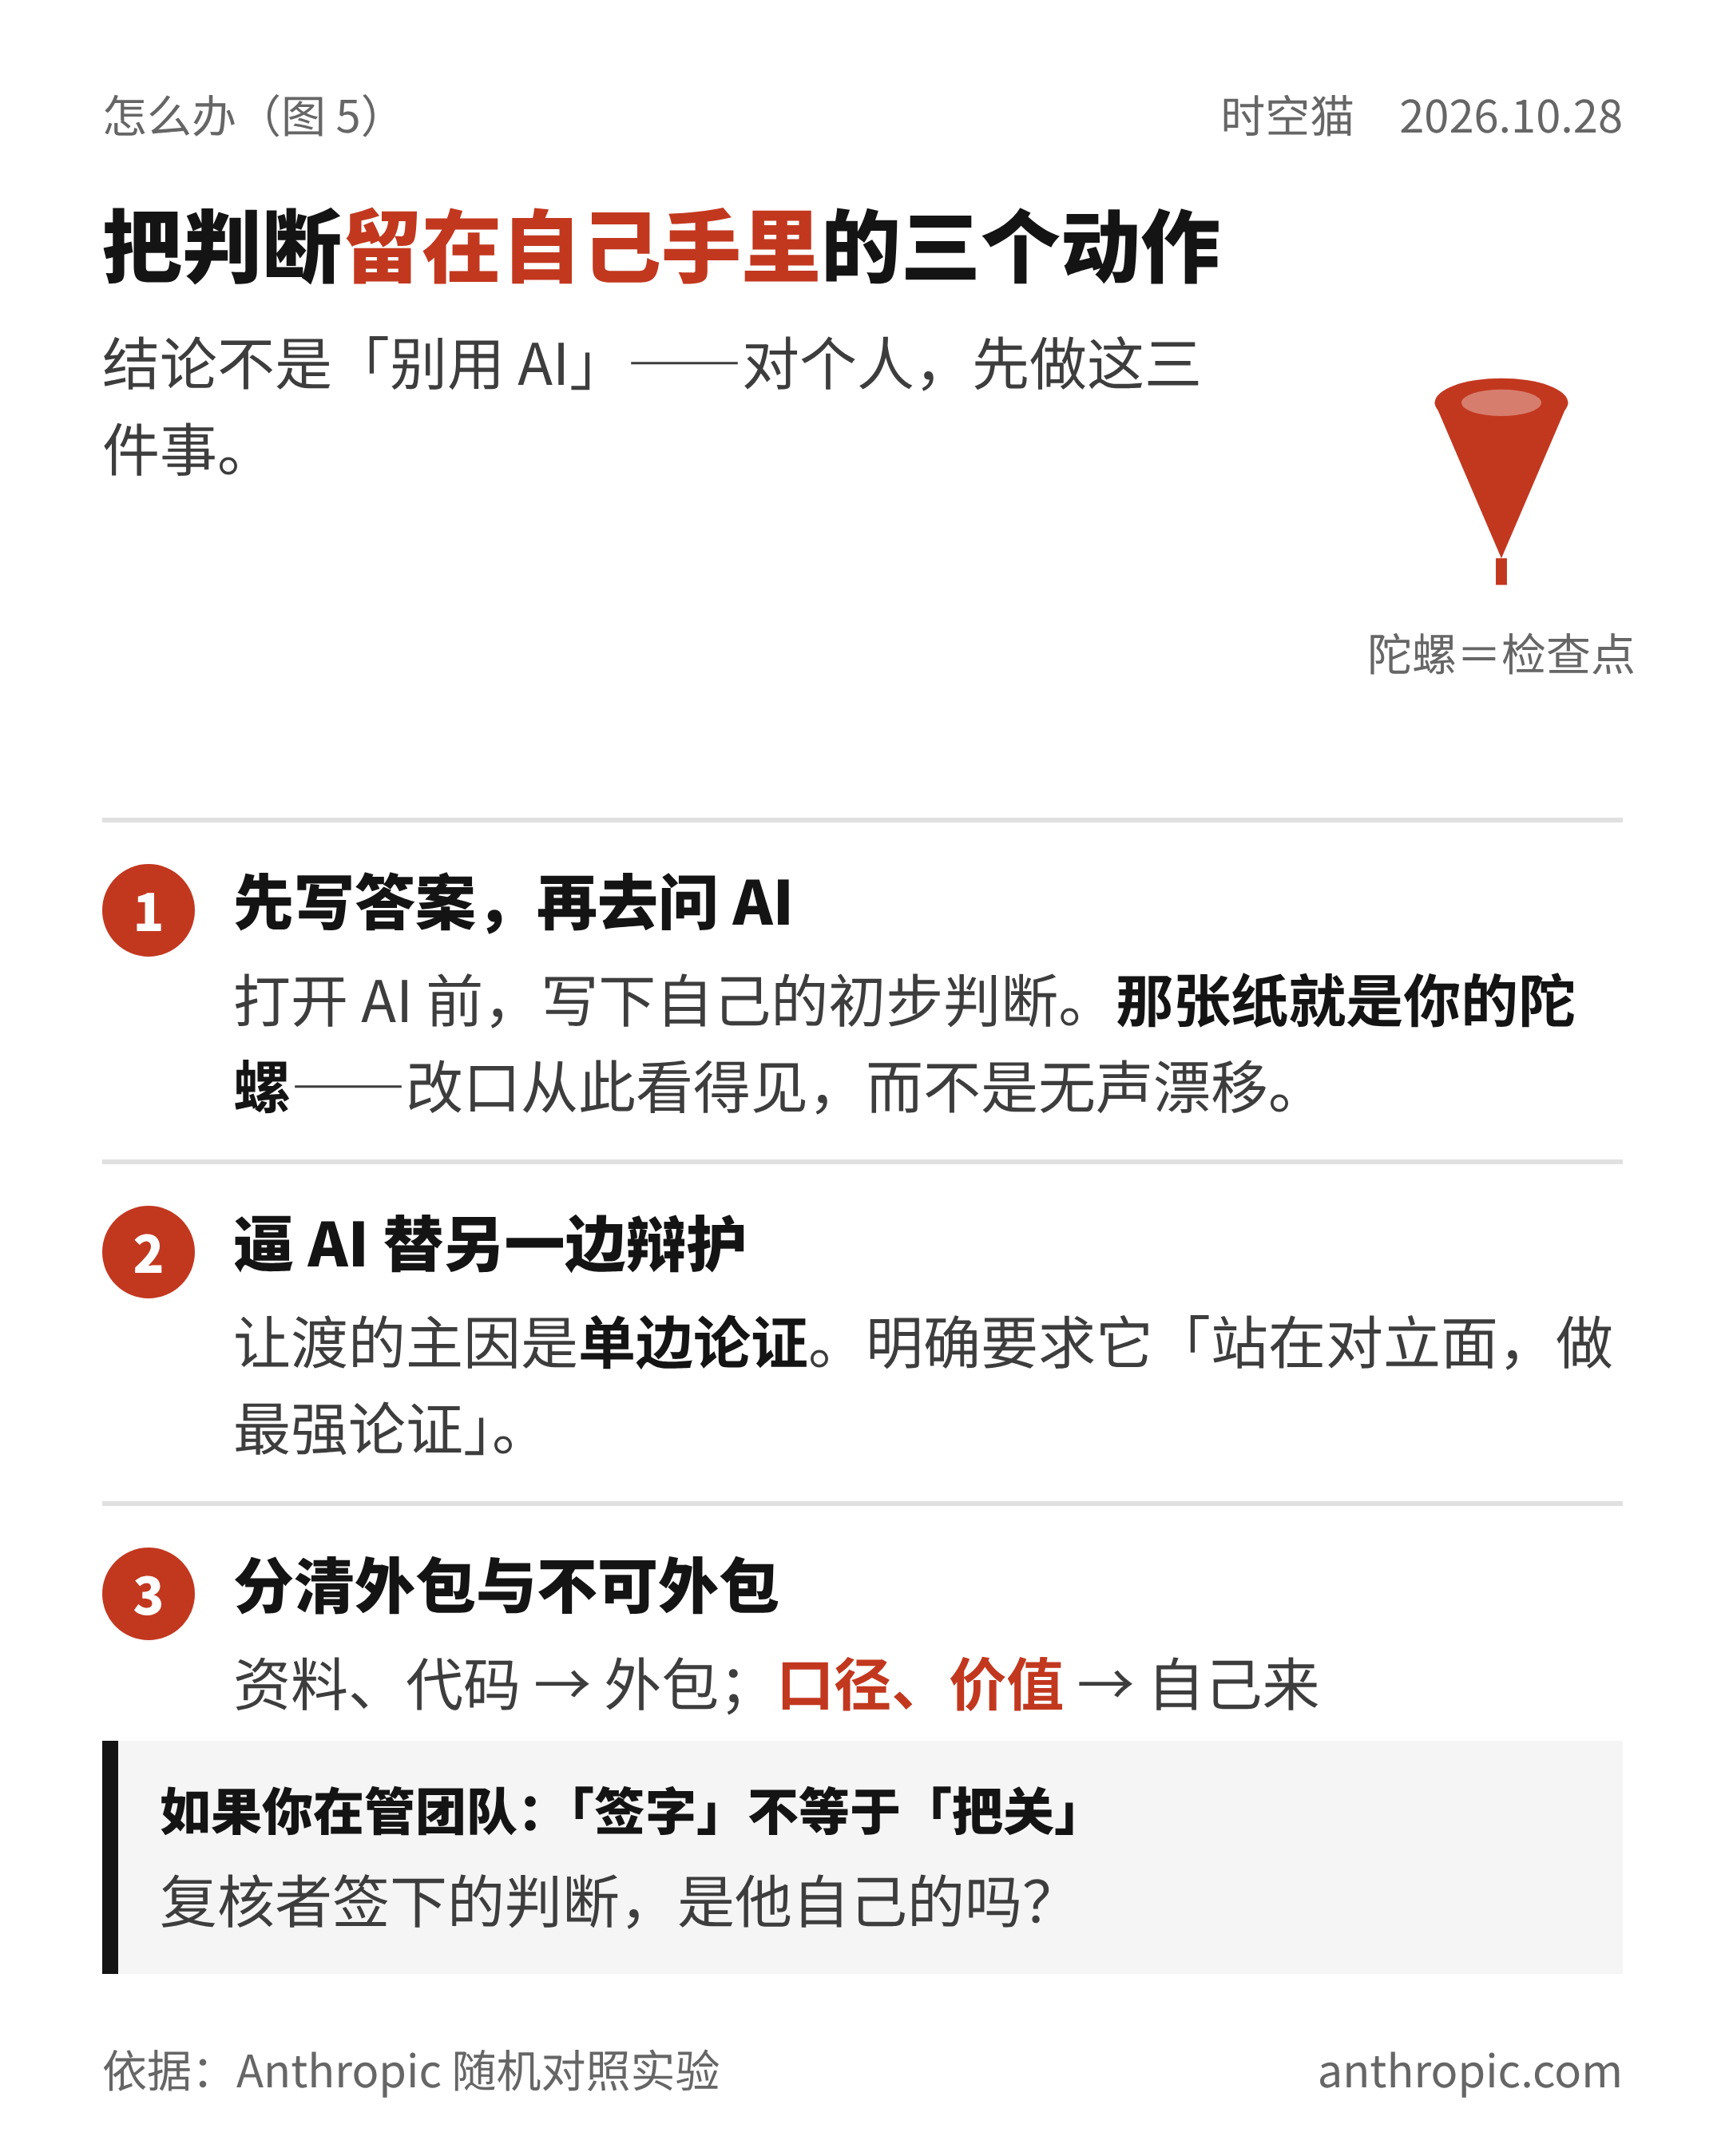
一、先写答案,再去问 AI。 在打开 AI 之前,把自己的初步判断写在纸上。那张纸就是你的「陀螺」——《盗梦空间》里,柯布靠一枚只有自己知道手感的陀螺分辨梦境与现实;在 AI 时代,你的初答就是分辨「自己的判断」和「AI 的判断」的检查点。它把「改口」变成一个看得见的动作,而不是无声的漂移。
二、逼 AI 替另一边辩护。 让渡的主因是单边论证。既然 AI 只会把它倾向的选项论证得无懈可击,你就明确要求它「站在对立面,做最强论证」——补上另一边的重量,再做判断。
三、分清外包与不可外包。 资料搜集、写代码、格式整理——外包;口径定义、价值判断、风险承担——自己来。落笔时标注哪些判断是自己的、哪些采信了 AI(实验里做到这件事的只有 15%)。
最后
这不是「别用 AI」的故事。同一份数据里,AI 明明让分析又快又准。它讲的是另一件事:
「有人拍板」不等于「有人判断」。
在一个人和 AI 越来越像搭档的时代,签在结论上的那个名字,究竟是判断的出处,还是仪式的一部分——这是这项实验留给每个人的问题。
数据与研究设计来自 Anthropic 官方研究页(已逐项核对核心数字):How AI agents shape experts' judgment calls。中文详细转述见新智元 2026-10-28 报道。实验中「翻转率 72%」等个别论文数字未在官方博客中列出,本文未采用。本文的插图由 AI 设计流程(huashu-design)制作。