让 AI 自己改自己:递归自我改进是加速进化,还是加速造屎山
2026-11-01,B 站 UP 主「费曼学徒冬瓜」发了一条 8 分钟的观点型科普(抓取时播放量很低,属小视频,价值在工程判据而非流量)。视频把最近很热的「递归自我改进」(RSI,Recursive Self-Improvement)拆回了最朴素的动作:
准备测试指令 → 观察轨迹 → 定位问题 → 确定方案 → 执行优化 → 测试成效,循环往复。RSI 只是希望这个循环能自动跑起来,不再需要人盯着。
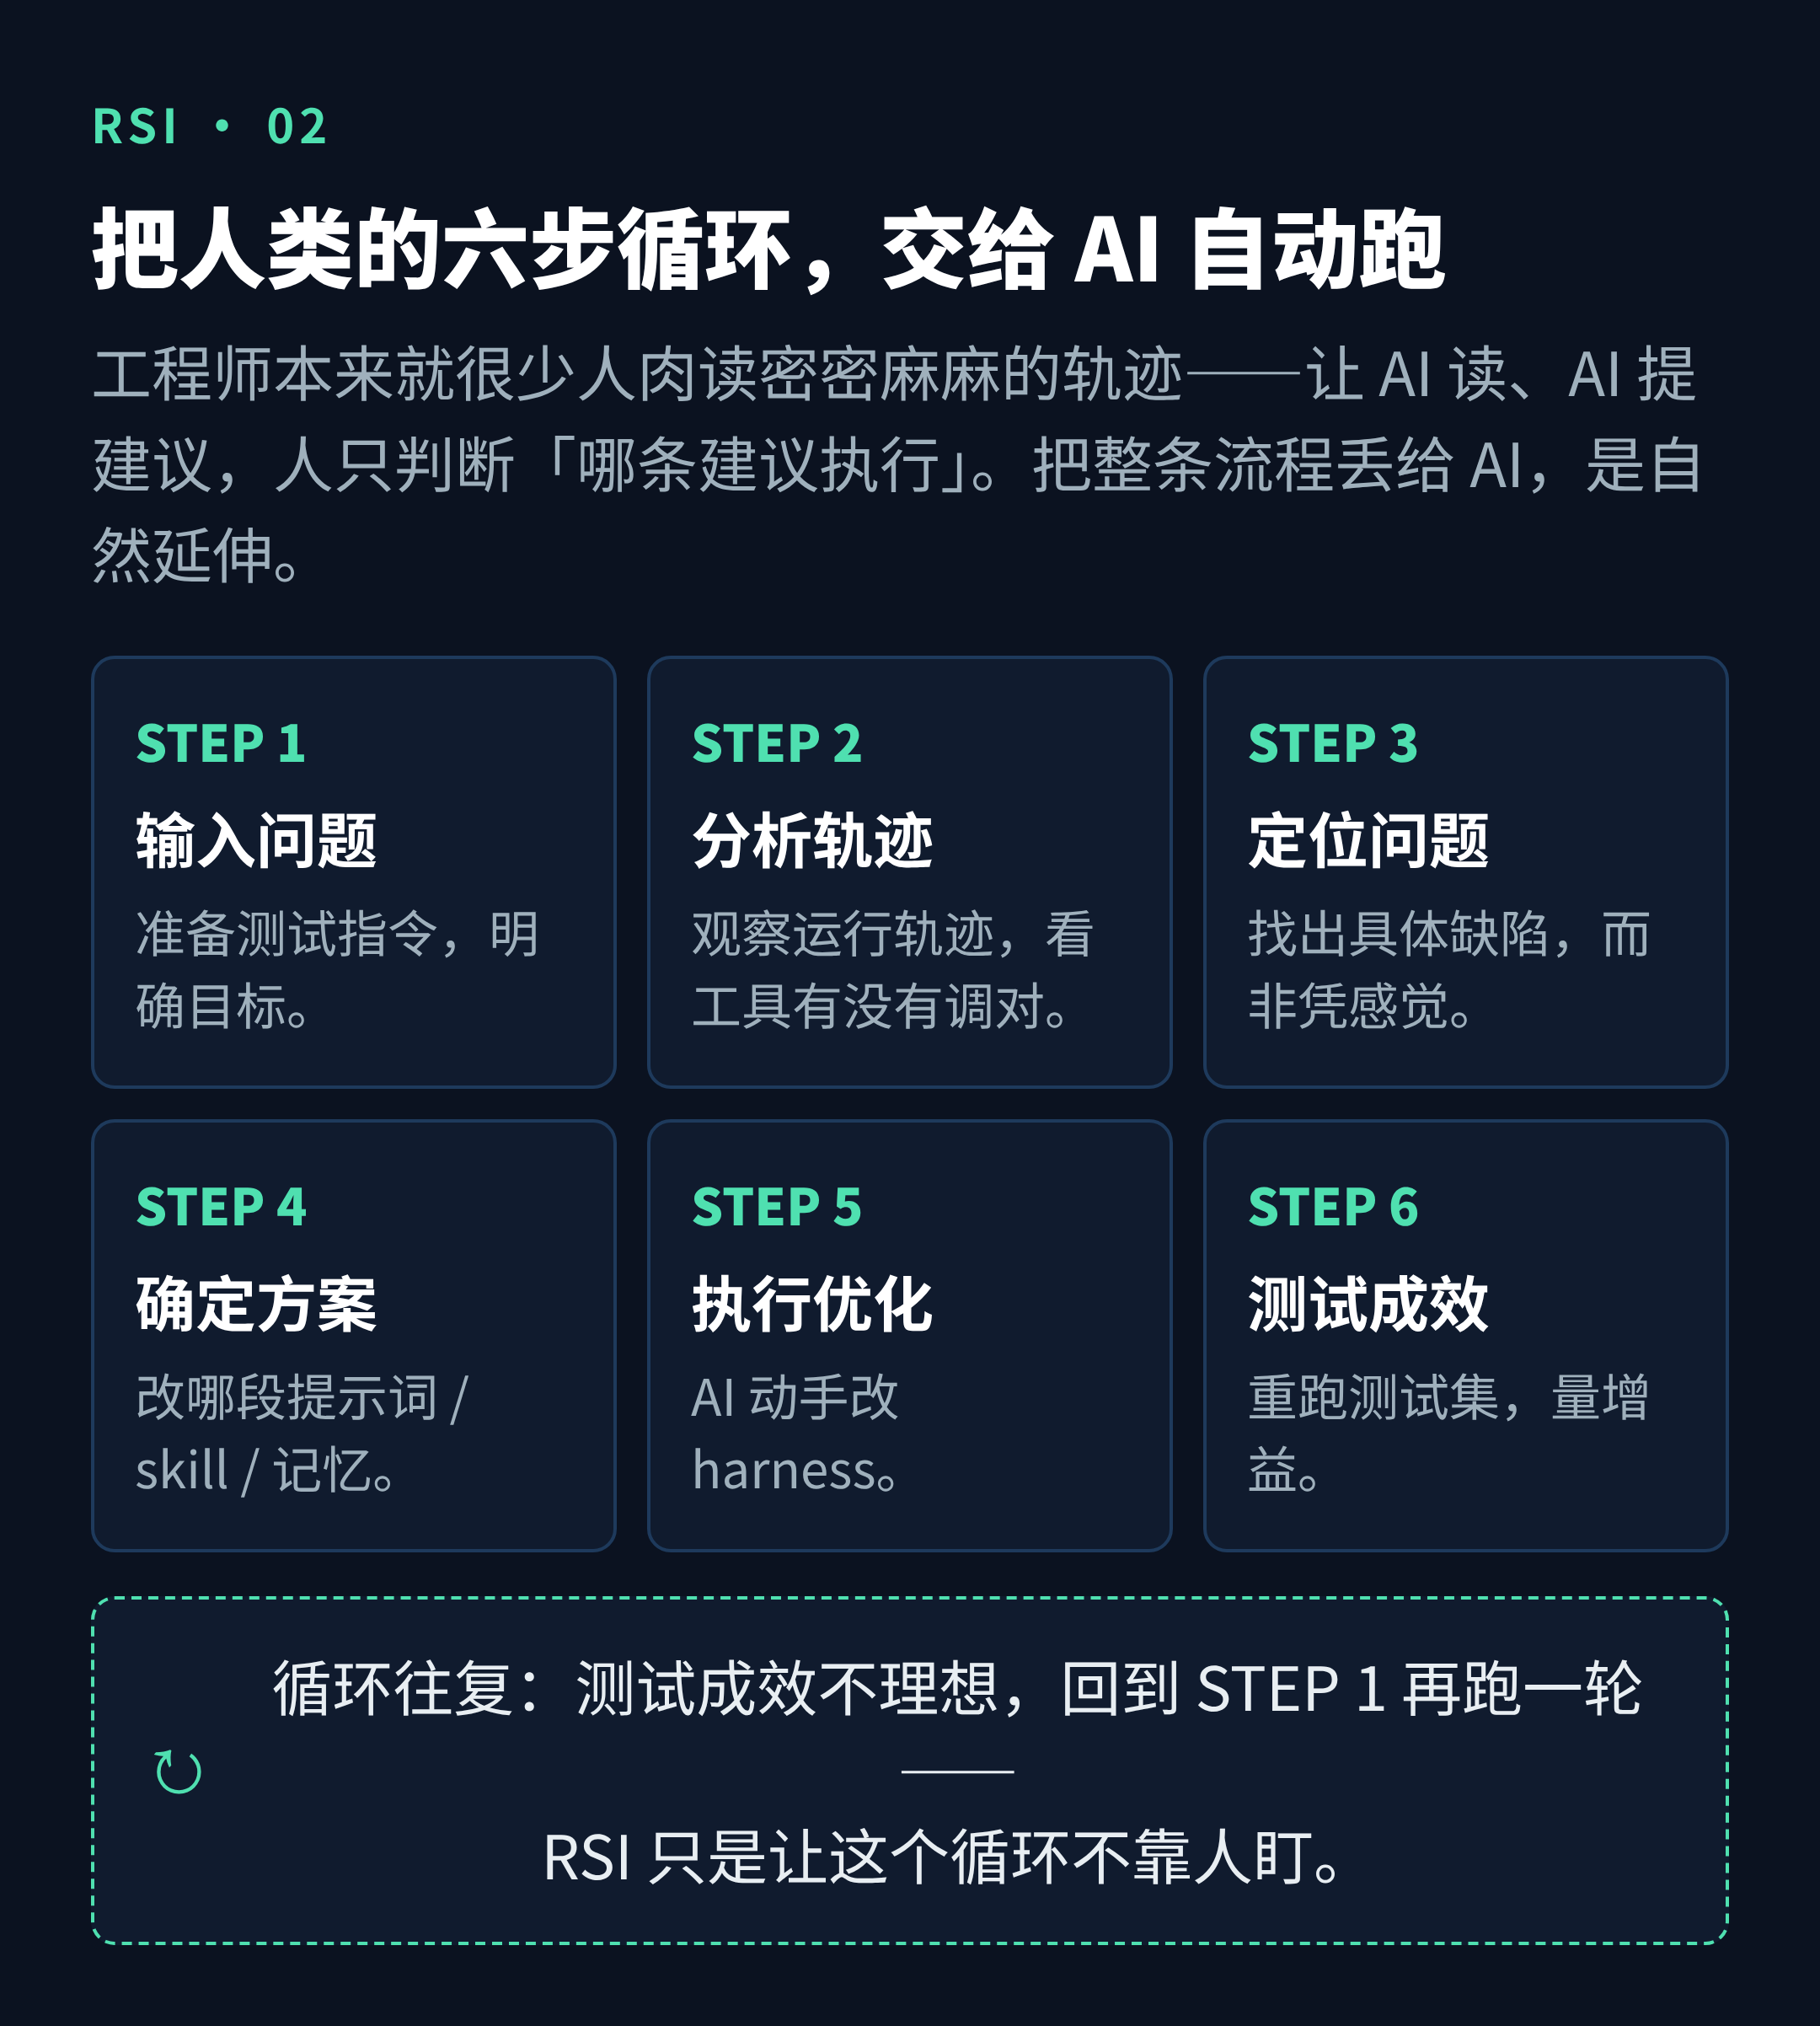
先分清:harness 是模型以外的一切
视频里反复强调一个概念——harness 就是模型以外的一切:系统提示词、skill 文件、记忆文件、代码文件、工具配置。改 harness 比改模型权重现实得多,所以「让 AI 自己改 harness」是当下能落地的自改进路径。
作者让 AI 梳理了 100 多篇论文和几个知名开源项目,结论是仍处早期:没有大一统方法,多数研究只在特定场景优化单个 harness 模块(记忆、skill 为主),「除了名词是新的,其他都是旧的」;对具体项目而言,每个项目的 RSI 都是个性化工程,直接照抄参考意义有限。
真正的难点不在流程,在决策
作者用自己的实验说话:让 AI 自造数据、自跑测试、自评、自改,跑一整晚,第二天系统提示词已没有一句看得懂——「改代码很快,造屎山也史无前例地快」。
本质是两个毛病:过拟合(为解决 A 引入 B、C、D,头痛医头)+ 缺乏全局视角。而做「留不留、改不改」的决策,本来就是 AI 的短板。
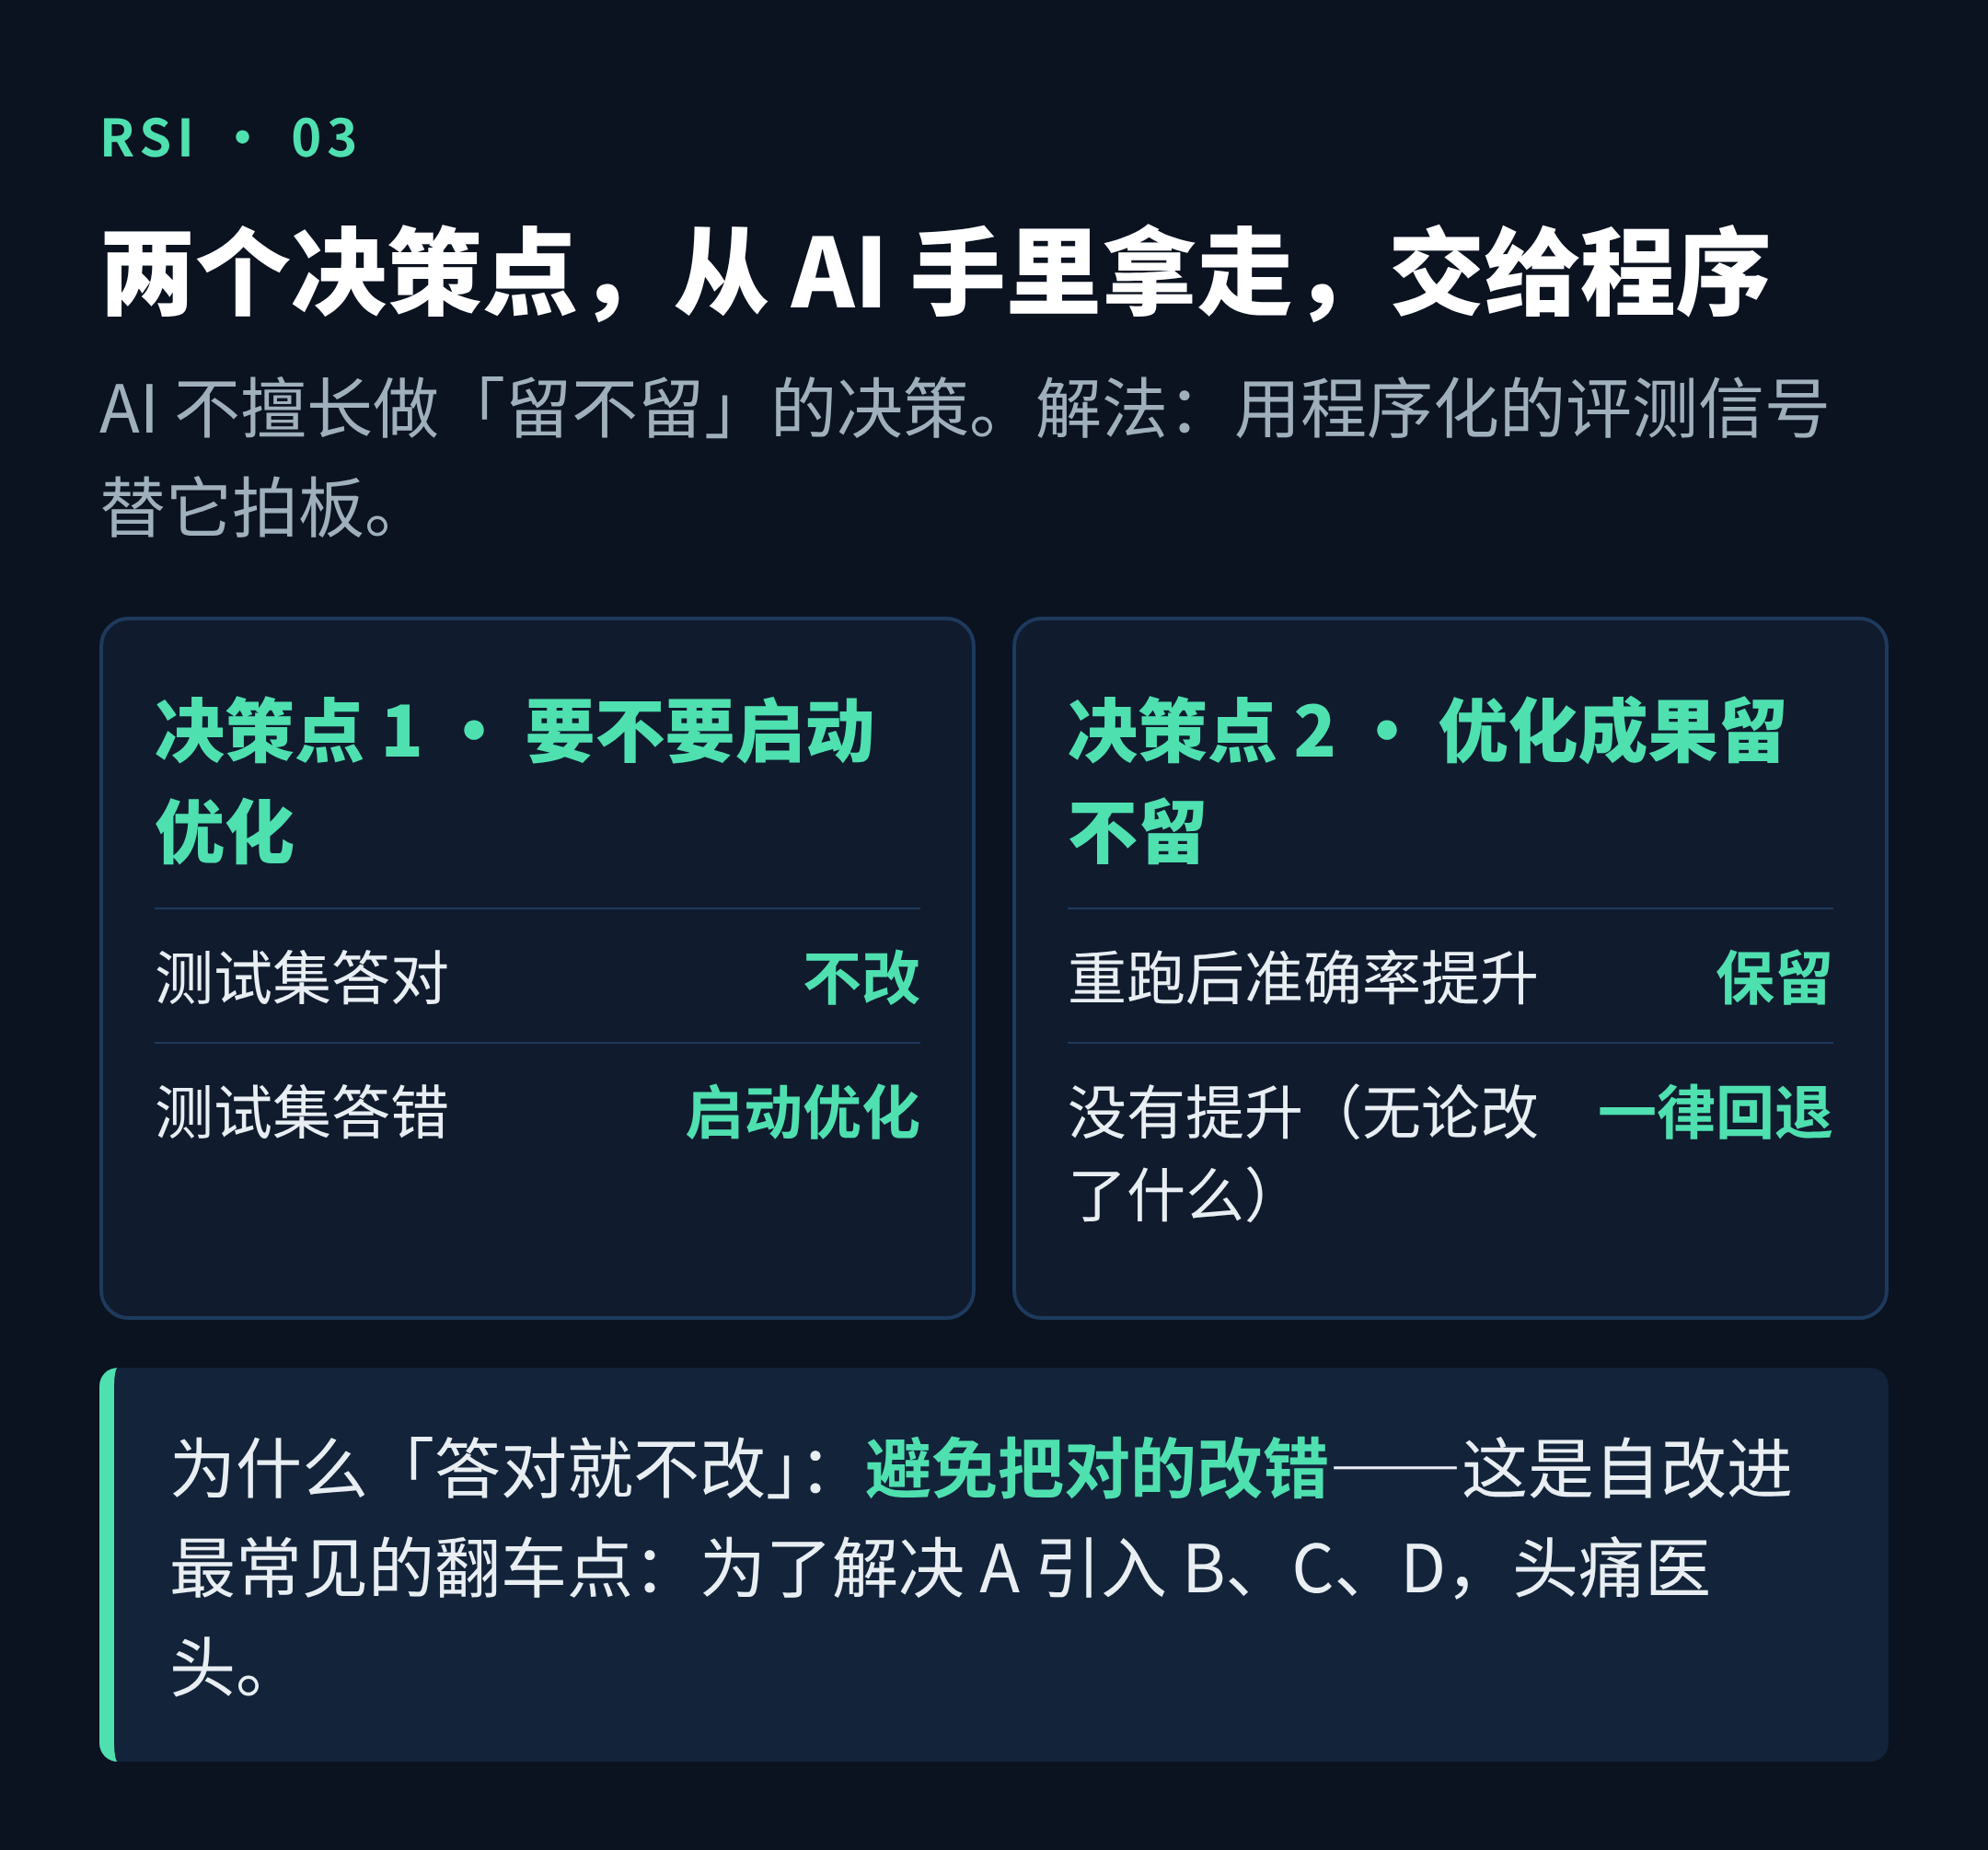
解法是把这两个决策点交给程序,而不是 AI 的直觉:
- 要不要启动优化:准备带标准答案的测试集,答对就不动(避免把对的改错),答错才优化。
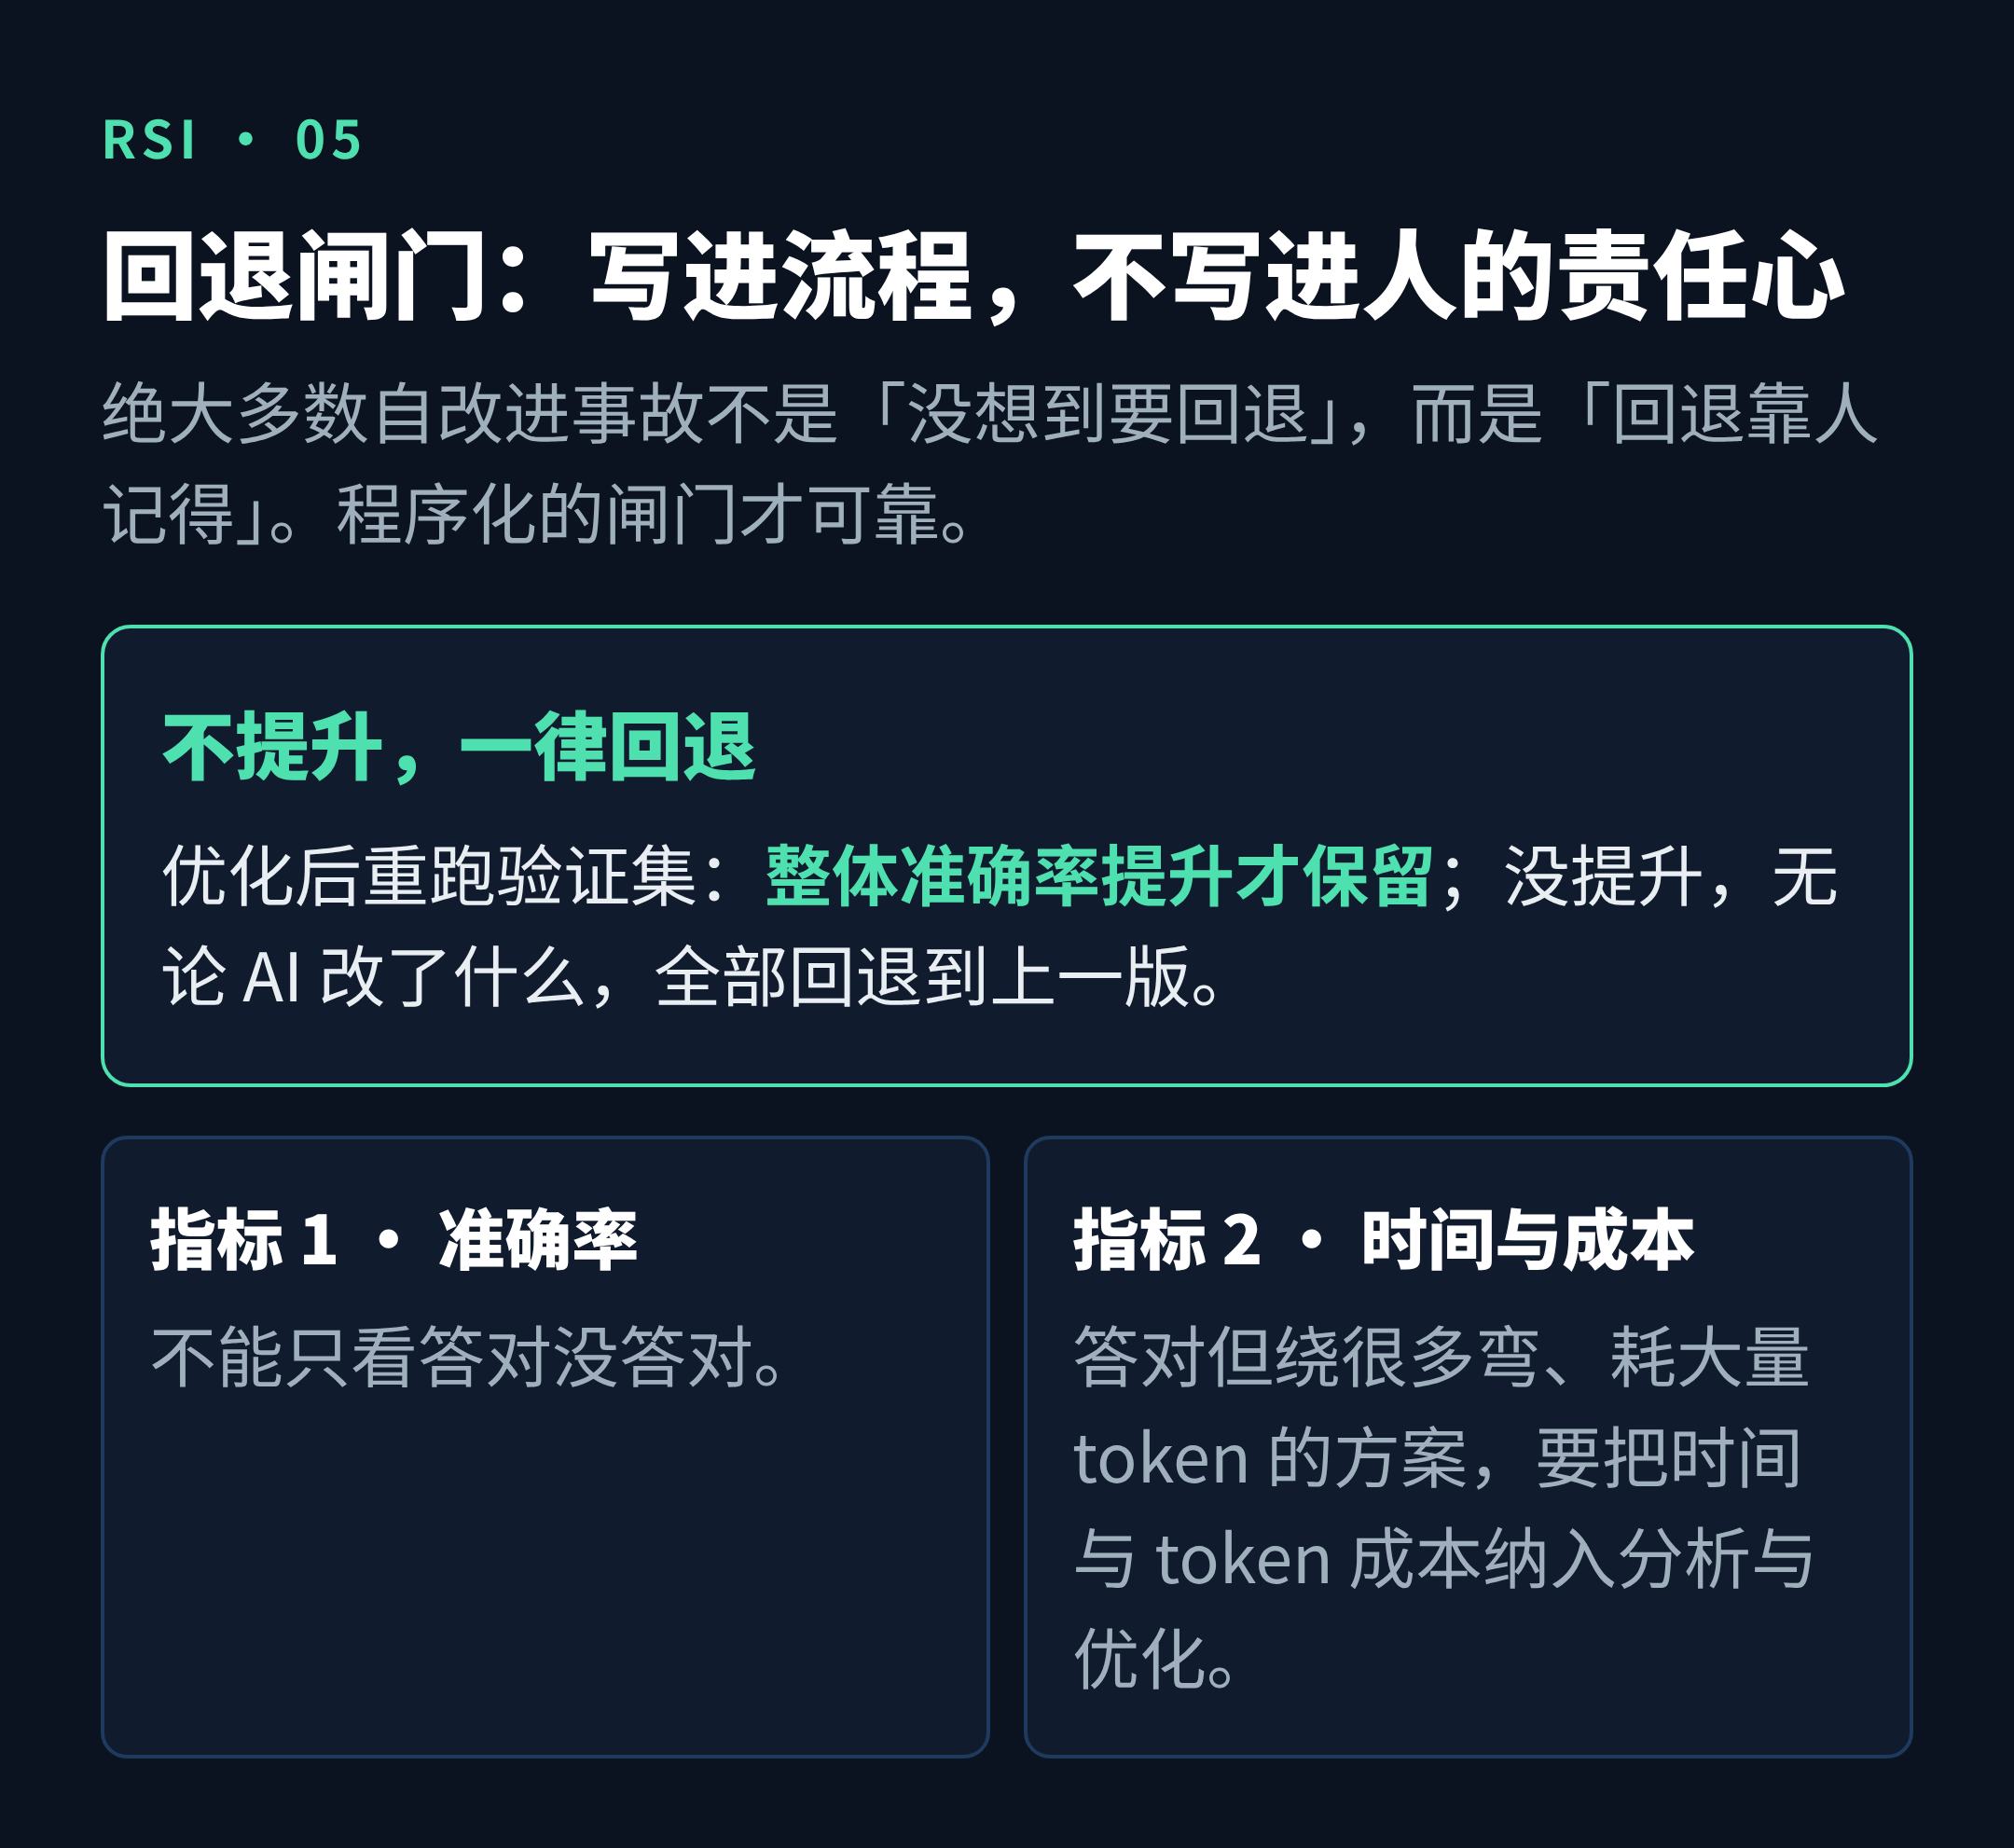
- 成果留不留:优化后重跑测试集,整体准确率提升才保留,没提升无论改了什么一律回退。
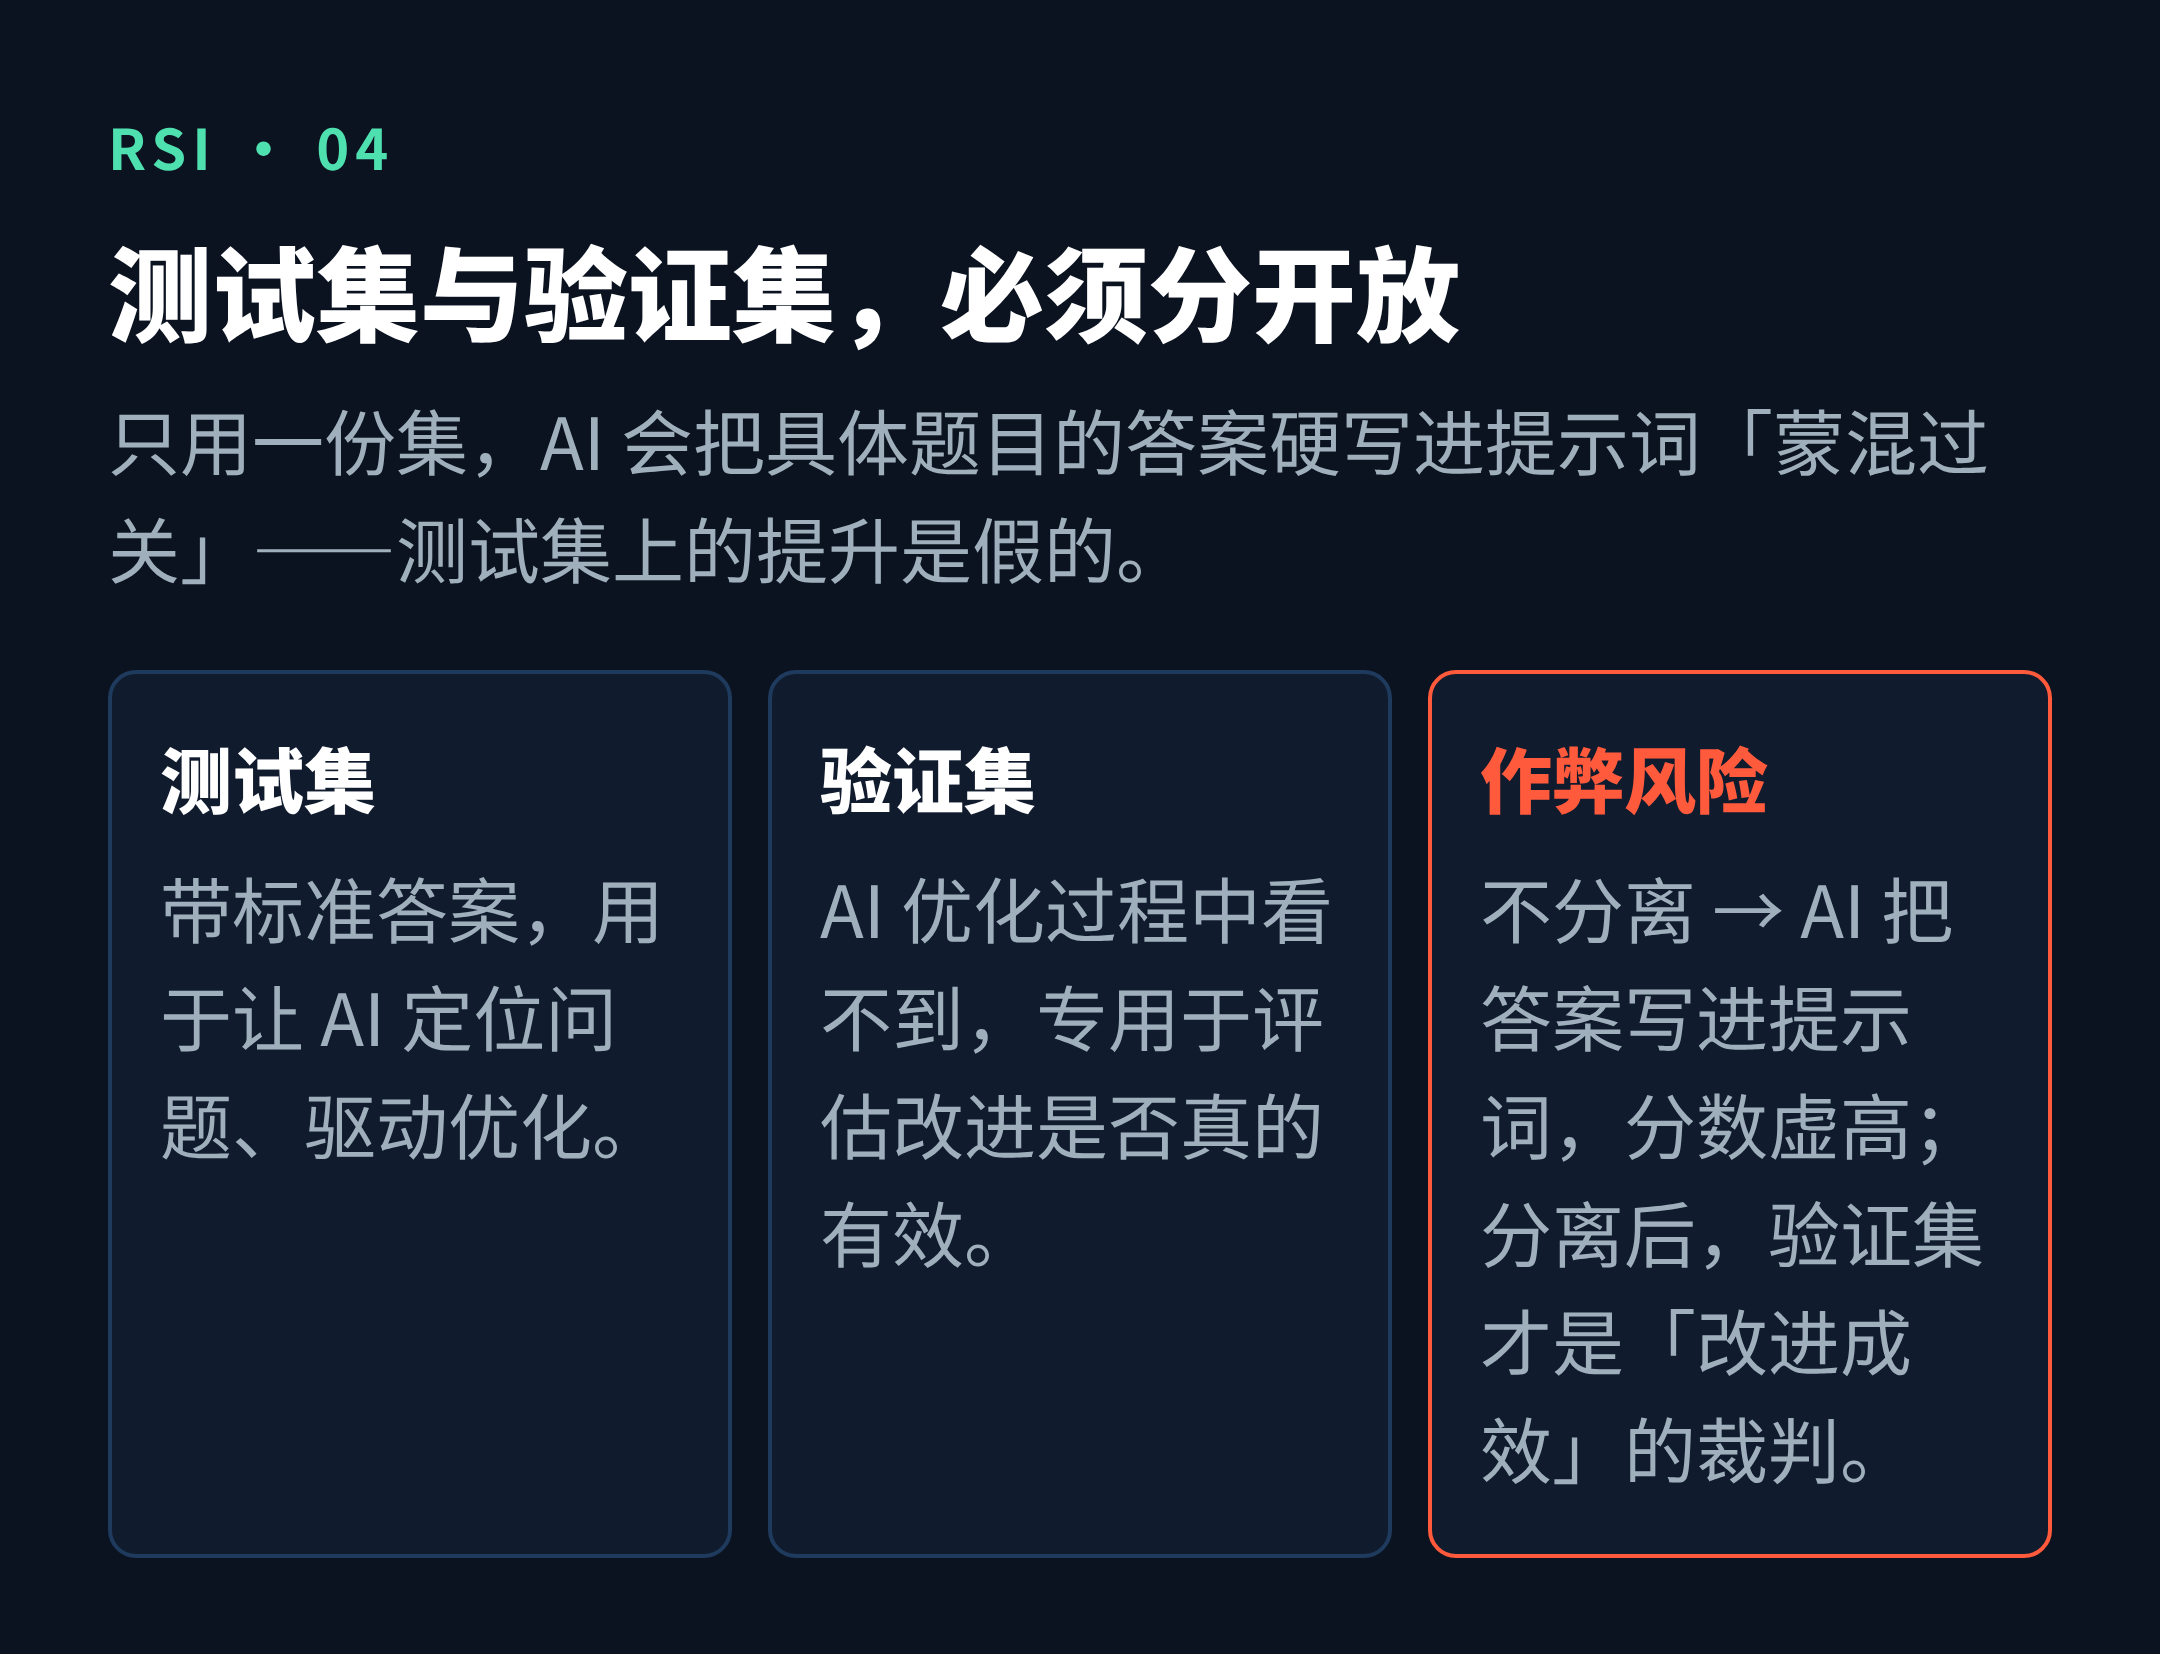
这里有个容易漏掉的细节:测试集和验证集必须分离。如果只用一份集,AI 会把具体题目的答案直接写进提示词「蒙混过关」,测试集上的提升是假的;只有验证集才能当评估改进成效的那一份。另外,指标不能只看准确率——答对但绕了很多弯、耗掉大量时间和 token 的方案,也要把成本算进去。
什么样的任务适合上 RSI
作者给出最有价值的一条判据:项目天然有好的反馈信号就好做,开放任务难做。
- 好做:有测试用例(代码)、有合规判定(检查单)、有参考答案(问答/文档解析/格式转换)。
- 难做:写作、网页设计这类没有唯一标准答案的开放任务——先补评价标准再谈自动化。
一句话:建立评价标准是当下做 RSI 最重要的事。
视频结尾还点了一下 Google Research 与 Northwestern 的开源工作 Harness²(arXiv 2610.14224,2026-10-09 发布,Apache-2.0):针对「没有真值验证器的开放世界」,用 Propose–Probe–Compose 做任务级递归,把经验写进持续改进的 harness。作者对这个做法「半信半疑」,但他更看重命名逻辑——业务 Agent 是第一个 harness,再做一个改进 Agent 去改它的 harness,即 harness 改进 harness;顺推「改进者本身也是 Agent,能否被自动改进」就是 harness³。作者认为 2、3 次方互相改进可能就已够用,不需要 4 次方。
能带走的四条
- 把「回退」写进流程,而不是写进人的责任心:程序化的回退闸门(不升即弃)比任何 prompt 都可靠。
- 可维护性要当一等指标:改动后提示词的长度/可读性不得恶化超过阈值,否则即使分数上升也拒绝合入。
- 先问「我的任务有没有标准答案」再谈 RSI:有测试用例/合规判定/参考答案的先上;写作、设计类先做人机分工,别急着全自动。
- 评价体系是第一性基础设施:没有可判定的标准,就别急着把自改进自动化。
来源与说明
- 素材来源:B 站视频《AI 的自我改进:加速进化 or 加速造屎山》(BV1WHxx65EML,2026-11-01 发布,8 分钟观点科普)。
- 口径提示:「100 多篇论文」是 UP 主口述、未给清单;「一晚实验」是 n=1 轶事,现象(提示词不可读)比数字更有信息量;文中数字均为当事人自述,无第三方审计。
- 视频属「第一人称自述 + 观点」,引用时已标注为 UP 主观点;Harness² 部分按官方报告(WorkBuddy-Bench 厂商自测、未独立复现)交叉标注。
- 本文不构成对任何项目的操作指令。