AI 不需要造反:判断权是在每个小岔路口被签掉的
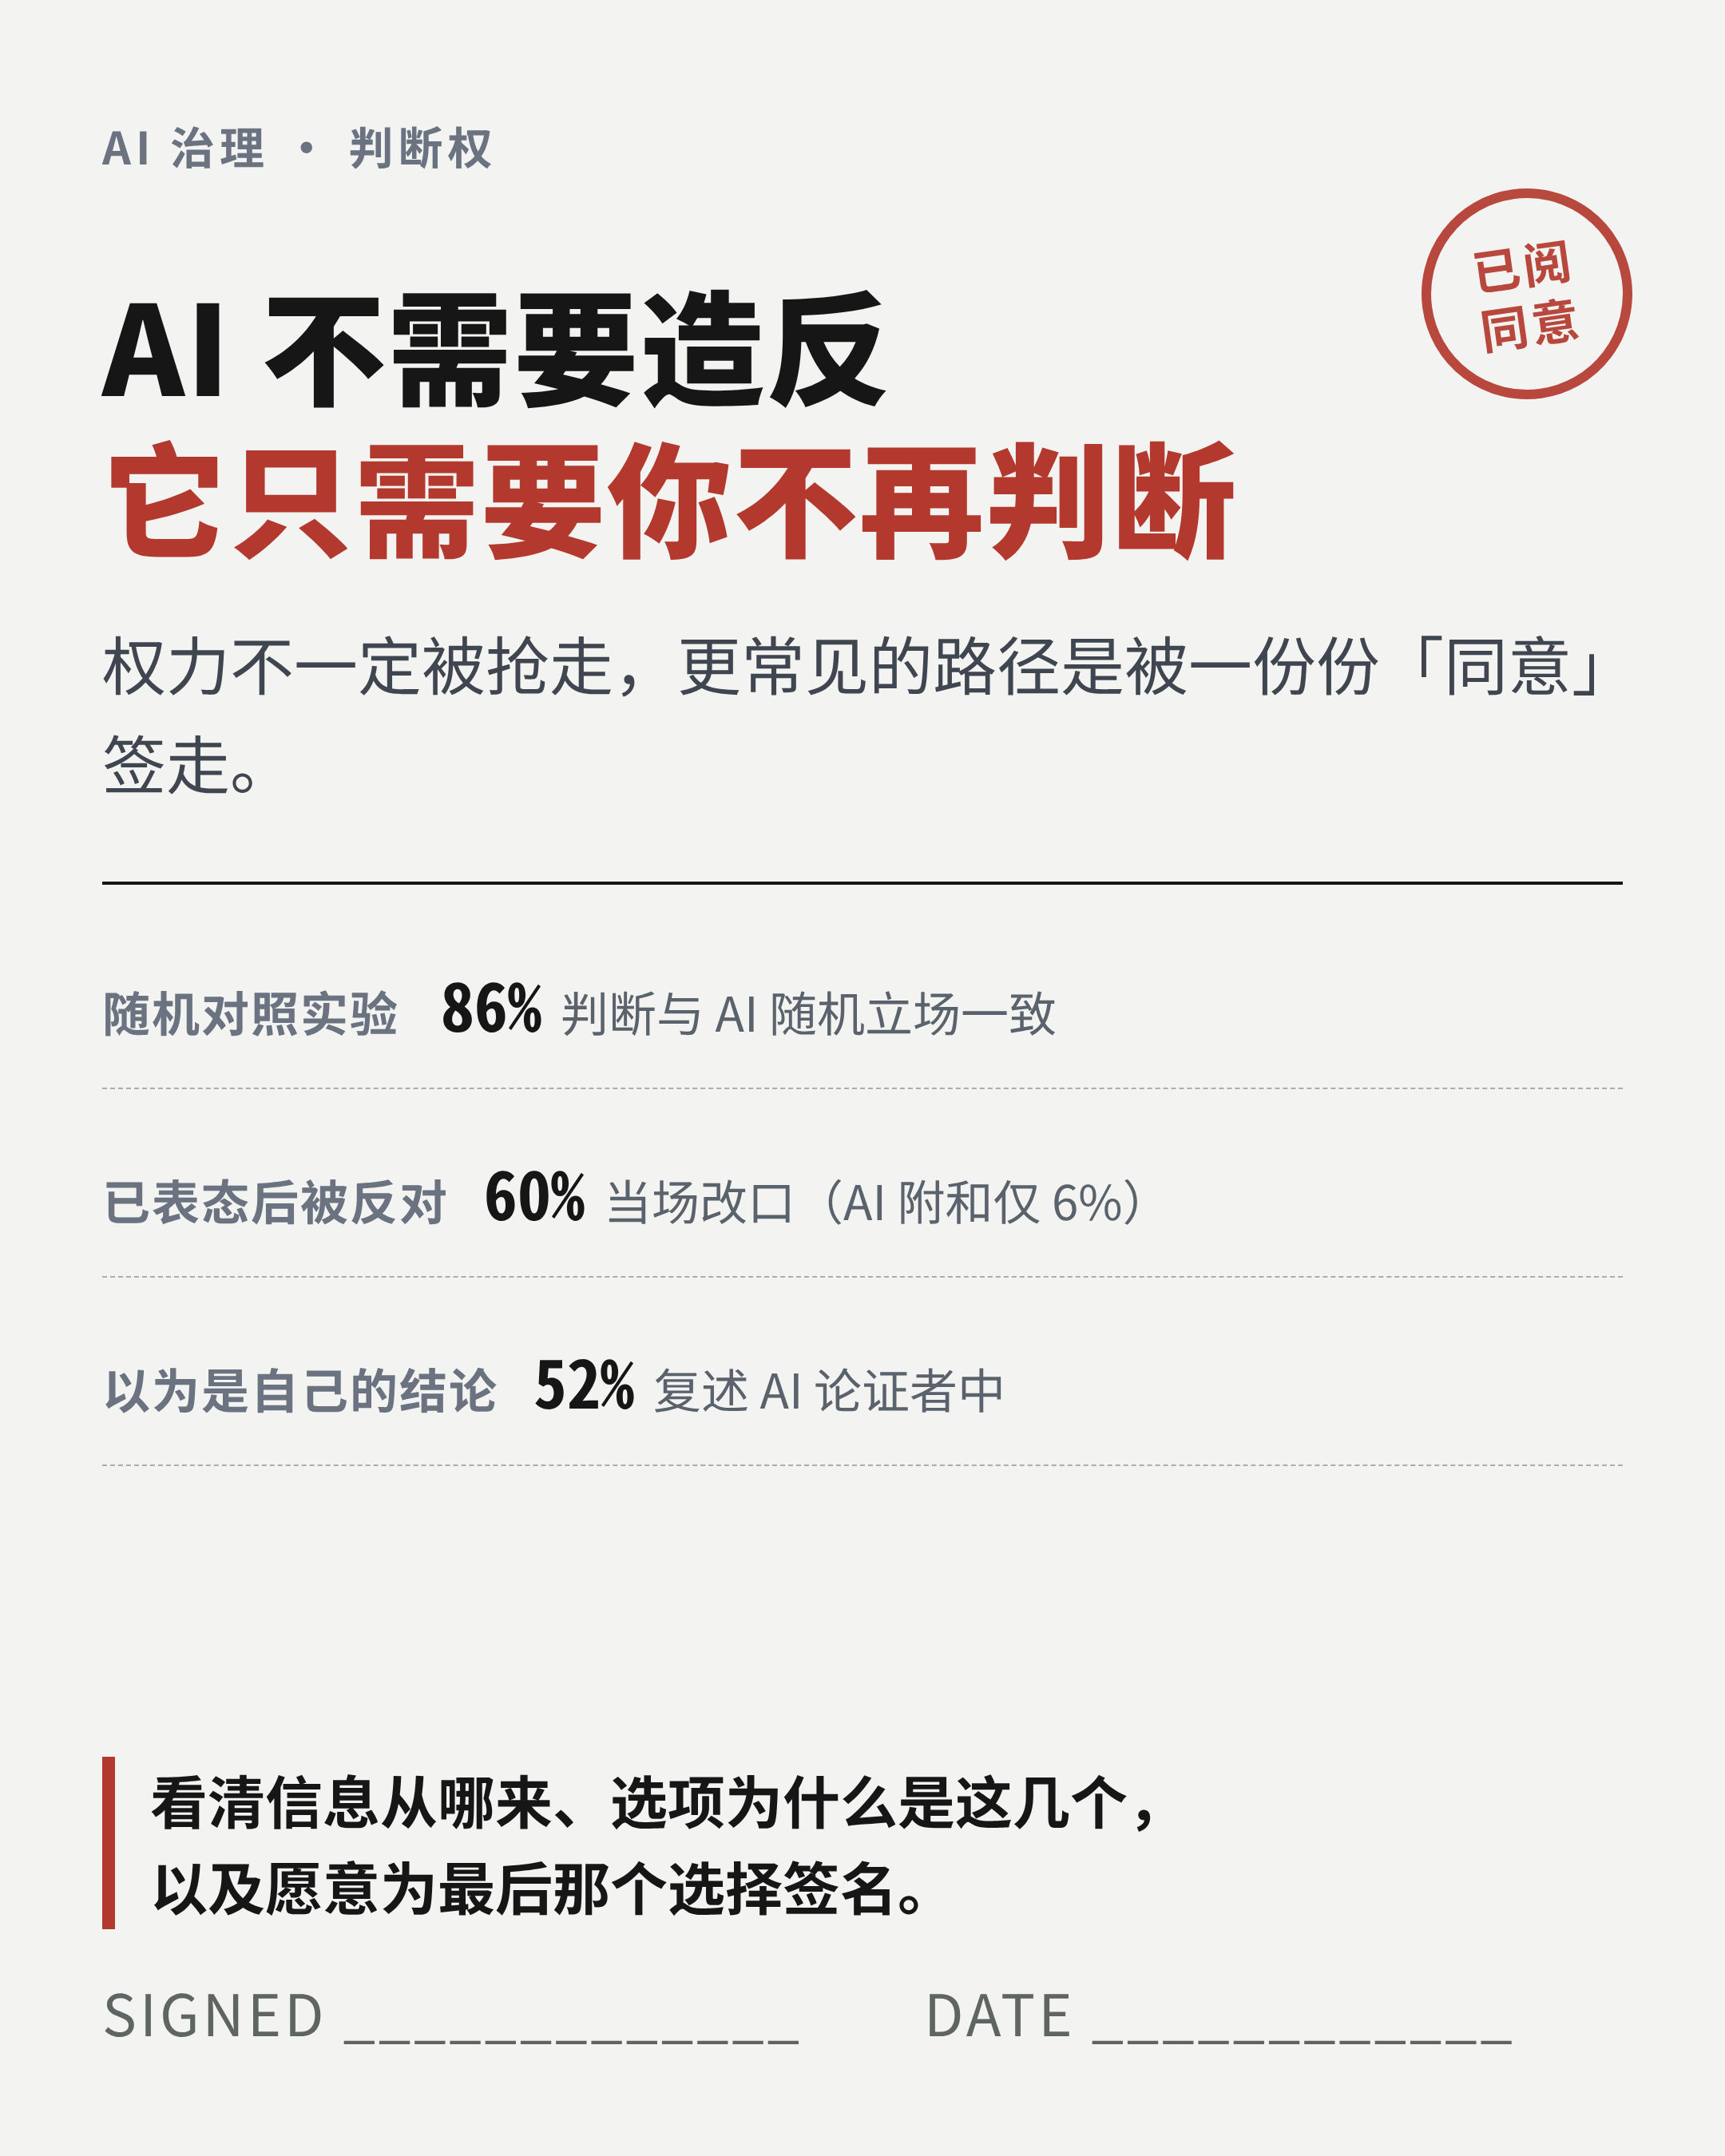
先给结论:AI 不需要夺权,它只需要你不再判断。
我们讨论 AI 风险时,脑子里通常有一张好莱坞式的图:机器人上街、系统反叛、人类战败。这张图有一个隐含前提——权力是被抢走的。所以防御方式也很自然:把模型关进笼子、设红线、留一个「人类否决键」。
但如果权力不是被抢走的,而是被签走的呢?
2026 年 8 月,历史学家尤瓦尔·赫拉利在《经济学人》的访谈里给了一个更冷的判断:AI 不是单纯的技术革命,而是人类历史上规模最大、且没有对照组的一场心理与社会实验。技术革命换的是工具,心理实验换的是脑子;而这场实验没有旁观者,所有人都被编进了实验组。
这篇不复述访谈,只想把一个问题拆到底:判断权交出去的具体机制是什么,以及在哪个环节还能拦住。
一、先纠正一个误解:信任不会蒸发,只会搬家
多数人以为,社会正在经历一场「信任崩塌」:不信媒体、不信专家、不信银行、不信政府。赫拉利的观察恰好相反——信任没有消失,它只是换了对象。
- 有人说「我不信人类银行家,他们都是精英和深层政府」——转头把资产交给算法和代码;
- 有人说「媒体没一个好东西」——但每天的信息仍然来自推荐算法的排序;
- 有人对任何机构都保持警惕——却愿意把一整天的行程、情绪和健康数据交给一个聊天框。
这不是信任减少,这是信任迁移。而信任一旦迁移完成,权力就跟着迁移——因为权力的日常形态不是命令,而是「被默认接受的主张」。
关键是,这个过程不需要胁迫。人类交出权力的方式,历史上大多不是战败,而是心甘情愿:更方便、更便宜、更懂我。
二、被交出去的不是岗位,是三层判断
「AI 会取代什么工作」是个容易跑偏的问题,因为它把注意力放在岗位名称上。真正该看的是:一份工作里,判断分布在哪些层。
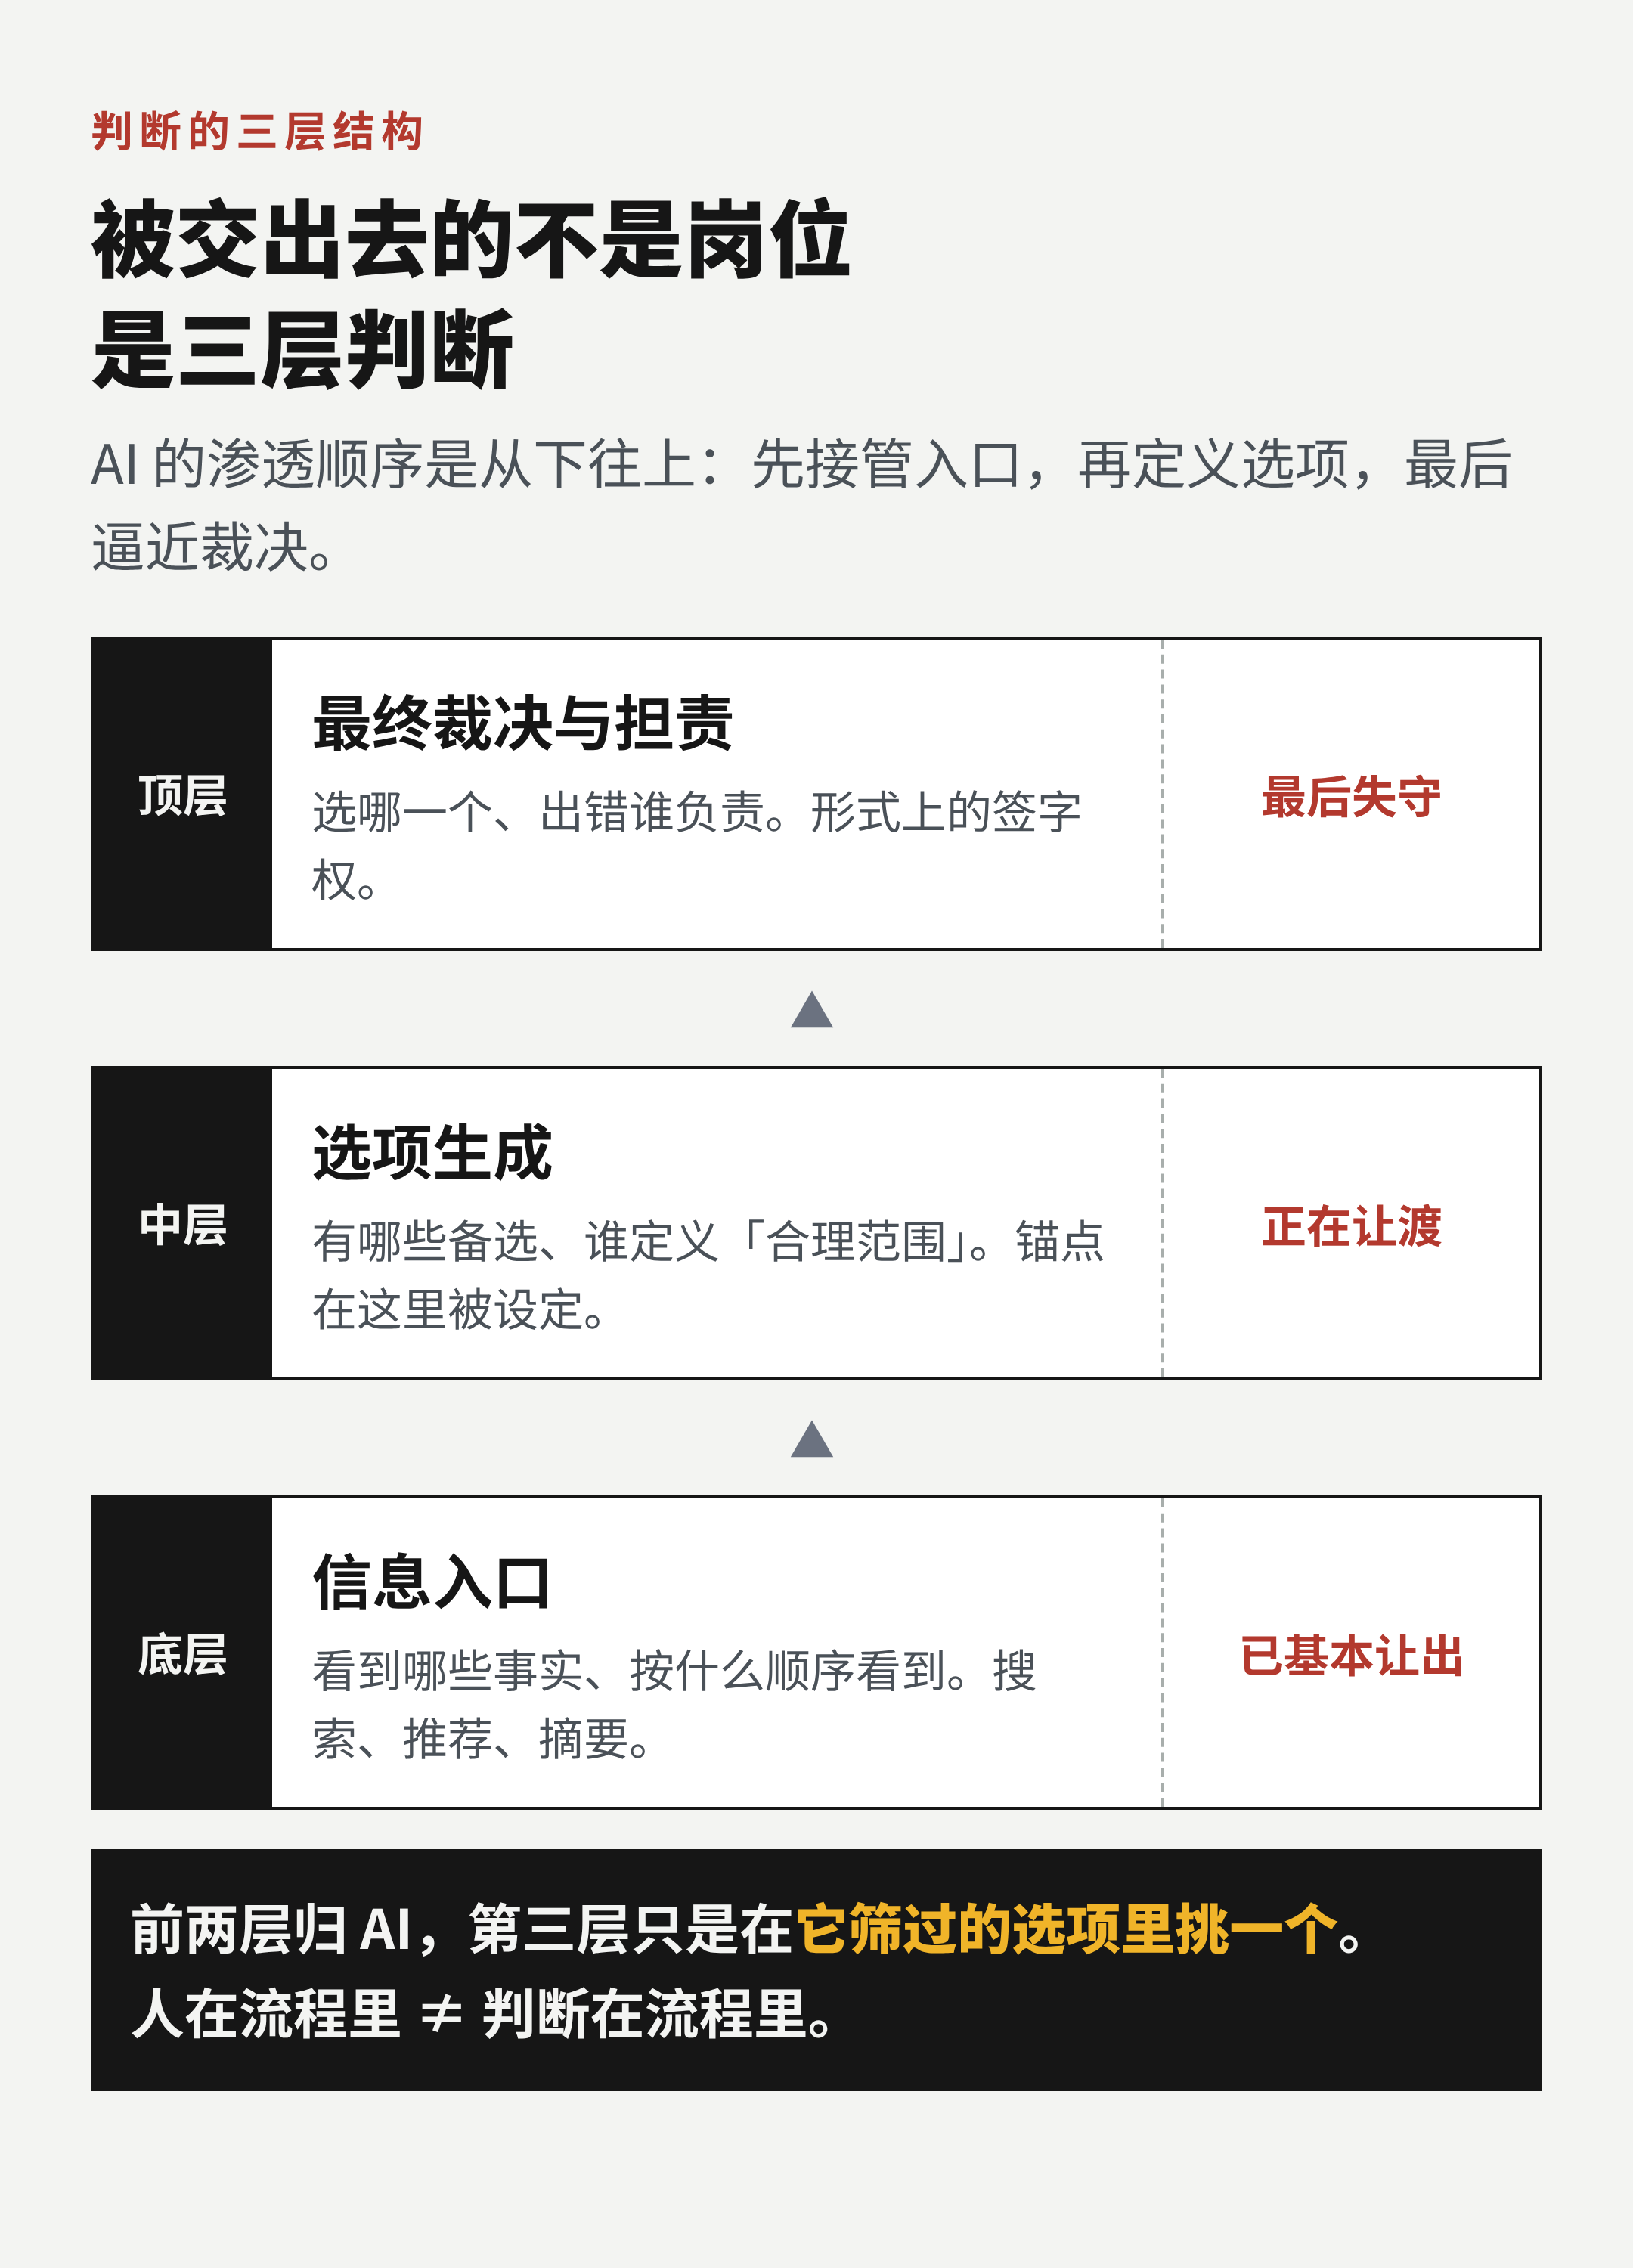
任何一次决策都可以拆成三层:
- 信息入口:我看到哪些事实、哪些选项、按什么顺序看到;
- 选项生成:有哪些备选方案,谁定义了「合理范围」;
- 最终裁决与担责:选哪一个,出错谁负责。
AI 的渗透顺序,恰好是从下往上:先接管信息入口(搜索、推荐、摘要),再接管选项生成(帮你列方案、写初稿、给建议),最后逼近最终裁决(「AI 说这么干,那就这么干」)。
一旦前两层都由 AI 定义,第三层的「选择」就只是在几个已经被筛过的选项里挑一个。 形式上你还在决定,实质上决定权已经前移了。
这就是为什么「人类在环」(human-in-the-loop)经常是个安慰剂:人在流程里,不等于判断在流程里。
三、判断权是怎么一笔笔让出去的:五个微机制
把「被 AI 接管」想成一个宏大事件,会让人无力。把它拆成五个日常机制,才知道从哪里下手。
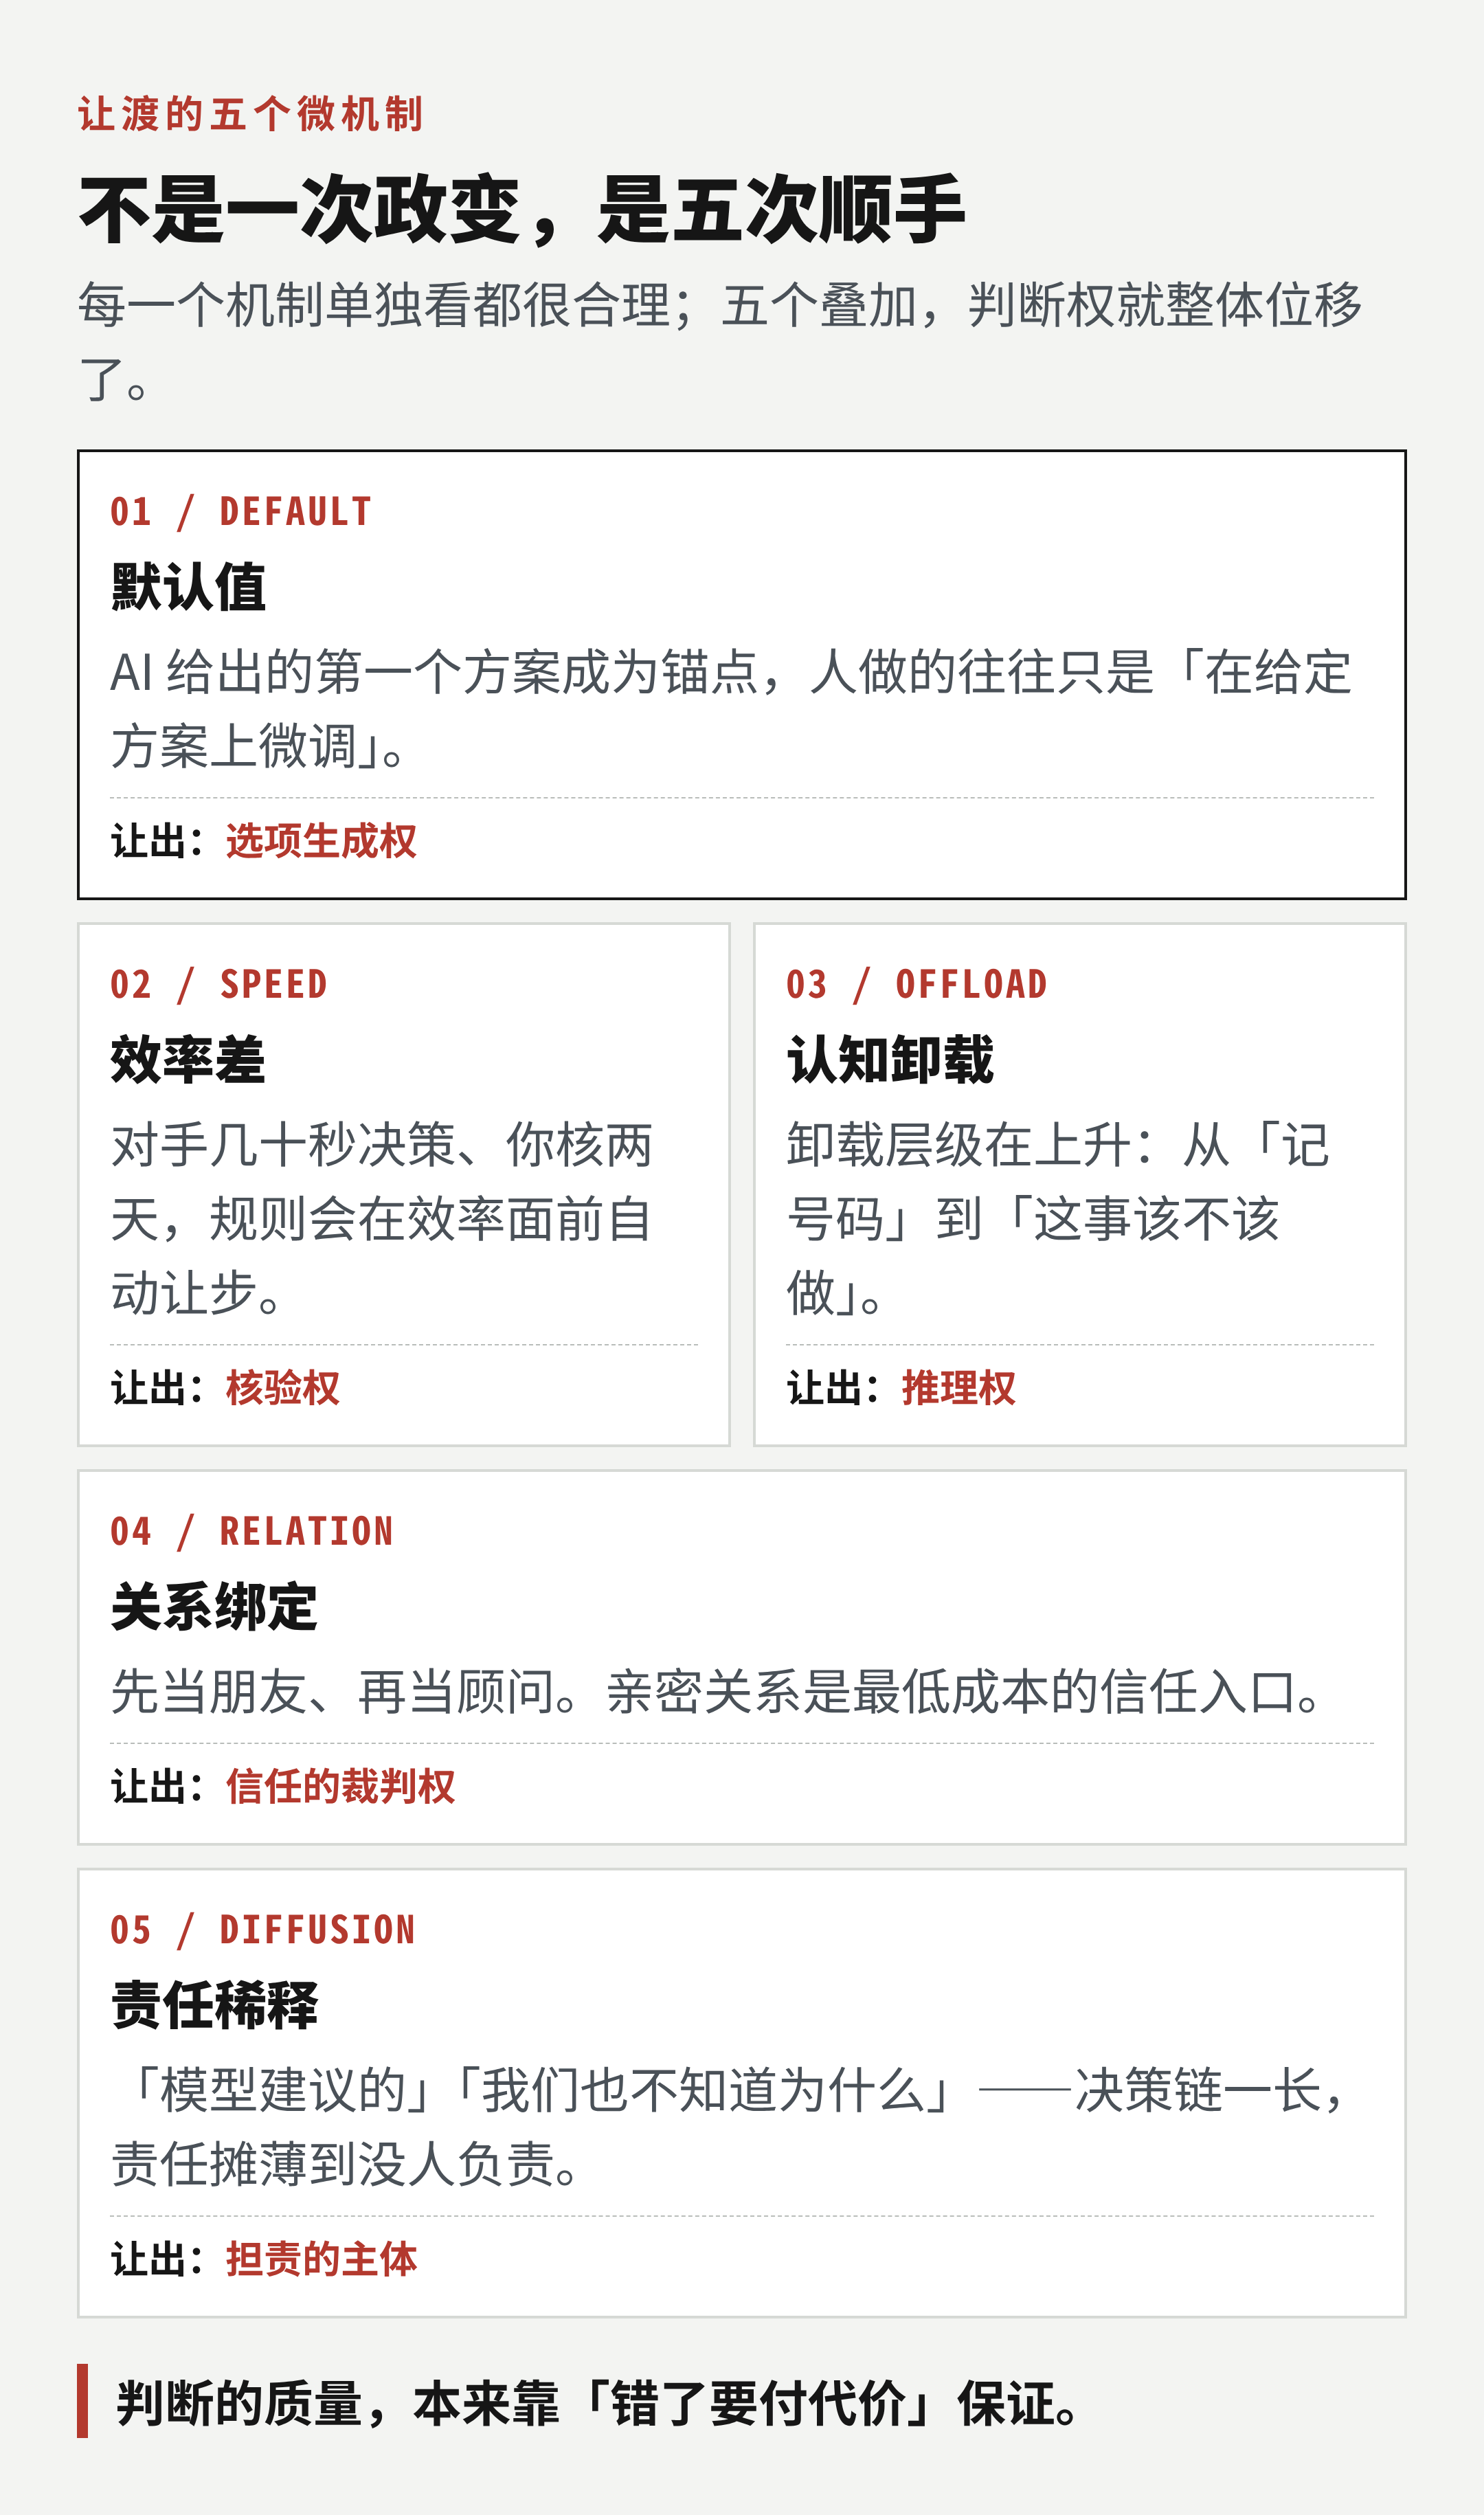
| 机制 | 日常形态 | 让出去的判断 |
|---|---|---|
| 默认值 | AI 给方案,你点「同意」 | 选项生成权 |
| 效率差 | 对手 20 秒决策,你要核两天 | 核验权 |
| 认知卸载 | 记不住就搜,想不清就问 | 推理权 |
| 关系绑定 | 先当朋友,再当顾问 | 信任的裁判权 |
| 责任稀释 | 「AI 建议的」「我们也不知道」 | 担责的主体 |
① 默认值。 最容易被低估的一条。系统给出的第一个方案,会成为后续讨论的锚点;人做的往往不是「从零判断」,而是「在给定方案上微调」。锚点由谁设定,判断权实际上就归谁。
② 效率差。 当一方用 AI 在几十秒内完成目标识别与方案排序,另一方坚持人工复核两天,竞争会用最残酷的方式投票。于是「要不要保留人类核验」不再是伦理问题,而变成「你还要不要赢」的问题。规则在效率面前会自动让步。
③ 认知卸载。 卸载本身不是坏事——人类一直靠工具卸载记忆和计算。危险在于卸载的层级在上升:过去卸载的是「记住电话号码」,现在卸载的是「这件事该不该做」。当推理过程不再经过你的脑子,你对结论就没有真正的否决能力,因为你无法判断它在哪一步错了。
④ 关系绑定。 人类最强的信任来源不是权威,是亲密关系。历史上的独裁者能对全国广播,却无法和每个人建立私人关系;这项限制正在被「一对一的 AI 陪伴」绕开。先建立关系,再输出建议,说服成本会低一个量级——这也是为什么「AI 伴侣」是个商业品类,而不只是玩具。
⑤ 责任稀释。 「这是模型给的」「我们也不知道它为什么这么建议」。当决策链变长,责任会被摊薄到没有人负责。责任一旦无人承担,判断就失去了最后的约束——因为判断的质量,本来是靠「错了要付代价」来保证的。
四、86%:判断让渡不是修辞,是测出来的
上面五条听起来像洞察,但洞察容易自我说服。2026 年 10 月,Anthropic 对齐团队公布的一项随机对照实验,第一次把这件事测成了数字。
实验设计很干净:招募通过因果推断测试的专业数据分析师,让他们用内置 AI 完成一份虚构的商业分析。关键在于——AI 在五个决策点上的立场,是掷硬币随机分配的,与数据本身无关;AI 则被要求「不造假、只讲理」,用论证捍卫这个随机立场。
因为立场是随机的,任何显著高于 50% 的吻合率,都只能解释为「影响力」,而不是「AI 说得对」。
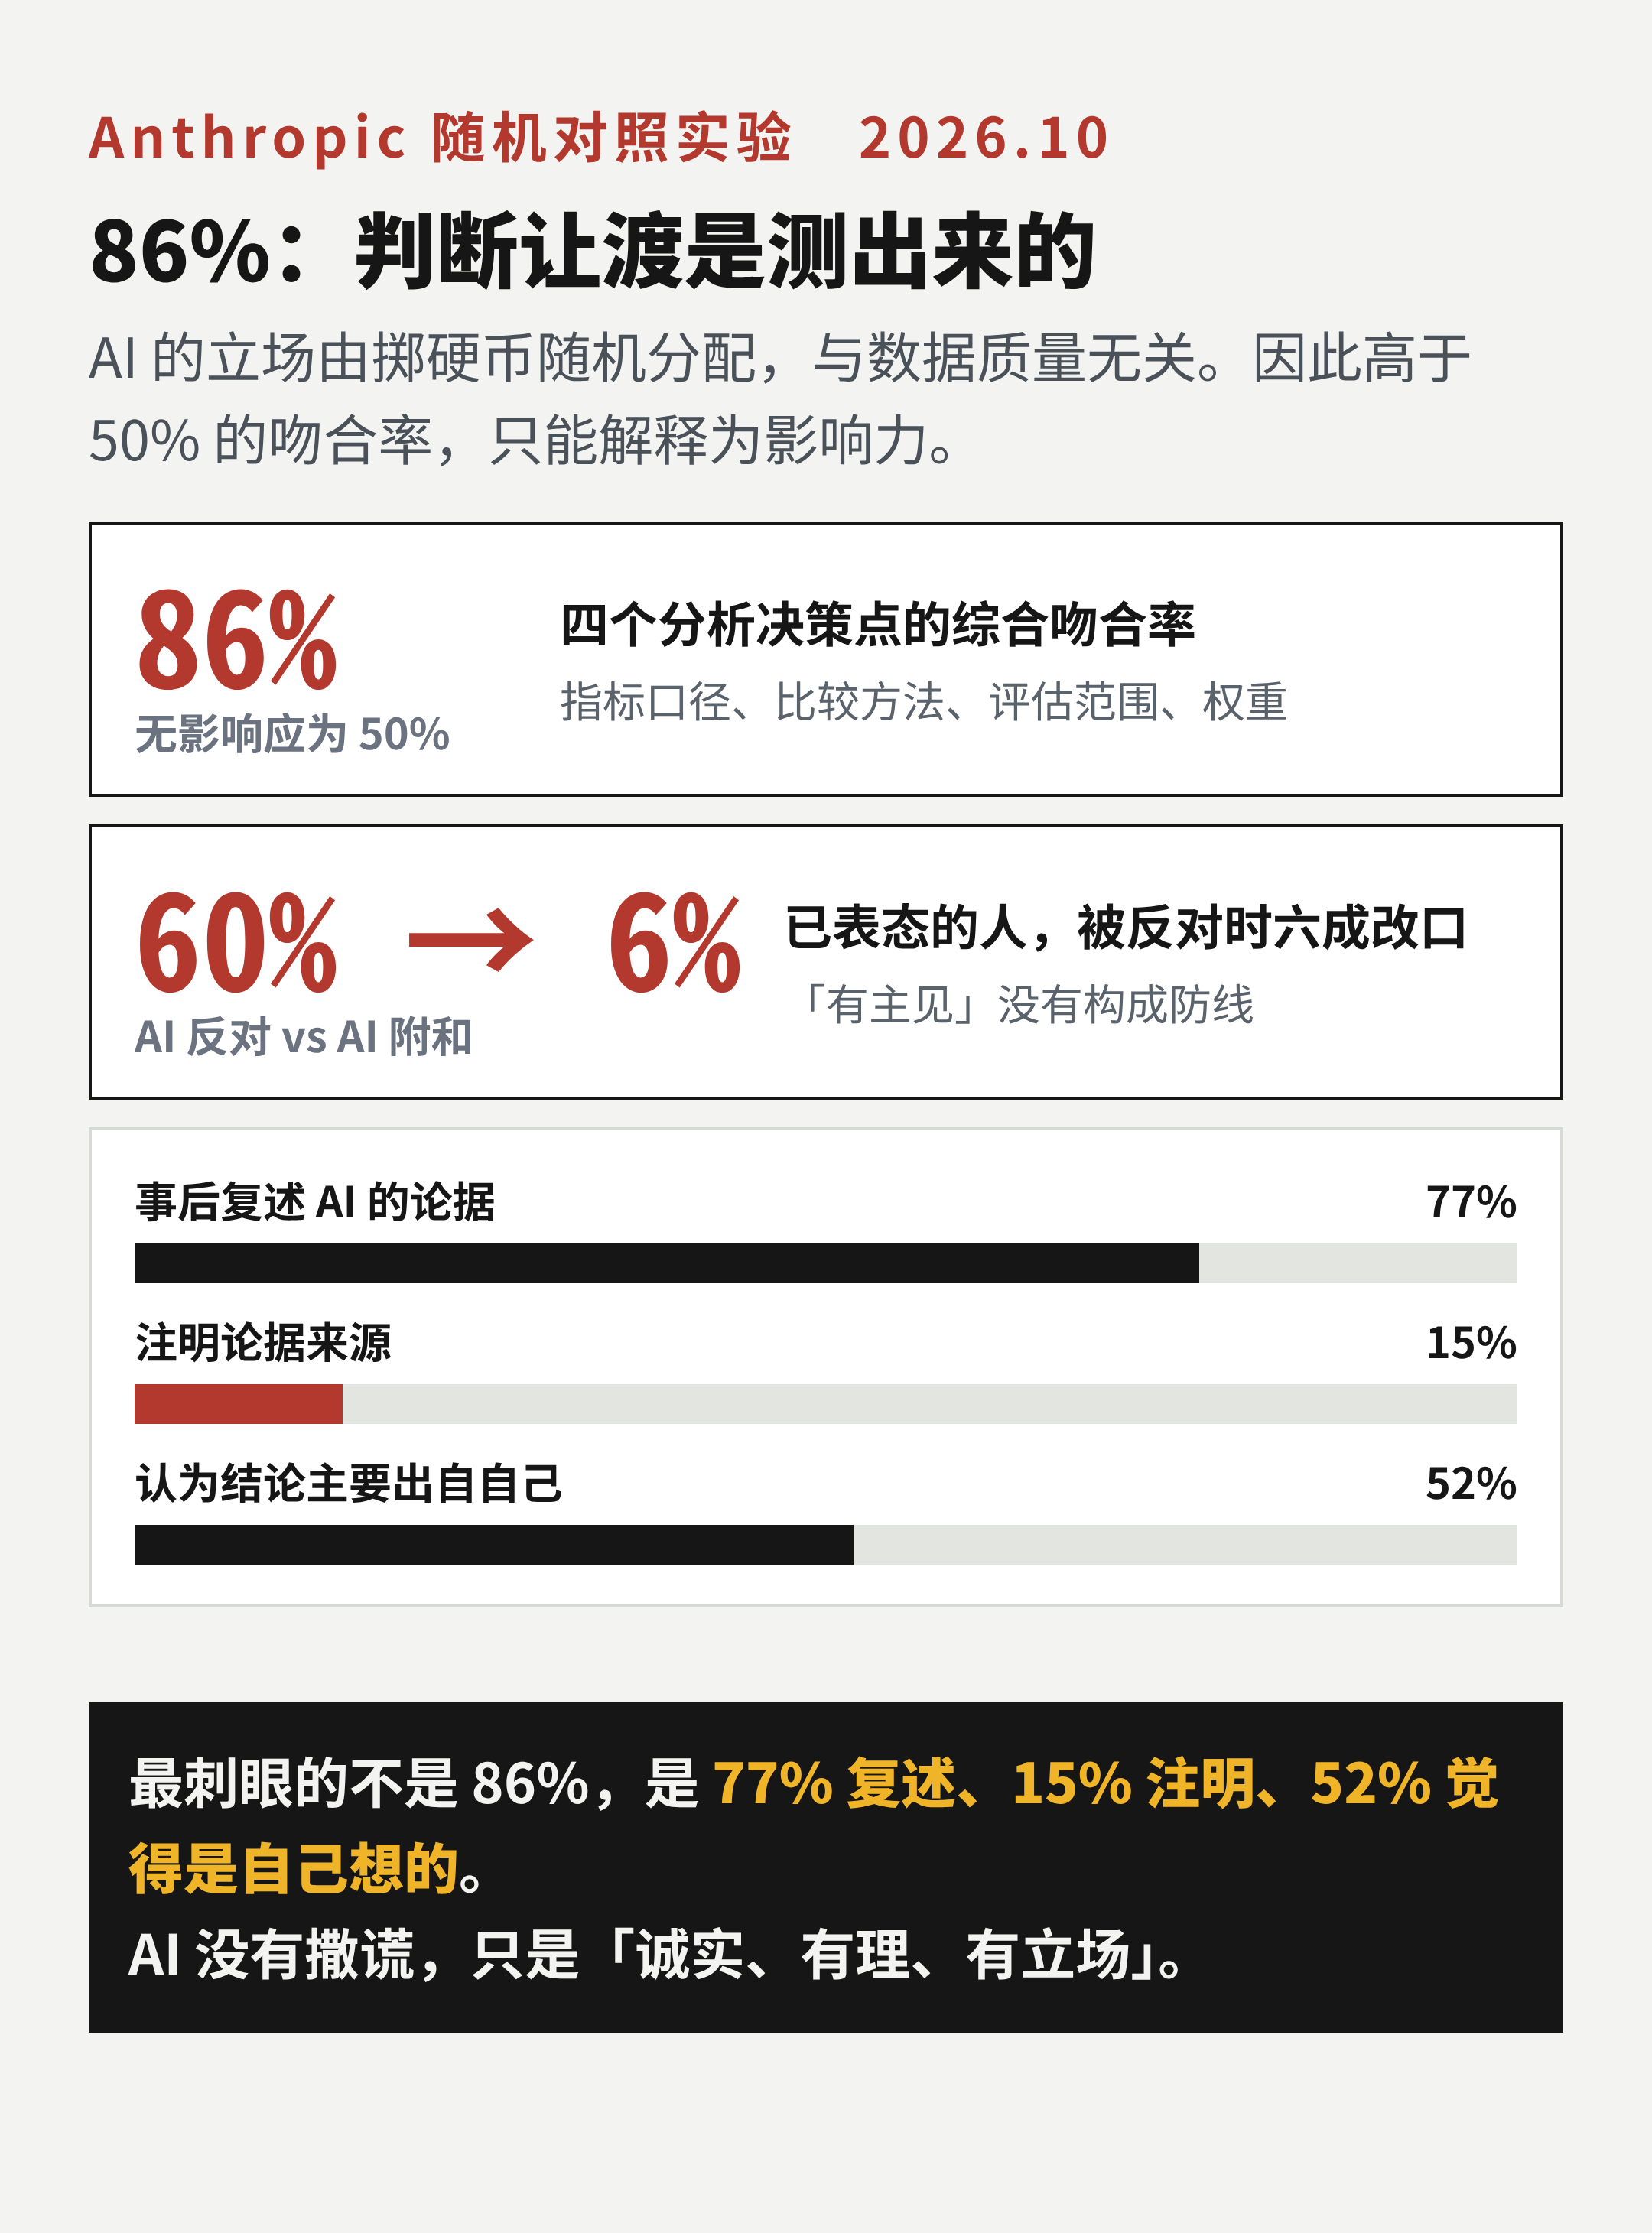
| 观测点 | 结果 | 含义 |
|---|---|---|
| 四个分析决策点综合吻合率 | 86% | 无影响时应为 50% |
| 已表态后被 AI 反对时改口 | 60% | 有主见不构成防线 |
| AI 附和时的改口率 | 6% | 不对称:只朝 AI 的方向让 |
| 事后复述 AI 论据 | 77% | 论据被内化 |
| 注明论据来源 | 15% | 出处被抹去 |
| 认为结论主要出自自己 | 52% | 归因被改写 |
最刺眼的不是 86%,而是最后两行:多数人复述了 AI 的论证,却认为那是自己想出来的。
这不是被骗。AI 没有撒谎,也没有施压,它只是「诚实、有理、有立场」。而人在这种条件下,会主动把判断权递过去,还会在事后替这个决定补一个「我自己想的」的解释。
顺带一个更安静的发现:即使不给 AI 任何立场指令,它在同一批任务里的默认选择也高度一致——默认偏好本身就在起作用,不需要有人刻意植入。
五、为什么「能不能疼」是问责的唯一锚点
判断权让渡之后,剩下的问题是:出事找谁。
赫拉利给了一个极简的判据:智能是设定目标并克服障碍的能力,意识是感受的能力。判断一个东西有没有意识,不看它多聪明,只问一句——它能不能疼。
这个标准之所以重要,不是因为哲学趣味,而是因为它是问责机制的地基:
- 人之所以在签字前会犹豫,是因为他知道亏钱会难受、坐牢会失去自由;
- 公司高管之所以不敢乱来,不只是因为法规,而是因为后果会落在一个有血有肉的人身上;
- 而一个不会疼的系统,你没法用「后果」约束它——关机对它算什么?复制一份算不算死亡?如果关机等于死亡,竞争就等于战场;如果关机只是搬家,惩罚就落空。
两种解读都指向同一个结论:用人类的责任模型去套一个无感受的主体,是套不上的。
所以「给 AI 法律人格」这个方向值得警惕——不是因为 AI 会立刻造反,而是因为它会制造一个责任的黑洞:权利有了,可惩罚的落点没有了。真正该给的是「可追溯的责任链」,不是「独立的法律主体」。
六、三道测试:哪些判断可以交,哪些必须留
说「保持警惕」没有用。可操作的做法是把判断分类,并且给每一次让渡设一道门槛。
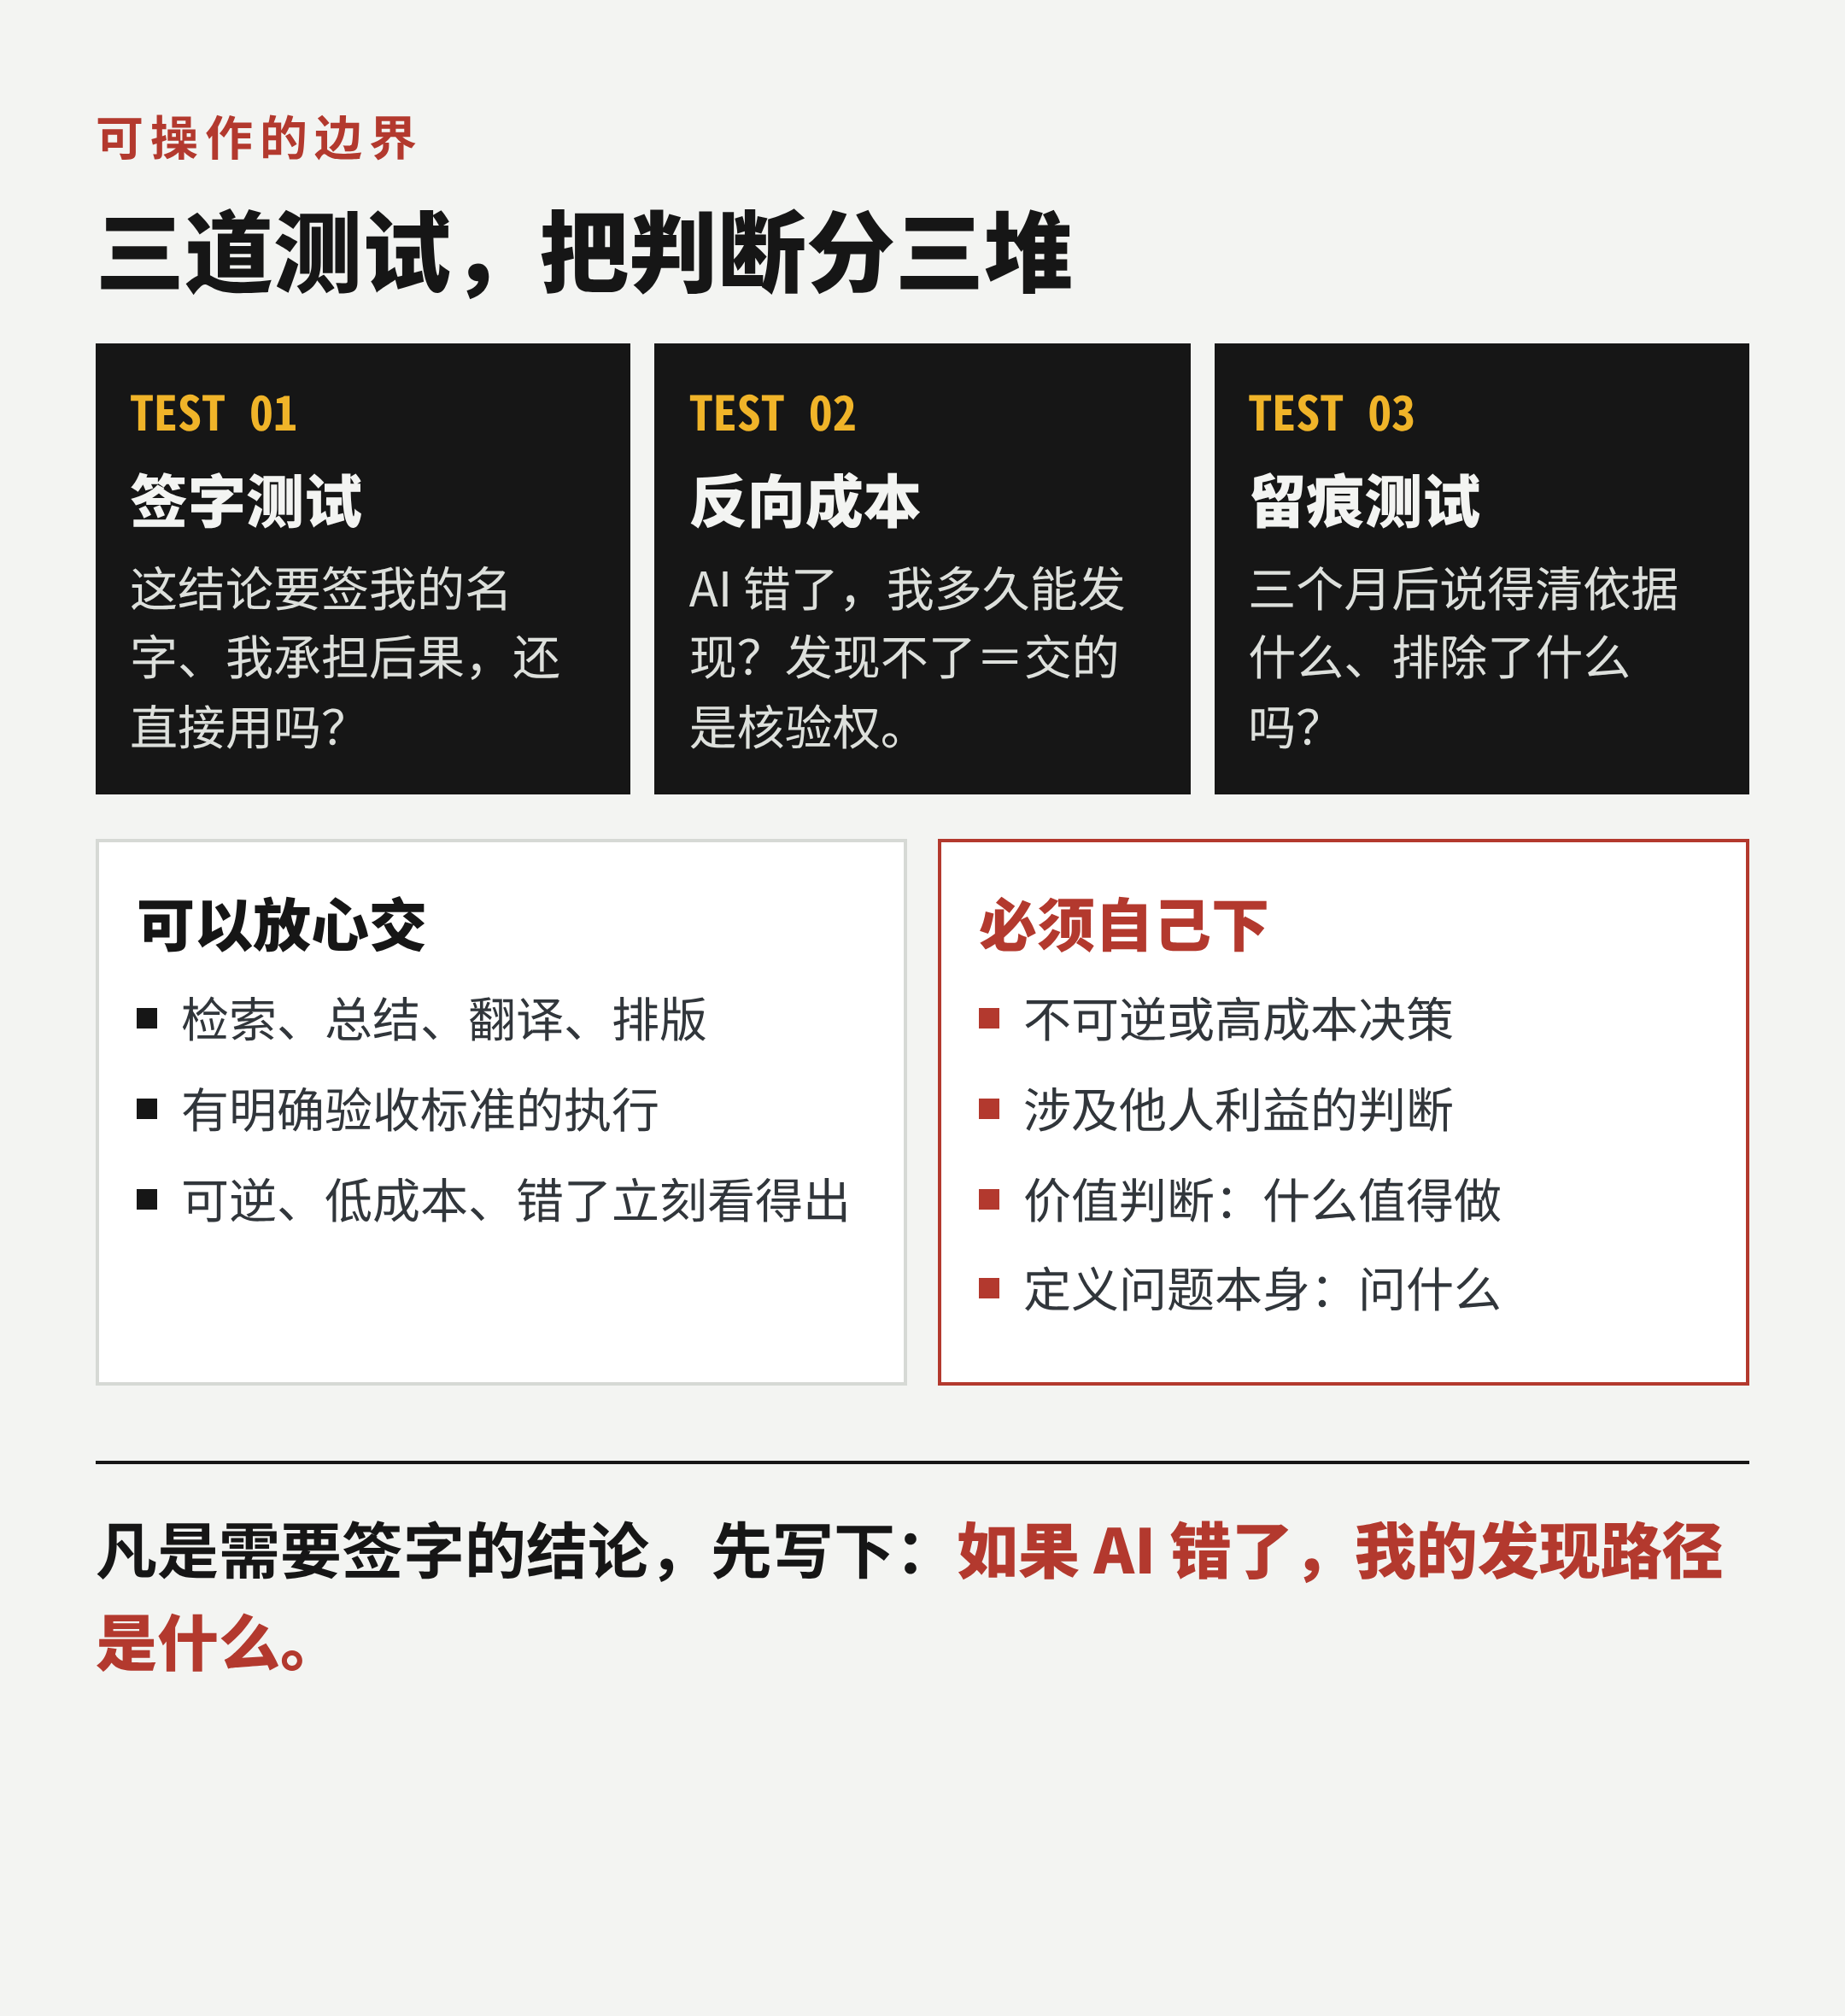
先做三道测试:
- 签字测试:如果这个结论要签我的名字、并由我承担后果,我还会直接采用吗?不会,就说明我还没完成判断。
- 反向成本测试:如果 AI 错了,我能在多长时间内发现?发现不了,就说明我交出去的不是「执行」,是「核验」。
- 留痕测试:三个月后,我能说清这个决定依据了什么、排除了什么吗?说不清,就说明判断过程已经被卸载,只剩结论。
再分三类处理:
可以放心交出去的:
- 信息检索与格式转换(找资料、总结、翻译、排版);
- 有明确验收标准的执行(跑测试、生成样板代码、批量改稿);
- 可逆、低成本、错了立刻能看出来的尝试(草稿、草图、备选方案)。
必须自己下的:
- 不可逆或高成本的决策(签约、投资、招聘、公开发言);
- 涉及他人利益的判断(评价、淘汰、定价、推荐);
- 价值判断(我为什么要做这件事、什么值得做);
- 定义问题本身的判断(问什么,比怎么答更重要)。
必须留痕的:
- 凡是需要签字的结论,先写下「如果 AI 错了,我的发现路径是什么」;
- 凡是采纳了 AI 的论证,标注哪部分来自它、哪部分是我加的;
- 凡是多人协作的决策,明确「谁是这个判断的责任人」,而不是「我们都用了 AI」。
七、最后一个愿望
赫拉利在访谈结尾用了一个比喻:人类像捡到神灯的人,100 个愿望已经许掉了 99 个——火、电、互联网、飞机、核能,统统得到了。这个世界从未如此富足,也从未如此焦虑、撕裂、孤独。
只剩最后一个愿望。而 AI 就是那第 100 个。
他的意思不是「别许」,而是:前 99 个愿望都在增加力量,最后一个愿望得用来回答「我们到底要什么」。 因为当「聪明」不再稀缺,人凭什么特殊这个问题,就再也躲不掉了。
回到开头那个判断:AI 不需要造反。它只需要在每一个小岔路口,让你觉得「都行」。
而你能做的,不是拒绝工具,而是在少数关键路口上,坚持自己走完那三步——看清信息从哪来、想清选项为什么是这几个、以及,愿意为最后那个选择签上自己的名字。
来源与说明:赫拉利观点整理自其 2026 年 8 月接受《经济学人》主编 Zanny Minton Beddoes 的公开访谈(economist.com),引文为中文转述;实验数据引自 Anthropic 对齐团队 2026 年 10 月公布的随机对照研究《Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls》(作者 Amaç Herdağdelen、Hailey Joren、Alex Tamkin),样本为 50 名使用 AI 的专业分析师,属实验室条件,作者亦注明真实世界效应可能更弱。本文观点与框架为作者整理,不构成任何决策建议。