Vibe-Research:把投研工作台搬回自己的电脑
我做过一个实验:打开电脑,数一数研究一家公司要用到几个窗口。
行情软件一个,财报 PDF 一个,公告网页一个,券商研报一个,Excel 一个,再加上一个 AI 聊天窗口。六个窗口之间靠人脑搬运,而人脑最不擅长的就是搬运——数字会抄错,口径会记混,三天前看过的那个数,三天后已经想不起来是从哪份报告第几页看来的。
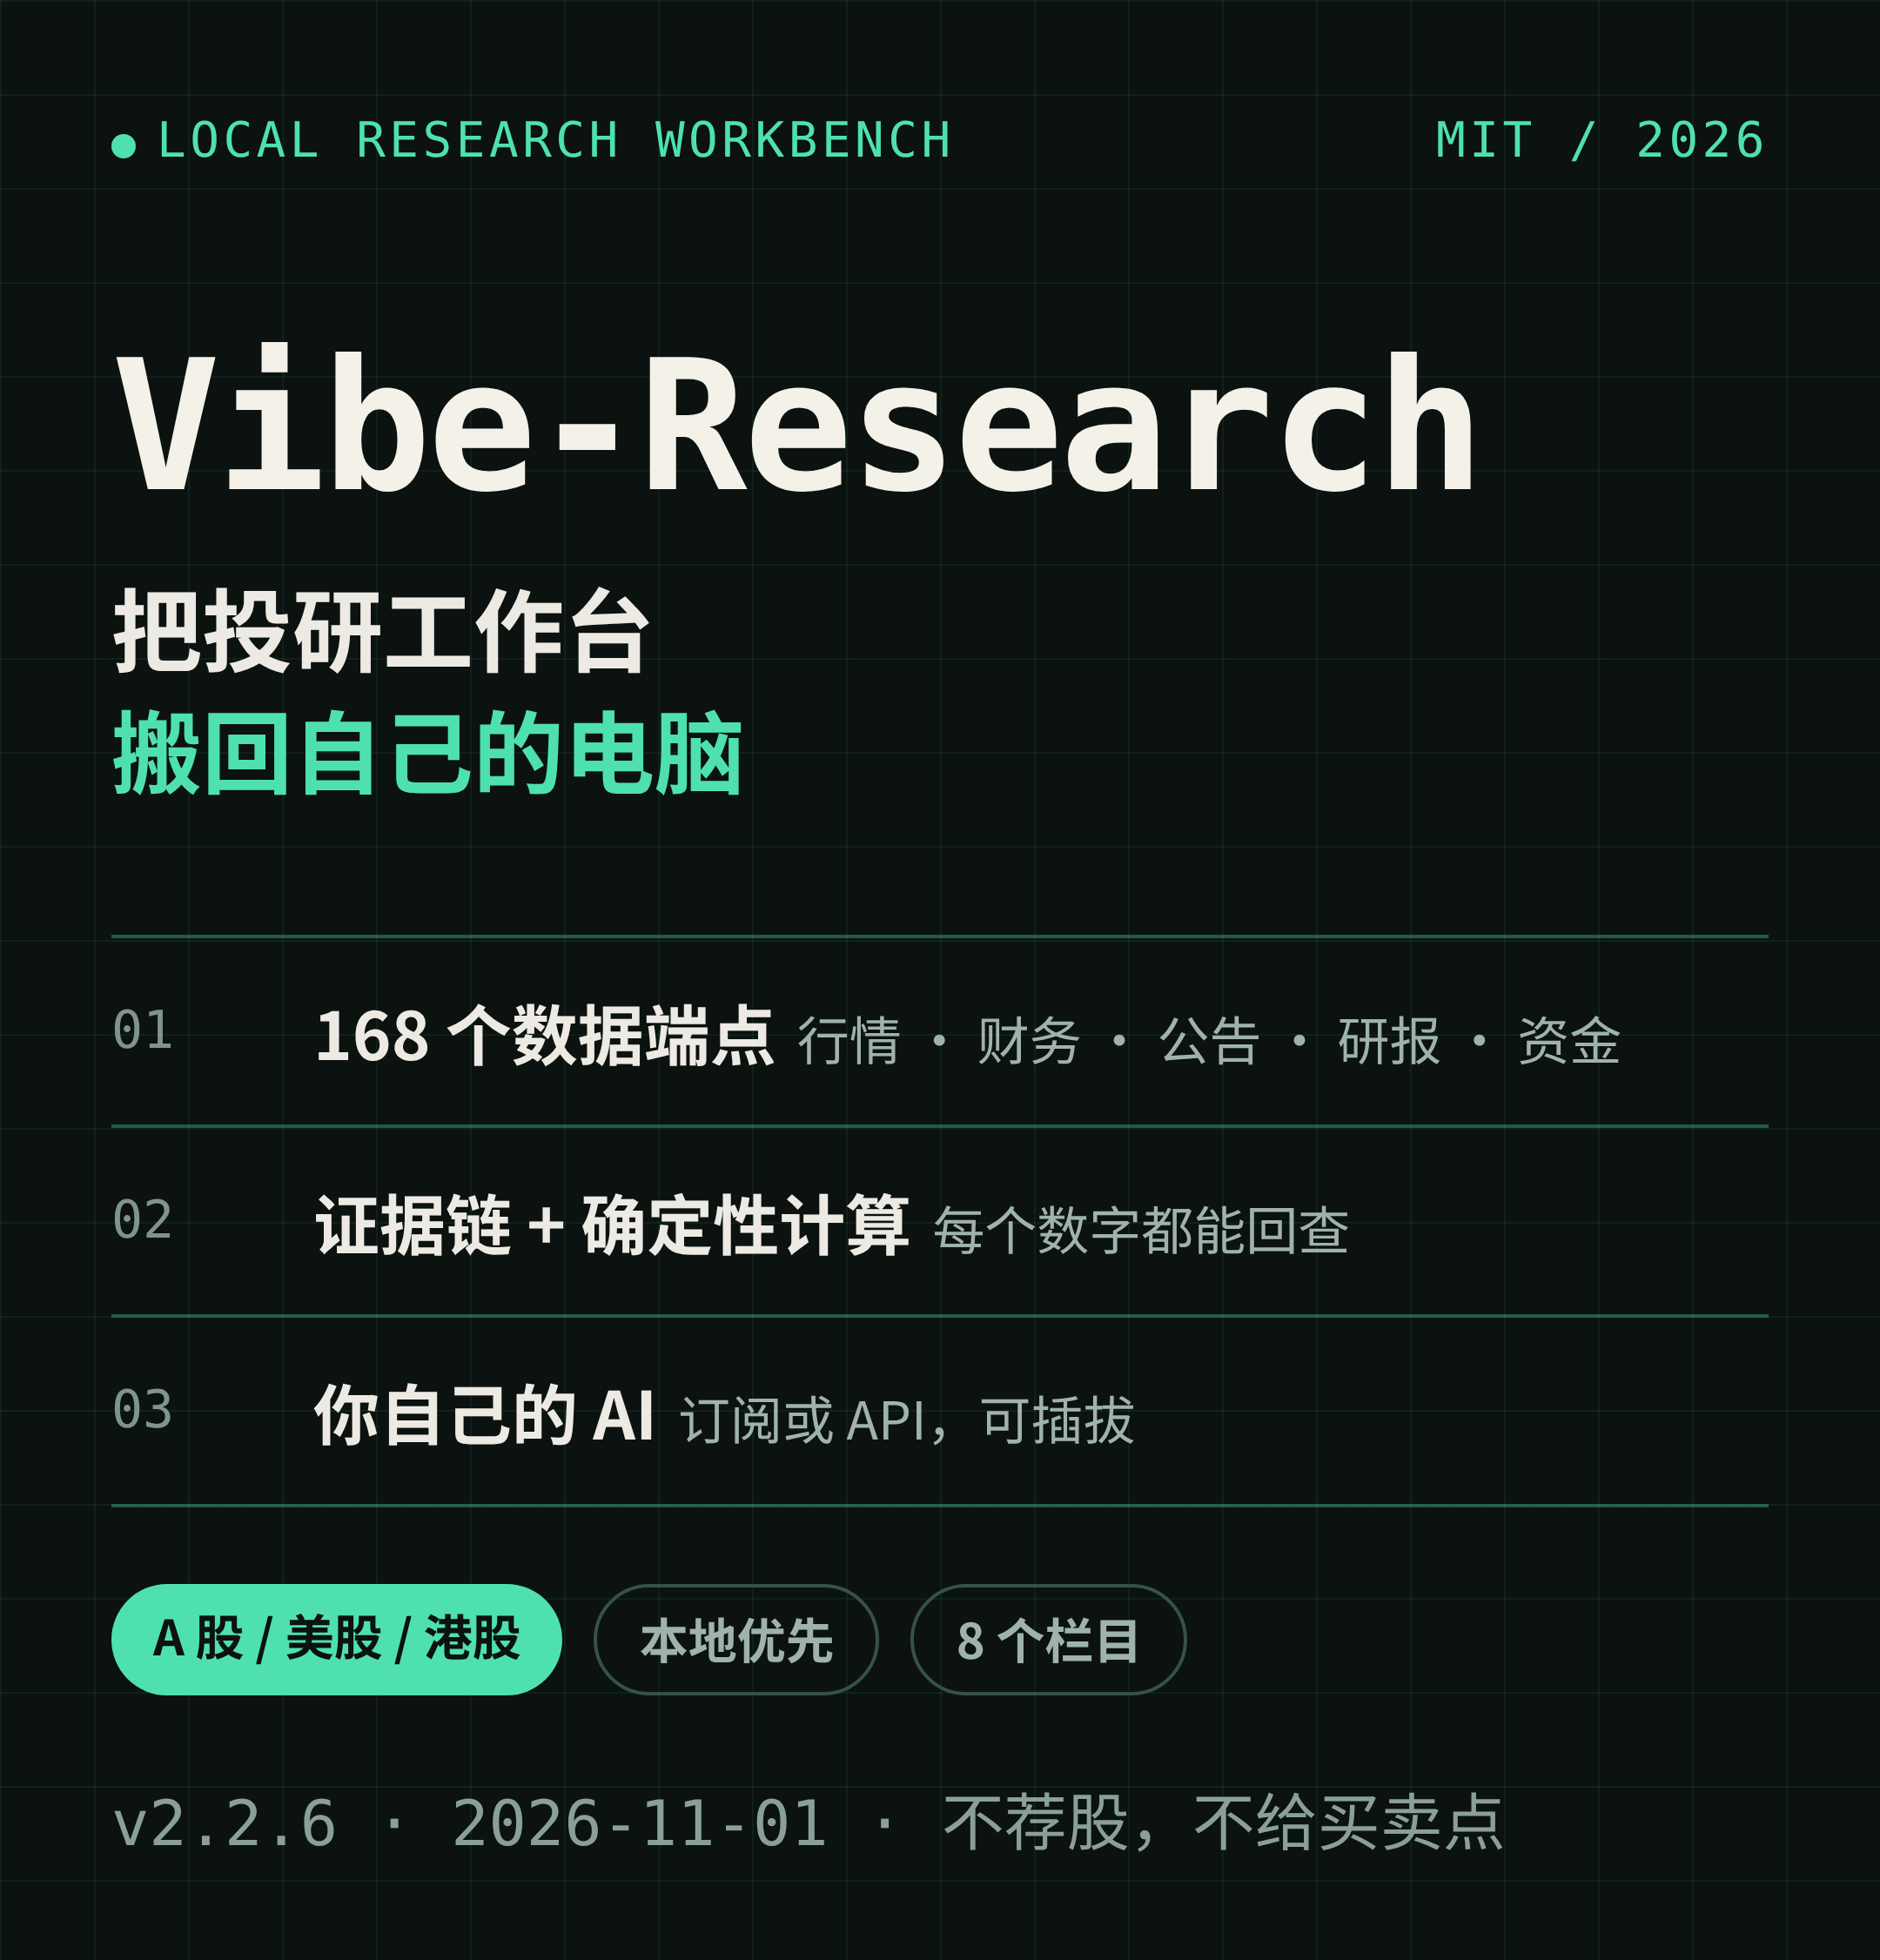
Vibe-Research 想解决的,就是这件很笨但很真实的事:把上面六个窗口收进同一个本地页面,并且让研究过程留下的每个数字都能回查到出处。
它是一个开源项目(MIT 协议),最新版本 v2.2.6 发布于 2026-10-29。截至 2026-11-01,GitHub 上约 3,400 星、656 个 fork。这篇文章不是使用教程,而是把这个项目拆开看:它做对了什么、哪些地方值得抄、以及它明确不做什么。
一、它到底是什么
一句话:一个跑在自己电脑上的 A 股 / 美股 / 港股投研工作台,AI 用你自己已经付费的那一个。
三个关键事实:
- 本地运行。装完打开
127.0.0.1:5930,界面是本地网页。自选、持仓、研究记录、研报原文都存在自己电脑的数据目录里,不上传云端。 - 数据底座是 168 个数据端点、35 个数据层,覆盖行情、K 线、财务、一致预期、公告、研报、资金、龙虎榜、限售解禁、宏观、招聘等。A 股数据同步自它自己的 a-stock-data,美股 / 港股同步自 global-stock-data。
- AI 是外接的:Claude Code、Codex、WorkBuddy / CodeBuddy 订阅,或任意兼容 Chat Completions 的模型 API(DeepSeek、通义千问、Kimi、MiMo、GLM 等)。产品本身不附赠额度。
它不替你下单,也不能下单。这一点从产品设计到措辞都很克制:输出只包含数据、分析框架、情景概率和裁决点,不提供建仓、加减仓、目标价或止损位。
二、v2.1 那次「做减法」,是最值钱的判断
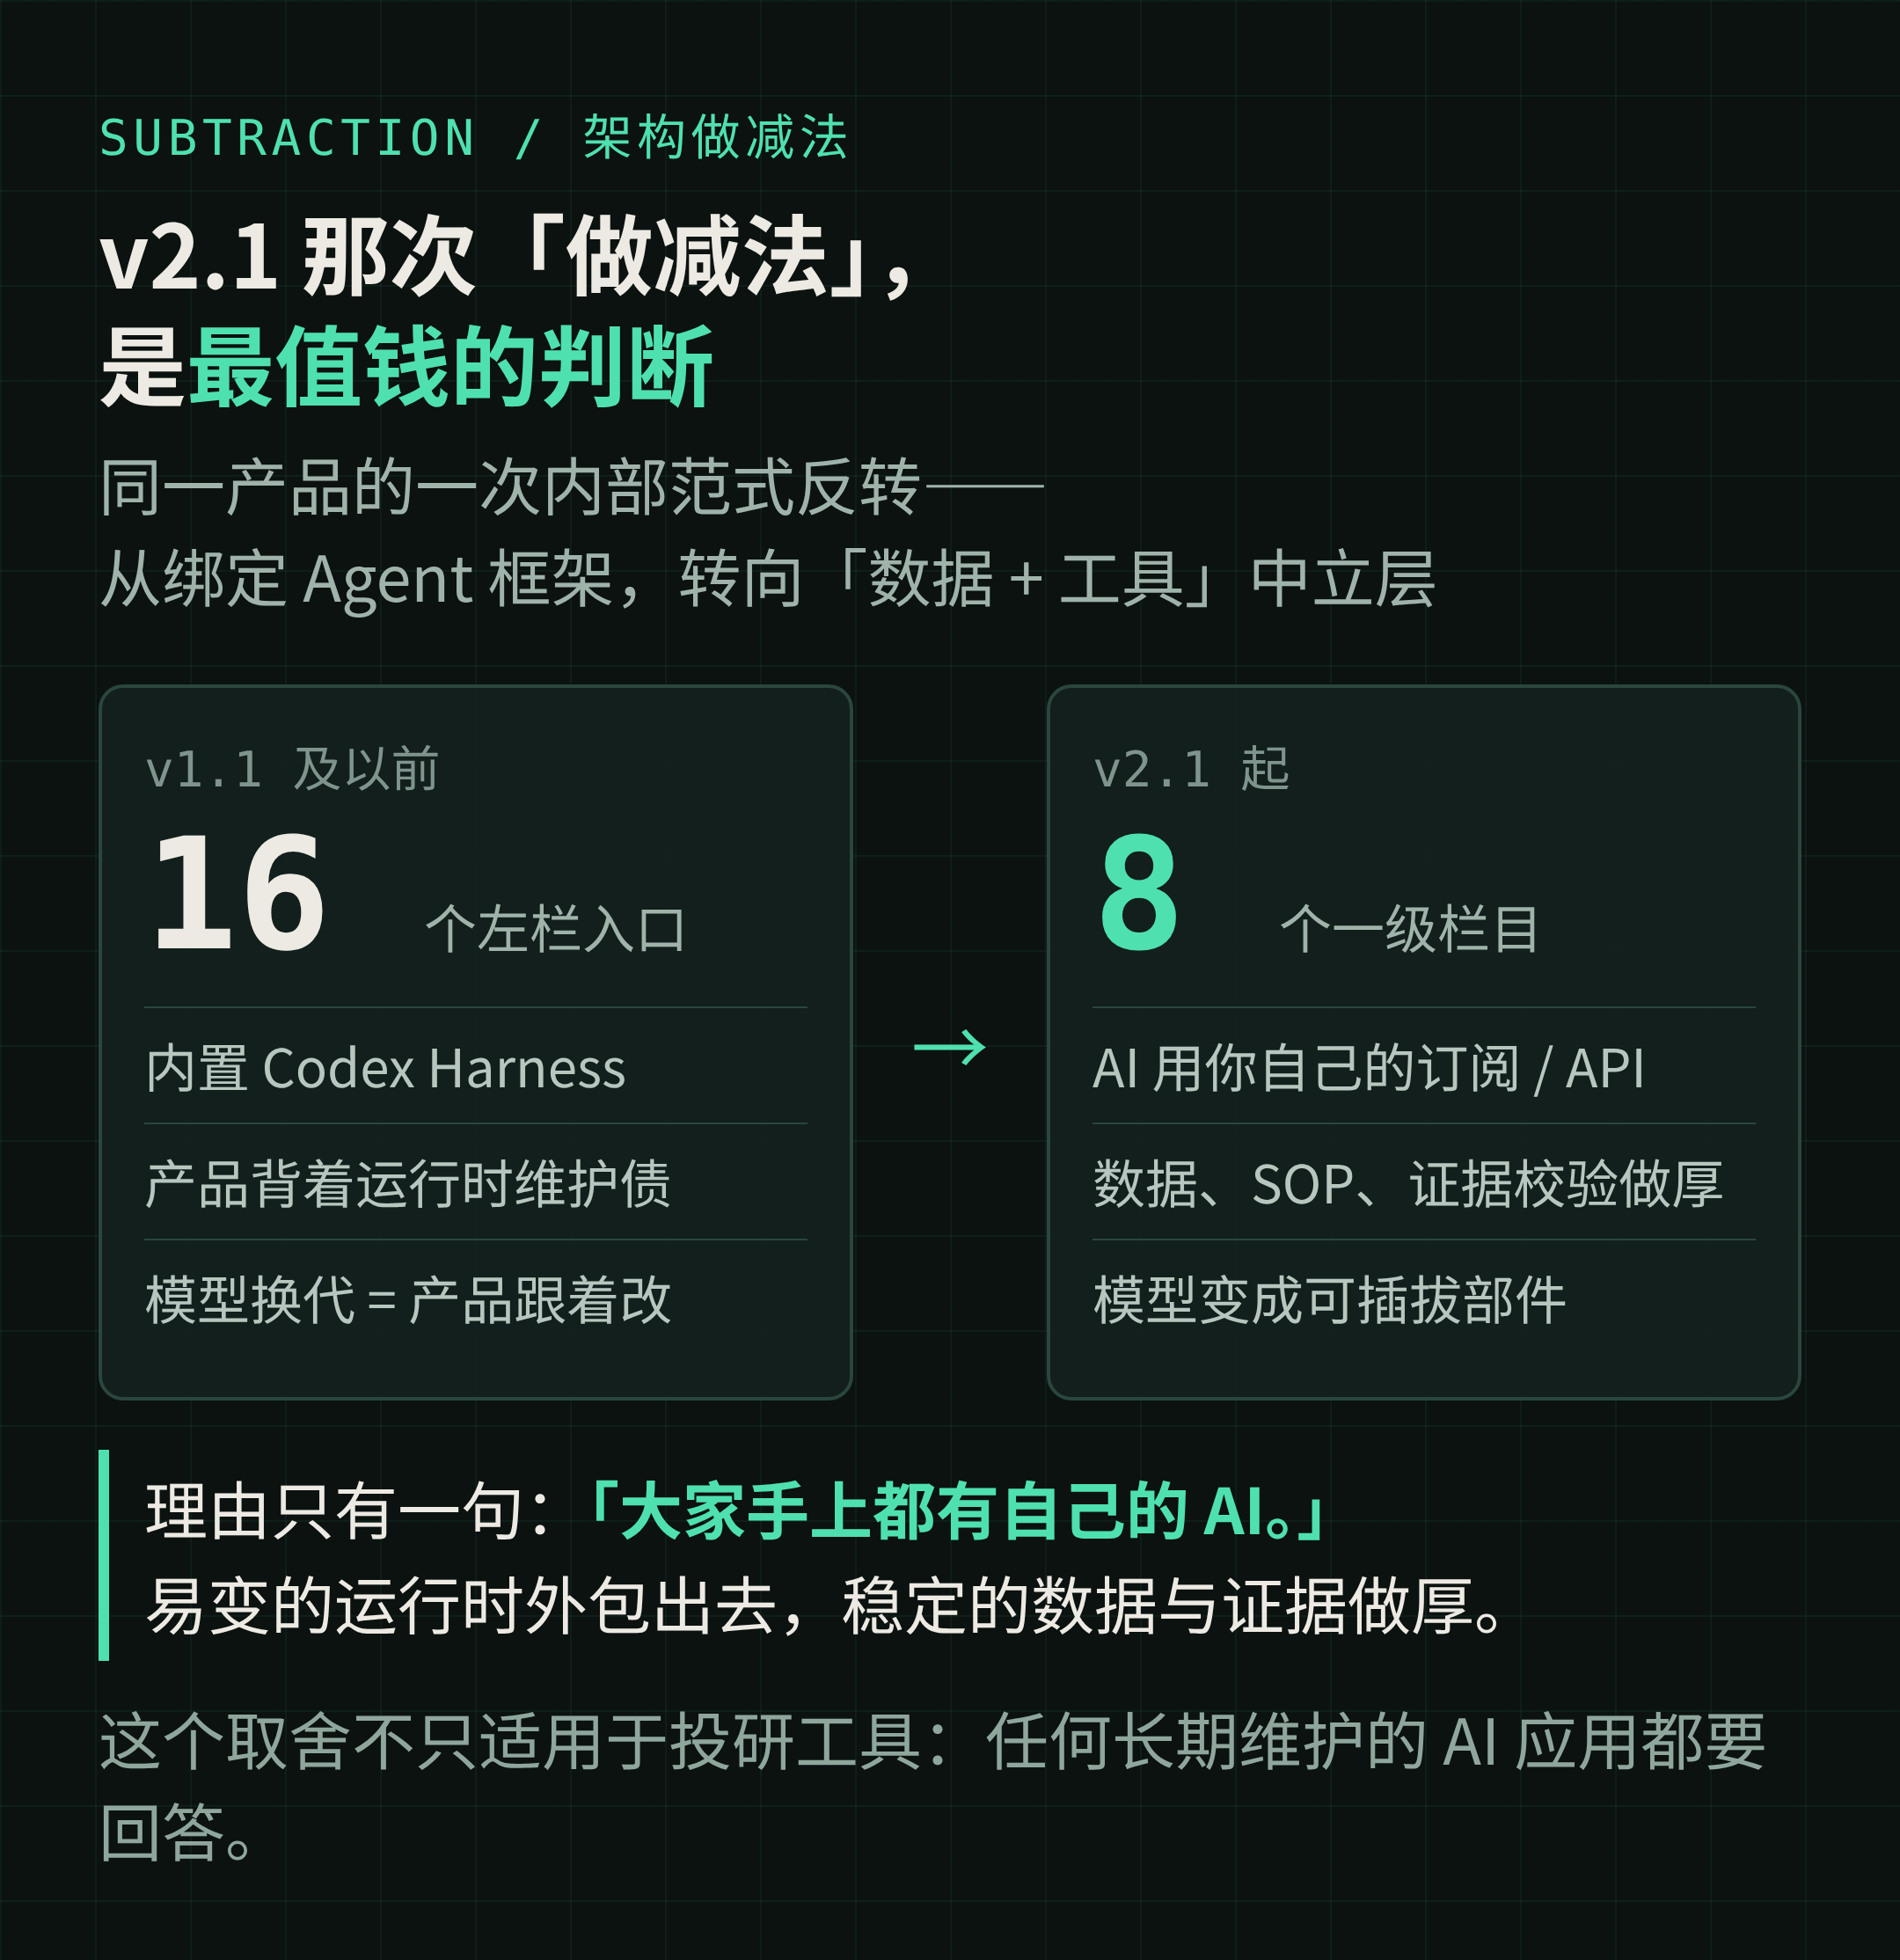
这个项目早期内置过 Codex Harness——把当时最强的 Agent 运行时直接焊进产品里。到 v2.1,作者把它整个拿掉了,理由只有一句:「大家手上都有自己的 AI。」
同时,左侧导航从 16 个入口收成 8 个栏目。
这两件事放在一起看,是一次很清醒的架构选择:
- 易变的东西外包出去。Agent 运行时三个月换一代,内置它等于给自己背上维护债,还要追着各家 CLI 的登录方式改。
- 稳定的东西做厚。数据端点、投研 SOP、证据校验、确定性计算,这些才是壁垒——它们不会因为换了哪个模型就失效。
于是产品退到「数据 + 工具 + 编排」这一层,把模型当成可插拔的部件。这个判断不只适用于投研工具:任何想长期维护的 AI 应用,迟早都要回答同一个问题——你到底是在做产品,还是在替某个模型框架做外壳。
三、八个栏目,一条完整的投研价值链
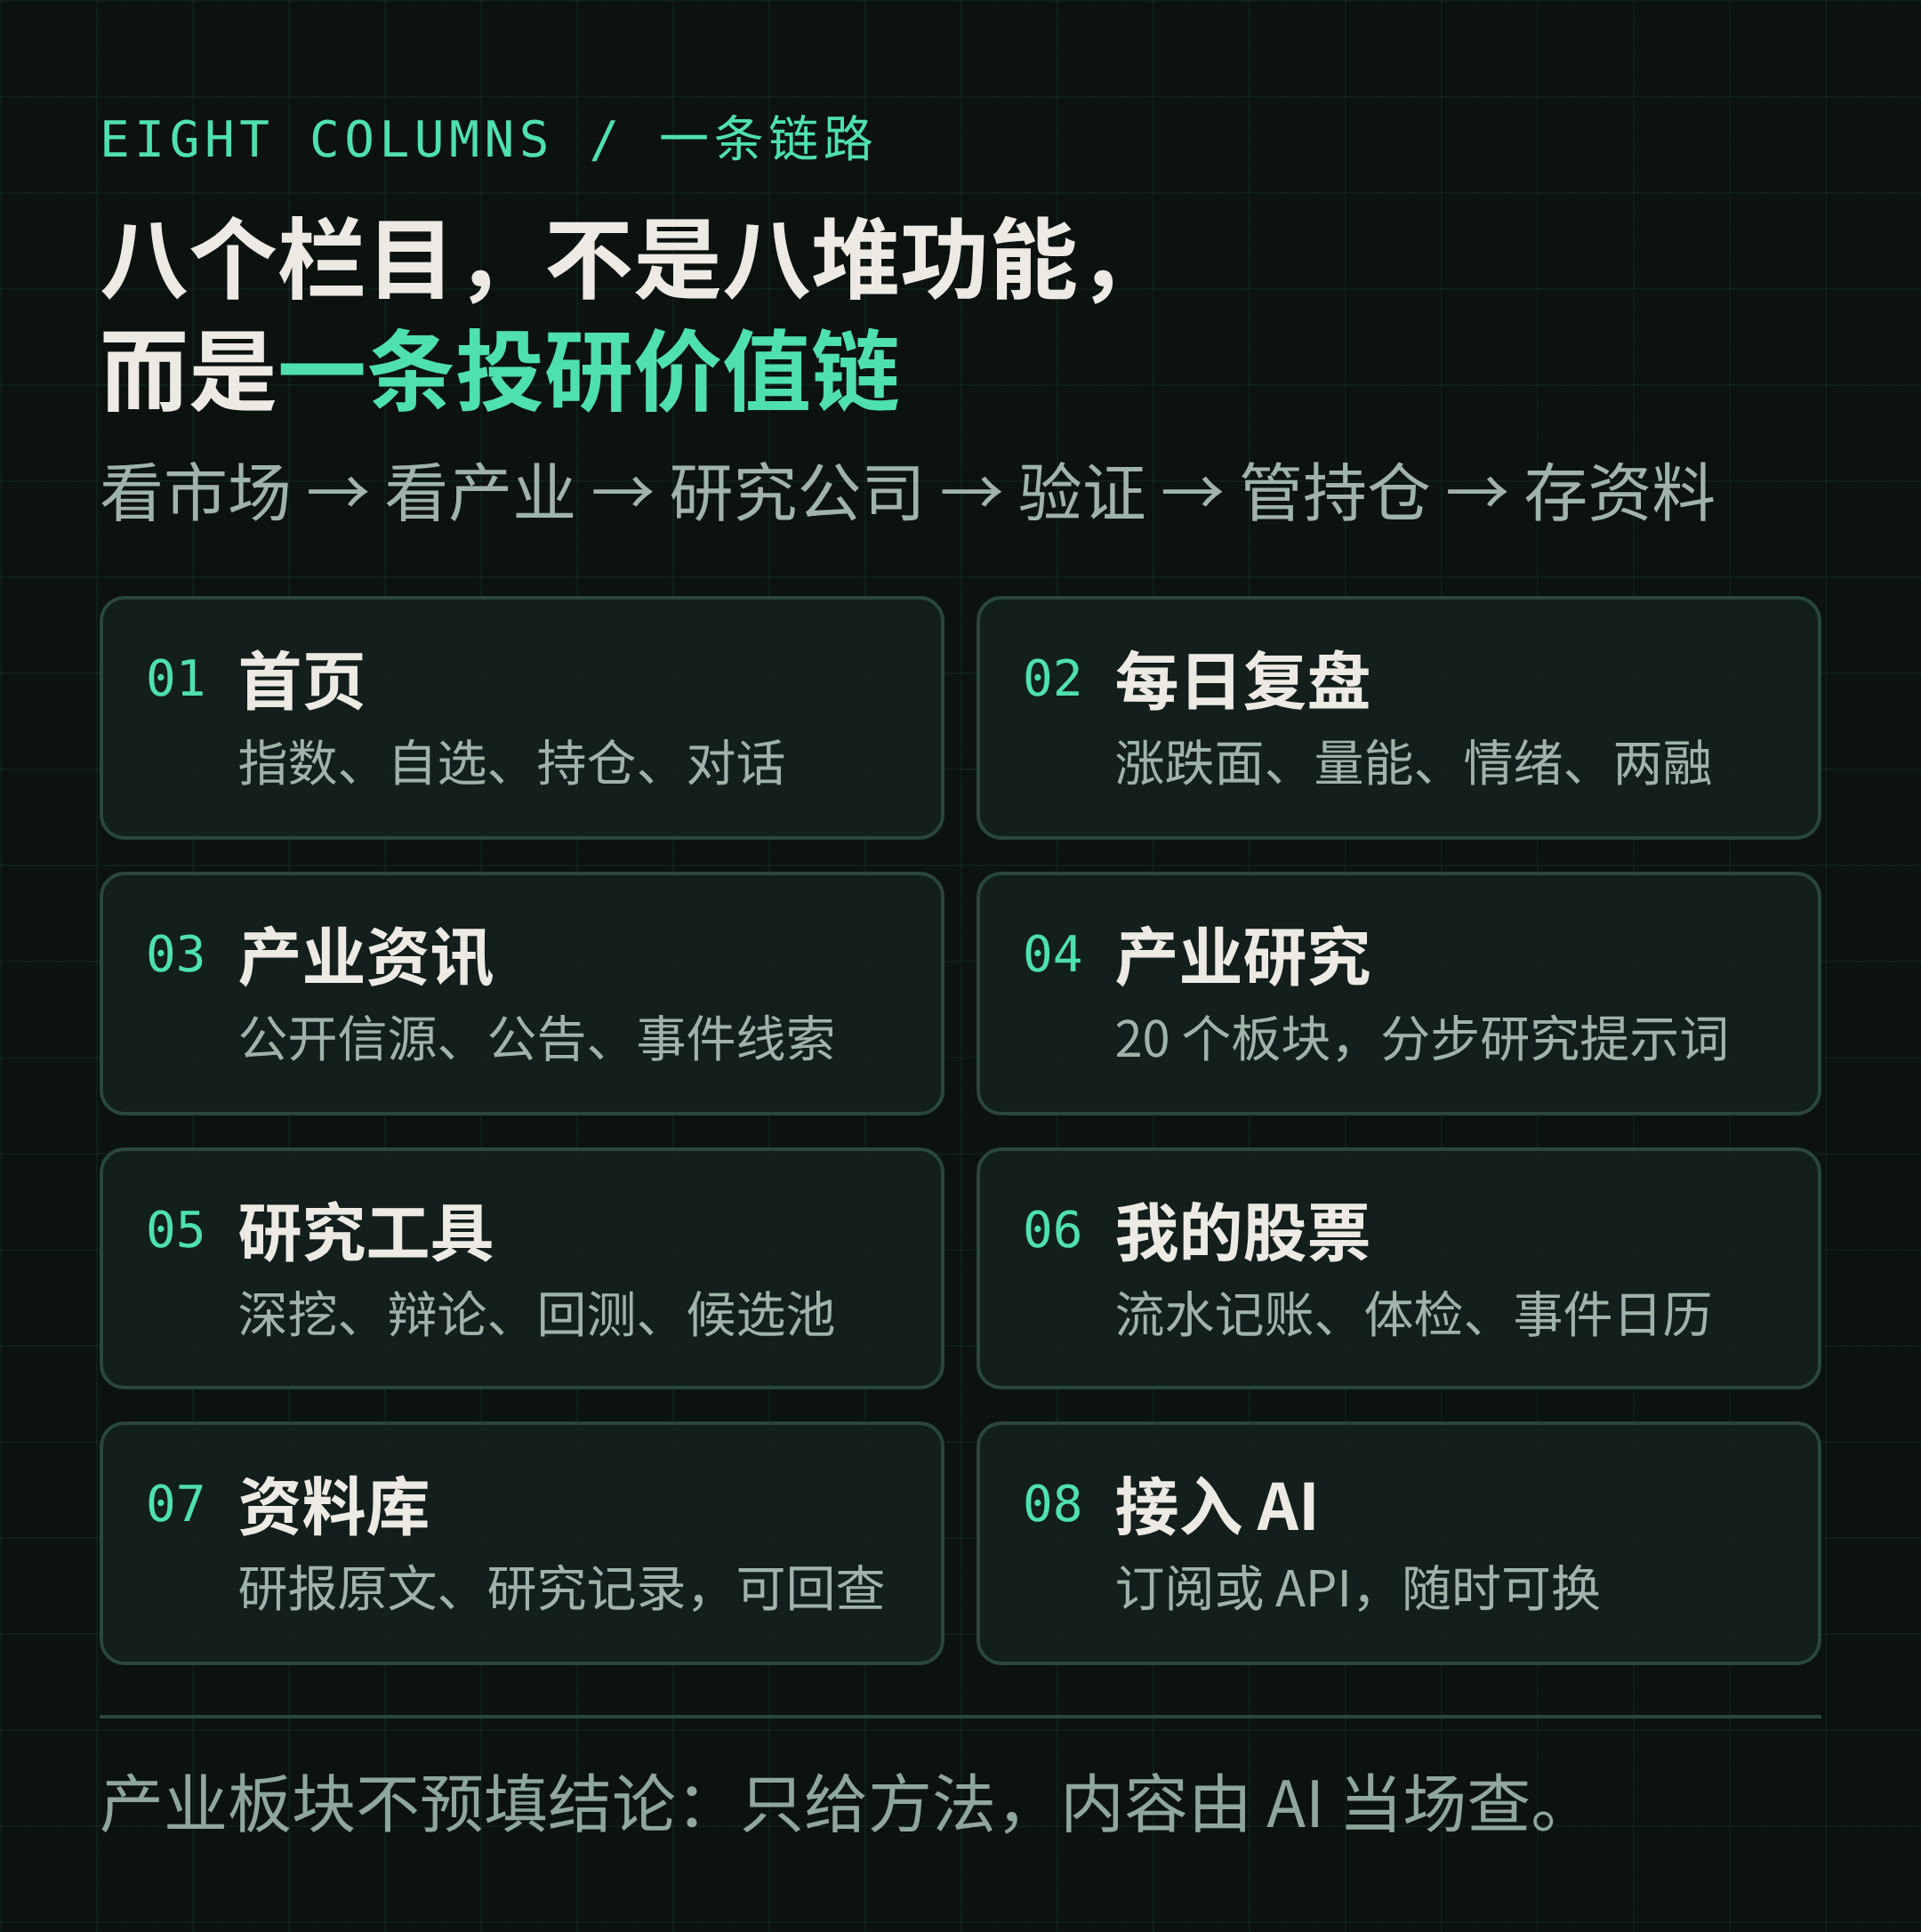
八个一级栏目不是功能堆叠,而是一条链路:看市场 → 看产业 → 研究公司 → 验证想法 → 管持仓 → 存资料。
| 栏目 | 它回答的问题 |
|---|---|
| 首页 | 今天市场怎么样,我的票怎么样了 |
| 每日复盘 | 涨跌面、量能、短线情绪、两融、行业资金处在什么状态 |
| 产业资讯 | 今天有什么新信息值得进一步核对 |
| 产业研究 | 这个产业的技术路线、产业链和格局是什么 |
| 研究工具 | 个股深挖、多空辩论、回测、候选池 |
| 我的股票 | 自选、持仓、事件日历、到期提醒 |
| 资料库 | 我的研报和研究记录放在哪 |
| 接入 AI | 用哪个模型来干活 |
其中「产业研究」有个细节我很喜欢:20 个板块不预填内容。每个板块只给一组分步研究提示词——先读你资料库里的研报,再找公开行业研报,然后一页页梳理技术路线、产业链、全球格局。内容由你的 AI 当场查,每个数字要求写来源和年份,查不到就写「未查到」。
这比塞一堆二手结论诚实得多。工具应该给方法,不该给答案。
四、真正值钱的,是三道「防口算」机制
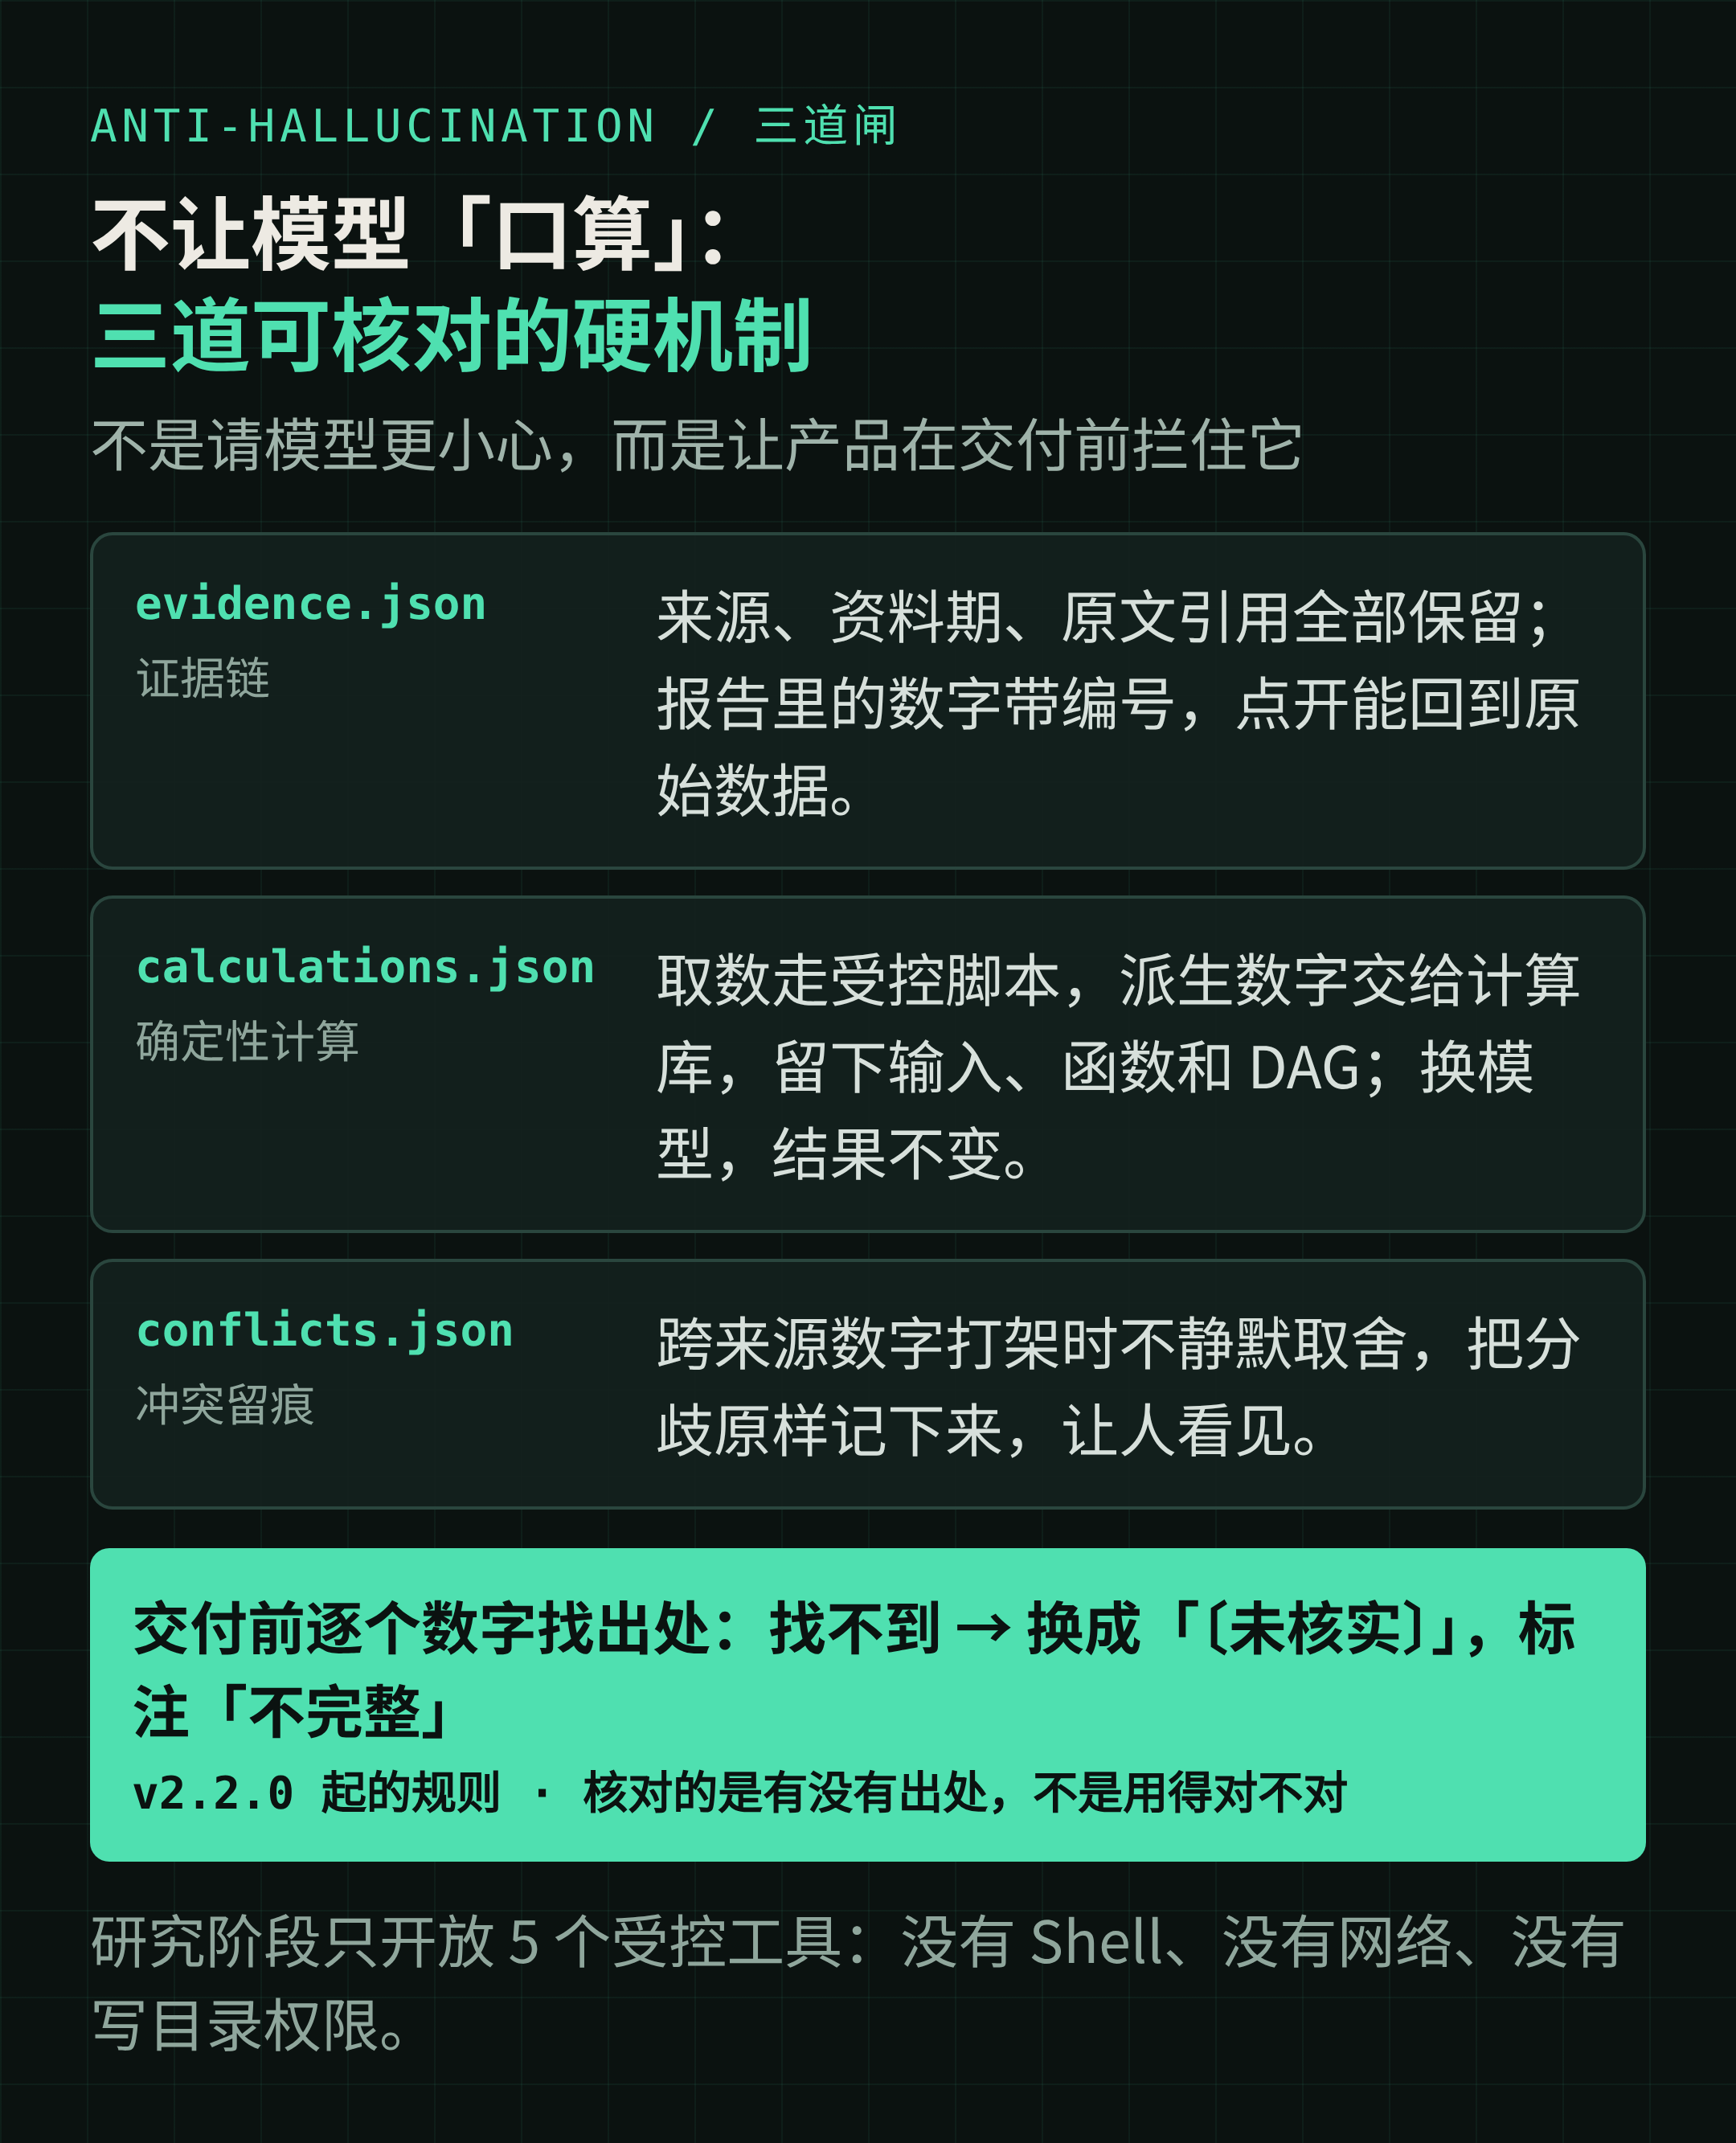
大多数「AI + 投研」产品停在聊天层:问一句,答一段,看起来很像那么回事,但你没法验证。Vibe-Research 花了很大力气在验证上,我认为这是它和同类产品最大的区别。
1)证据链:每个数字都要有编号
跑完一次六阶段研究(公司画像 → 财务 → 盈利预期 → 估值 → 风险 → 报告),产物不是一个 Markdown 文件,而是一组:
report.md:最终报告;evidence.json:本轮用到的证据,每条保留来源、资料期和原文引用;calculations.json:派生数字的输入、函数和计算 DAG;conflicts.json:跨来源的冲突,不静默取舍;manifest.json:用了哪个 AI、哪个阶段、什么状态。
报告正文里的数字带证据编号或计算编号,点开能回查到原始数据。这解决的是投研里最要命的「数字漂移」:一个数从公告到 Excel 再到结论,中间被谁改过、改成了什么口径,全都留痕。
2)确定性计算:不让语言模型心算
模型最不可靠的能力之一,是算术。这个项目的做法是:取数由受控脚本完成,派生数字交给确定性计算库,模型只负责组织语言和判断。
calculations.json 记录的是一个 DAG——每个派生数字用了哪些输入、调了哪个函数。同一条计算链重跑,结果一致;换了模型,结果也不变。这一点很关键:它把「模型能力」和「计算结果」解耦了。
3)交付前核对:找不到出处的数字直接遮掉
v2.2.0 加了一条我见过最硬的规矩:报告交付前,会拿每个数字回本次取到的数据和计算里找出处;找不到的,不猜、不圆,直接把数字换成「〔未核实〕」,并在报告开头写明有几处,运行状态标为「不完整」。
这里的边界写得很清楚:它核对的是「这个数字有没有在这些材料里出现过」,不是「用得对不对」。有出处不等于推论正确,这一条它自己也反复声明。
但这仍然是方向性的一步:从「让模型更小心」,变成「让产品拦住它」。
再配一层:研究阶段是一次独立会话,只能调用 5 个受控工具(列文件、读文件、确定性计算、写阶段产物、写报告),订阅 CLI 的内建工具全部关闭,研究线程没有 Shell、没有网络、没有写目录权限。
这就是「受控沙箱」——不是靠提示词求模型别乱来,而是让它没有乱来的工具。
五、接入:用自己的订阅,不复制登录态
四种接入方式:
- Claude Code:本机装好并用 claude.ai 订阅登录;
- Codex:本机装 OpenAI 官方 CLI,用 ChatGPT 账号
codex login; - WorkBuddy / CodeBuddy:装腾讯官方独立命令行
codebuddy登录; - 模型 API:填地址、模型名、key。
几个工程细节值得单独说:
- 点「测试并保存」会先发一次真实对话,通了才生效;失败不会覆盖当前配置。
- 订阅直接调用本机已登录的 CLI,产品不读、不复制登录文件。
- 选了哪家就用哪家,条件不满足直接报错,不会悄悄降级或换供应商。
- API key 存在当前浏览器的
localStorage,不写进仓库、后端配置或日志——但也不是系统钥匙串,共享电脑要自己清。
六、装起来要费多大劲
两条路。
免安装包:Windows x64、Apple 芯片 Mac、Intel Mac 三个压缩包,自带 Node 和 Python,解压双击启动。代价是包没有代码签名,第一次打开要在系统提示里手动放行。
源码:需要 Node ≥ 22.18(必须是启用了 TypeScript 支持的官方构建)、Python ≥ 3.11,然后 git clone → scripts/setup → scripts/start。默认页面端口 5930、本机 API 8765,被占用会自动换并在终端说明。
说实话,这不是一个「点开就能用」的消费级软件。它假设你愿意折腾一次环境,换来后面长期的本地数据和研究记录。这个取舍是明确的。
七、它明确不做什么
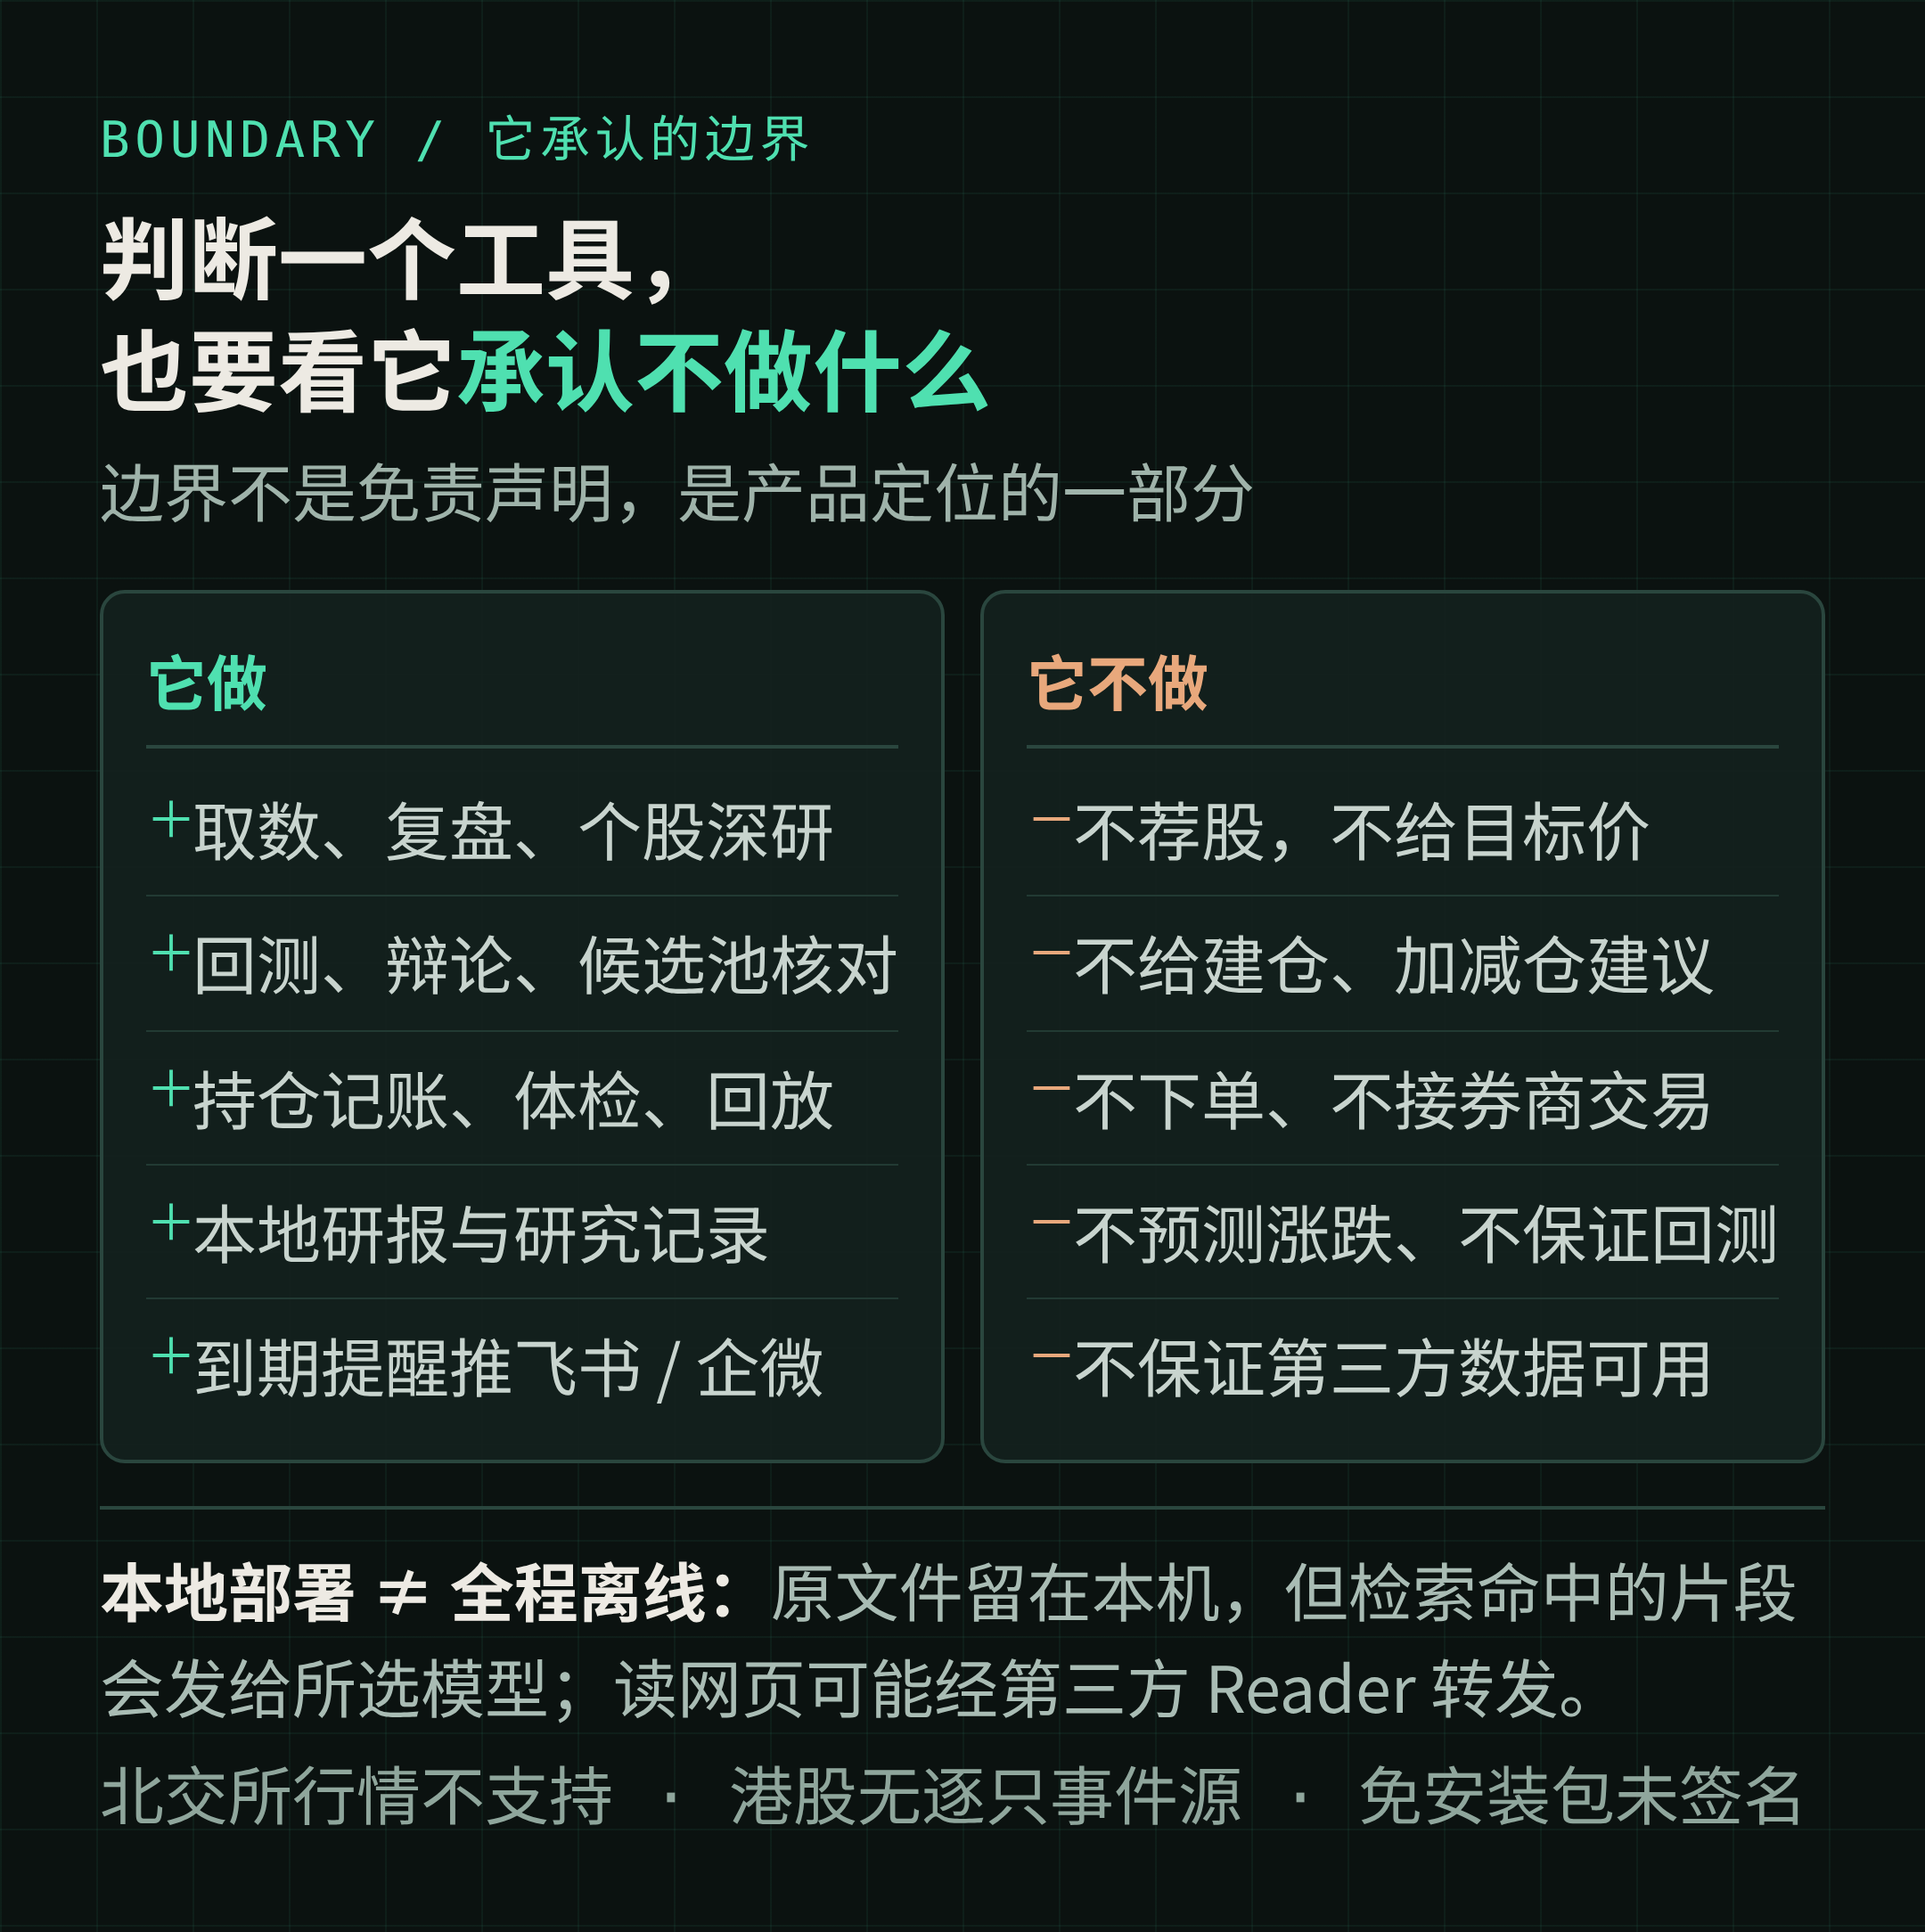
判断一个工具,除了看它能做什么,更要看它承认自己做不到什么。这个项目的「当前边界」写得很老实:
- 不预测、不荐股、不给买卖点和目标价;回测只描述历史,不承诺未来。
- 数据端点「登记在册」不等于第三方服务随时可用,公开数据可能延迟、缺失或有误。
- 北交所行情不支持;港股目前没有逐只事件来源,页面上直接写「没查」。
- 免安装包没有代码签名,Windows 和 Intel Mac 包没有在实机上验收。
- 六阶段研究可能跑几十分钟甚至更久,不承诺固定时长;订阅模式每次对话都要启动本机 CLI。
- 原始研报只存本机,但检索命中的正文片段会发给所选模型;读网页可能经第三方 Reader 转发。本地保存不等于全程离线。
最后一条尤其要说清楚:很多人把「本地部署」理解成「数据绝对不出门」,这是误解。本地部署换来的是「原文件和记录归你」,不是「一个字节都不外发」。
八、如果自己要做一个垂直 Agent,可以抄这四条
我看完这个项目,记下的是四个可迁移的设计,而不是它的功能清单:
- 分层:把数据、工具、SOP 做成稳定层,把模型运行时做成可替换层。别把产品绑死在某一个框架上。
- 证据链:每个结论性数字都能回查到来源和原文。做不到就不写,或者标成未核实。
- 确定性计算:能让代码算的,绝不让模型心算;计算过程和输入一起留档。
- 受控工具:给 Agent 的能力用白名单,而不是黑名单;没有权限,比「请你不要」可靠一万倍。
这四条不是投研专属。任何要在真实业务里交付结论的 Agent,迟早都要补上。
九、我的判断:它补的是「可复核」,不是「交易纪律」
如果你想要的是一个「告诉我买什么」的工具,它会让你失望——它明确不做这件事。
它真正补上的,是研究流程里最枯燥的那一段:数据从哪来、口径是什么、这个数字能不能回查、两个来源打架时听谁的。这些东西不产生快感,但决定了你的研究是可复用的资产,还是一次性的感觉。
至于买多少、跌了怎么办、什么时候卖,仍然得由一套独立的风控和纪律来回答。工具能让你少抄错一个数,但不能替你决定要不要下注。
这也是我自己的教训:研究做得再细,也只是把「值多少」说清楚;「怎么下注」和「错了怎么办」是另外两张卷子。
来源与说明
- 项目仓库:https://github.com/simonlin1212/Vibe-Research (MIT)
- 官网:https://viberesearch.wiki
- 版本信息与功能细节核对于 2026-11-01:README、CHANGELOG 与 v2.2.0 / v2.2.6 Release Notes;星标数为 GitHub API 当日读数。
- 本文为工具观察与方法讨论,不构成任何投资建议,也不构成对任何软件的推荐或背书。第三方数据的准确性由数据提供方负责;软件功能以其官方文档为准。
本文首发于 cosmocat.dev。