DeepSeek 的 token 账本:155 万亿和 38 美元,到底怎么算
先把两个数字摆出来。
2026 年 10 月 20 日,DeepSeek 开源内部推理框架 DeepInfer。比代码更值得看的,是随附的部署问答里第一次摊开的两组数:
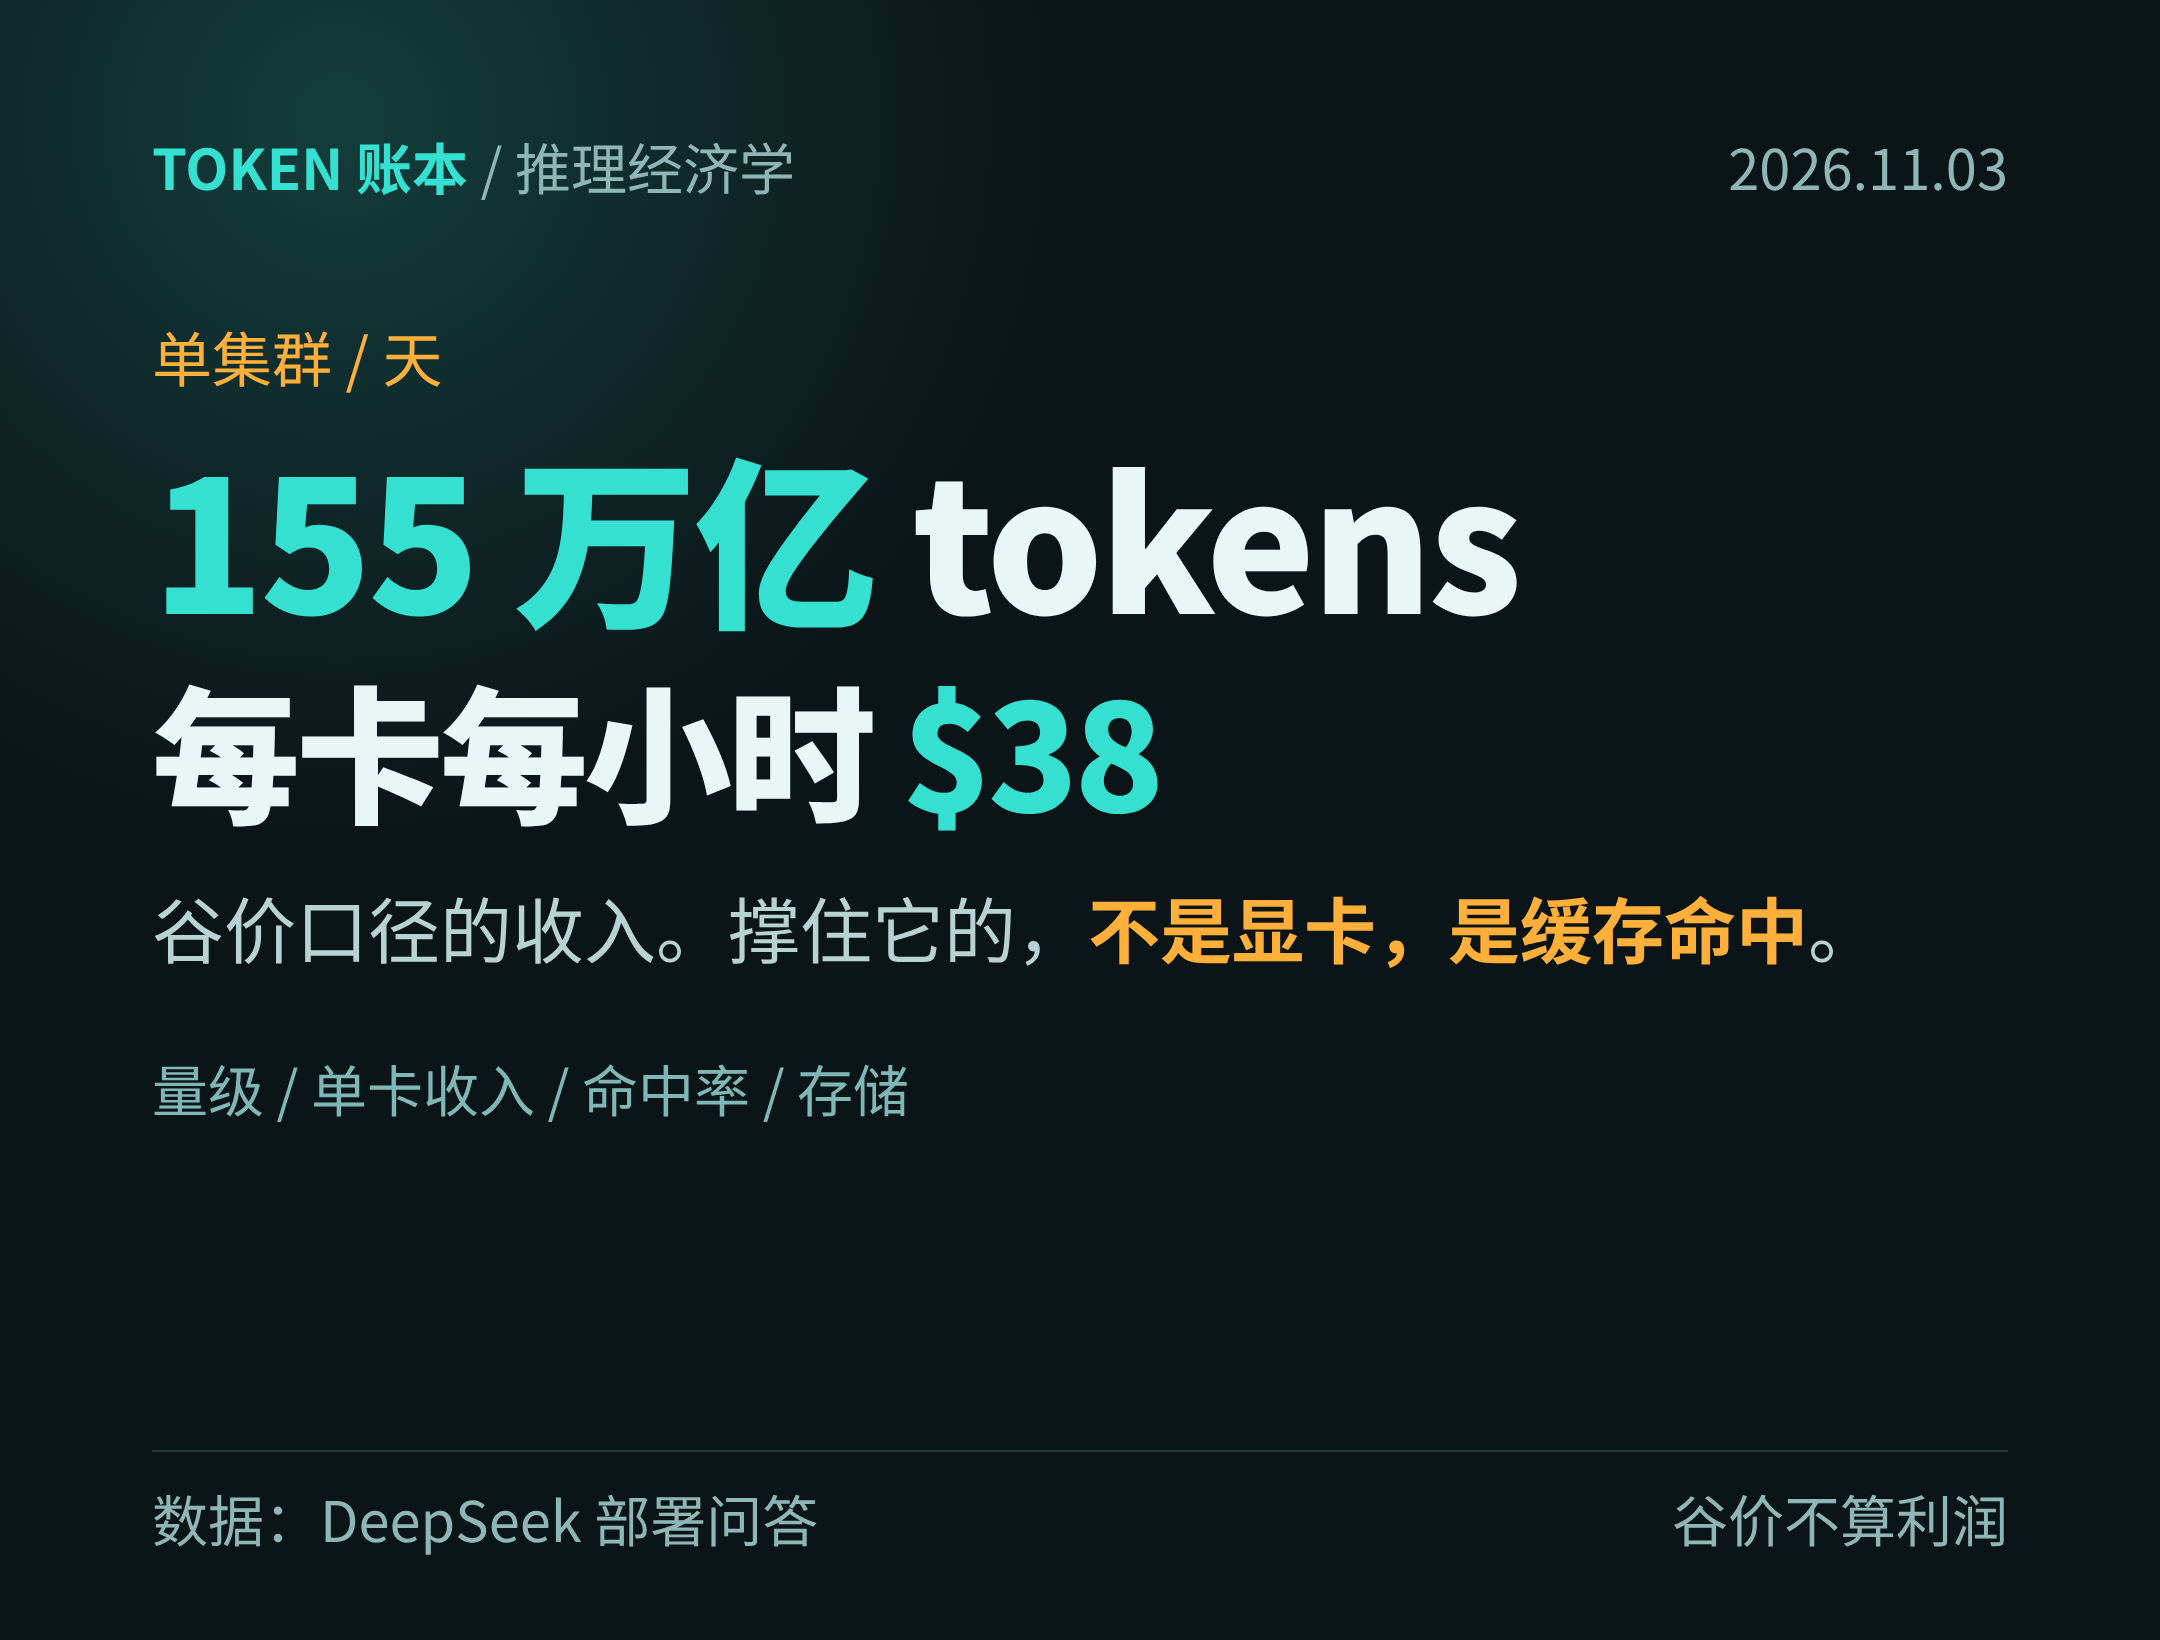
- 单一集群一天处理 155 万亿 tokens;
- 每张卡每小时收入 38 美元(按谷价计算)。
一个卖得很便宜的模型,一个听着很贵的单卡收入。两件事同时成立,就值得算一算了。
这篇不谈立场,只算账。算完你会发现:这轮低价竞争里真正的胜负手,不在显卡,而在「重复的那部分 token 值多少钱」。
一、先给 155 万亿找个坐标
孤立地看「155 万亿」,很难有体感。找个参照物。
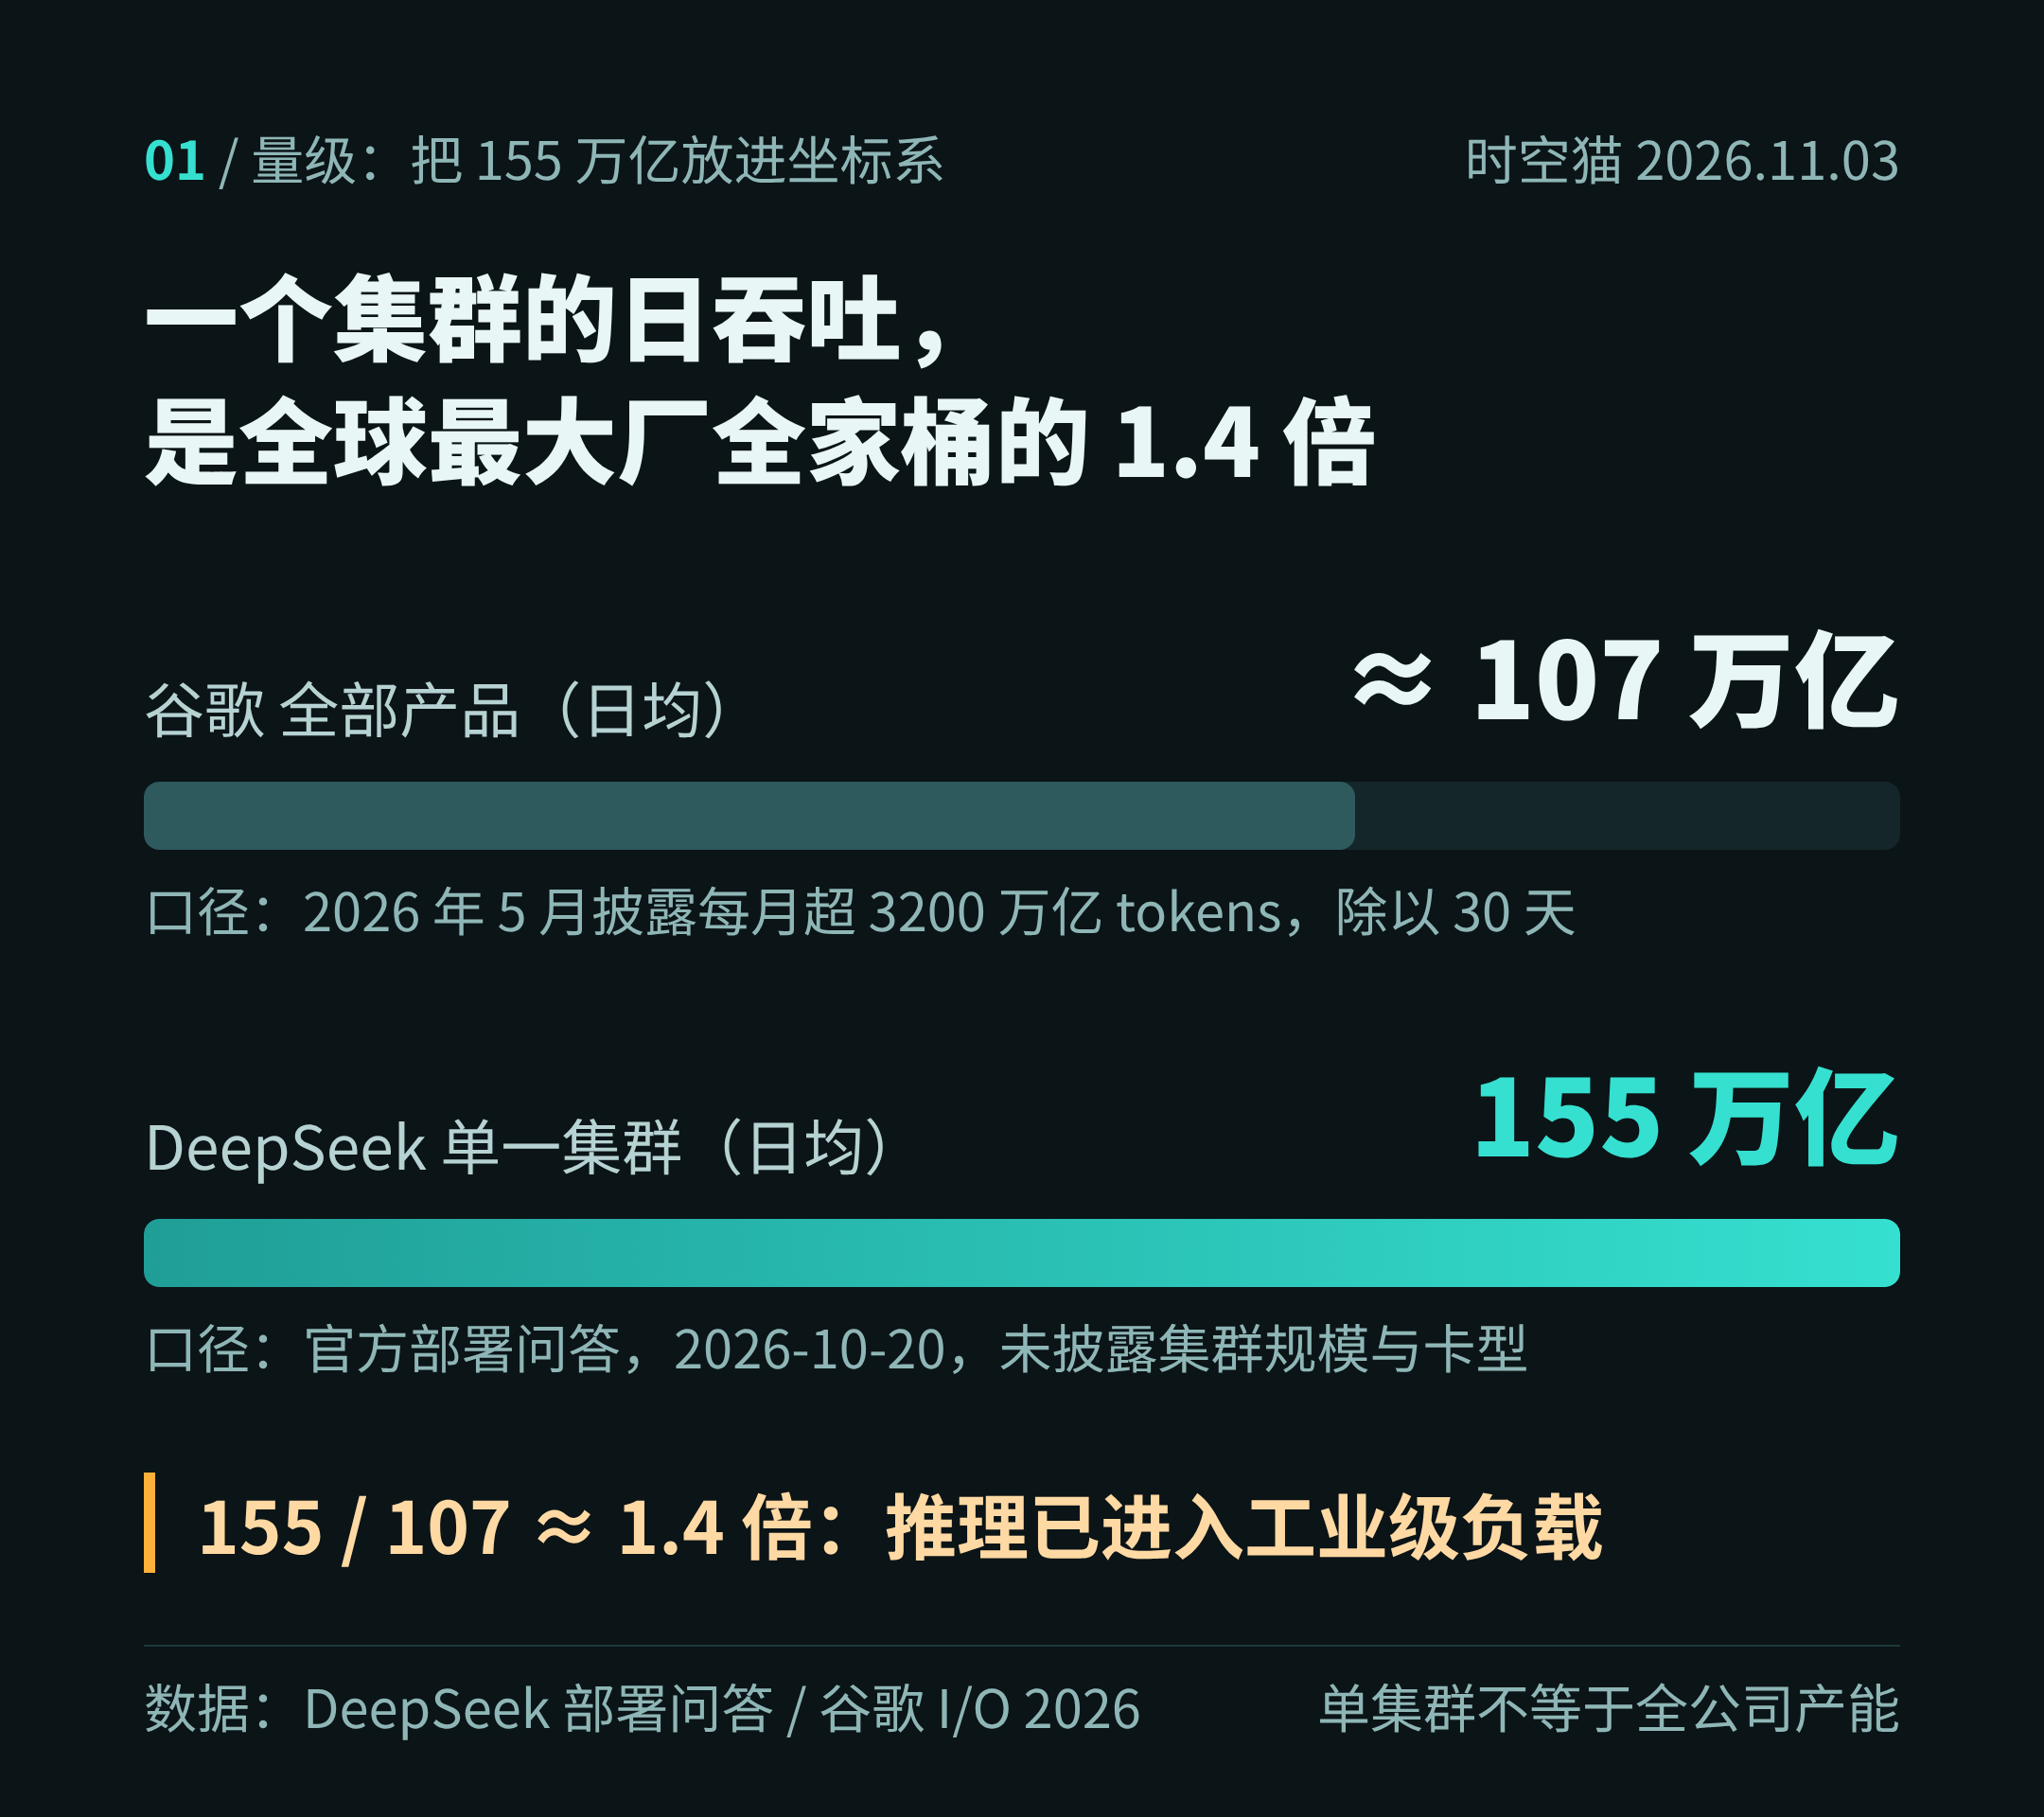
2026 年 5 月的谷歌 I/O 上,官方披露:谷歌所有产品加起来,每月处理超过 3200 万亿 tokens(同比增长约 7 倍)。摊到 30 天,日均约 107 万亿。
也就是说,DeepSeek 的一个集群,一天的吞吐量,已经是全球最大科技公司全家桶日均量的 1.4 倍左右。
这个对照有两个含义。
第一,推理需求真的到了「工业级」。不是 demo、不是试用,是每天几十万亿次真实调用堆出来的量。
第二,它是单集群,不是全公司。官方没披露集群规模与卡型,所以「单集群」这三个字既是谦虚,也是留白——你没法直接用它反推总产能。
二、38 美元是收入,不是利润
第二个数字更值得小心:每卡每小时 38 美元。
先明确它的口径——这是官方问答里的原话,是「按谷价」的内部结算收入,不是对外 API 挂的价,更不是利润。官方没有披露成本。
那这 38 美元算高还是低?用租卡成本做一把尺子。
市场行情大致是:Blackwell 代高端卡在云上的时租,公开列表价按型号在十几到二十美元区间,实际成交价常见个位数到十美元出头。不同渠道、不同合约期差异很大,这里只取一个区间感受量级:每卡每小时 8–10 美元的成交价,15–20 美元的列表价。
对照之下,38 美元/卡·时的收入,大约是租卡成本的 2–4 倍。而且这还是谷价——夜间折扣后的低价。
这里要立刻补一句边界:收入倍数不等于毛利率。因为推理的成本远不止「租一张卡」:还有存储、网络、机房、运维、以及自建集群的折旧。把 38 美元直接当利润,是最容易犯的错。
三、真正的账本:重复的 token 值多少钱
要理解「便宜还能赚钱」,得先理解一个技术事实:大模型读一段话,是有成本的;但如果这段话它已经读过,成本可以接近零。
原理不复杂。你发一段话给模型,它要先把整段内容「读一遍」(prefill),把中间结果算成 KV Cache,然后才开始回答。很多请求的内容是重复的——同一份系统提示、同一批工具说明、同一段前几轮对话。这些内容之前已经算过,结果存在缓存里,直接调出来用就行,不必重算。
这就是缓存命中。
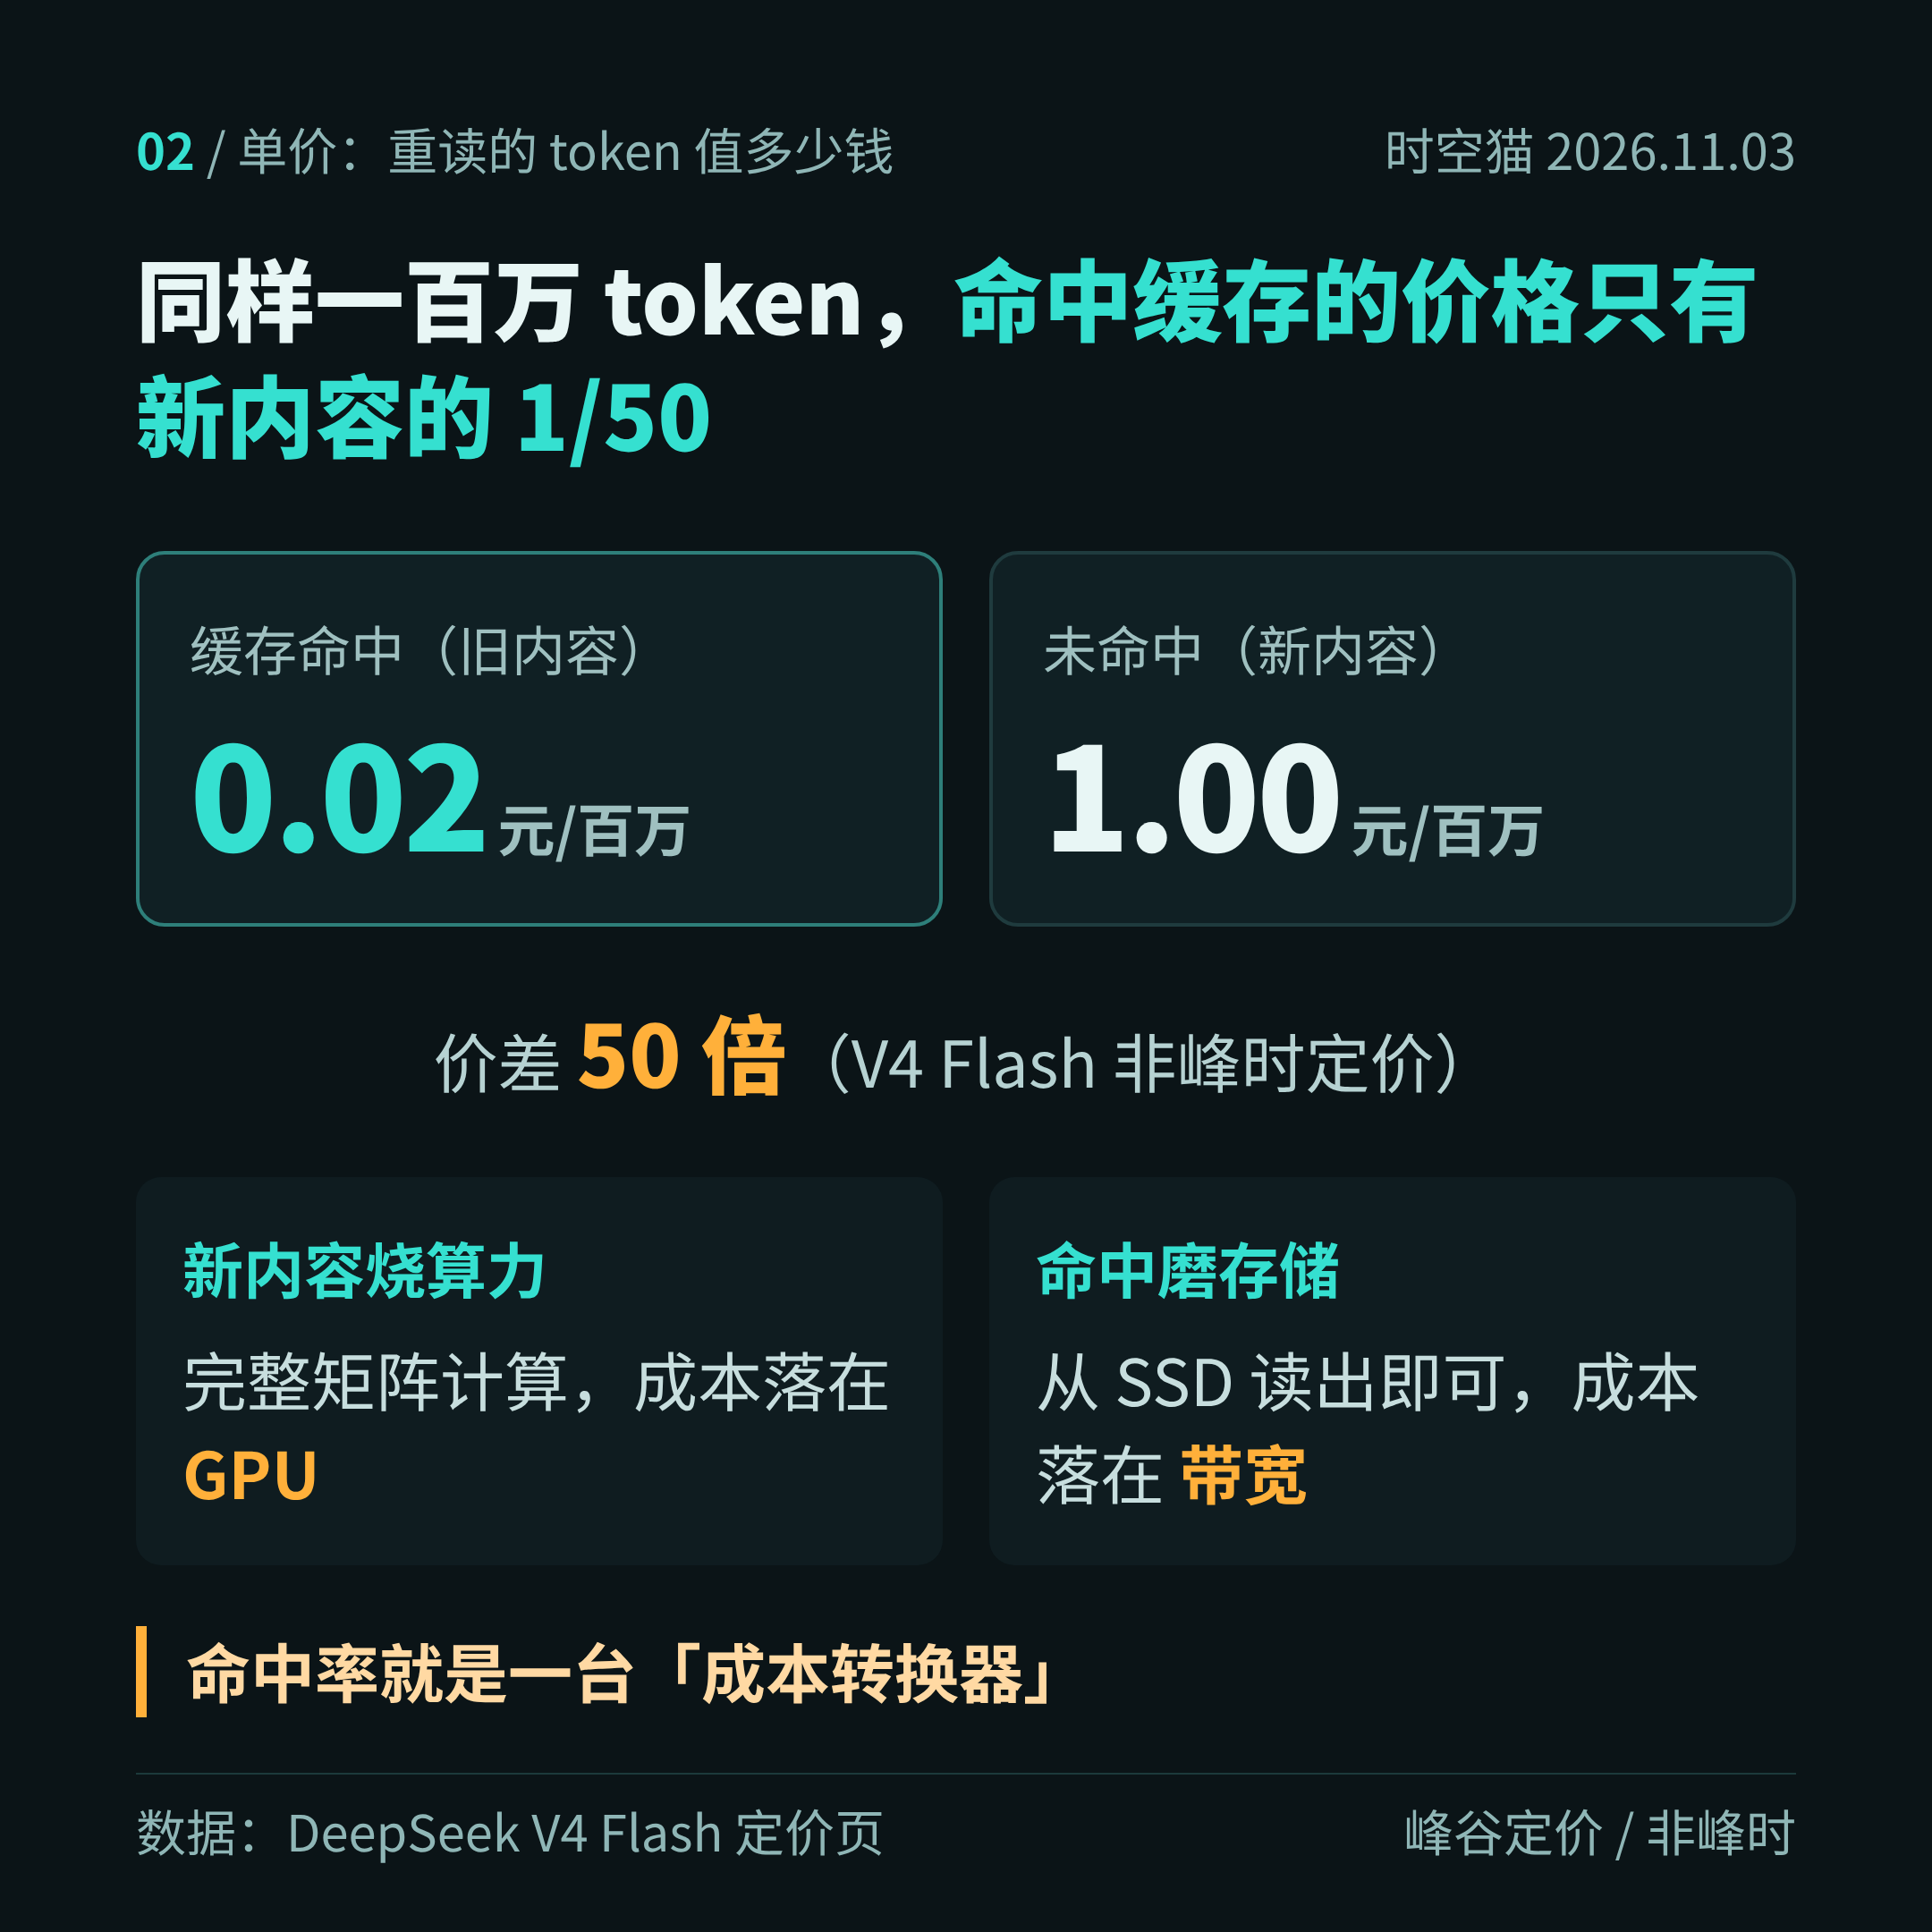
DeepSeek 把这件事做成了定价策略:以 V4 Flash 的非峰时价格为例,缓存命中的输入只要 0.02 元/百万 token,未命中的新内容是 1.00 元/百万 token。
两者相差 50 倍。
这个差价为什么能成立?因为两类 token 的成本结构根本不同:
- 新内容:要跑完整的矩阵计算,花的是 GPU 算力;
- 命中内容:主要是从存储里读出来,花的是 SSD 带宽和网络,几乎不占算力。
所以命中率越高,同样营收对应的算力成本越低。缓存命中率,本质上是一台「把算力成本换成存储成本」的转换器。
四、新旧对照:255 倍里,藏着 2.9 倍
把两个时间点的官方数据放在一起,账本会更清楚。
2025 年 2 月底,DeepSeek 公布过一次推理系统数据:全部推理服务一天输入 6080 亿 tokens,缓存命中率 56.3%;按当时定价折算,理论日收入 562,027 美元,成本利润率 545%。
2026 年 10 月,单集群一天 155 万亿 tokens,每卡每小时收入 38 美元。
先算第一个倍数:155 万亿 ÷ 6080 亿 ≈ 255 倍。也就是说,一年半左右,量级涨了两个半数量级。
再算第二个倍数:单卡收入从多少涨到 38?如果按「理论日收入 ÷ 24 小时 ÷ 卡数」倒推,2025 年那次数据对应的单卡时收入大约在 10–13 美元区间(具体取决于你按成本反推的 1814 张卡,还是按 2224 张卡的口径)。按 13 美元算,到 38 美元大约涨了 2.9 倍。
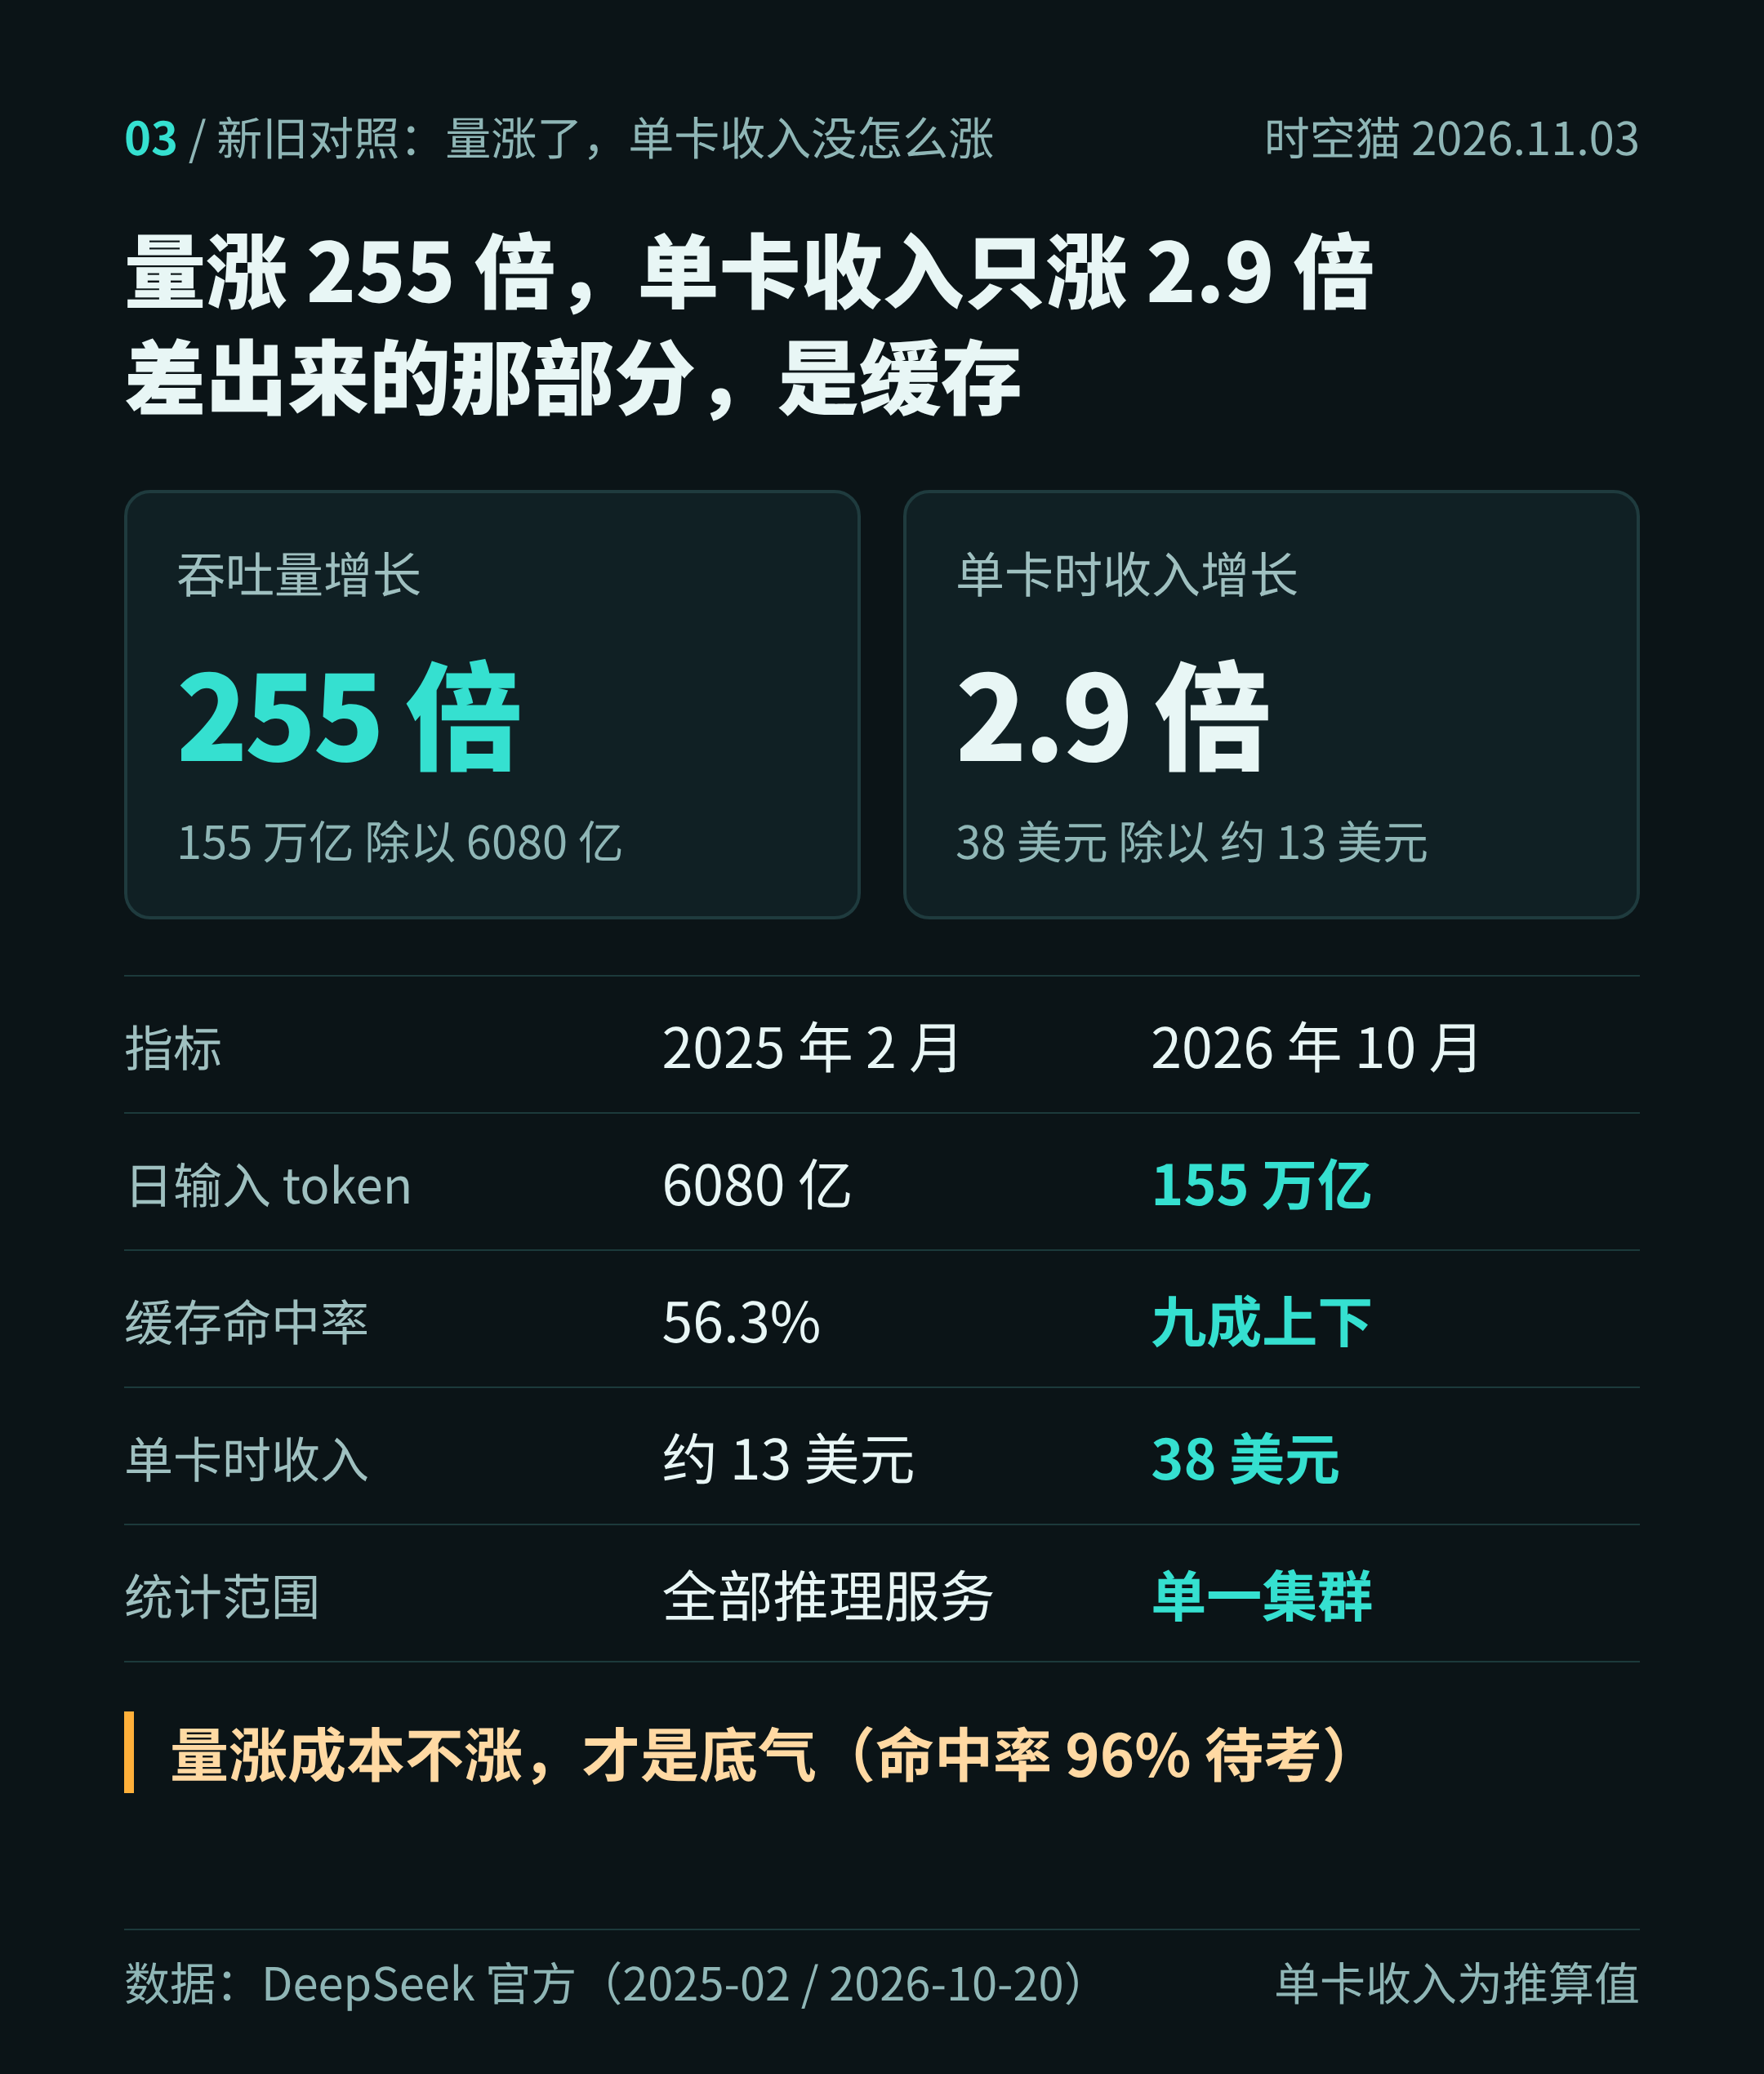
量涨了 255 倍,单卡收入只涨了不到 3 倍。差额去哪了?
答案就是那 255 倍里,绝大多数是「重读」的 token。 它们几乎不消耗算力,也卖不出几个钱,但把吞吐量撑了起来。量冲上去了,成本没跟着冲上去——这才是「敢卖便宜,还能赚钱」的底气。
顺带说一句:流传中的「命中率 96%」这个数字,目前没有在官方公告、仓库说明和部署问答里找到原文,只能算「待考」。上面对比只用有出处的 56.3%。
五、客户换人了:从一问一答,到智能体
命中率能从五成多涨到九成上下,背后是客户结构变了。
2025 年的大头是聊天:一问一答,前后重复的内容不多,命中率天然偏低。
2026 年的增量大头是智能体(Agent)。智能体每做一步,都要把系统提示、工具说明、前面几十轮的记录重新发一遍——新写的只有一小段,重复的是绝大部分。
这不是猜测。看 OpenRouter 这类聚合平台的调用榜就知道:2026 年 10 月 19 日至 25 日那一周,DeepSeek 的 V4.1-Flash-1017 单周被调用 33.6 万亿 tokens,环比增长 801%,登顶全球第一;而榜单上调用量最大的应用类型,正是写代码、操作电脑的编程智能体。
智能体是天生「重读型」的负载。 谁把重读做成了最便宜的那一项,谁就接住了这波增量。
官方在存储设计上也印证了这一点:缓存按流量类型分档保存——智能体流量保留 3 天,聊天流量保留 7 天;如果统一缩短到 3 天,聊天流量的命中率会下降 0.5%–1%。
六、成本不止显卡:那 100 PiB 的硬盘
理解了缓存,就能理解一个反直觉的推论:token 涨 10 倍,显卡不一定涨 10 倍。
因为命中缓存的那部分不重算,新增需求有很大一块落在了存储和网络上。官方口径里,单套缓存用的 SSD 规模是 约 100 PiB(1 PiB ≈ 1024 TB),单台存储服务端要求至少 40GB/s 的读吞吐。
这意味着什么?
- 推理生意的成本项里,除了 GPU,还有存储集群、高速网络、调度系统;
- 谁想复制这套模式,先得自建百 PB 级存储,再把命中率调到九成以上;
- 而「缓存管理」和「负载均衡」这两块,官方明确说没有完整开源——理由是跟内部系统耦合太深。
所以框架开源了,护城河还在。框架是图纸,缓存管理和调度是把图纸变成生产线的工艺。
七、为什么要开源:两本账
明知赚钱,为什么把框架开源?从公开信息能读出两本账。
第一本:让自家底座成为行业默认。 闭源大厂是把最强的模型锁在自家按量收费,像卖油;开源是把底座送出去,让别人都长在上面,像安卓。云厂商如果自己部署的成本比直接调官方还高,最理性的选择就是把请求转给官方——这就是「成本领先」在软件生态里的复利。
第二本:给国产算力修路。 DeepInfer 的硬件白名单是英伟达 SM100 和华为昇腾 950。美国对高端芯片的出口管制让算力采购受限,把「能在昇腾上跑大模型」的框架开源出去,等于拉着全球开发者一起分摊「CUDA → 昇腾」的迁移成本。这条路修好了,国产算力的需求才有地方落地。
八、钱往哪流:三个方向,两种确定性
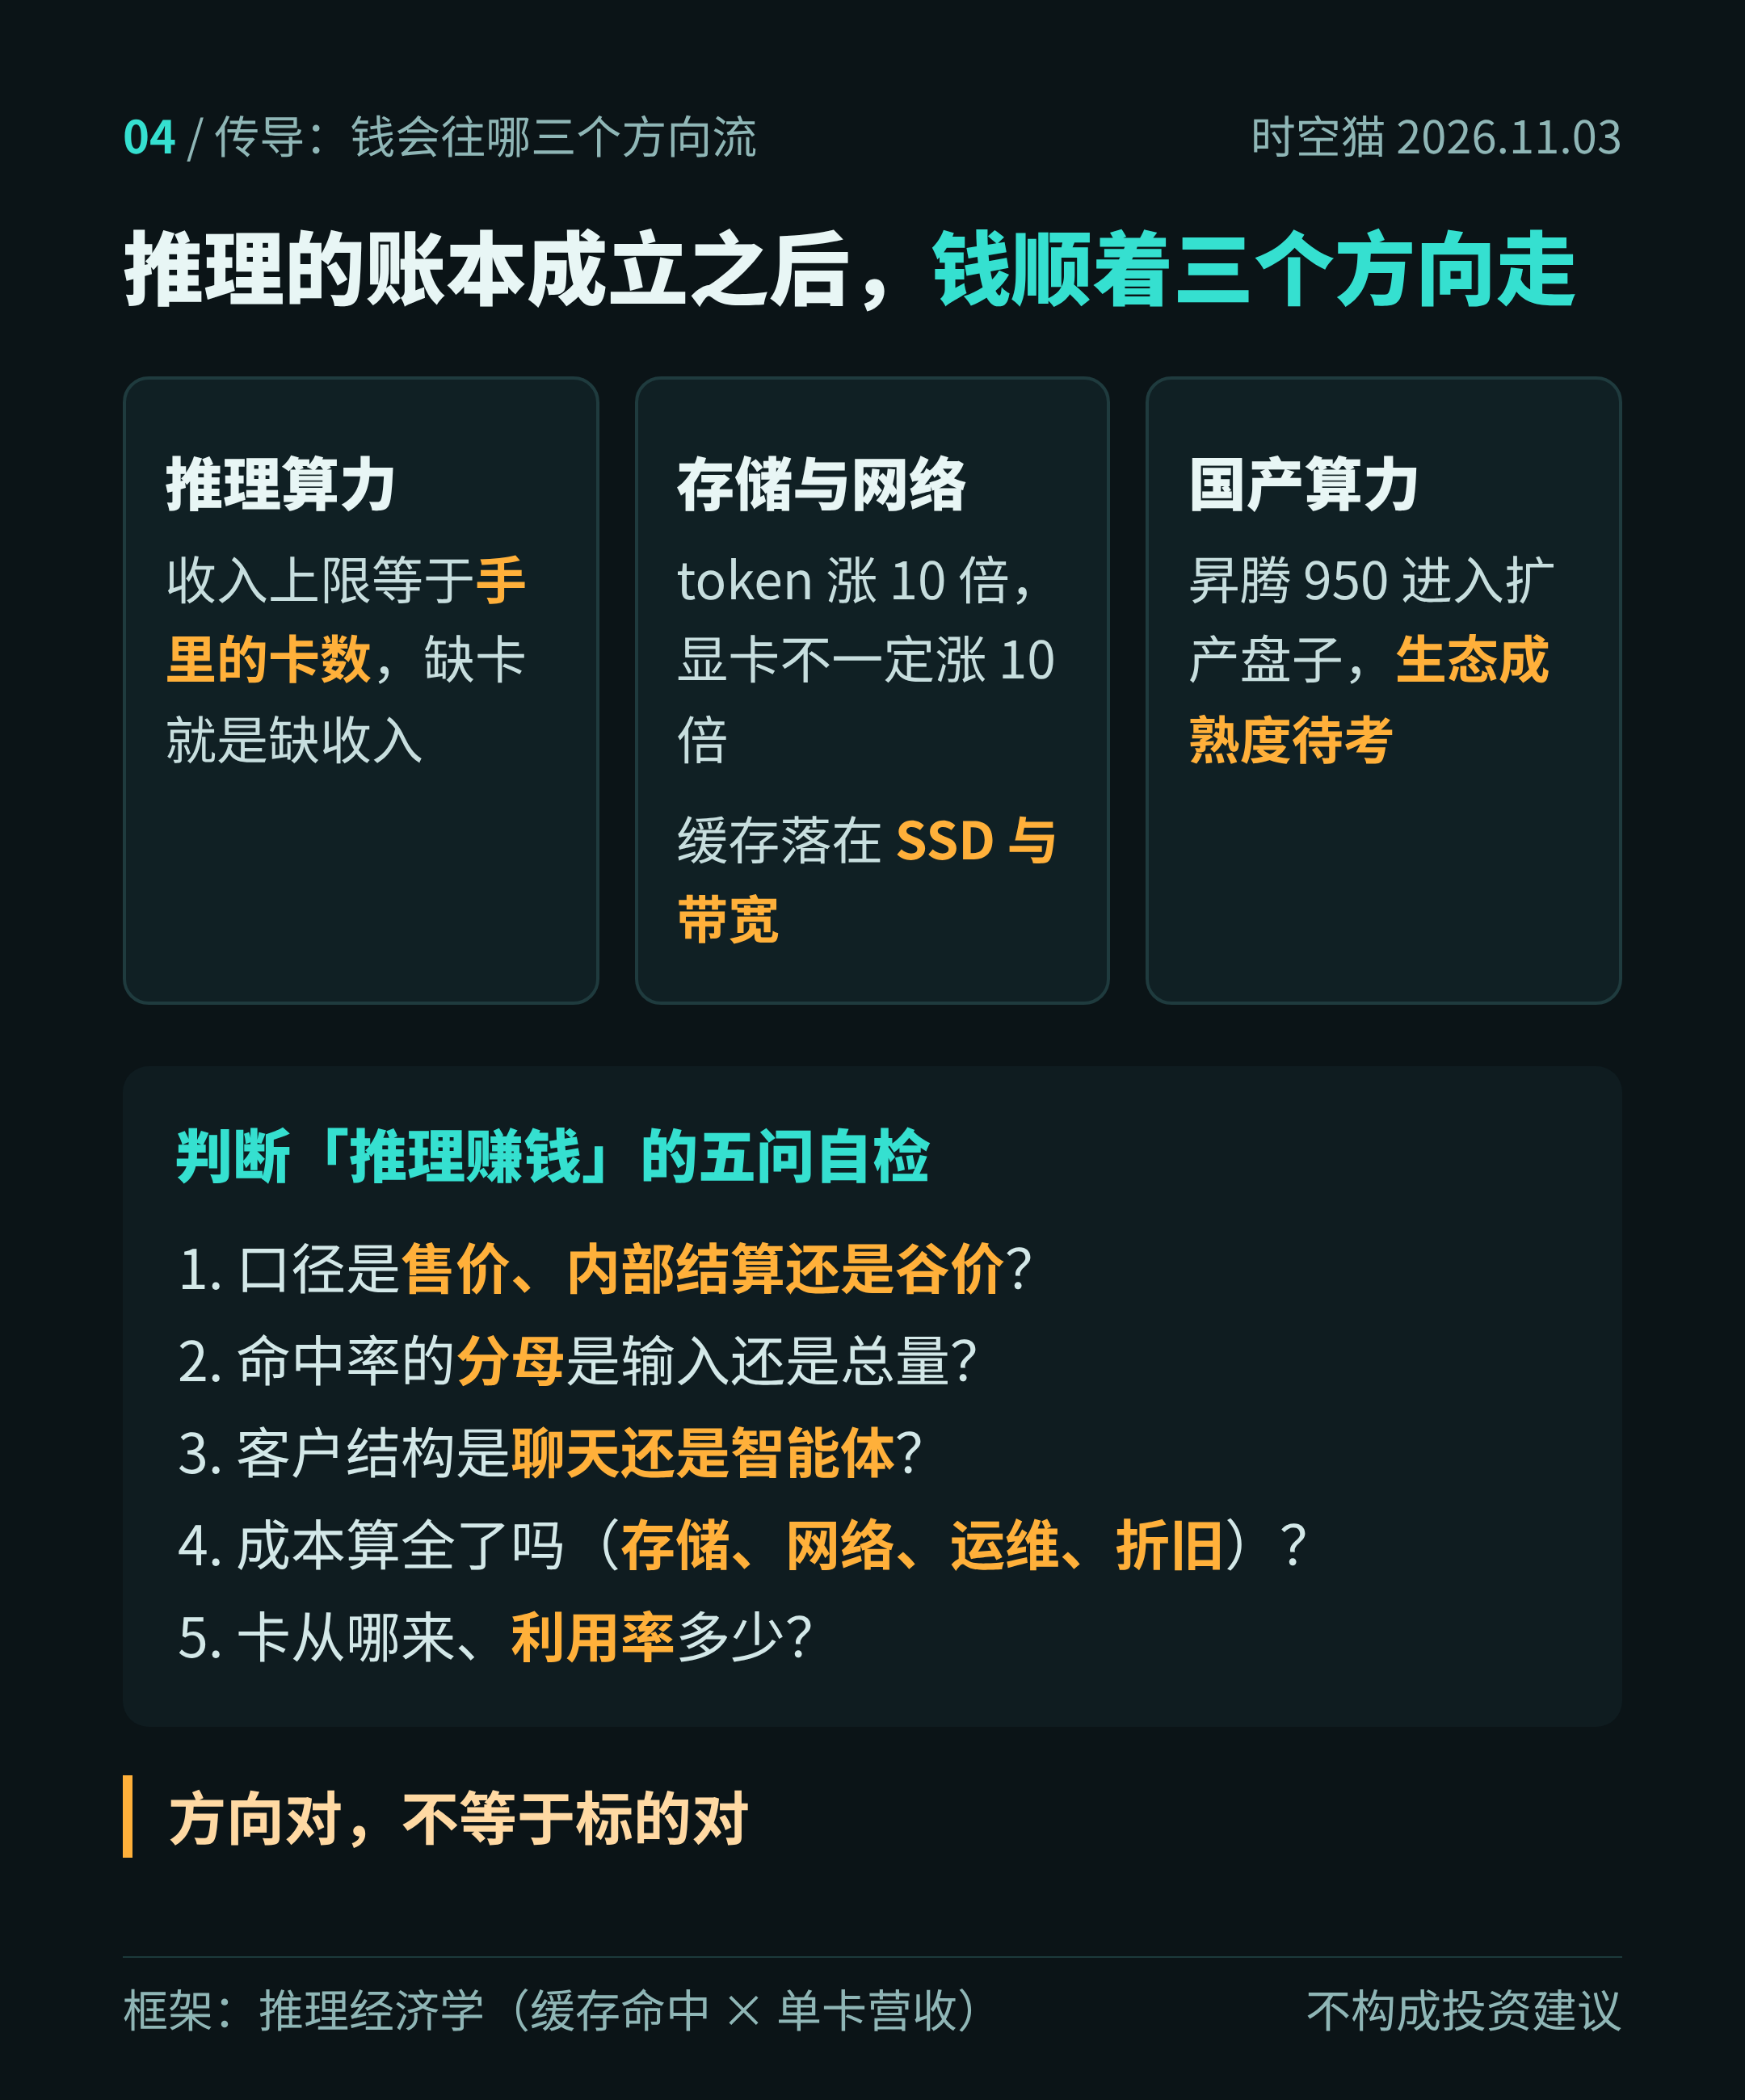
如果上面这套账成立,产业的钱会往三个方向走:
① 推理算力。 收入上限 = 手里有多少张卡。2026 年 10 月 15 日的那次大中断(08:11 起,13:04 恢复,近 5 小时),市场普遍归因于算力与工程承压——需求在加速,供给跟不上,这就是算力继续扩张的理由。
② 存储与网络。 这是被低估的一环。命中缓存的内容要落在 SSD 上,读得够快靠的是高速网络与调度。token 量涨,存储和网络的弹性需求会先涨。
③ 国产算力。 昇腾 950 已经进入扩产讨论。这条线的确定性来自「需求确定 + 替代确定」,不确定性来自「软件生态成熟速度」。
但要提醒的是:方向对,不等于标的对。推理经济学的账本,是「行业级」的判断,落到具体公司,还要看它的客户结构、利用率、以及是否真的把缓存做成了能力。
九、五问自检:怎么判断别人说的「推理很赚钱」
下次再看到「某某做推理赚翻了」的说法,用这五个问题过一遍:
- 口径是什么? 是对外售价、内部结算价,还是谷价?三者差好几倍。
- 命中率多少,分母是什么? 是输入命中率,还是总 token 命中率?分母不同,结论完全不同。
- 客户结构是什么? 聊天为主还是智能体为主?前者重复度低,后者重复度高,命中率天差地别。
- 成本算全了吗? 有没有算存储、网络、运维、折旧?只算 GPU 租金的「毛利率」都是耍流氓。
- 卡从哪来、利用率多少? 收入上限是卡数;有卡但闲置,账本一样不成立。
五问里只要有一问答不上来,那个「赚钱」就先别信。
十、边界:哪些是确定,哪些还不确定
- 确定的:155 万亿/天、38 美元/卡·时(谷价)、100 PiB 级缓存、TTL 分档、未开源的三个组件、昇腾 950 支持——都有官方出处。
- 推算的:255 倍、2.9 倍、「单卡 10–13 美元」——是用官方数字做的除法,口径已在文中标注。
- 待考的:「96% 命中率」——官方三份材料里没找到原文。
- 不能推的:38 美元不是利润;命中率高不等于长期壁垒;一次数据披露不等于可持续的商业模式。
来源与说明
本文数据来自:DeepSeek 官方公众号公告(2026-10-20)、DeepInfer 仓库说明与《DeepSeek V4.1 Flash 推理部署 Q&A》、DeepSeek 2025 年 2 月《V3/R1 推理系统概览》、OpenRouter 公开周榜(2026-10-26,统计周 10-19 至 10-25)、谷歌 2026 年 I/O 公开演讲、中国信通院《大模型词元服务性能监测报告(2026 年)》。
计算过程:255 倍 = 155 万亿 ÷ 6080 亿;单卡收入倍数按 38 美元 ÷ 约 13 美元估算,13 美元由理论日收入 562,027 美元 ÷ 24 小时 ÷ 约 1814 张卡得出(官方未直接披露卡数,故为推算)。
本文为行业分析,不构成任何投资建议;提及的公司与产品仅作技术讨论,不代表推荐。