11 月 8 日,一场对话里,中国工程院外籍院士张亚勤问了腾讯首席 AI 科学家姚顺雨一个很商业的问题:模型公司的护城河,到底是什么?
姚顺雨的回答没有落在模型上。他说,壁垒更多在产品层——真正难替代的不是最聪明的模型,而是能理解用户背景、用得上专有数据和上下文、并且被用户信任的 AI 产品。
张亚勤顺着这个逻辑开了个玩笑:那按你这么说,Anthropic 未来或许不值一万亿甚至两万亿美元了,因为模型总有一天会商品化。然后他转头提醒现场的学生,千万别听他的去买股票。
这个玩笑里藏着一个真问题:如果模型真的会商品化,那什么不会?
我把知识库里所有讲「护城河」的内容翻了一遍——三十多条,从 2024 年梁文锋的访谈,到今年的马斯克、刘小排、Mashrabov、姚顺雨。它们讲的是不同生意,但放在一起看,其实可以用同一把尺子量:
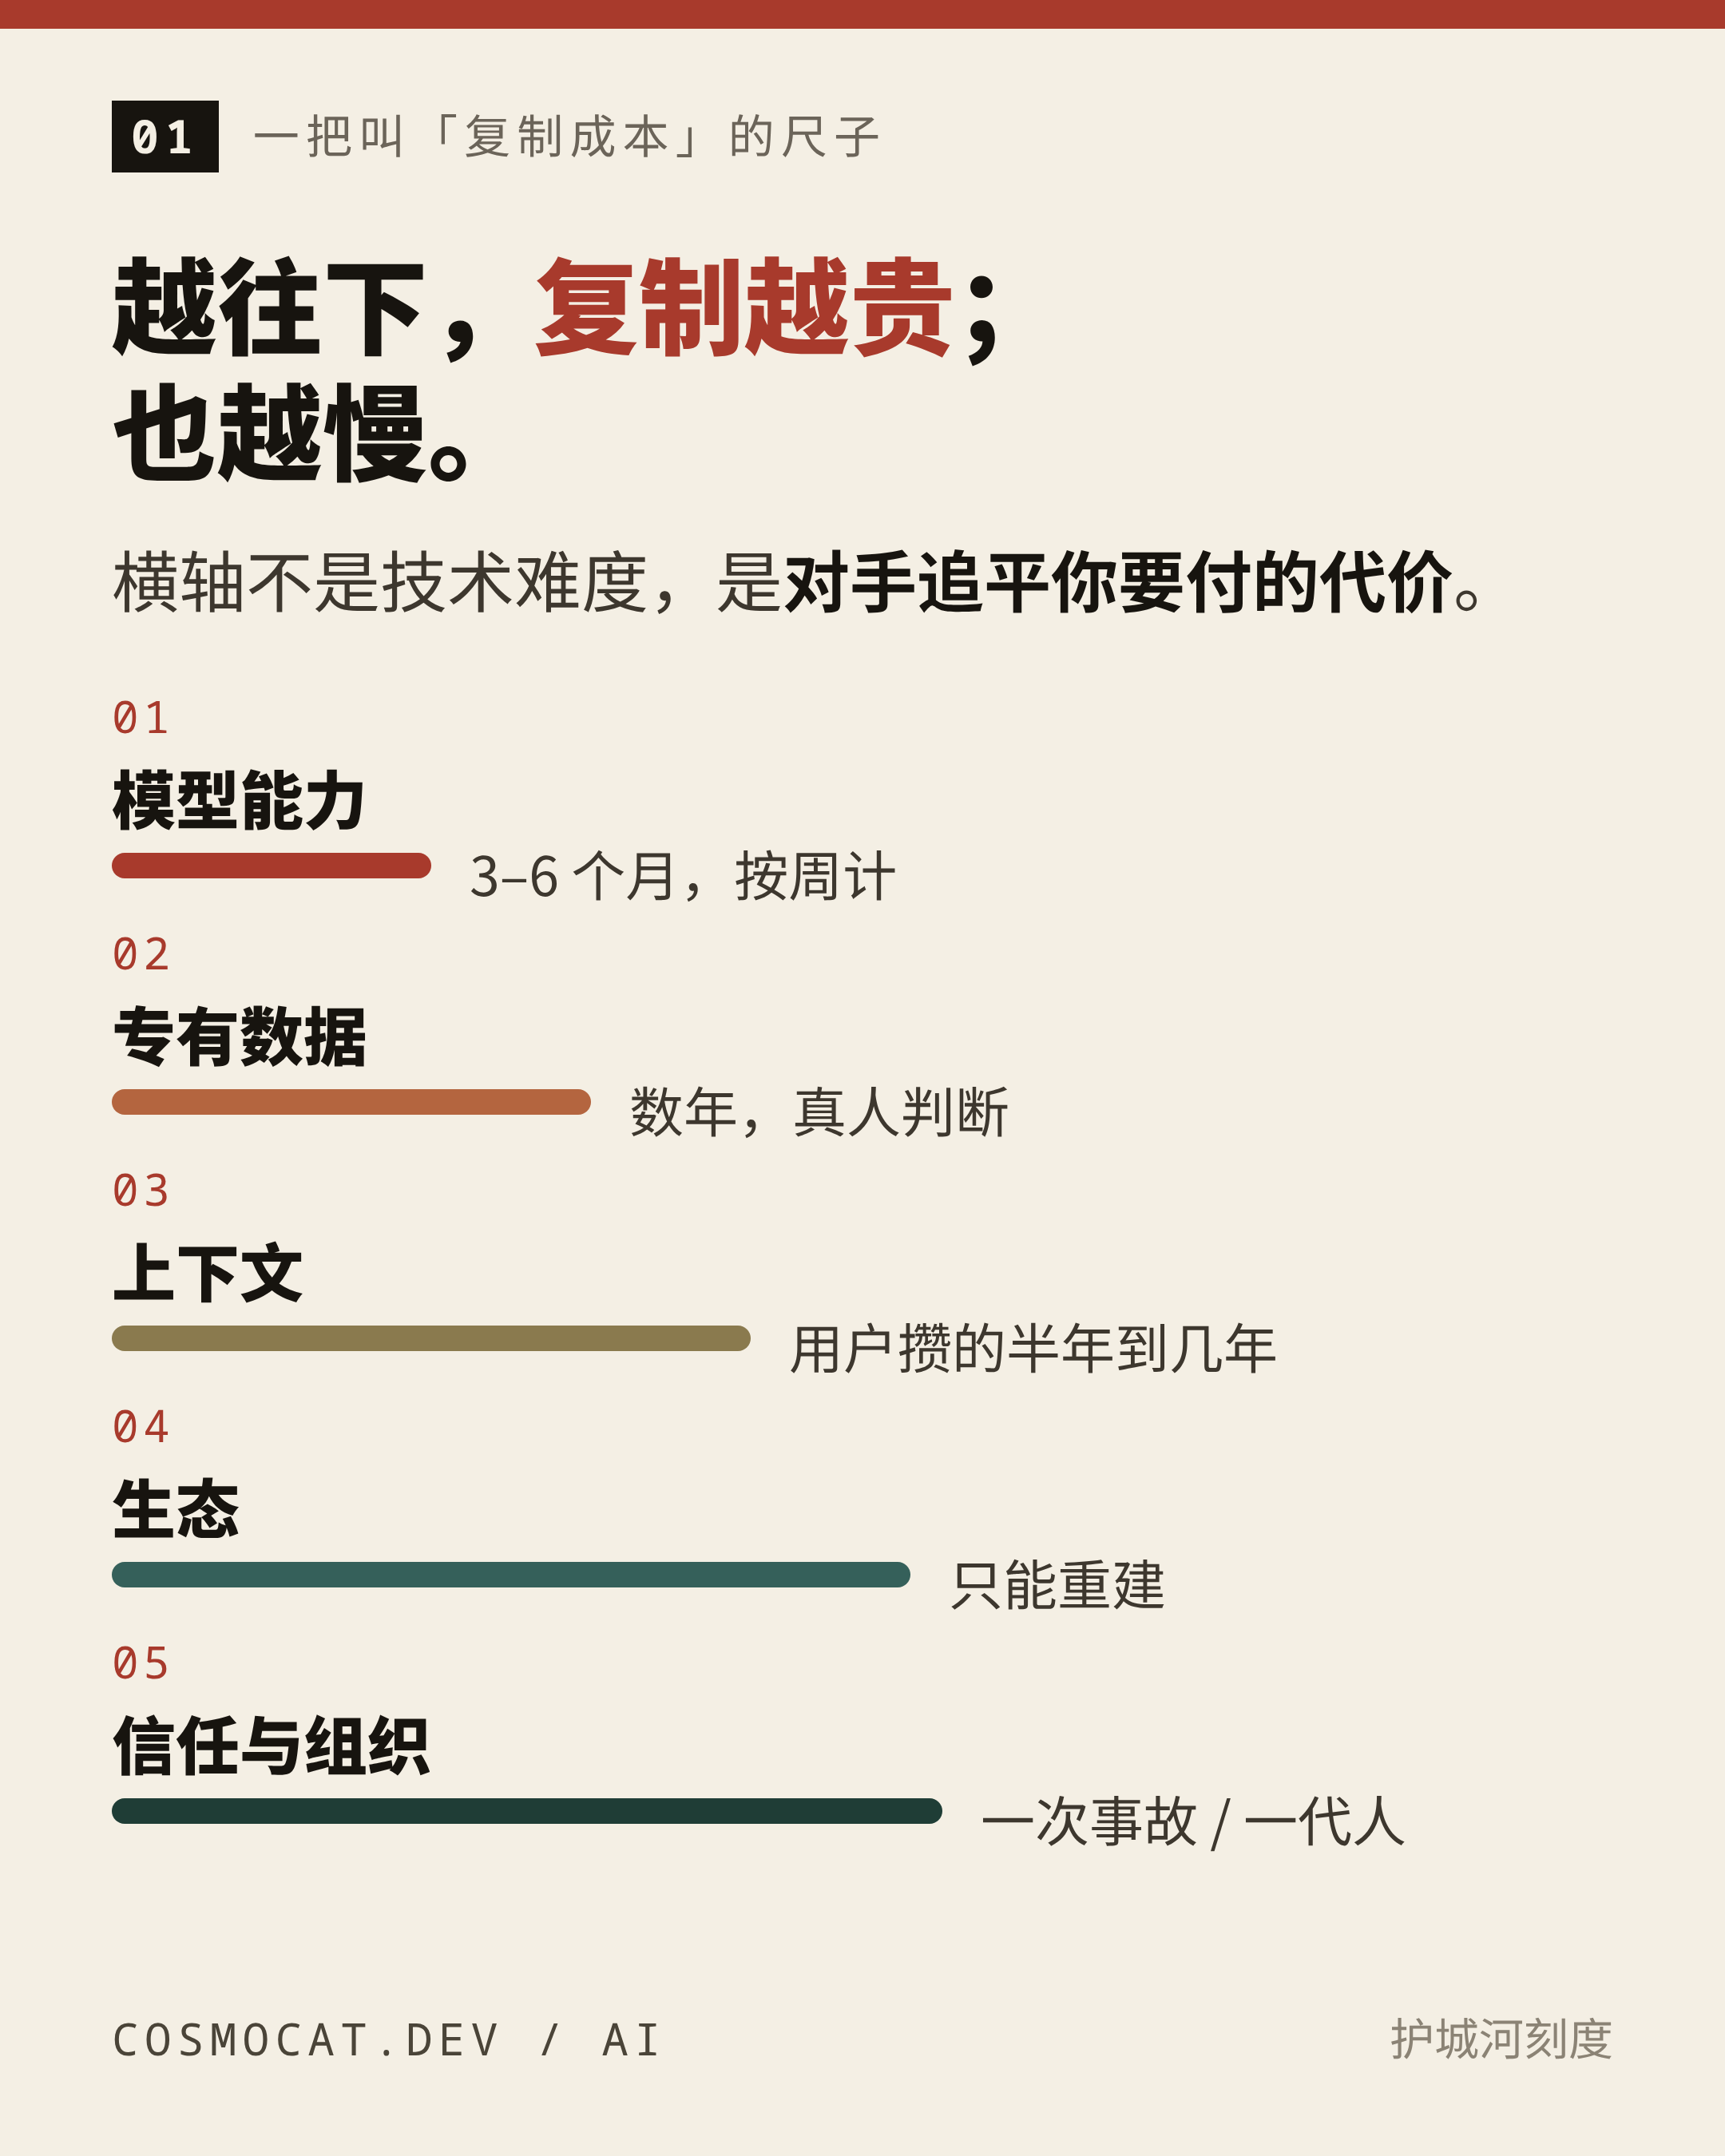
复制它,要多久、要付什么代价。
答案清单越长、重建越慢的那一层,才是真的墙。
四种位置,同一道题
先看四句话。
梁文锋(DeepSeek)2024 年被问「开源会不会让对手复制你的护城河」,他的回答是:「没有秘密,但复制需要时间和成本。」英伟达的 GPU 也没什么神秘的,但你要追上,就得重建团队、追赶下一代技术。
刘小排(独立开发者)今年 11 月说的是同一件事的产品版本:「把 EvoLink 的代码全部给你,你也复刻不出来它的客户、口碑、用户规模。」
姚顺雨换了个角度:「即使竞争对手推出了一个更聪明的模型,也不意味着它能提供同样的服务,因为后者未必知道用户是谁。」
Mashrabov(Higgsfield 创始人)说得最狠:「行业今天兜售的大多数技术壁垒,很大程度上是伪命题。」他认为真正能沉淀的只有两样:交付最终商业结果,和构建难以逆转的网络效应。
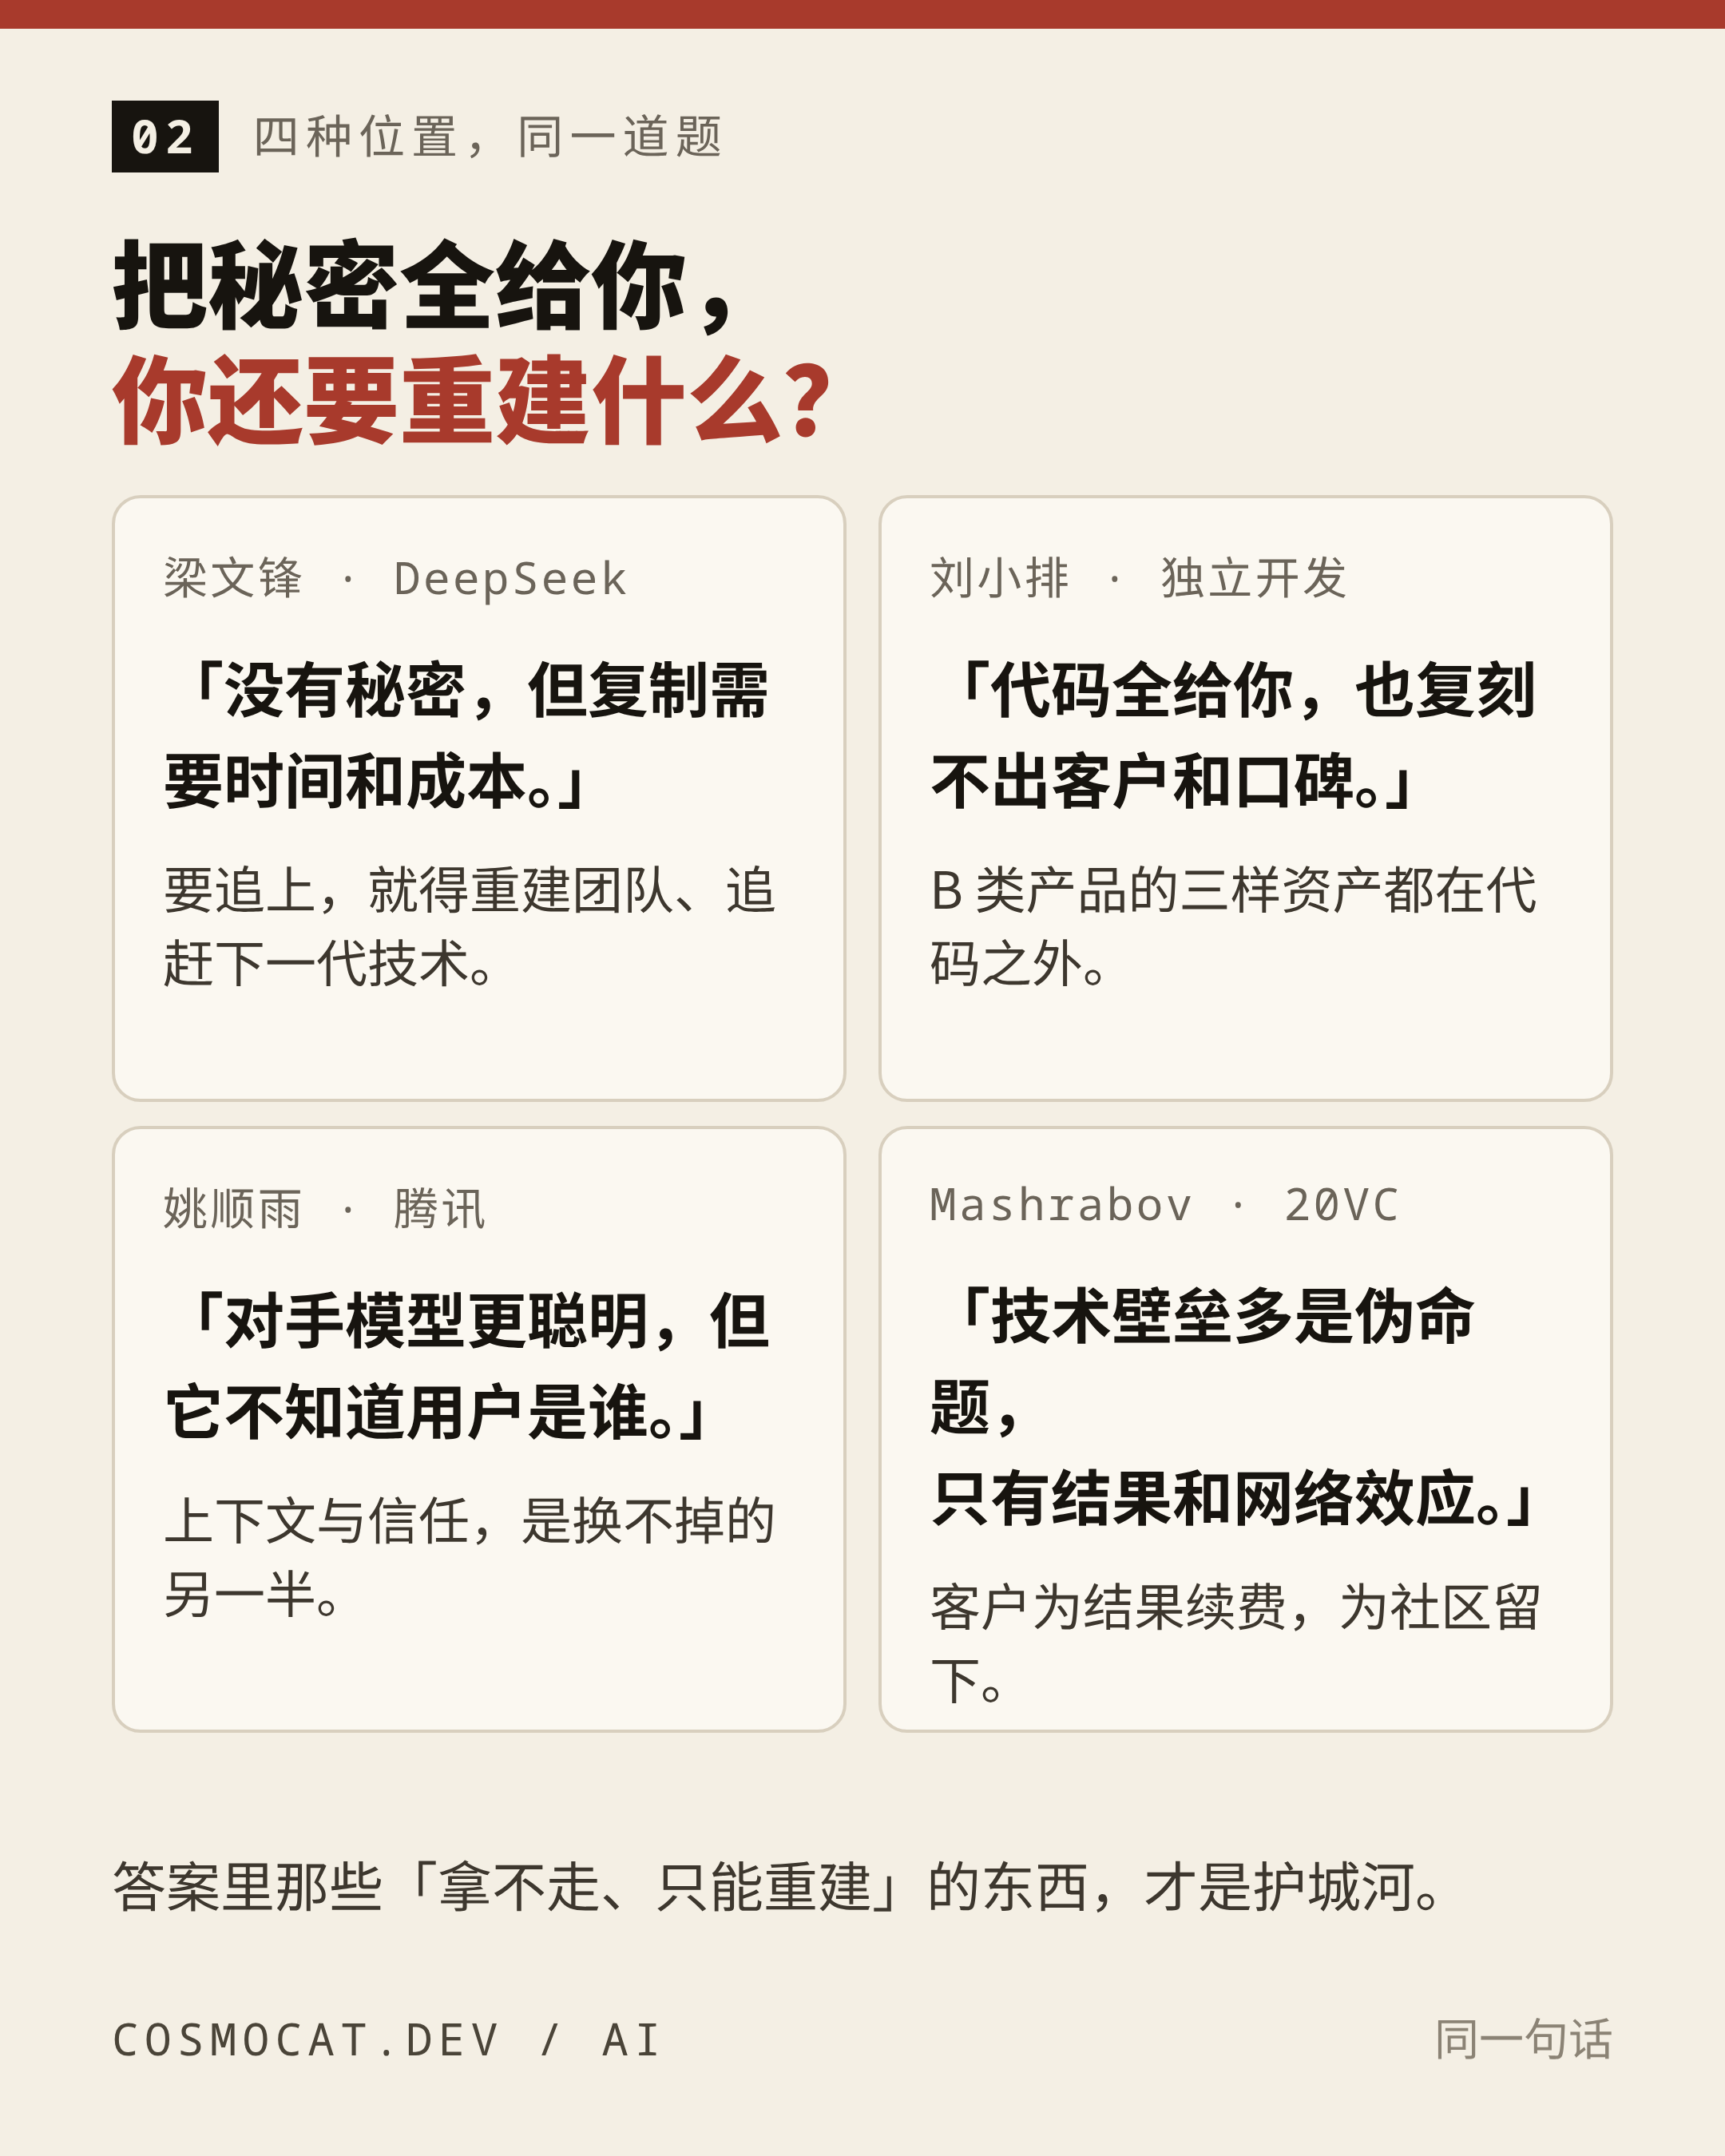
四个人,两个在中国、两个在美国;两个做模型、两个做产品。他们说的其实是一道测试题:
把我的秘密全部给你,你还要重建什么?
答案里那些拿不走、只能重建的东西,就是护城河。下面按「重建要多久」从短到长,拆成五层。
第一层:模型能力,折旧最快的一层
姚顺雨在那场对话里给了一个时间尺度:大模型的领先优势,3 到 6 个月就会发生变化。
这个数字还算客气。知识库里「大模型华强北化」那条记录是更冷的版本:Kimi K3 在 2026 年 7 月发布,2.8T 参数、当时全球最大规模的开源模型;不到一个半月,Qwen3.8-Max、GLM-5.3、Step 5 Preview 就在 Artificial Analysis 的综合智能榜单上追平或超过了它。
原因不复杂:权重开源、蒸馏成熟、评测公开、人才流动。一套能力被验证有效之后,复制它的路径几乎是透明的。连「新范式」都在加速贬值——Jev 最热的时候,Redis 作者 antirez 公开说他两小时就复现了一个能跑的版本。
所以模型层的问题不是「不重要」,而是它在资产负债表上折旧太快。今天的 SOTA 是入场券,不是墙。你可以靠它抢三个月的窗口,但很难靠它收三年的租。
但模型层有一个不折旧的变体:迭代速度本身。腾讯混元 Hy4 发布时提到,用 Hyra 2.0 脚手架自动训练出的 Hyra-Jev,在 8 项基准里有 6 项优于官方 Jev。这说明真正的资产不是某一版权重,而是「能持续造出下一版」的组织能力——那已经属于第五层了。
第二层:专有数据,要「真人判断」而不是「多」
数据护城河常被误解成「数据量」。知识库里最锋利的一个样本是编程数据。
马斯克在 2026 年 10 月的一场访谈里承认:全球真正攒够编程交互数据的只有三家——OpenAI、Anthropic、Cursor,xAI 不在其中。随后 xAI 以约 600 亿美元买下 Cursor,当作入场券。
为什么是编程?因为代码的对错可以被单元测试验证,也可以被真实程序员用「接受 / 退回 / 改几行再用」批改。每一次取舍都是一次真人判断,而且可验证。这类数据爬不到、实验室也造不出来,只能靠成千上万真实用户一行一行攒。
这里有一条很硬的非对称:**算力可以砸钱建,模型可以花时间追,但「真人判断」只能靠时间和用户规模积累。**钱和时间的汇率,在这里不通用。
「不可替代性定价」那条记录给了侧面证据:纽约时报和 Reddit 的 token 数量差不多,但 Reddit 的授权价贵了至少 7 倍(某些口径 14 倍)——因为 NYT 可以被 WSJ 加风格迁移近似替代,Reddit 上的真实讨论找不到替代品。
所以数据层的自检问题不是「我有多少数据」,而是:**我的数据,是别人跑一遍就能得到的吗?**如果是,它就不是护城河,只是原料。
第三层:上下文,用户愿意攒的那半年
OpenAI 2026 年 9 月的 DevDay 之后,有一句判断被反复引用:换一个模型几乎没有成本,但换掉一个跟了你半年、知道你下周三要录视频、握着你几千个应用登录态的 Dot,那才真的很有成本。
迁移成本有四个来源:偏好记忆、登录态与权限、历史协作产物、团队协同网络。它们共同构成一句话:模型可换,用户的工作流资产不可换。
姚顺雨的微信例子是同一个逻辑的 ToC 版本:这个 AI 未必需要最强的模型,但它知道你的日程、朋友关系和活动信息。对手推出一个更聪明的模型,也不代表它能提供同样的服务——因为它不知道用户是谁。
这一层的复制周期,等于用户愿意在你这里攒多久。它没法一次性买来,只能一天一天长。产品含义也随之改变:不是做更多功能,而是把记忆、授权、历史、协作沉淀下来,让用户「懒得搬」。
它也有冷启动难题:用得越少,上下文越薄;上下文越薄,越没有换不掉的理由。这也是为什么「用完即走」的套壳产品,永远长不出这一层。
第四层:生态,复制不了,只能重建一个
再往上一层,是生态。
个人 Agent 竞争最热的时候,有个判断很清醒:软件层的能力——主动性、定制、记忆、界面——都能在一夜之间被抄走;抄不走的是生态。Meta 有 Instagram 和 Facebook,xAI 有 X 的社交图谱,亚马逊则直接用封禁宣示交易闭环的主权:谁拥有消费者与交易之间的界面,谁就收得到入口税。
生态的本质不是「功能多」,而是三样东西的独占组合:数据源、分发渠道、交易闭环。这三样都没法靠写代码补。
Mashrabov 给过一个自建生态的量级:Higgsfield 把工程管线开源后,平台的开源工程库在 8 周内从 10 个涨到 10000 多个高活跃工程。这是网络效应的复利:开发者可以 Fork 前人的成果再叠加增量,越多人用,后来者越难追。(数字是创始人自述,没有第三方审计。)
中国这边是镜像的另一面:不是生态太强,而是生态割裂。微信、小红书、美团、淘宝不向 Agent 开放数据权限,跨 App 的任务——全网简报、聊天统一管理、外卖比价下单——就卡在门口。所以国产 Agent 的竞争,很大一部分不是模型竞争,是「能不能进别人的院子」。
第五层:信任与组织,一次事故或一代人
最贵的一层,也最容易塌。
2026 年 9 月,Anthropic 要求企业客户把对话记录与使用日志保留 30 天。英伟达、Palantir 等公司随即限制内部使用 Claude,Palantir 甚至要求一份「不可撤销的零数据留存保证」,否则不接入专有信息。零数据留存(ZDR)从加分项变成了采购门槛。
这件事的杀伤力在于:它不攻击模型能力,直接攻击授权关系。客户一旦不敢把数据交给你,前面四层全部归零——因为你连被使用的资格都没有了。
姚顺雨把这件事说得很透:当 AI 从回答问题转向代表用户执行任务,用户是否愿意开放个人信息、是否信任它安全地处理数据并采取行动,会直接决定产品的使用深度。信任不再只是品牌概念,而是使用深度的前置条件。
组织是这一层的另一半。梁文锋说 DeepSeek 的护城河是团队成长、技术 know-how 和创新的文化——这些东西的共同点是:**你可以把结论抄走,但抄不走「得出下一个结论的能力」。**要追,就得重建一个团队,再追赶下一代技术。
对个人和小团队,这一层有一个可操作的版本:验收标准(eval)。一人公司真正的壁垒不是工具多强,而是你把「什么才算干好了」写得有多清楚。先有尺子,再量活,再改尺子;尺子越硬,交付越稳,客户越敢反复找你。工具谁都能买,标准只有你自己写得出来。
再往软里说一层,是审美与耐心——在游戏开发里,流程能让你做出一个能运行的游戏,但不能保证有人愿意玩第二次;两者之间的差距,只能由人带进来。
裁判席:商业结果
五层墙,最后都要过同一道裁判:客户为什么续费。
Mashrabov 的判据是「能不能交付最终商业结果」:不卖抽象概念,实打实帮客户拉升转化和 GMV。刘小排的 EvoLink 是 toB 版本:客户为业务结果采购,用户靠人传人增长。Lovable 的「组合体验」是产品版本:客户买的不是一张图,而是「AI 生成 → 实体成品 → 寄到你家」的完整链条,单点能力被平权,组合服务还在。
反面的判据也很清楚:
- 20 美元轻应用必死——只卖一个可被通用入口覆盖的浅层功能,基座模型一次升级就被顺手吸收;
- 平台收割——你在别人的闭源 API 上攒数据、攒客户,房东看见哪行赚钱就自己下场,客户变对手;
- 平台补贴换来的用户关系,也可能是租来的——当平台用套餐额度帮开发者获客,关系随时可能被截流。
所以护城河不是「我有墙」,而是「客户换不掉 + 愿意续费」。墙是手段,续费才是计分。
三种死法,和一张四问自检表
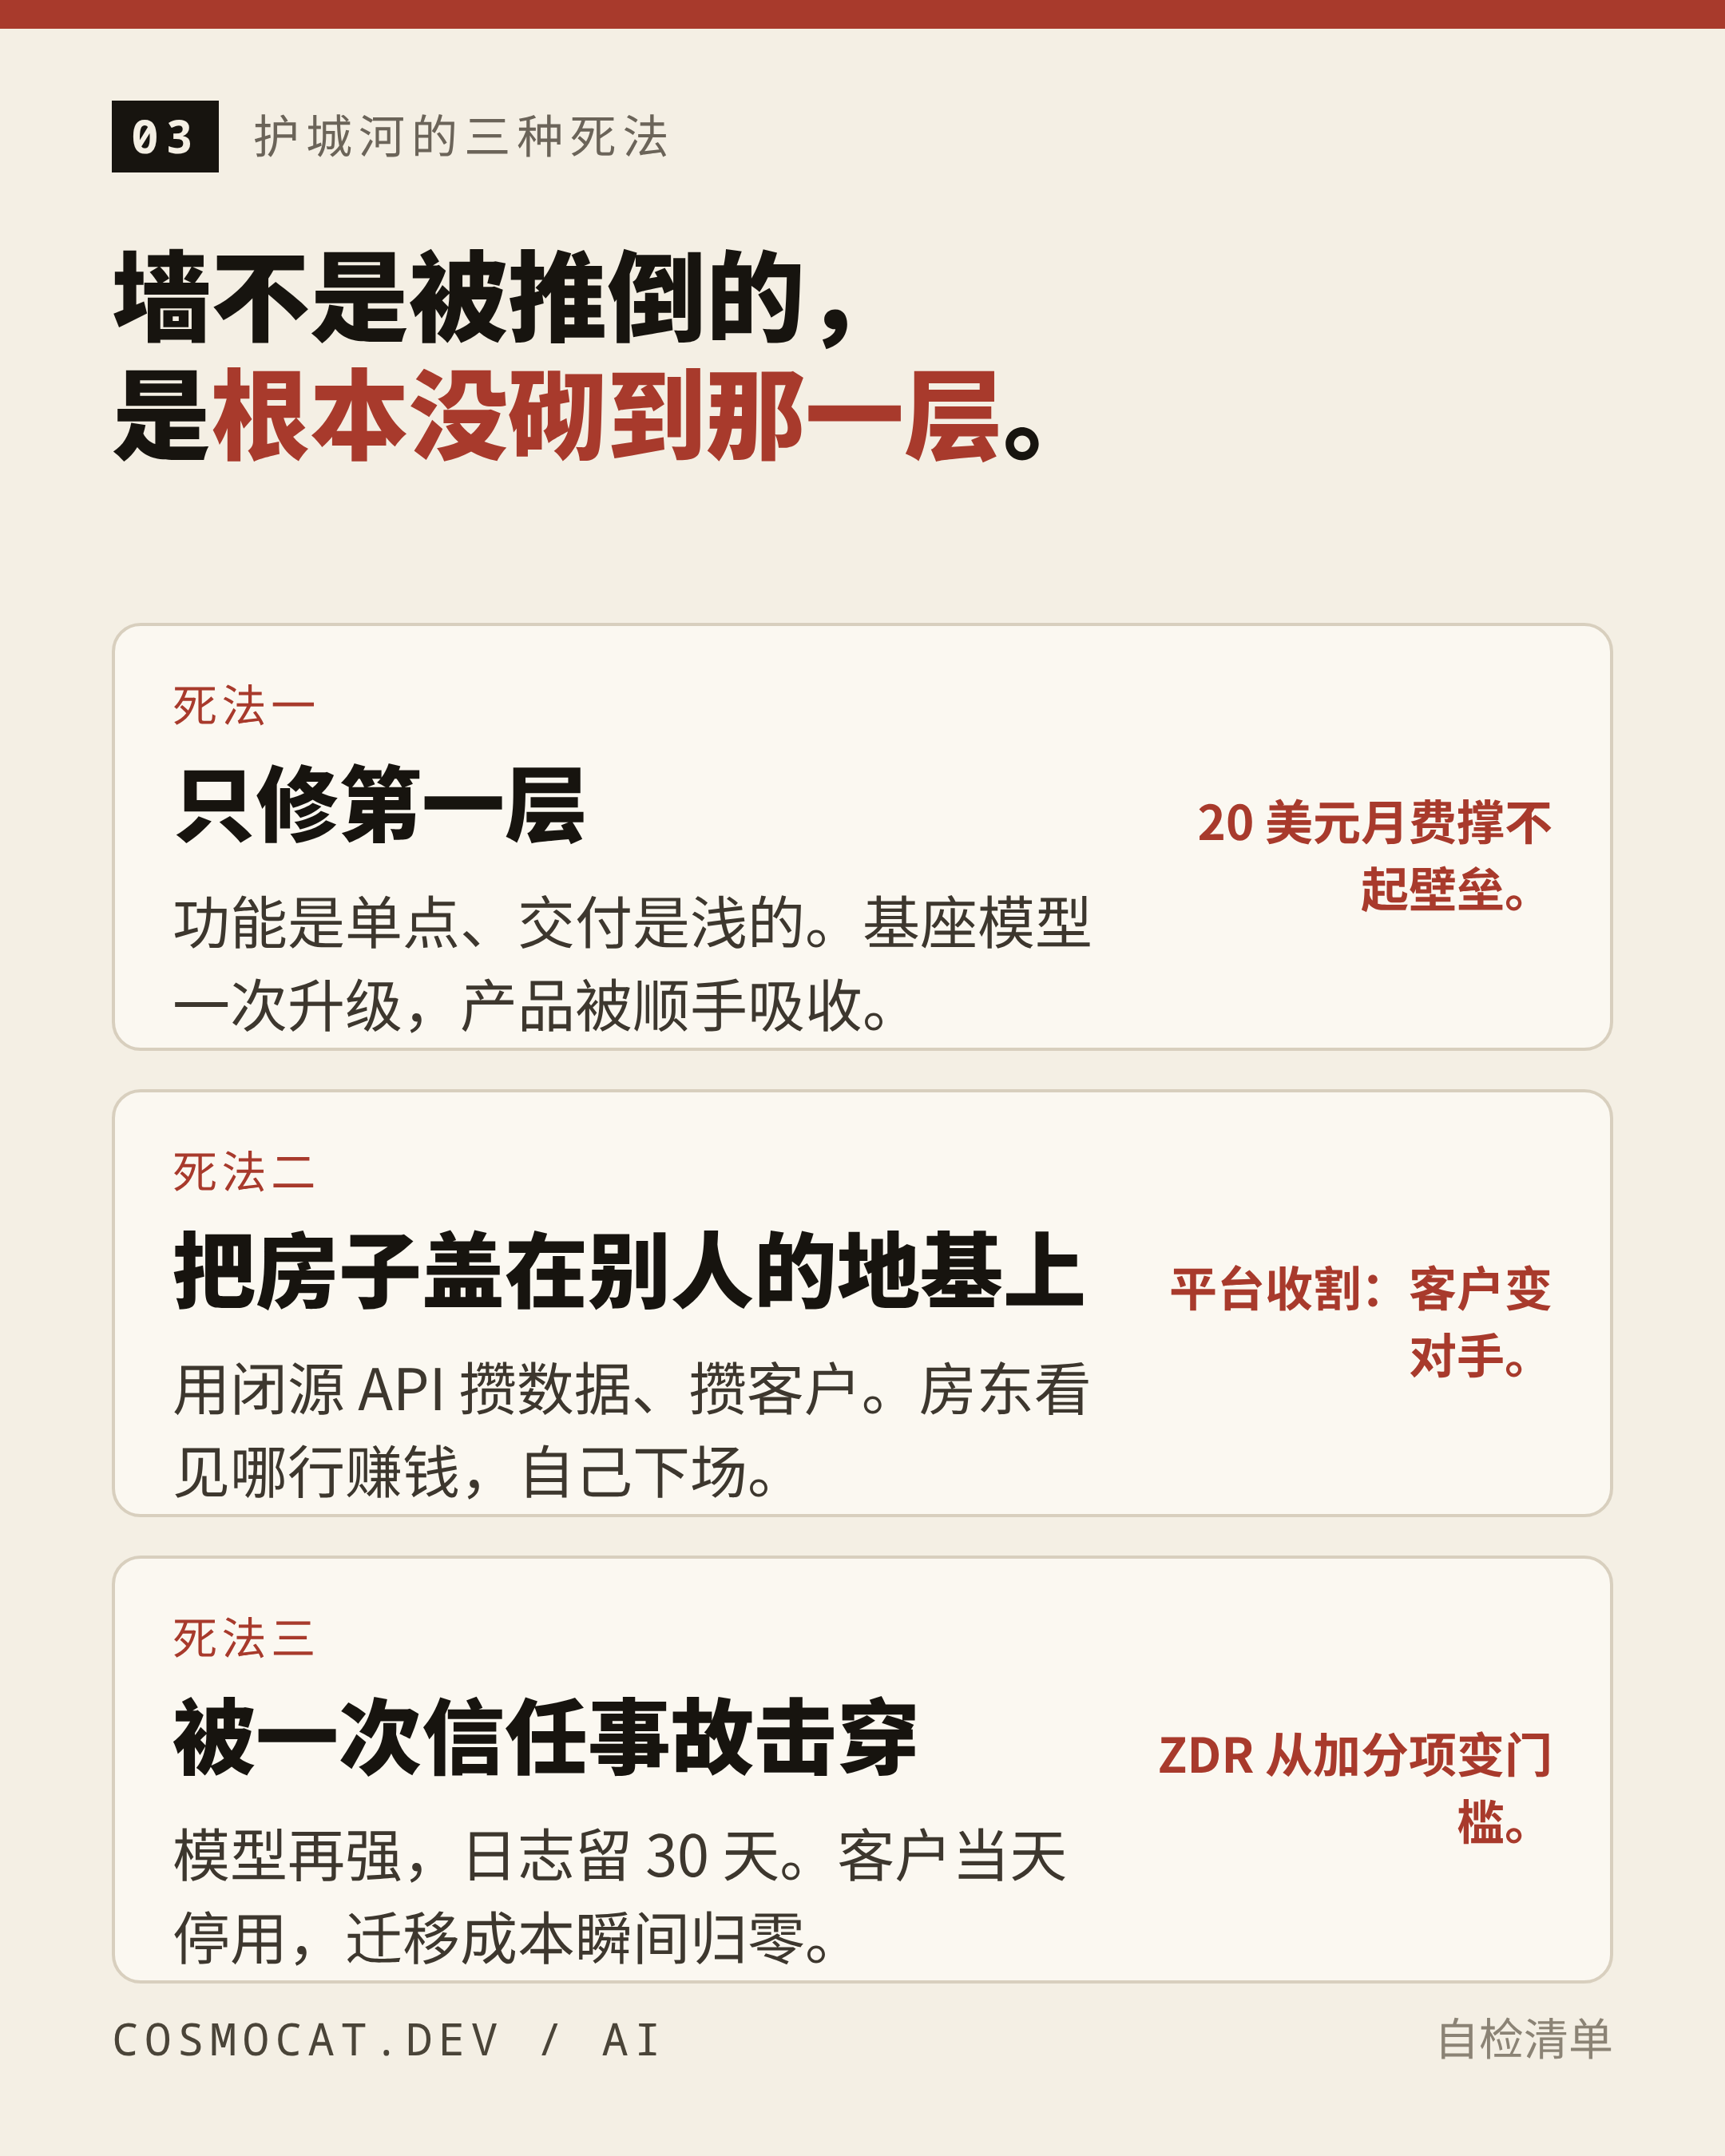
把上面的东西压成三种最常见的死法:
- 只修第一层:功能是单点、交付是浅的,产品靠「我用了更强的模型」讲故事。基座一升级,故事就结束了。
- 把房子盖在别人的地基上:用闭源 API 攒数据、攒客户,却没有自己的上下文、生态或信任资产。房东一下场,你连谈判资格都没有。
- 被一次信任事故击穿:模型再强,日志留 30 天,客户当天停用。迁移成本在信任崩塌的那一刻归零。
对应的四问自检:
- 秘密全给你,对手还要重建什么?(团队 / 数据 / 生态 / 信任)
- 用户换掉你,要重练什么?(记忆 / 权限 / 历史产物 / 同事)
- 客户续费,是结果还是习惯?(说得出被改善的指标吗)
- 出一次数据事故,他还留吗?(赚的是能力差价,还是信任溢价)
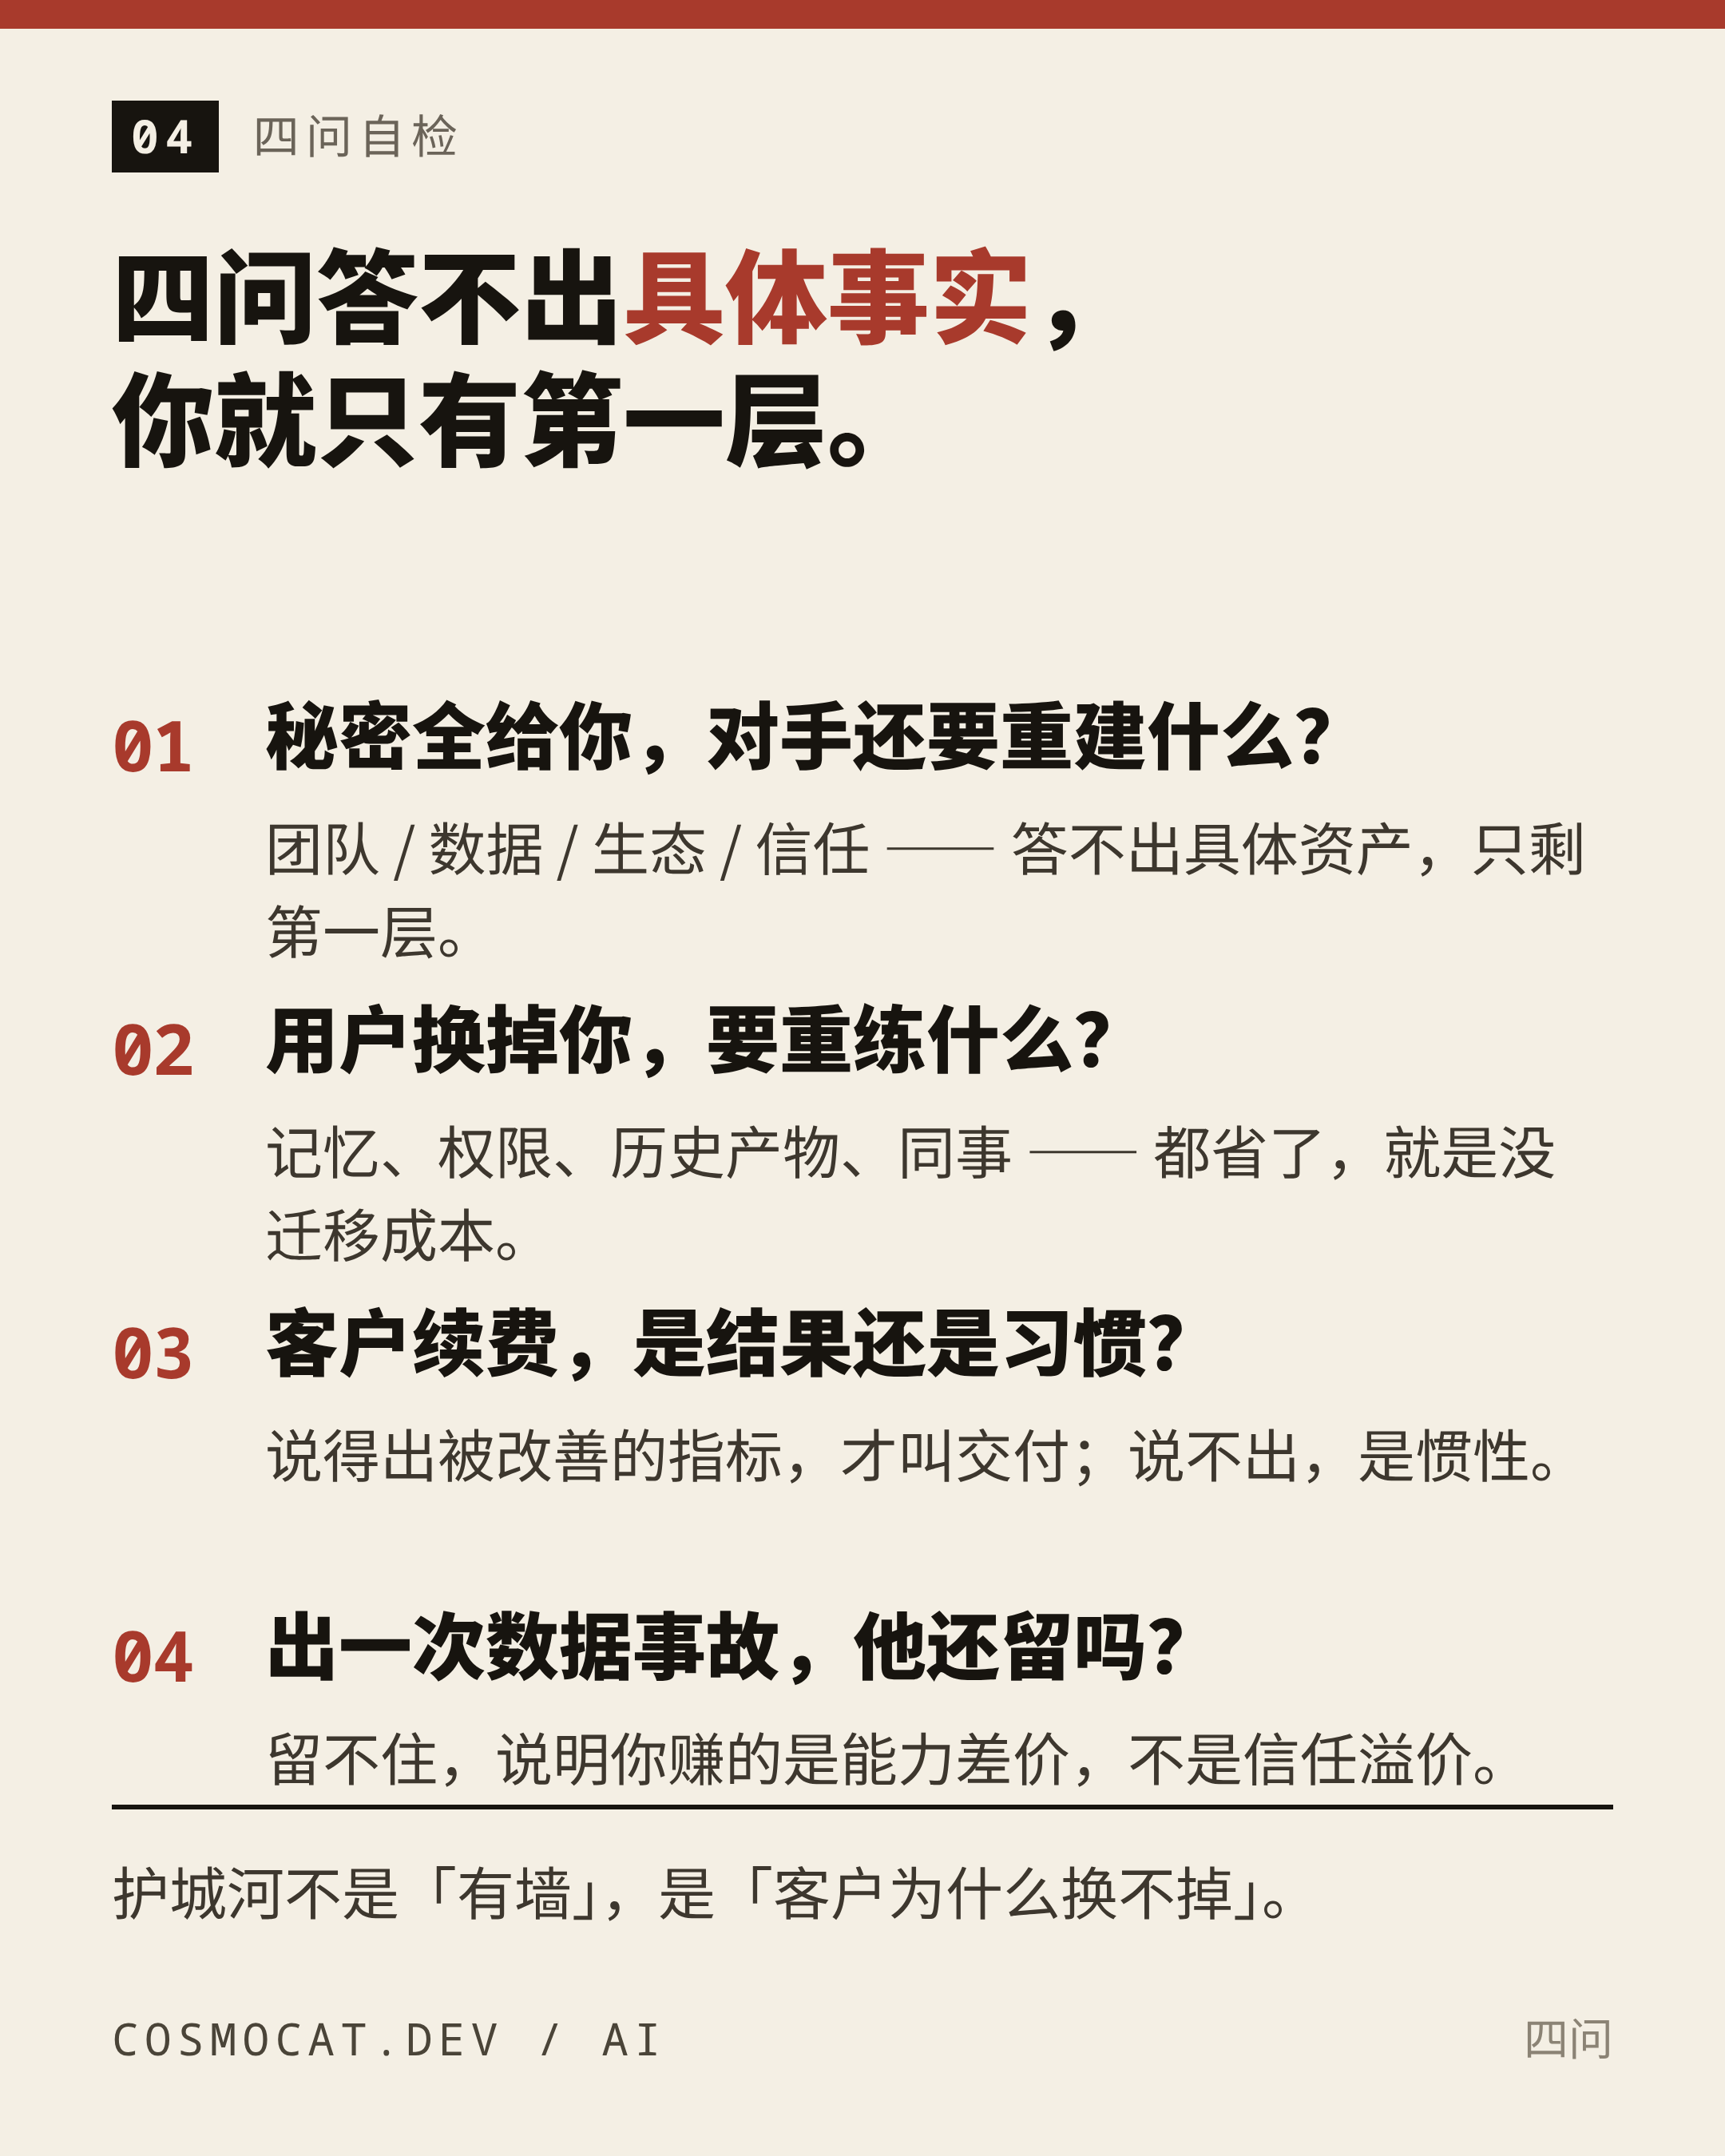
四问答不出具体事实,说明你只有第一层。这不是道德判断,是结构判断。
对个人和小团队,现实的三条窄路
看完五层,很容易得出一个沮丧的结论:生态、数据、信任基建,个人一样都占不到。
确实占不到。但「复制成本」这把尺子也给了三条窄路——它们都不需要你先有钱或有流量,只需要时间和一致性:
**第一,攒上下文。**选一个足够窄的场景,把用户的历史、偏好、产物认真存下来。你不需要最聪明的模型,只需要成为「最懂这个用户这件事」的那个产品。这是姚顺雨那条判断在小尺度上的可用版本。
**第二,攒尺子。**把你所在细分领域的验收标准写出来,一条条可检查。它是 know-how 的编码,也是你唯一能拥有的「私有资产」。客户复购,很多时候不是因为你便宜,而是因为只有你知道什么叫「做好了」。
**第三,卖完整交付,不卖单点能力。**单点能力一定会被平权。把生成、判断、履约、售后组装成一条别人懒得组的链路,你卖的就是「省下来的麻烦」,而不是「一个功能」。
这三条都慢,但都符合那把尺子:它们让对手的重建成本,随着你的经营时间一起变长。
回到那场对话
张亚勤的玩笑其实很准确:如果模型能力最终商品化,单纯依赖模型领先的估值逻辑确实会被挑战。但反过来也成立——模型越便宜,产品层的墙越值钱。
Anthropic 值不值两万亿,对写这篇文章的人不重要。重要的是另一个问题:
明天对手把模型换到和你同款,价格还比你低一半,你的用户为什么还留在这里?
如果答得出来,那就是你的护城河。如果答不出来,那现在就该开始砌了。
来源与说明:本文观点来自公开访谈、行业分析与知识库既有记录,包括梁文锋 2024 年访谈、姚顺雨与张亚勤 2026 年 11 月对话、马斯克 2026 年 10 月访谈、Alex Mashrabov 与 Anton Osika 的公开分享、刘小排 2026 年 11 月文章,以及 Artificial Analysis 榜单相关行业评论。文中标注「自述」的数字均为当事人公开表述,未经第三方审计;「7 倍 / 14 倍」为授权价差的不同口径。本文为方法论整理,不构成投资建议。