33 条求工具的抱怨,只有 2 条提到钱:AI 时代最贵的是筛选
先说结论:抱怨是最便宜的需求线索,也是最容易被高估的那一种。 它证明有人遇到了问题,不证明有人愿意为解决方案掏钱。
这个判断不是我拍脑袋想出来的。前几天看到一个数据:有人把 Reddit 上的讨论、应用商店评论整理成一个付费需求库,创始人自述最近 6 个月毛收入超过 2 万美元,而之前 6 个月只有 714 美元。
这个数字有它的问题——未经审计、不是利润、也不是月经常性收入,连收入截图的时间线都被指出有疑点。但它引出了一个值得认真对待的问题:
公开的抱怨,到底哪一部分能变成钱?
我决定不引用它的结论,自己拿一批真实抱怨拆一遍。
一、我做了什么:41 条抱怨,一套固定的拆法
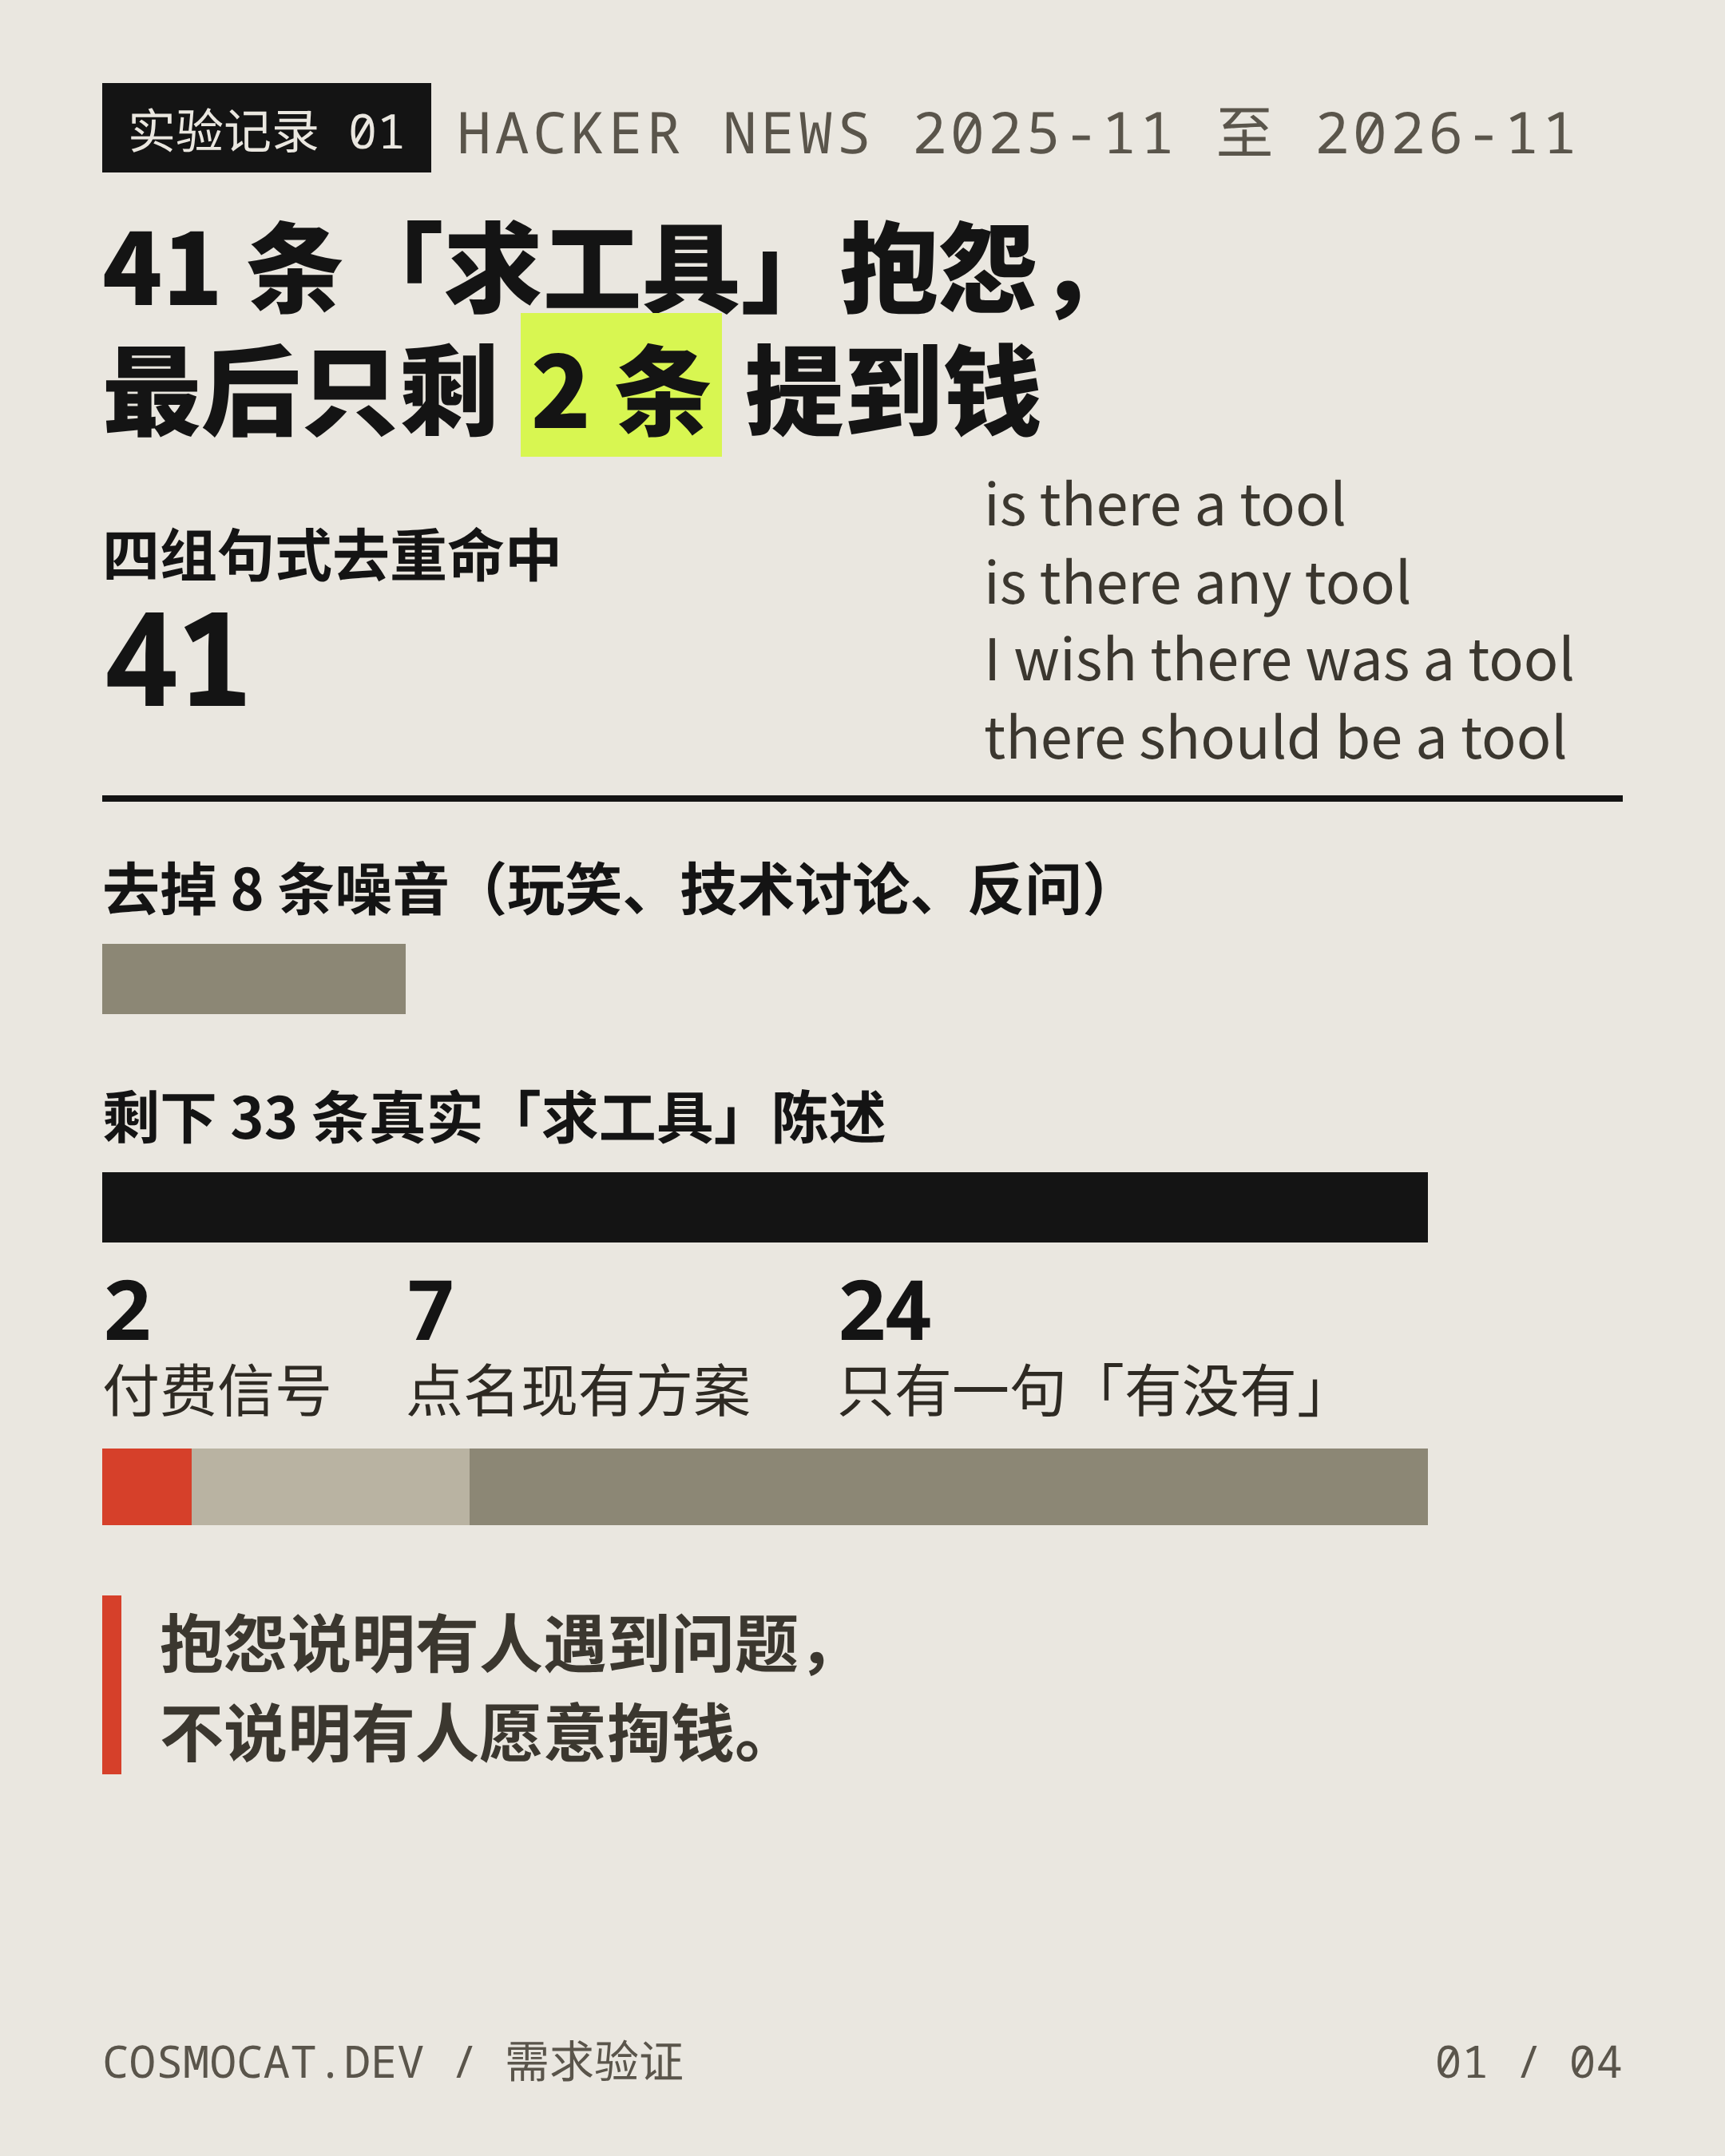
取样规则是完全公开、可复现的:
- 数据源:Hacker News 公开评论。选它不是因为它是「最好的社区」,而是因为每条评论都有固定链接、公开可查、可以逐条核对原话。很多平台的评论区,你连回溯都做不到。
- 句式:只搜四组「求工具」的说法——
is there a tool、is there any tool、I wish there was a tool、there should be a tool。 - 时间窗:2025 年 11 月 1 日到 2026 年 11 月 11 日,整整一年。
- 命中:去重后 41 条。
然后我逐条读了这 41 条,按证据强弱分成四类:
- 噪音:玩笑、技术讨论、反问,不是真在找工具;
- C 类:只有一句「有没有」,没说自己现在怎么解决,也没提钱;
- B 类:点名现有方案或具体缺口,说了「我在用 X,但它缺 Y」;
- A 类:有明确付费信号,说了愿意付钱,或明确「想买但买不到」。
统计结果(样本 33 条,已剔除噪音):
| 指标 | 数量 | 占比 |
|---|---|---|
| 有明确付费信号 | 2 条 | 6.1% |
| 点名现有方案 | 7 条 | 21.2% |
| 只有一句「有没有」 | 24 条 | 72.7% |
剔掉 8 条噪音后,剩 33 条真实需求。也就是说,如果只看「有多少人在喊」,你会得到 33 个机会;如果只看「谁已经准备好掏钱」,只剩 2 个。
也就是说,如果只看「有多少人在喊」,你会得到 33 个机会;如果只看「谁已经准备好掏钱」,只剩 2 个。
二、三条样本,三种命运
光看数字没有体感,看原话。
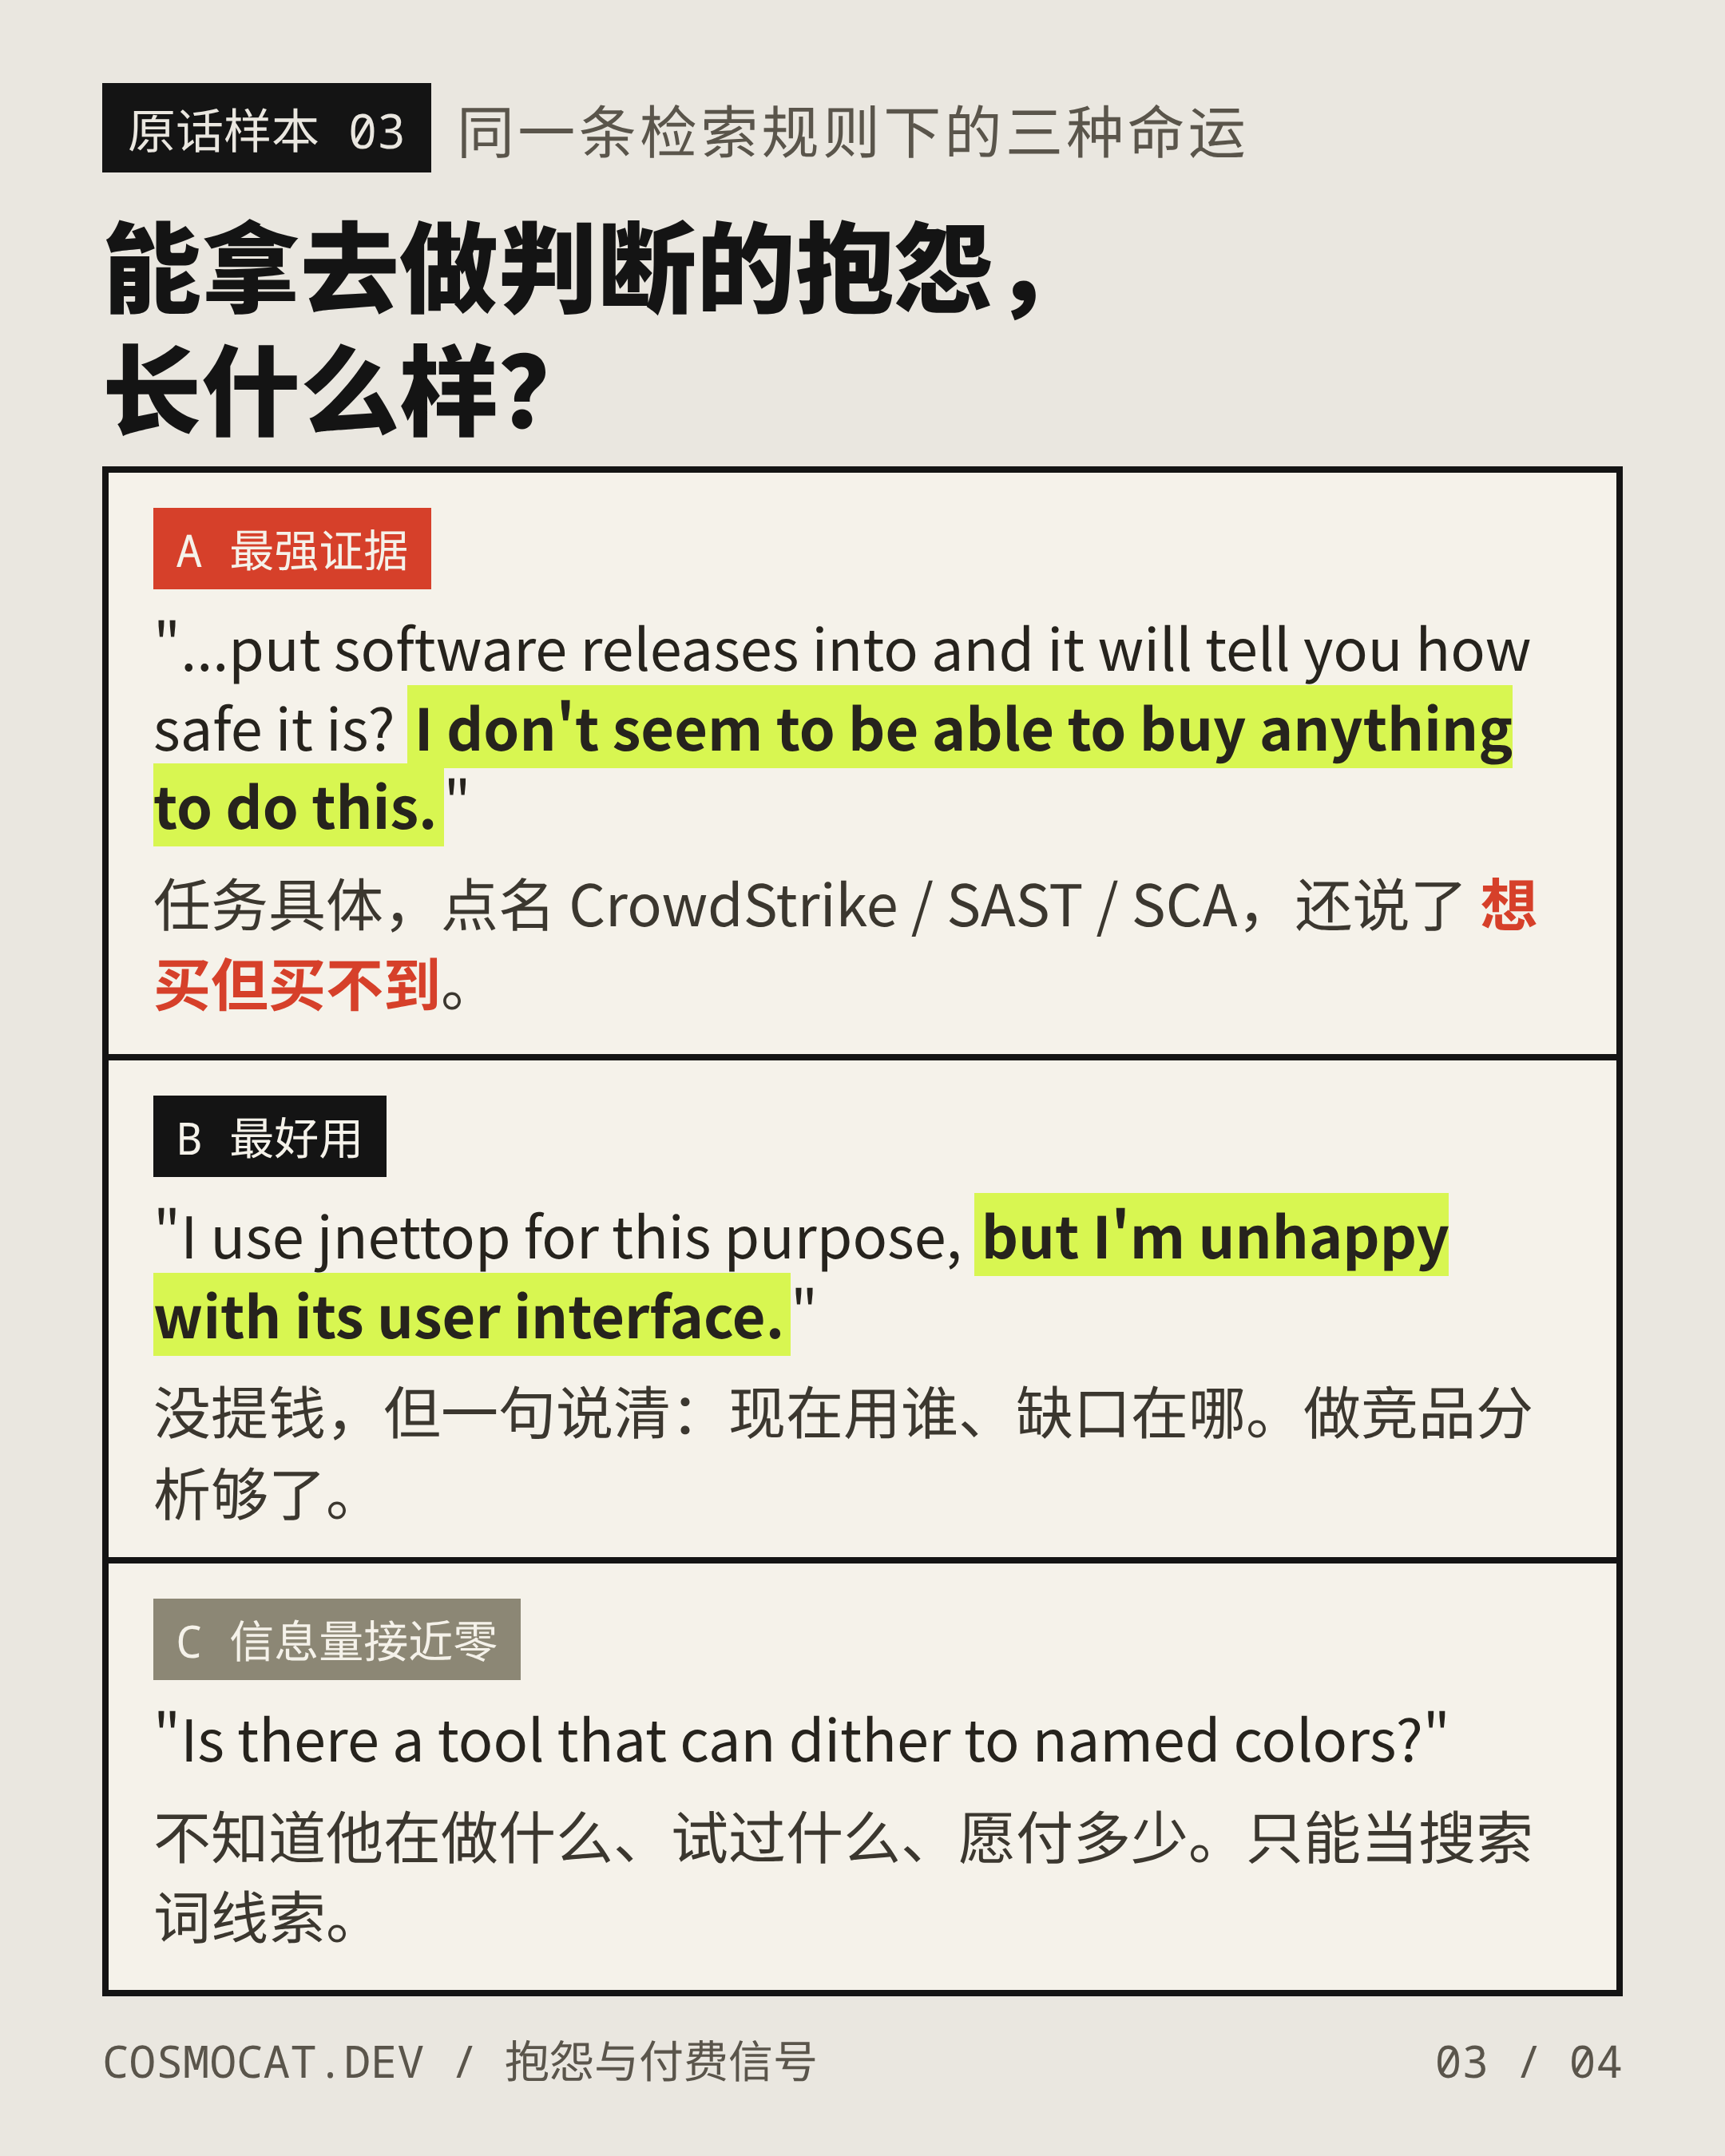
最强的一条:他说了「想买但买不到」
一位开发者在讨论某个硬件监控软件被植入恶意代码时写道:
"Is there a tool out there that you can put software releases into and it will tell you how safe it is? I don't seem to be able to buy anything to do this. Crowdstrike and other modern antivirus may react to it once it's on a device, SAST / SCA tooling will help with CVEs, but there's nothing I can give my users where they can put in some piece of random software and get a reputation metric out the other side, is there?"
这段话同时给了三样东西:
- 具体任务:把一批软件发布物丢进去,得到一个「安全分」;
- 现有方案:CrowdStrike、杀毒软件、SAST/SCA——他都试过,覆盖的是别的环节;
- 付费信号:「想买但买不到」。
这三样凑齐,才叫一条能拿去做产品判断的抱怨。缺任何一样,都只是情绪。
第二条:付费意愿直接写在句子里
另一条在讨论音频编辑器的帖子下面:
"I need an Audio tool to remaster old songs. Basically to bring old songs to modern crystal clear quality. I would be happy pay subscription fees. Is there a tool for that?"
「愿意付订阅费」这句话,比一百条「这个想法不错」都有用。注意它的场景也很具体:老歌修复,不是「音频处理」这种大词。
最好用的一条:点名了现在的工具,也说不满意在哪
"I wish there was a tool that also displayed current and accumulated transfer rate per socket/process. I use jnettop for this purpose, but I'm unhappy with its user interface."
这条没有提钱,但它是最适合做竞品分析的样本:现有方案是谁、缺口在哪,一句话说完了。 你甚至不需要访谈,就知道自己要做的是「同样的数据 + 一个能看的界面」。
对比一下那 24 条只有「有没有」的:
"Is there a tool that can dither to named colors?"
——信息量约等于零。你不知道他在做什么项目、试过什么、愿意付出多少。它唯一的价值是提醒你:这个词可能有人在搜。
还有 8 条根本不是需求。比如一条被关键词命中的玩笑:「我希望有个工具,能把我所有的文档直接分享给世界各大情报机构。」关键词能帮你把范围缩小,但关键词是筛子,不是判断。
三、为什么 73% 的抱怨停在「有没有」
这不是 Hacker News 独有的现象,背后有三个很朴素的原因。
第一,提问的人不是使用的人。 很多人问「有没有工具」,是因为刷到了一个话题、突然好奇,并不代表他明天要交一份工作。真正的使用者,往往已经在用某个难用的办法硬扛——所以他才会说出「我用 jnettop,但不满意」。能说出绕路动作的人,才是真的在路上的人。
第二,用的人不一定会买。 Hacker News 的人群有个特点:遇到问题先想自己写个脚本。对他们来说,「有没有工具」的下一句经常是「没有那我周末自己写一个」。这不是需求弱,是这个人群的付费阈值高。
第三,需求真实,但太小。 给 git add -p 传行号、把 RGB 抖动到命名色、给 Windows 进程拍一份上下文快照——这些都是真问题,但可能一年只有几百个人遇到,且每个人只愿意花 5 美元。它养不活一个产品。
所以「抱怨密度」到底说明什么?它说明注意力,不说明钱包。 一个话题下抱怨越多,越可能是一个内容选题、一个搜索词、一个社区运营的抓手;但要判断能不能收钱,得看另外三列。
四、把抱怨变成判断:五列就够了
我参考了那套付费需求库的做法,把它简化成一张可以直接填的表。核心只有五列:
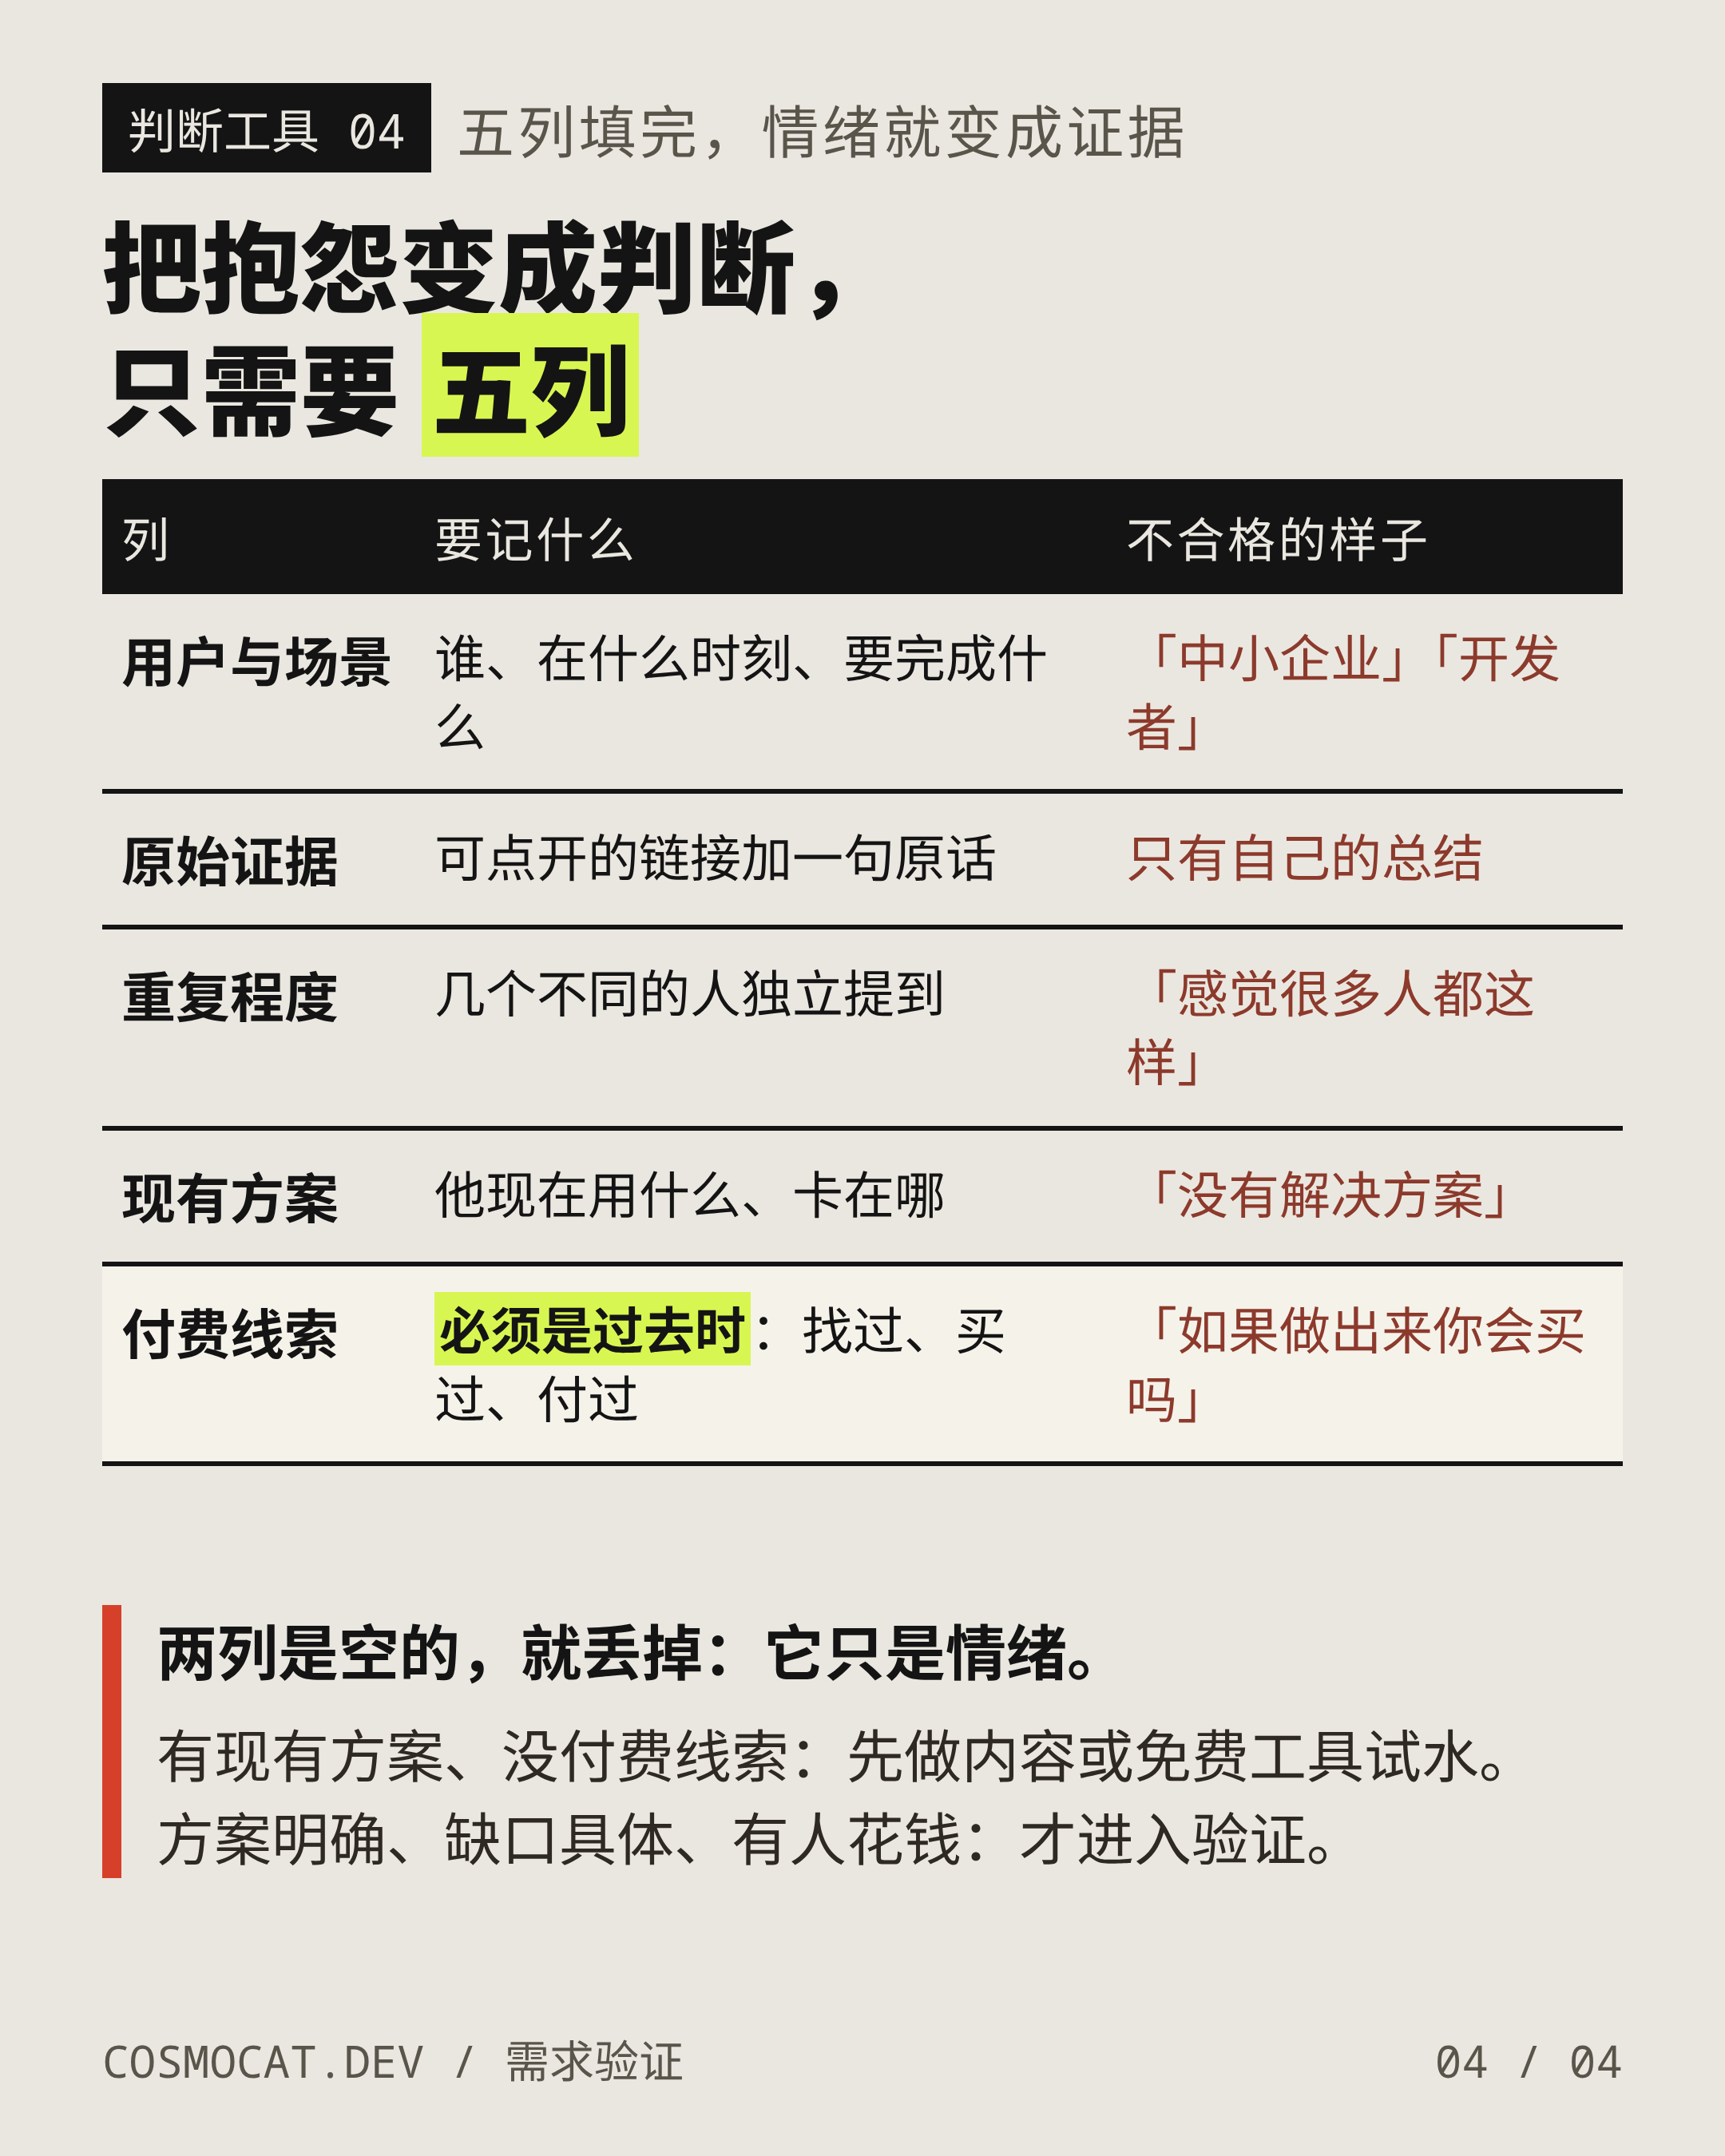
| 列 | 要记什么 | 不合格的样子 |
|---|---|---|
| 用户与场景 | 谁、在什么时刻、要完成什么 | 「中小企业」「开发者」 |
| 原始证据 | 可点开的链接 + 一句原话 | 只有自己的总结 |
| 重复程度 | 有几个不同的人独立提到 | 「感觉很多人都有」 |
| 现有方案 | 他现在用什么、卡在哪 | 「没有解决方案」 |
| 付费线索 | 有没有人找过、买过、付过 | 「如果做出来你会买吗」 |
最后一行是最容易被做假的。付费线索必须是过去时。 有人说「我愿意付」算弱信号,有人已经为某个半成品付过钱、或者明确说「想买但市面上买不到」,才算强信号。至于「如果做出来你会不会买」——那是礼貌,不是数据。
填完这五列,判据就很简单:
- 五列里有两列是空的 → 丢掉,它只是情绪;
- 有现有方案、但没有付费线索 → 可以先做内容或免费工具试水,别急着写代码;
- 现有方案明确、缺口具体、并且有人已经在花钱 → 这才值得进入验证。
五、两小时,先跑一遍最小验证
不用先做产品,也不用先写爬虫。给自己两个小时:
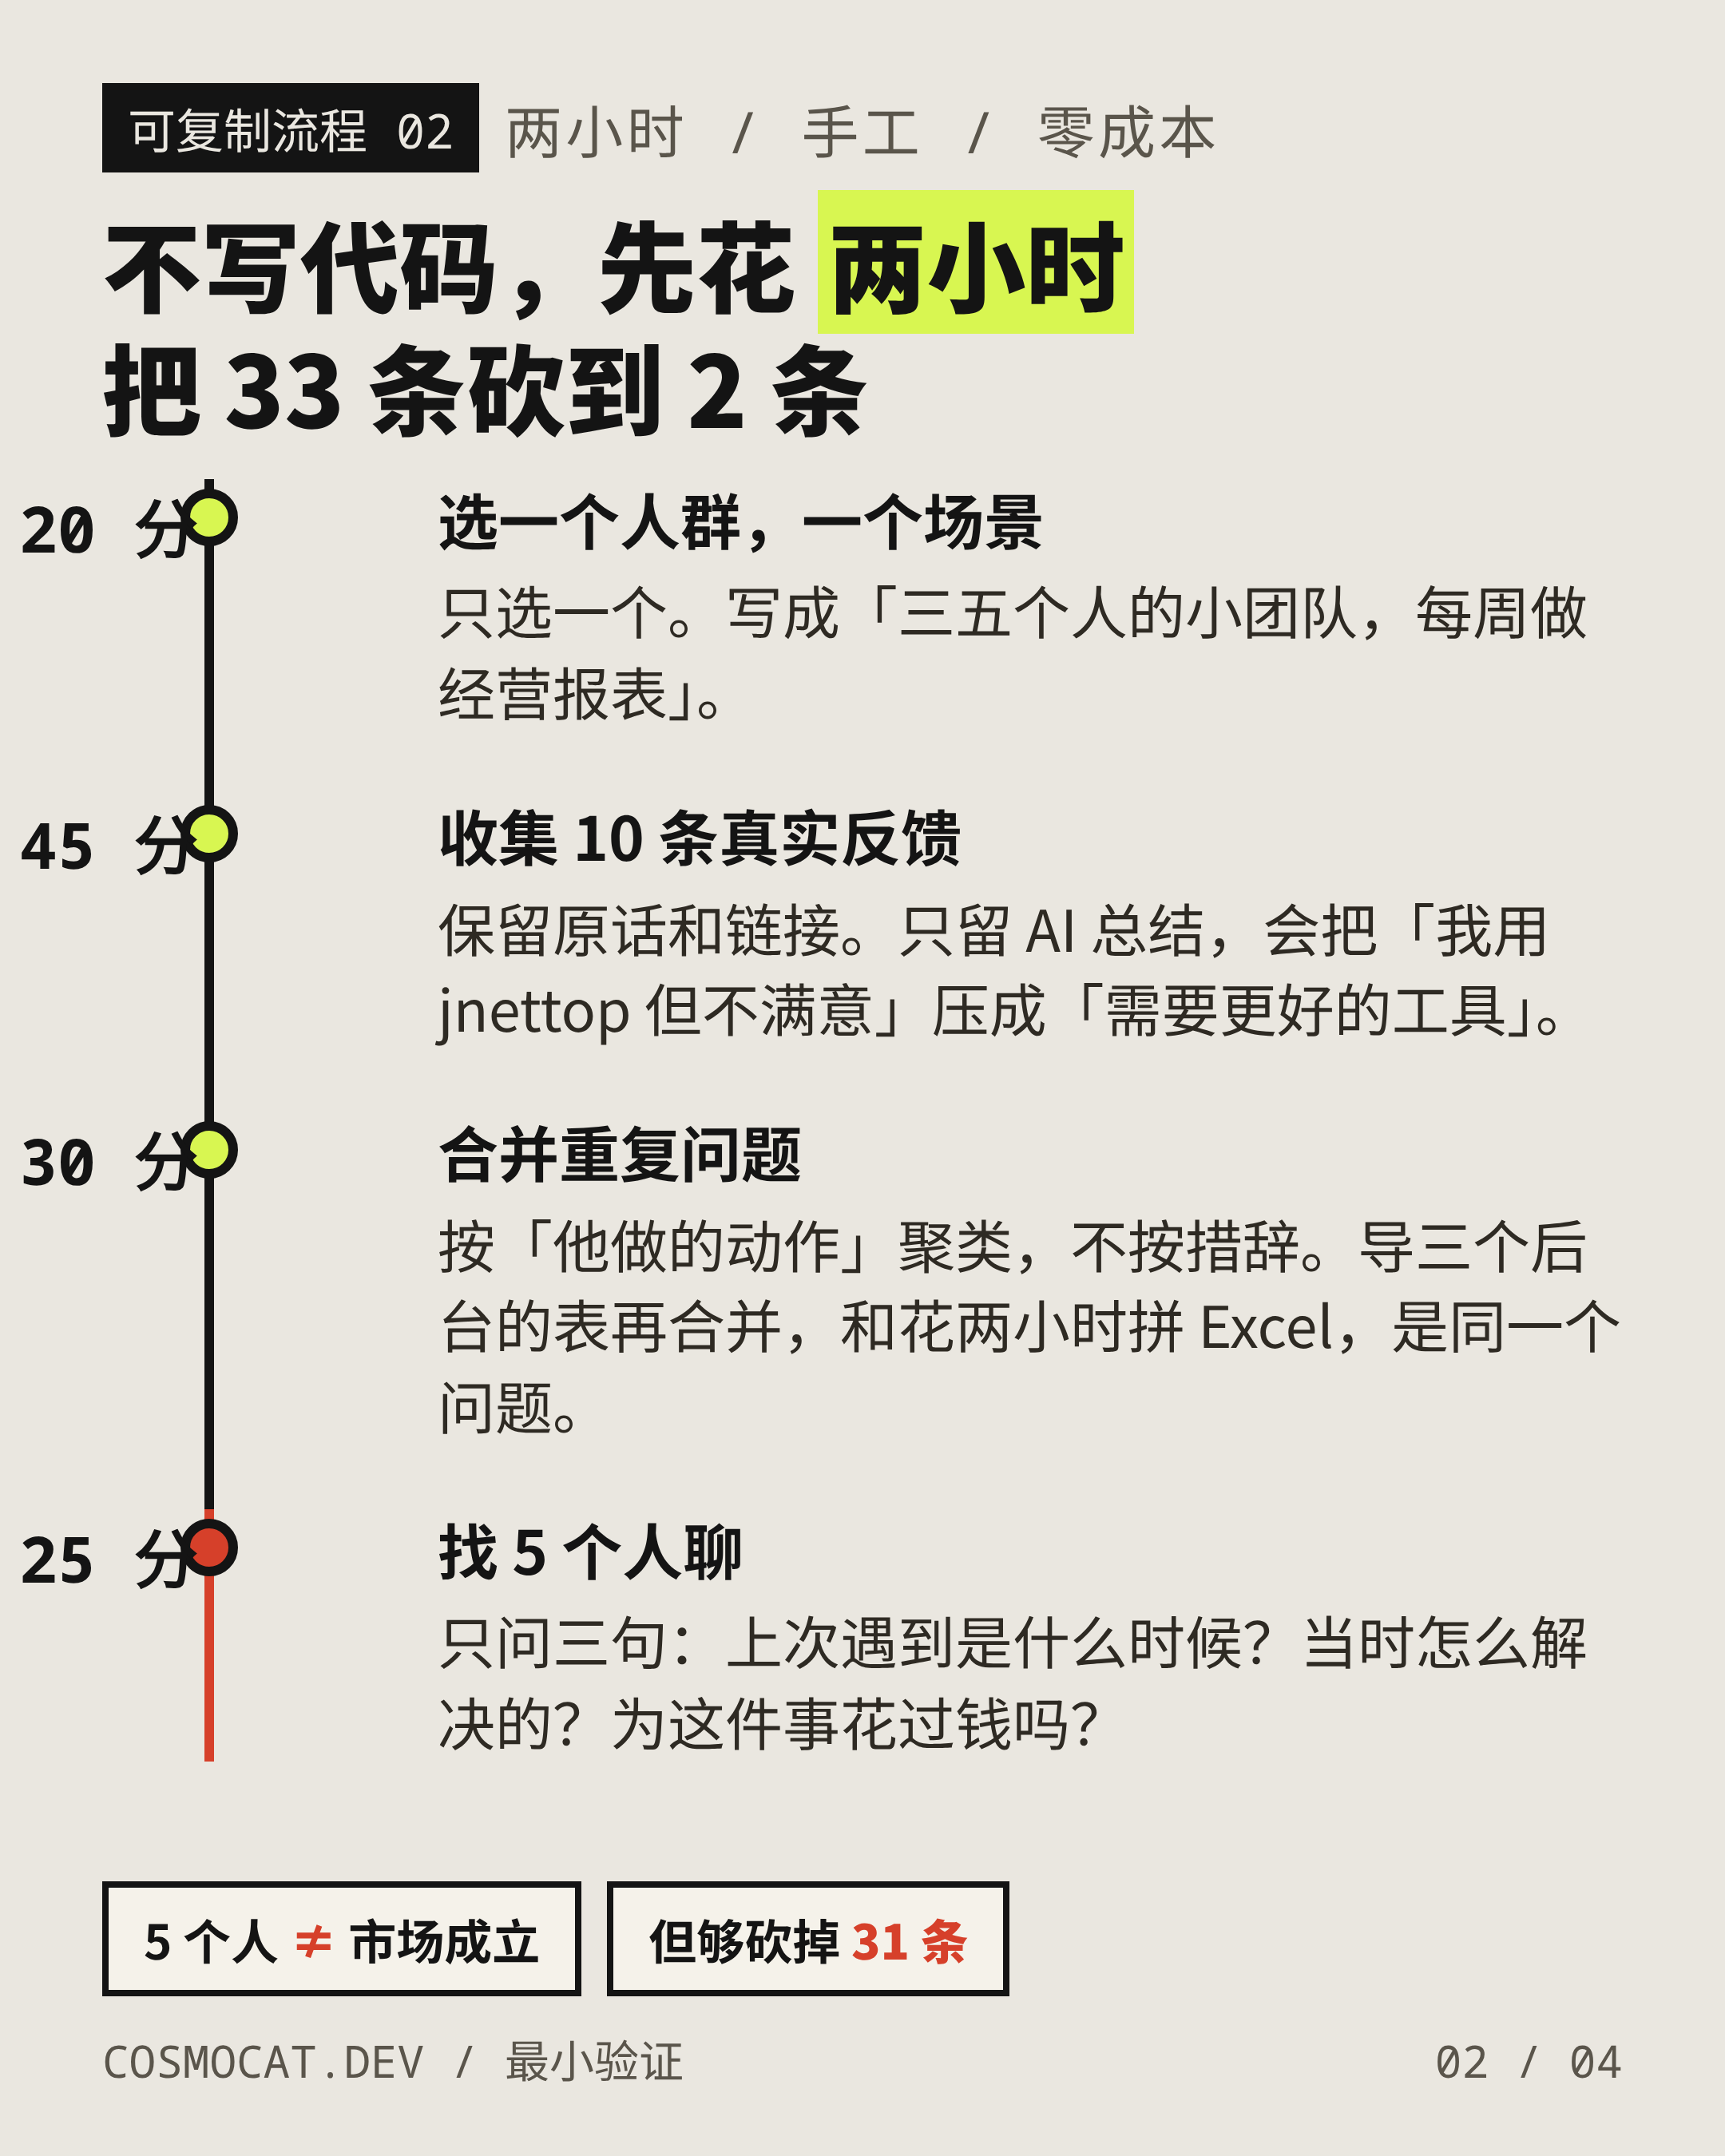
- 20 分钟:选一个人群和一个场景。 只选一个。比如「三五个人的小团队,每周做经营报表」。
- 45 分钟:收集 10 条真实反馈。 保留原话和链接,不要只留 AI 总结——总结会把「我用 jnettop 但不满意」压成「需要更好的工具」,最重要的信息正好被压没了。
- 30 分钟:合并重复问题。 按「他做的动作」聚类,不要按措辞聚类。「导三个后台的表再手工合并」和「每周花两小时拼 Excel」是同一个问题。
- 25 分钟:找 5 个人聊。 只问三个问题:上次遇到是什么时候?当时怎么解决的?为这件事花过钱吗?
5 个人的回答不能证明市场成立,但足以让你把 33 条候选砍到 2 条。这就是这张表全部的价值。
六、那门「卖抱怨」的生意,卖的到底是什么
回到开头那个项目。它监测约 170 个 Reddit 社区(这是产品方的说法,我没有独立核实),把讨论整理成可检索的库,按月收费 39 美元,或者 129 美元买断。
如果按我这 33 条样本的比例推,它的真实工作量不是「收集抱怨」,而是把大量抱怨筛成少数几条有付费线索的。用户花 39 美元买的也不是数据——原始讨论本来就是公开的、免费的——他买的是别人替他做完的筛选和去重。
这解释了两件事:
第一,为什么「我也做个爬虫」通常不成立。 爬虫解决的是收集,收集不是瓶颈。瓶颈是判断哪条值得看,而这个判断需要人(或者一个被反复校准过的模型)来承担。工具越便宜,判断越贵。
第二,为什么它的收入数字不能直接当模板。 一周更新一次、170 个社区、AI 分类评分,这些是运营成本;而它的增长可能来自某一次爆帖带来的流量,而不是稳定的搜索需求。没有获客成本和续费数据,2 万美元只能说明「有人做到过」,不能说明「你可以复制」。
七、这个实验的边界
必须说清楚,否则上面的数字会被误用:
- 样本只有 33 条,且来自单一社区。 它是一组工程人群的英文抱怨,不能外推到中文市场、消费产品或企业采购。
- 分类是我人工判读的。 换一个人来分,可能有 1 到 2 条会落到不同档位。样本表和每条的判读理由我都留了,可以复核。
- 「提到钱」不等于「真的付钱」。 它只是把候选范围缩小,真正的验证仍然要有人掏钱。
- 时间窗只有一年。 有些抱怨在一年前可能是真需求,现在已经被解决了。
- 我没有购买、也没有实测那个付费需求库。 文中关于它的定价和覆盖范围,都来自公开页面与创始人自述。
结语
如果只能记住一句话:
抱怨告诉你哪里有摩擦,付钱记录告诉你摩擦有多贵。
前者可以免费获得,所以它不值钱;后者需要你去翻别人的账单、访谈、试用记录,所以它值钱。AI 让「收集抱怨」的成本降到了接近零,也就顺便让「筛选」变成了整条链上最贵的一环。
下次看到一条「有没有这种工具」,先别急着打开编辑器。先问一句:他上次遇到这个问题,是怎么解决的?
来源与说明
- 样本数据:Hacker News 公开评论,经 Algolia 搜索接口按四组句式检索,时间窗 2025-11-01 至 2026-11-11,去重后 41 条;逐条链接与人工判读理由见本文附带的样本表(
hn_complaints_sample.csv)。 - 引用原话均可通过对应条目链接回溯,例如:
https://news.ycombinator.com/item?id=47720321、47714893、48267796、46366838。 - 付费需求库的定价与覆盖范围来自其官网公开页面与创始人自述,截至 2026-10-29;收入数字未经独立审计,本文不作为论据使用。
- 本文为方法演示,不构成对任何产品的推荐或否定。