两个「3.5 Transcribe」:Google 放在云上,NVIDIA 直接开源了
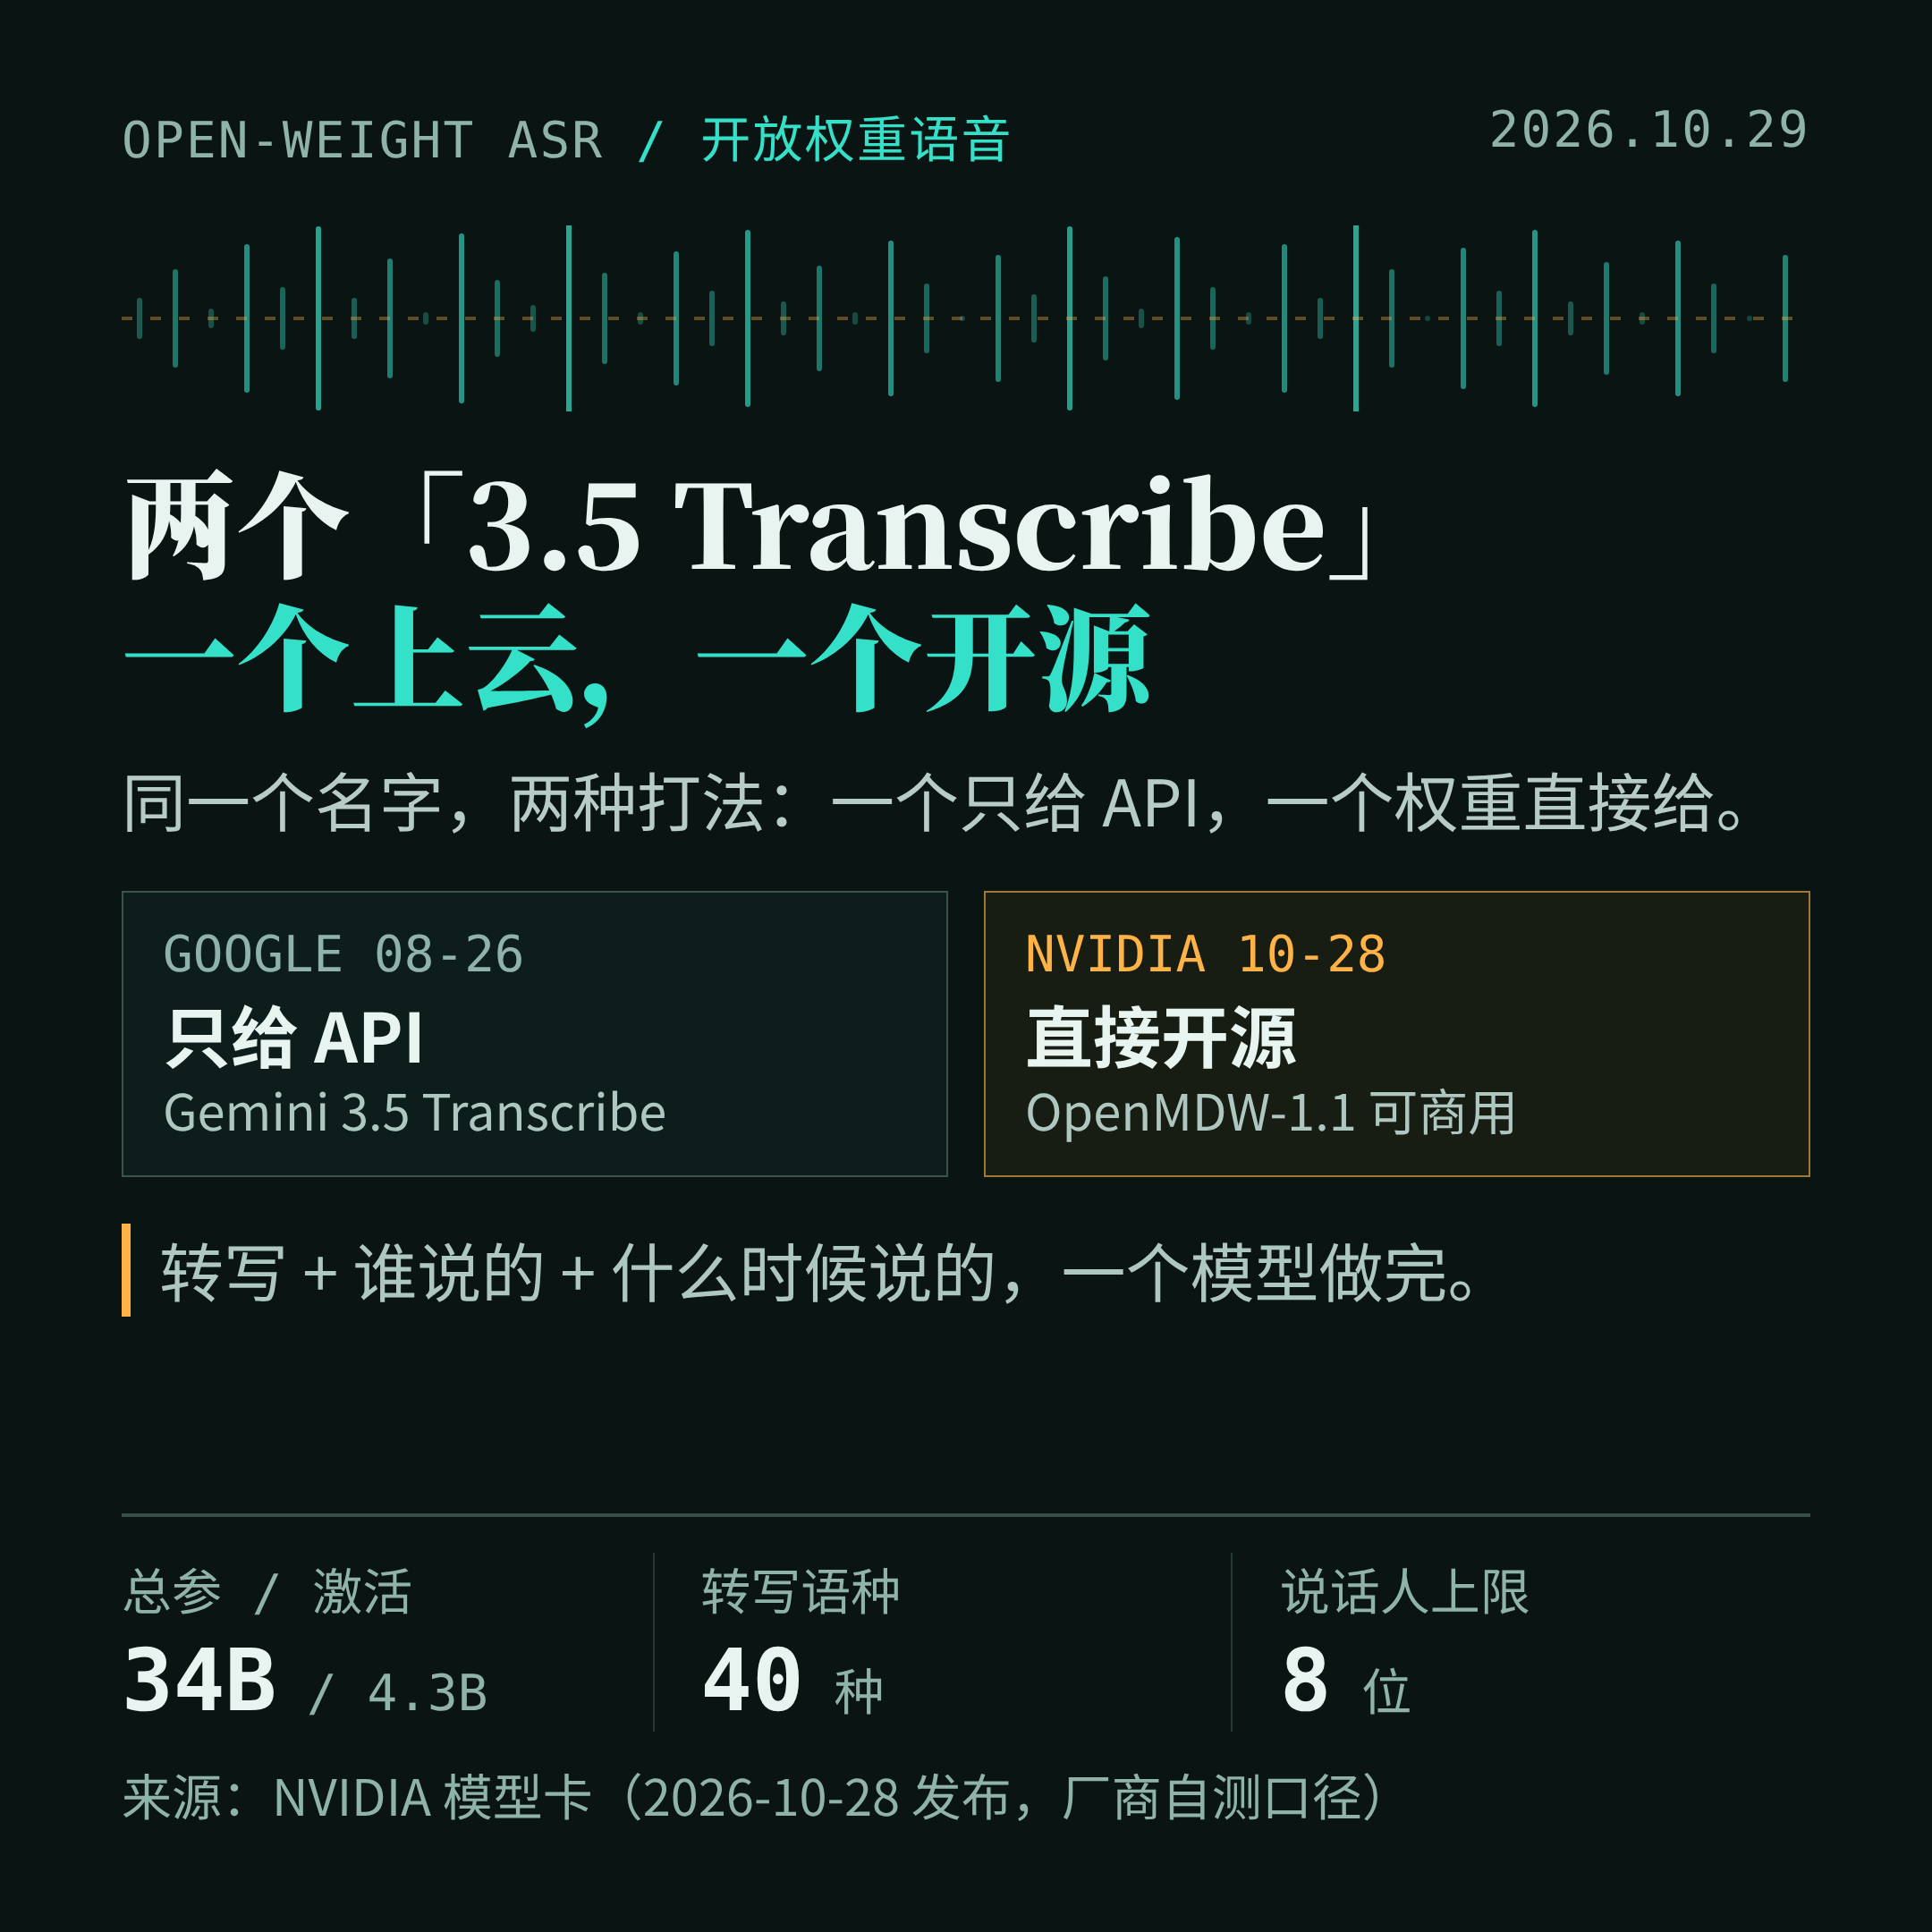
八月底,Google 发布了 Gemini 3.5 Transcribe——不给你权重,只给你 API。
十月底,NVIDIA 发布了 Nemotron 3.5 Transcribe——权重直接放出来,OpenMDW-1.1 许可,可商用。
同一个名字,两种打法。这不是巧合:语音转写正在从「一个功能」变成「一条产品线」,而两家公司对「这条线该归谁」给出了完全相反的答案。这篇文章把 NVIDIA 这个新模型讲清楚:它做到了什么、数据该怎么读、以及它离「你能用上」还有多远。
一、它是什么:一个 34B 的「语音增强语言模型」
先纠正一个容易误读的细节。标题里说的「30B-A4B」是模型名,模型卡里的准确数字是:总参数 34B,激活 4.3B(含音频编码器)。
更有意思的是它的出身:它不是从零训练的语音模型,而是拿 Nemotron 3.5 Lightning 30B-A3B 这个文本模型做底座,再外挂一套语音感知模块。官方把这条路线叫 SALM(Speech-Augmented Language Model,语音增强语言模型)。
拆开看是这样三块:
- 语音编码器:约 600M 的 Transformer ASR 编码器,负责「说了什么」;
- 说话人编码器:约 99M 的 Sortformer,负责「是谁说的」;
- 语言底座:Nemotron 3.5 Lightning,负责把声音和指令一起读成文字。
两路音频特征并行进入语言模型,生成文本时同步打上说话人标签。再配一个 CTC 时间戳头,词级时间戳和说话人分段就能一起输出。
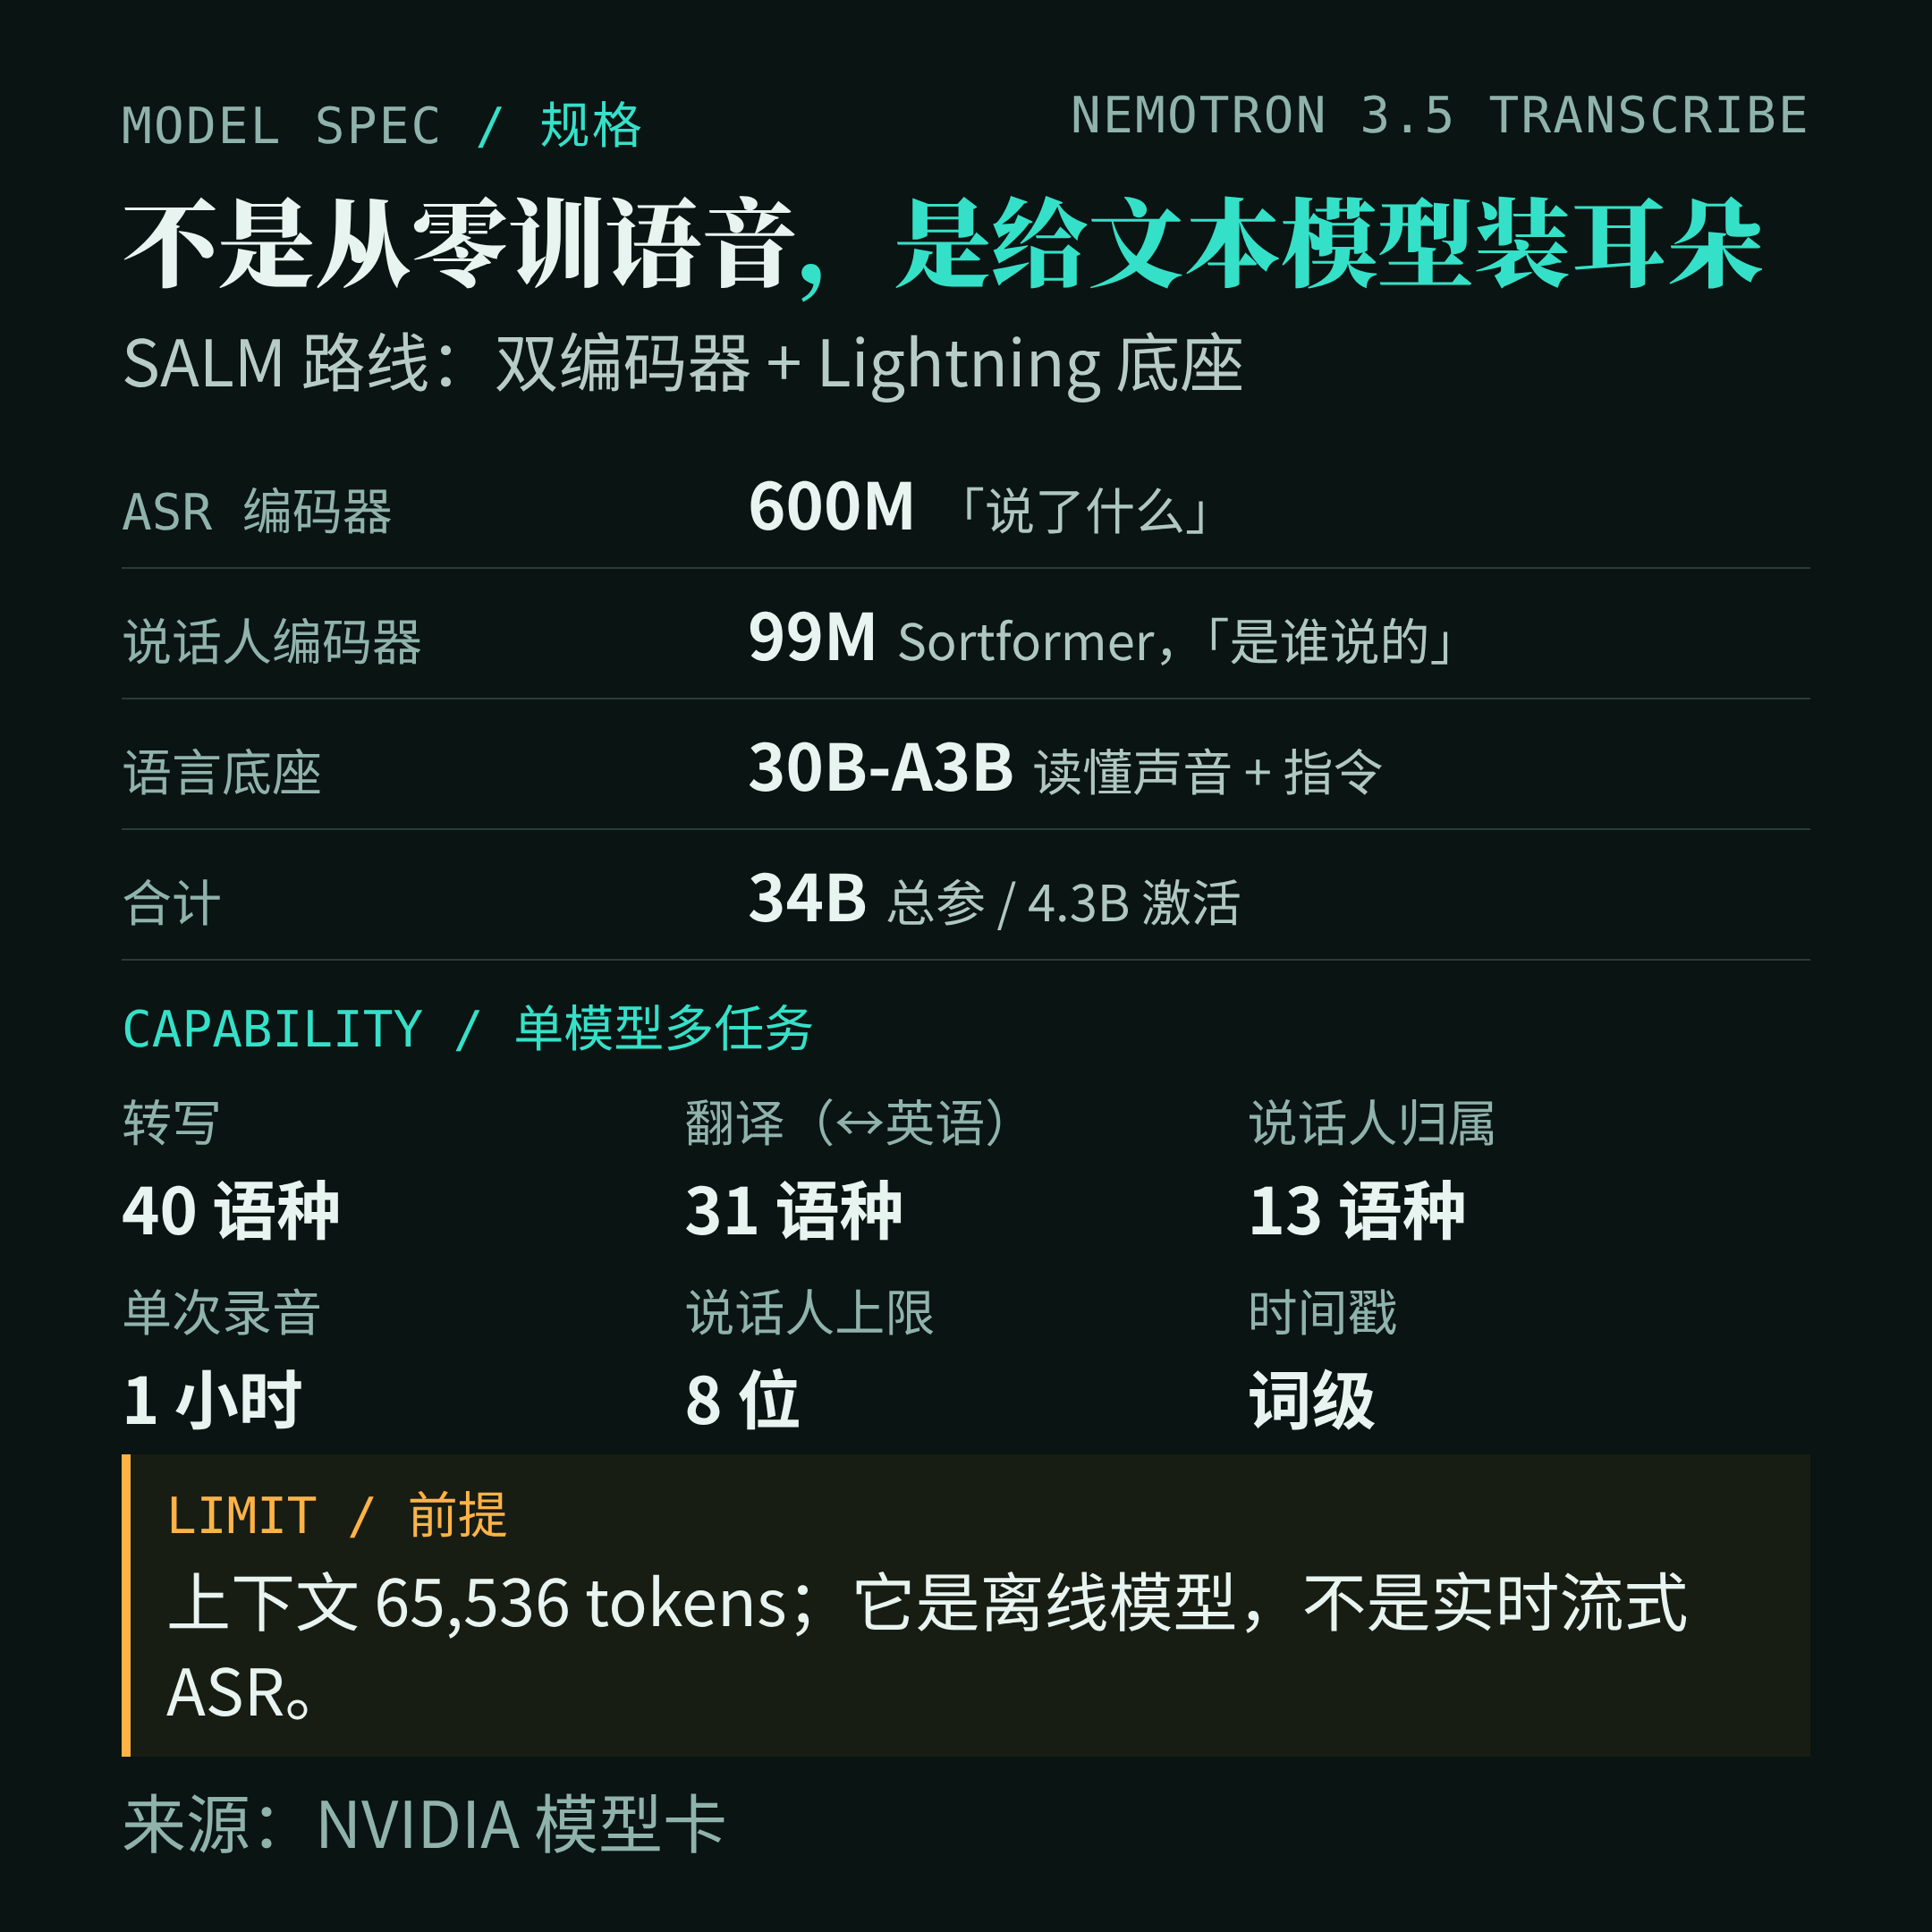
这个结构解释了一件事:为什么它能听懂指令。因为底座本来就是个语言模型,你让它「逐字转写」「写成书面语」「标出每个说话人」「翻译成中文」,它是在理解你的话,而不是在切换四个不同的模型。
能力清单(官方口径):
- 40 种语言转写,31 种语言与英语双向翻译,13 种语言的多说话人转写;
- 单次最长 1 小时录音,最多 8 位说话人,支持词级时间戳;
- 单个模型同时做转写、说话人归属、语言识别、翻译、音频问答。
二、成绩单:多说话人这一项,是真的第一
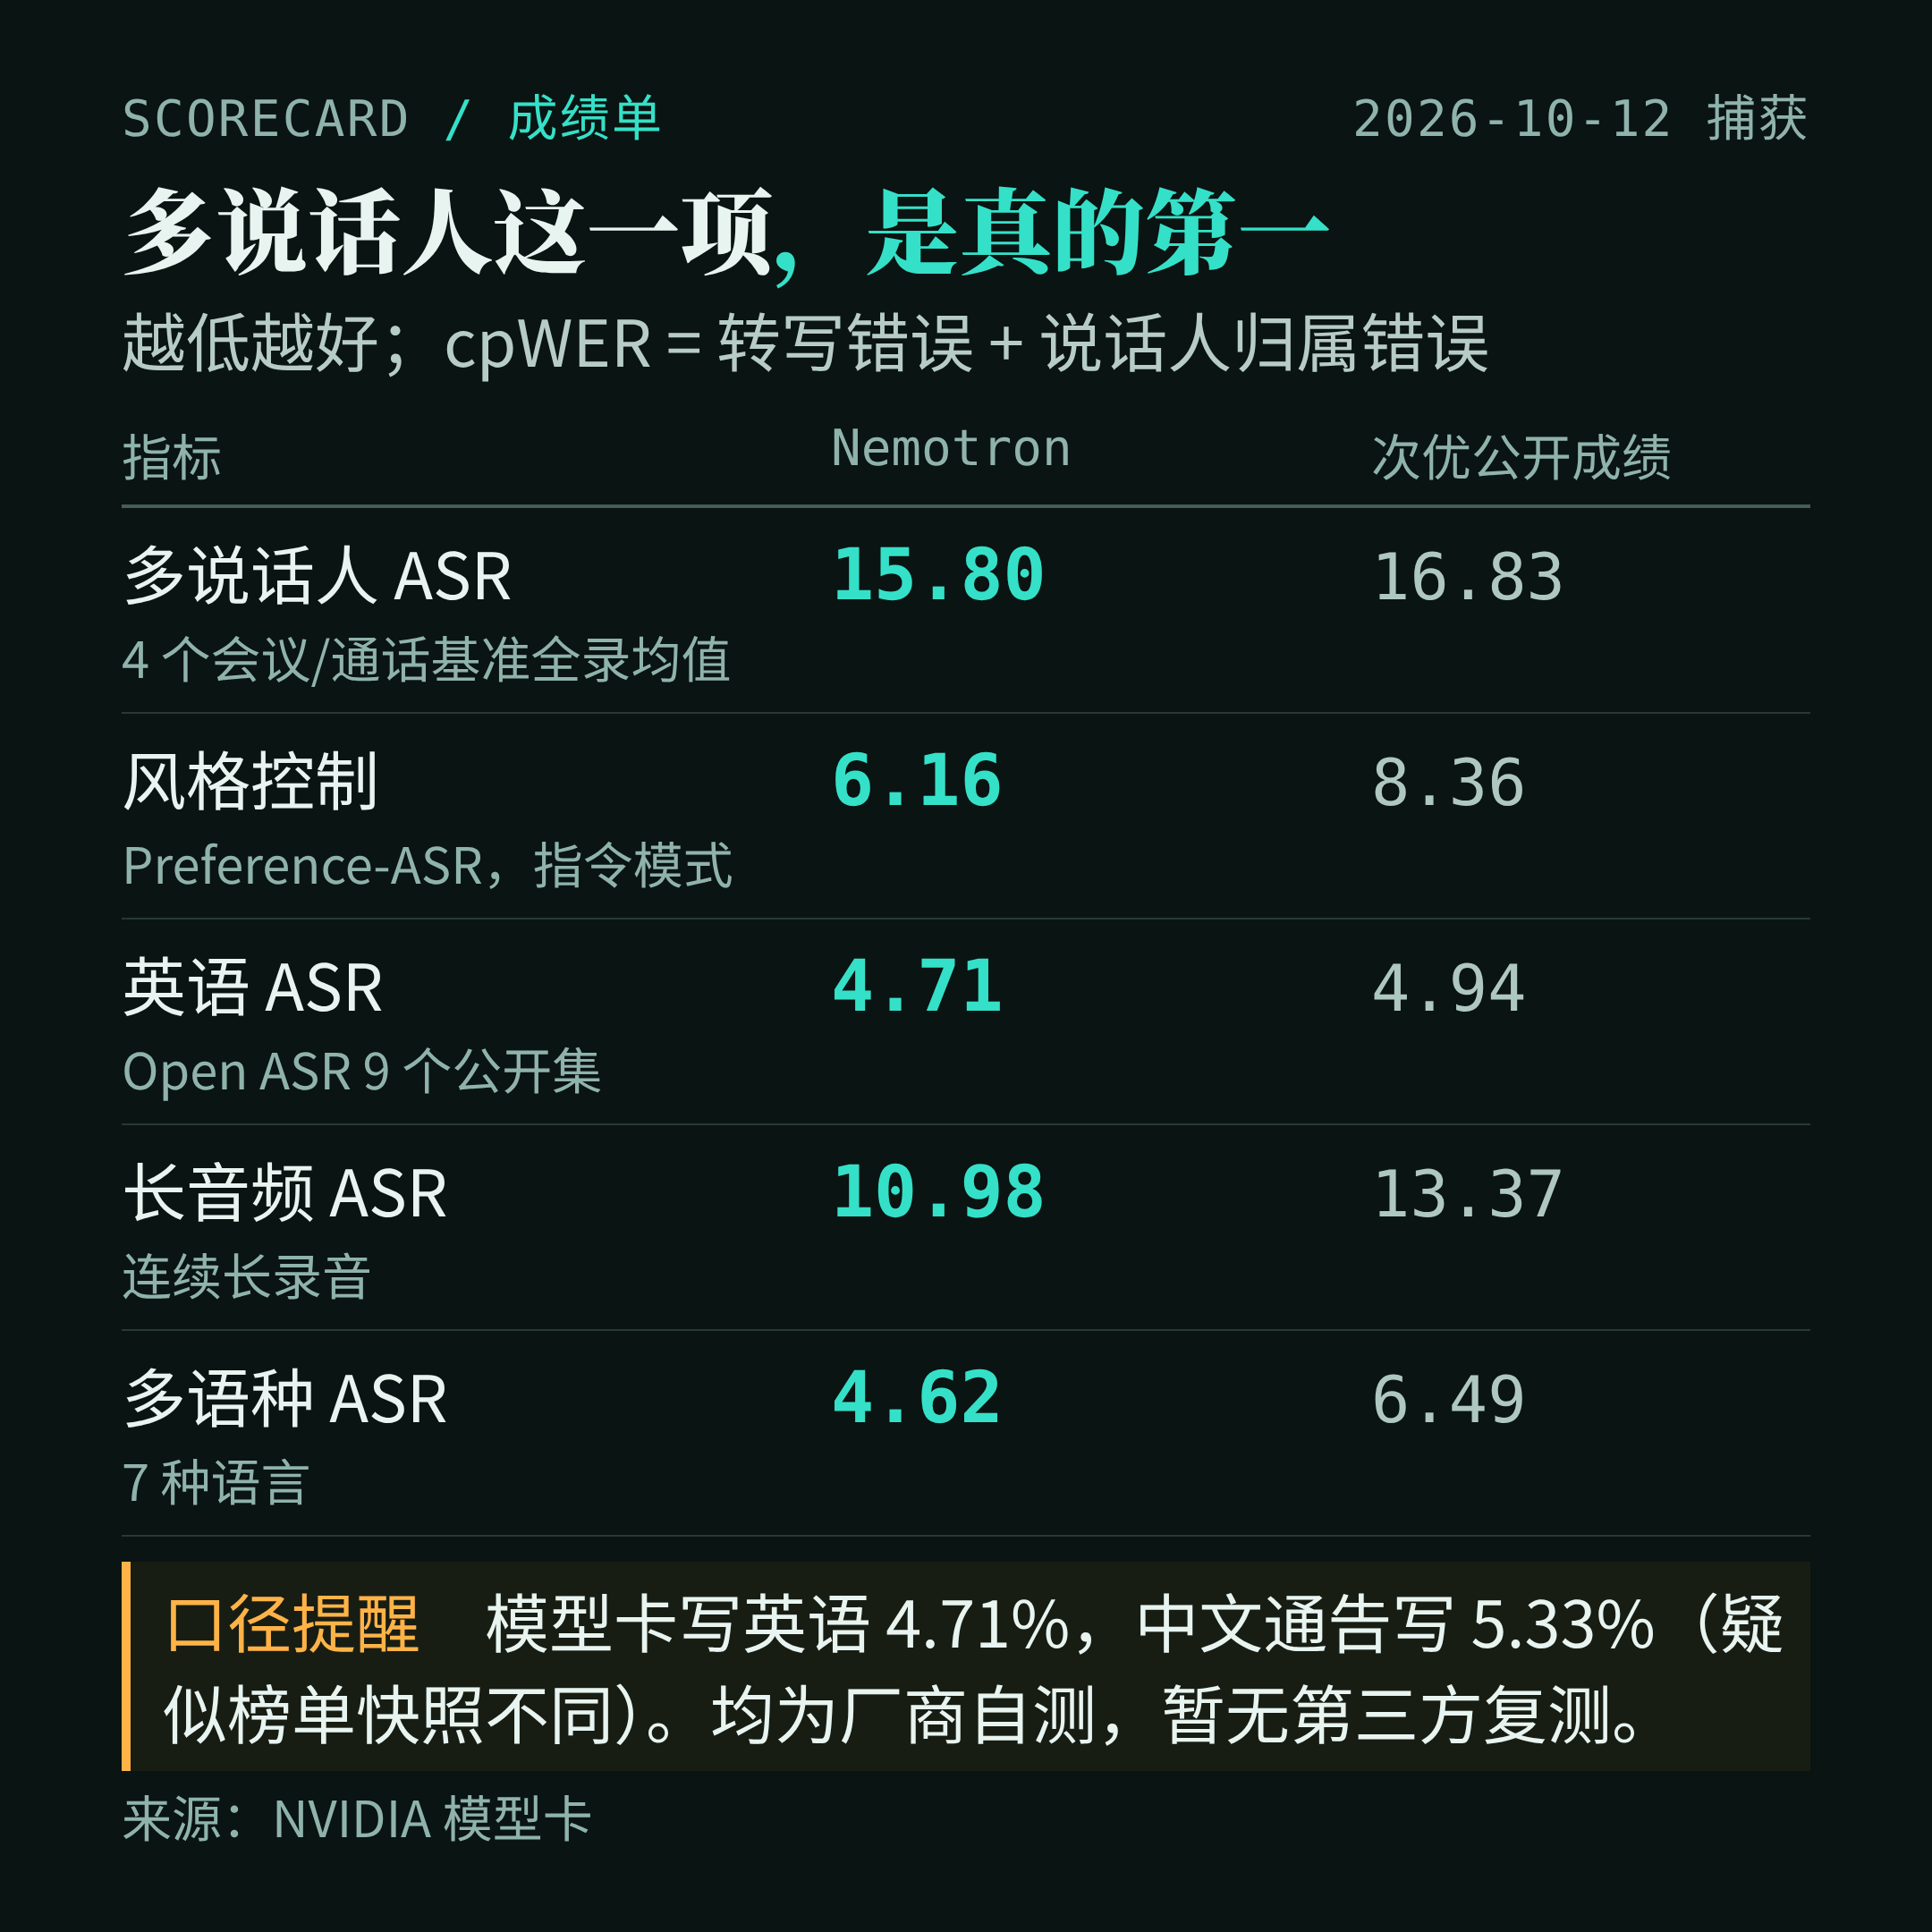
先把最重要的说清楚:在多说话人转写(转写 + 谁说的,联合计算 cpWER)上,它是「已公开最好成绩」。
模型卡给的数据(2026-10-12 捕获):
- 多说话人 ASR:AMI、CALLHOME、Mixer 6、NOTSOFAR-1 全录平均 cpWER 15.80,次优是 DiCoW v3.3 + DiariZen 的 16.83;
- 英语 ASR(Open ASR 榜 9 个公开集)平均 WER 4.71,开放权重里第一,次优是 Qwen3-ASR-1.7B 的 4.94;
- 长音频平均 WER 10.98,次优 Parakeet-TDT-0.6B-v3 是 13.37;
- 多语种(7 语言)平均 WER 4.62,次优 Qwen3-ASR-1.7B 是 6.49。
还有一个值得单说的成绩:在 Artificial Analysis 的 AA-WER 上,它拿到 2.81%,与开放权重最佳成绩只差 0.04 个百分点——而它的激活参数只有对方的约六分之一。翻译成大白话:用 4B 左右的激活算力,跑到了接近旗舰的转写精度。
⚠️ 这里有一处口径差,得说清楚。ModelScope 社区那篇中文通告写的是「英语榜平均 WER 5.33%」,模型卡写的是 4.71%。两个数字都自称「开放权重第一」,差异大概率来自榜单快照和参评集合不同。引用时我建议以模型卡的 4.71% 为准,并注明捕获日期——这是二手转述和一手模型卡之间最常见的那种偏差。
另外提醒一句:cpWER、DER、WER 这三个指标都出现在不同的评测里(David AI、VoiceArena、Cekura),它们说的不是同一件事。DER 量的是「谁在说、什么时候说」,cpWER 是先对齐说话人再算转写错误。「第一」前面没写清楚是哪个榜、哪个指标,基本等于没说。
三、真正值钱的,可能不是模型而是数据流水线
这次发布还有一半内容,很容易被忽略:Granary v2——一套多语言语音数据清单和整理流水线。
它的核心方法很朴素:同一段录音,生成三种互相对齐的转写。
tn_raw:文本规范化的逐字稿;itn_raw:数字转成书面写法,但保留「呃、这个」这类口语不流畅;itn_clean:再去掉不流畅表达。
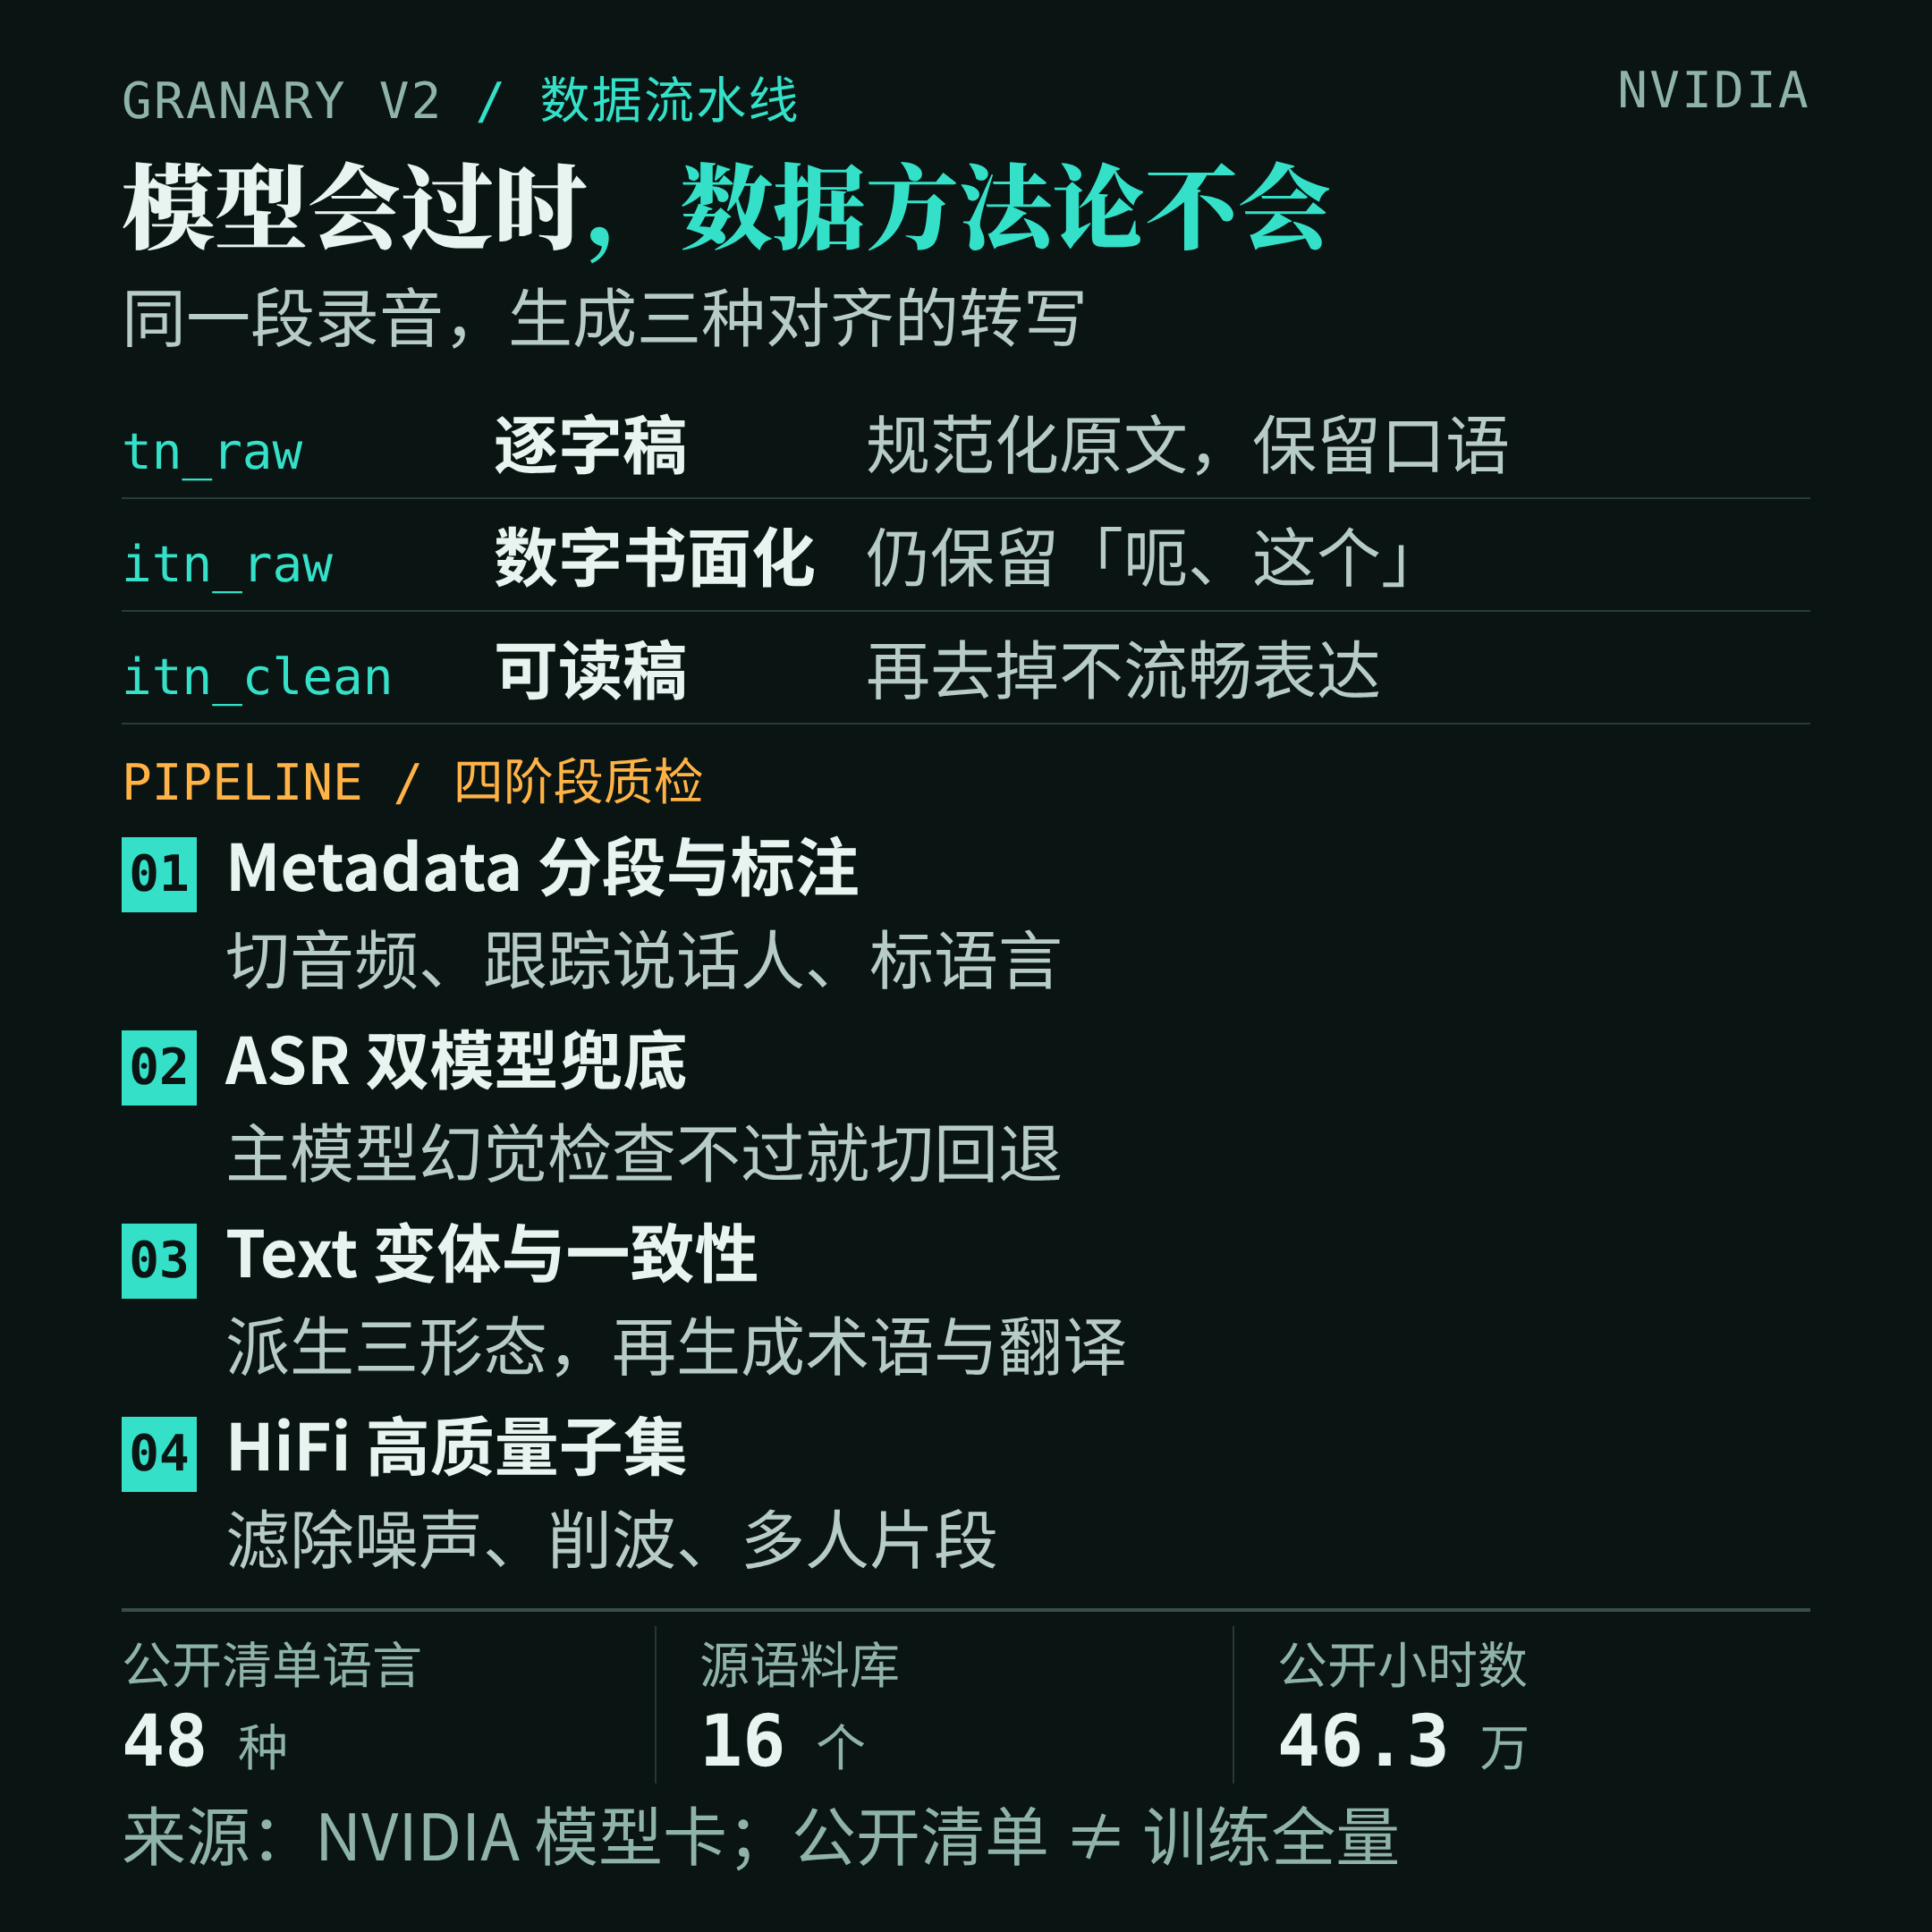
为什么要三种?因为「逐字稿」和「可读稿」本来就是两种需求。传统做法是用后处理规则去清洗,规则一多就脆;Granary 的做法是在训练阶段就把两种输出都教会模型,推理时用一句指令切换。这也是它能做到「同一段录音,要逐字就逐字、要书面就书面」的根本原因。
流水线分四段:Metadata(分段、说话人跟踪、语言标注)→ ASR(每语种主模型 + 回退模型,主模型没过幻觉检查就换回退)→ Text(衍生变体 + 一致性检查 + 术语/翻译)→ HiFi(滤掉噪声、削波、多说话人片段,留高质量子集)。
公开清单覆盖 48 种语言、16 个源语料库、46.3 万小时。模型卡同时说明了训练侧的口径:约 172 万小时唯一音频(含重复曝光是 653 万小时)、3.72 亿条唯一音频样本。
这套东西的价值在于可迁移:它不绑定 NVIDIA 的模型,任何做语音数据的人都可能照着搭。模型会过时,数据方法论不会。
四、它离「你能用上」还有多远
好消息:这次 NVIDIA 给得很实在。
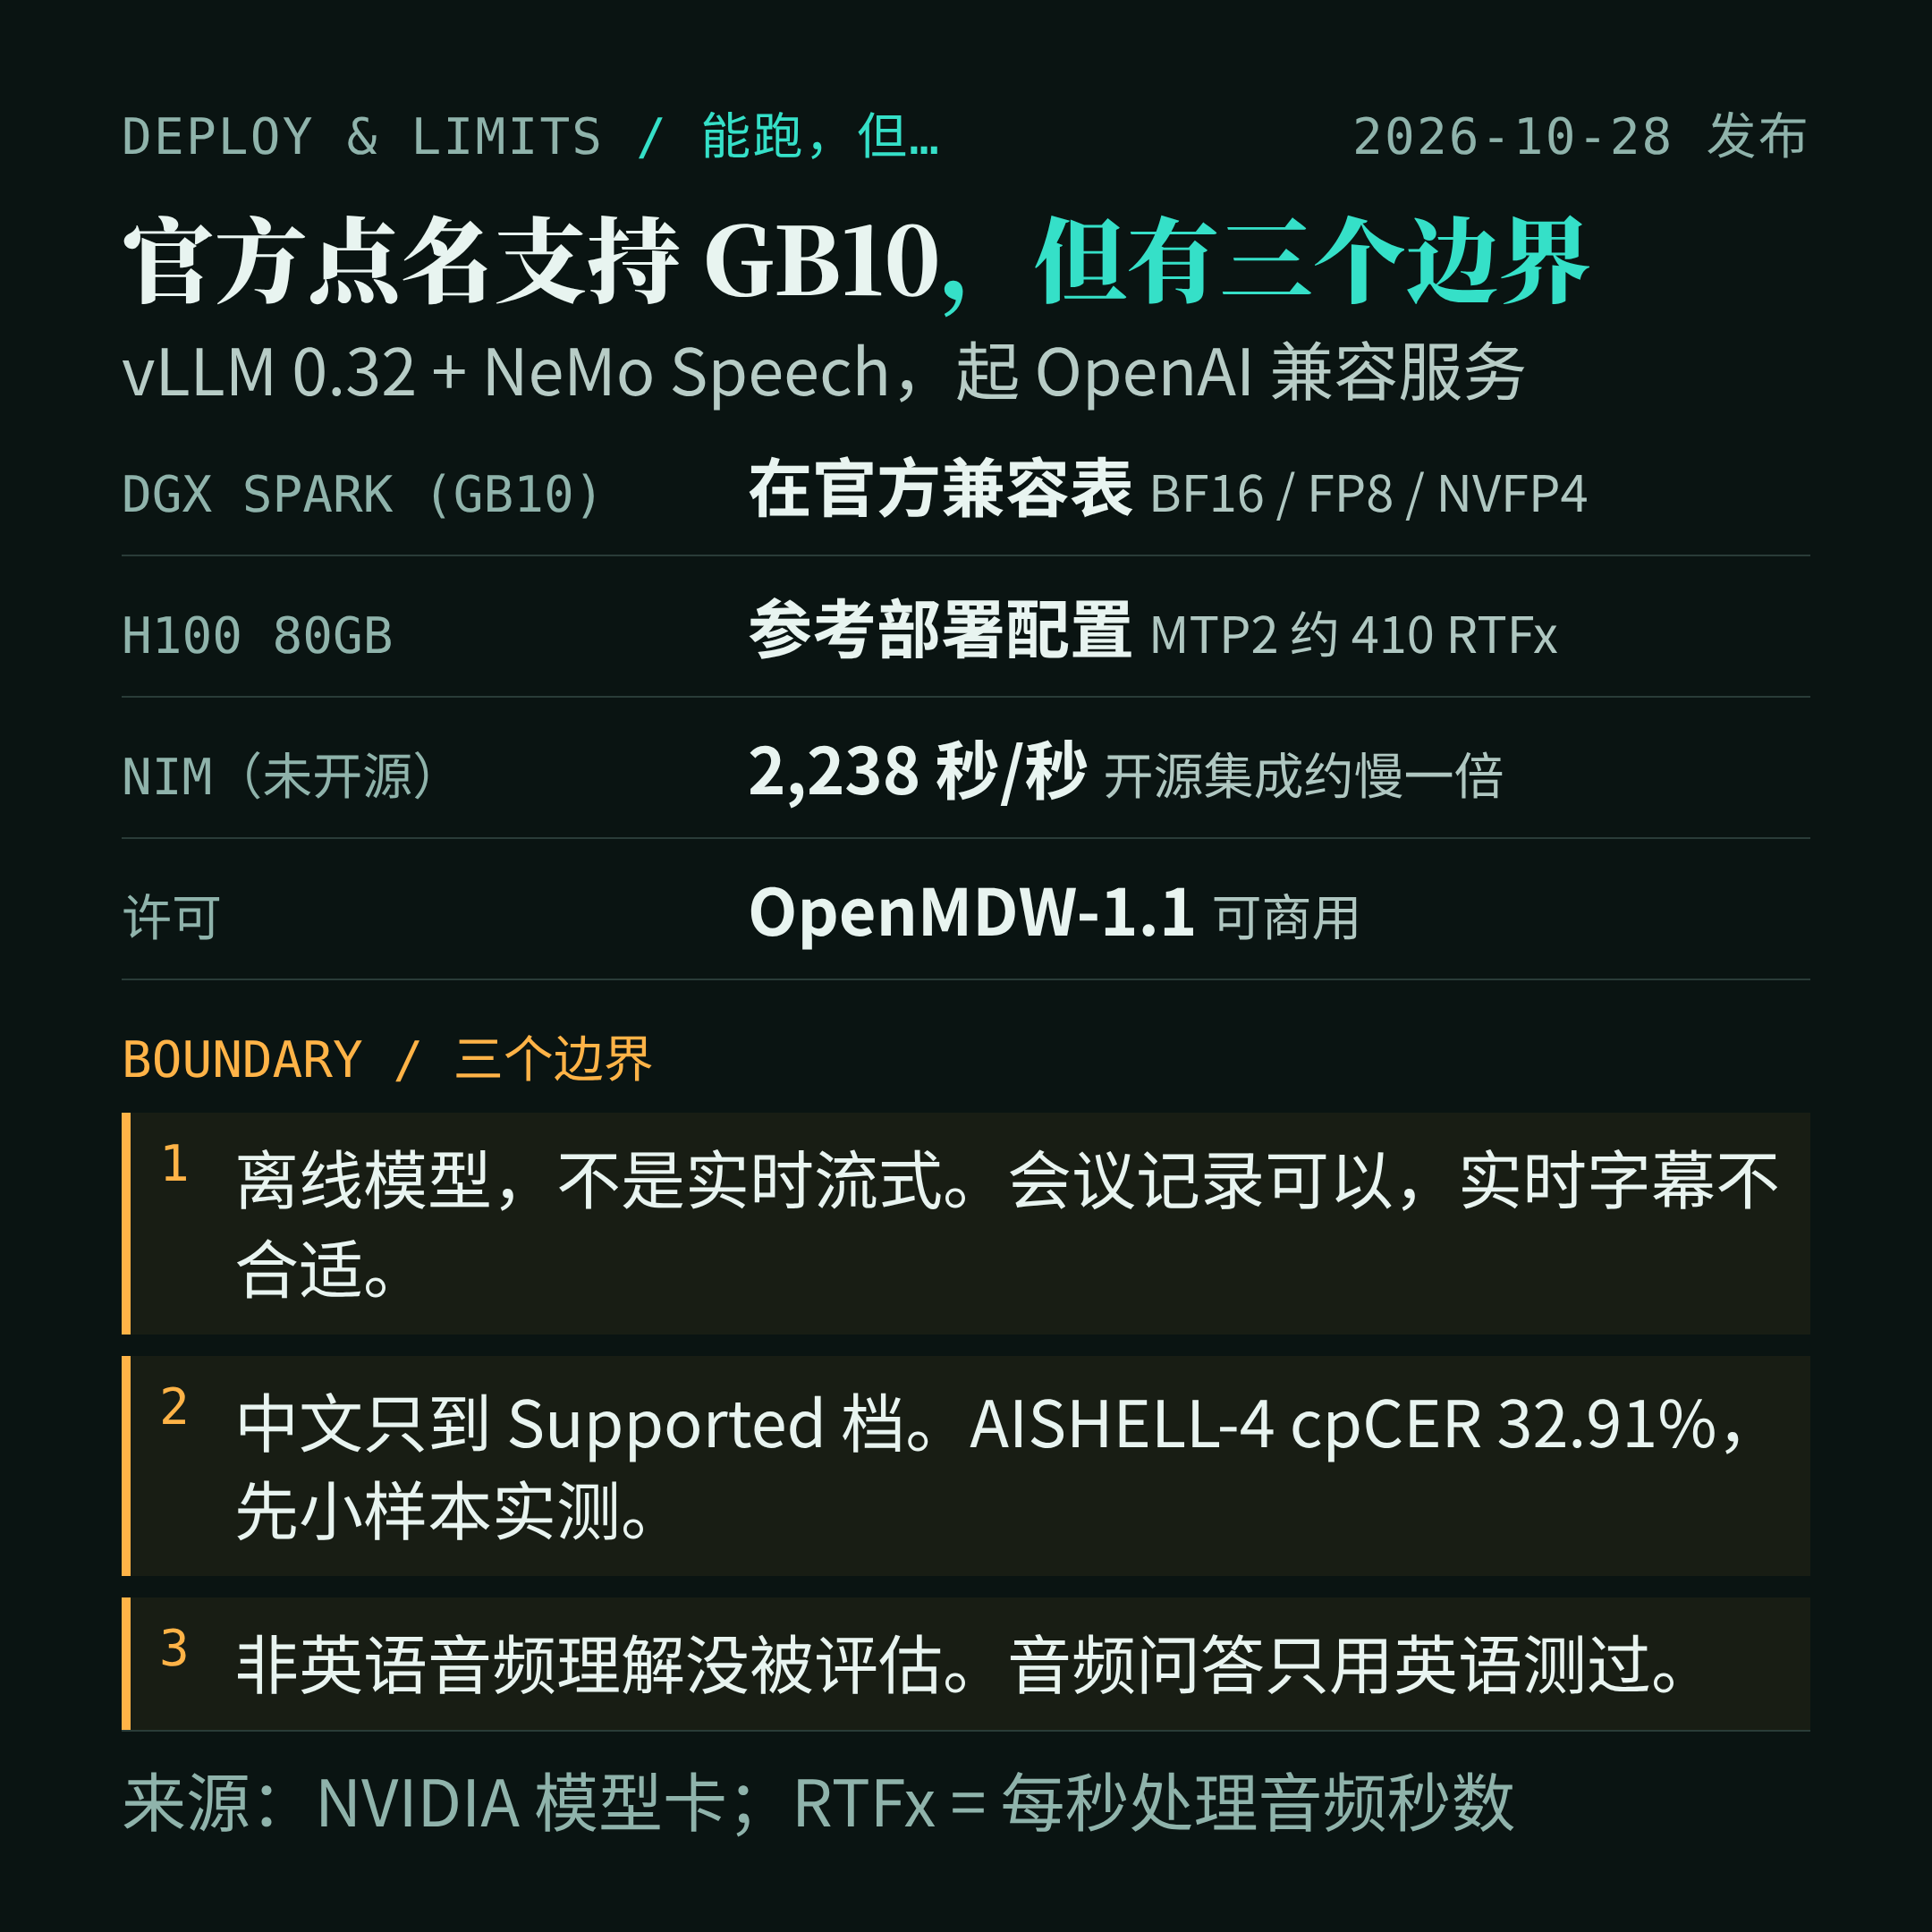
- 官方硬件兼容表里,DGX Spark(GB10)在列,支持 BF16 / FP8 / NVFP4 三档精度,走 vLLM 0.32.0 + Hugging Face Transformers。对一台 128GB 统一内存的本地机器来说,这是少见的「官方点名支持」。
- 部署路线是 vLLM + NeMo Speech 插件,起一个 OpenAI 兼容服务,用标准 SDK 传 WAV 就能调。
- 官方还给了吞吐参考:H100 80GB 上跑批量英语 ASR,MTP2 投机解码约 410 RTFx(每秒处理约 410 秒音频);NIM 优化版在 RTX PRO 6000 Blackwell 上能到 2,238 秒音频/秒、30 秒录音 0.13 秒返回。注意后者是未开源的 NIM 版本,开源集成大约慢一倍。
但要泼三盆冷水:
- 它是离线模型,不是实时流式 ASR。官方原话是「内部切块不代表它是实时服务」。做会议记录、批量转写可以;做实时字幕、语音对话,它不合适。
- 中文只到「Supported」档。模型卡把 40 种语言分成 Leading / Production-ready / Supported 三档,中文在第三档,注释是「支持,可能需要微调」。中文多说话人成绩也不亮眼:AISHELL-4 的 cpCER 是 32.91%,AliMeeting 是 34.95%。中文场景要上,先小样本实测。
- 非英语的音频理解没被评估过。它的音频问答、推理、语音指令跟随都只用英语数据测过,官方明说其他语言「可能不可靠」。
五、三条判断
第一,开放权重 ASR 的竞争轴变了。 过去比的是「字准不准」,现在比的是「结构化」——说话人、时间戳、风格控制、多语种。NVIDIA 这次把「转写 + 谁说的 + 什么时候说的」压进一个模型,等于在拆「ASR + 说话人分离 + 后处理」那条传统流水线。
第二,数据流水线正在变成公开的基础设施。 Granary v2 这种「三形态对齐」的做法,比模型权重更有复用价值。以后评估一个语音模型,除了看榜单,也该看它公开了什么数据方法。
第三,「开源」不等于「白嫖」。 34B 的模型,哪怕有 FP8 / NVFP4,也不是随便一台机器就能跑。GB10 在兼容表里是个好信号,但真正的门槛从「有没有权重」变成了「有没有合适的硬件 + 工程能力」。
回到开头那个对照:Google 把语音转写做成按量计费的云服务,NVIDIA 把它做成可以下载、可以微调、可以塞进自己产品的权重。两条路都会有人走。 对做产品的人来说,问题不是「哪个更强」,而是「我的数据能不能离开我的机器」。
来源与说明
- NVIDIA 模型卡:https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
- 技术报告:https://research.nvidia.com/labs/nemotron/files/NVIDIA-Nemotron-3.5-Transcribe-Technical-Report.pdf
- Granary v2:https://huggingface.co/datasets/nvidia/Granary-v2
- 中文通告(ModelScope 社区,2026-10-29):https://mp.weixin.qq.com/s/dtwg8adAczUugQ-NBSIlBw
- Google Gemini 3.5 Transcribe(2026-08-26):https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-5-transcribe/
口径说明:本文所有评测数字均来自 NVIDIA 官方模型卡(结果捕获于 2026-10-12),属厂商自测口径,暂无第三方独立复测;中文转写成绩为模型卡所列基准,测试集与中文 ASR 榜单(如 SuperCLUE)口径不同,不可直接互比。发布时间以模型卡「Release Date」栏(2026-10-28,四通道同上)为准。本文不构成任何采购或选型建议。