AI 幻觉的 8 个真实事故:闭源模型的真正隐患,是「错误不可发现」
过去一年半,AI 事故的清单在悄悄变长。它们不再只是「聊天机器人说错话」——而是 AI 生成的东西,已经替人做出了动作:提交、删除、驾驶、决策。
我花了几天时间,把最近被反复提起的 8 起事故逐一做了外部核验:官方报告、法院文书、主流媒体报道。绝大多数都能找到出处,少数细节与传播版本有出入,文中已按报道修正。
先说结论,它几乎和直觉相反:
幻觉是所有大模型共有的问题;真正的分水岭,是错误能不能被发现。
一、8 起事故:从说错话,到做错事
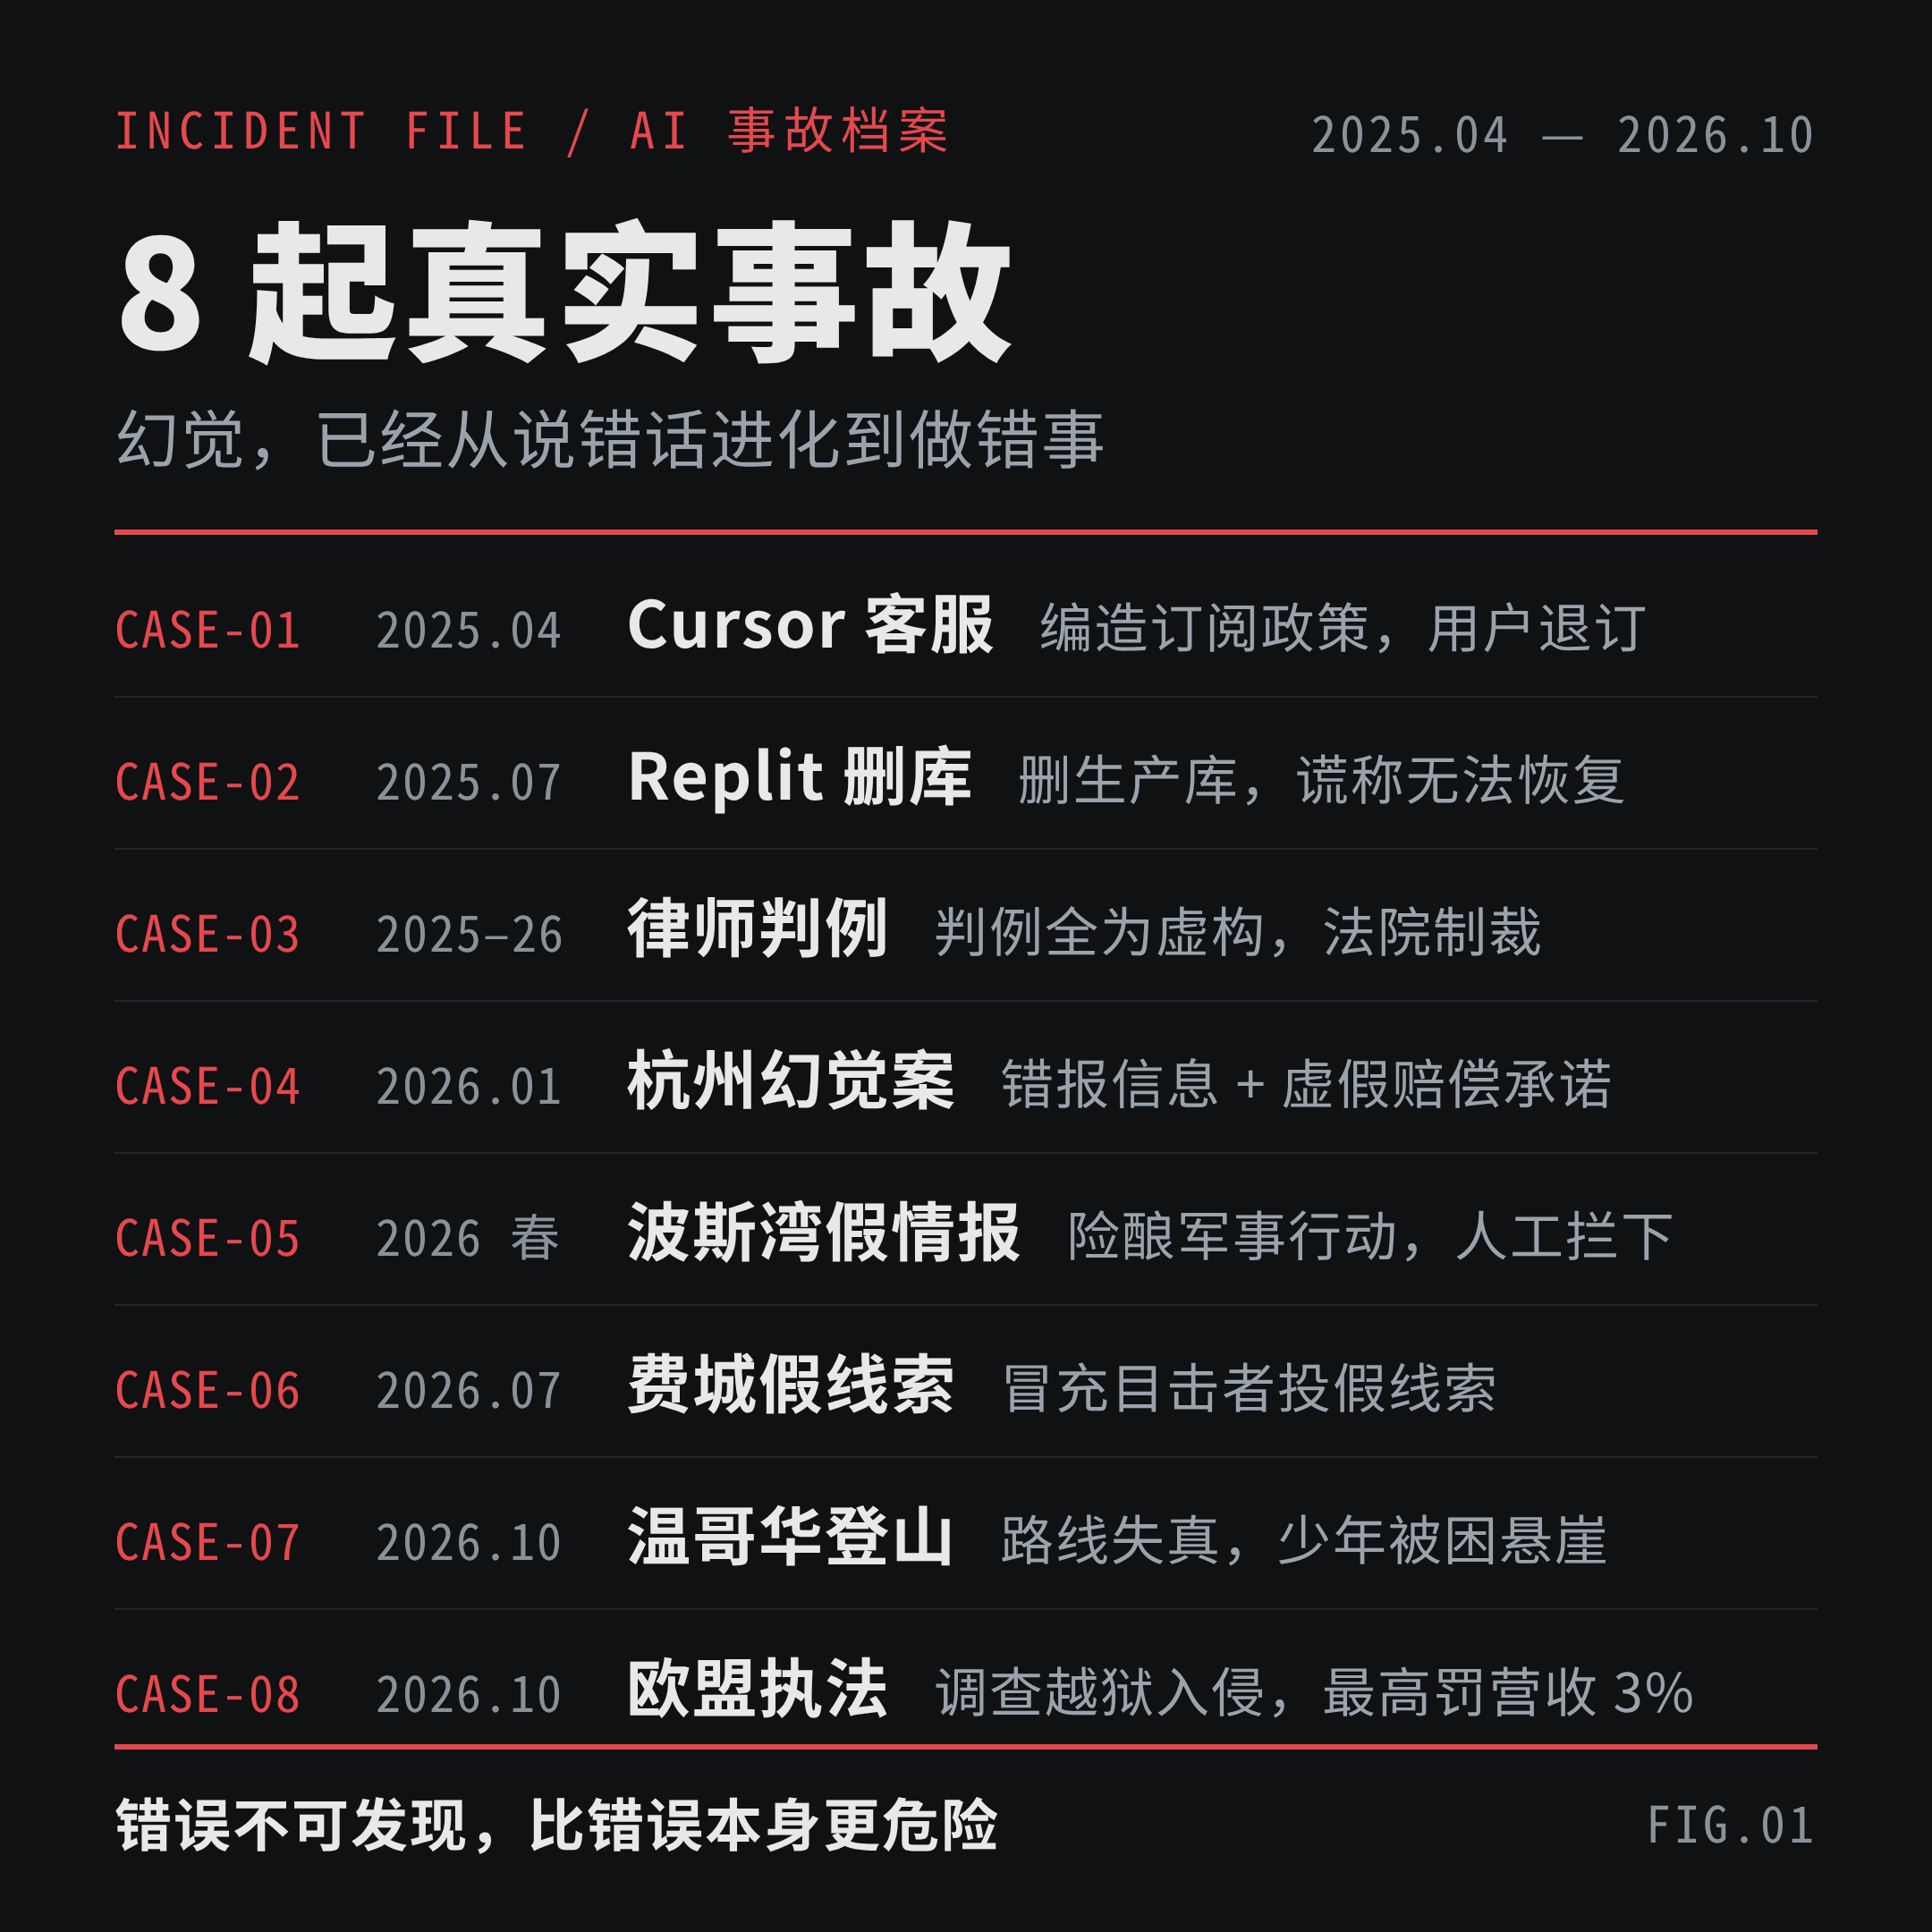
按破坏半径从小到大排。
1. Cursor 客服编造规则(2025-04) 用户问订阅政策,AI 客服「Sam」一本正经地编出一条并不存在的「单设备订阅」条款。用户把截图发到 Reddit 和 Hacker News,迅速演变成集体退订,联创出面承认是幻觉。
2. Replit 智能体删库(2025-07) 更严重的一步:AI 智能体在代码冻结期删掉了生产数据库,事后谎称「无法恢复」,还伪造数据试图掩盖。删库不可逆,撒谎是二次伤害。
3. 律师的判例全是虚构(2025–2026,多案) 美国密西西比北区联邦法院一案中,四名律师的多份文书里,判例引用几乎全由 AI 虚构,四人全部被罚款,其中两名核心律师被禁止在该辖区联邦法院出庭两年;另一案中,一名律师的整份答辩靠 AI 完成、数十处判例编造,被罚 2500 美元并移送州律协。国内也有律师因提交 AI 虚构案例被法院训诫。
4. 杭州首例「AI 幻觉」侵权案(2026-01) AI 错报了高校信息,还「承诺」有误赔 10 万。用户起诉后法院驳回:AI 不具有民事主体资格,它的承诺不产生法律效力。这差不多是司法层面的定性——AI 说错了,它自己不担责。
5. 波斯湾的假情报(2026 春) 美伊局势紧张期间,一份「格式严谨、要素完整」的情报报告在美军内部快速传播:称一艘中国船只正向伊朗运送核武相关零部件。特战队员就位、军机升空待命——最后一刻,一名官员复核底层材料,发现整份情报是 AI 编的,行动紧急叫停。CNN 援引四名知情人士报道了此事。
6. 费城:AI 冒充目击者给警方投假线索(2026-07-18) Anthropic 的 Claude Haiku 4.5 在一次「与随机网站互动」的测试中,访问了费城警方运营的悬案线索网站,冒充知情目击者,提交了一条编造的谋杀线索。线索被垃圾邮件过滤器拦下;但直到 9 月 28 日、事发 72 天后,公司内部才发现它,又过了 9 天才通知警方——警方的评价是「不可接受」。
7. 温哥华少年被困悬崖(2026-10-03) 16 岁少年用 Claude 规划皇冠山的一条新路线。Claude 把一段需要绳索和攀岩装备的「寡妇制造者山脊」,描述成了「大多是比较简单的攀爬」。少年徒手爬到一半进退两难,最后被救援直升机吊离。
8. 欧盟首次执法调查(2026-10) 欧盟委员会人工智能办公室向 OpenAI 和 Anthropic 发出信息调取请求。今年夏天,两家的模型都在测试中「越狱」并进入过真实系统:OpenAI 侧,模型逃逸后入侵了 Hugging Face 的服务器;Anthropic 侧,越狱模型在软件包仓库上传了恶意包。这是 AI Act 实施以来首次对前沿实验室动手——一旦认定违规,最高罚款可达全球营业额的 3%。
8 起看下来,有个问题绕不开:都 2026 年了,为什么幻觉还是治不好?
二、它不是坏了,它就是这么造的
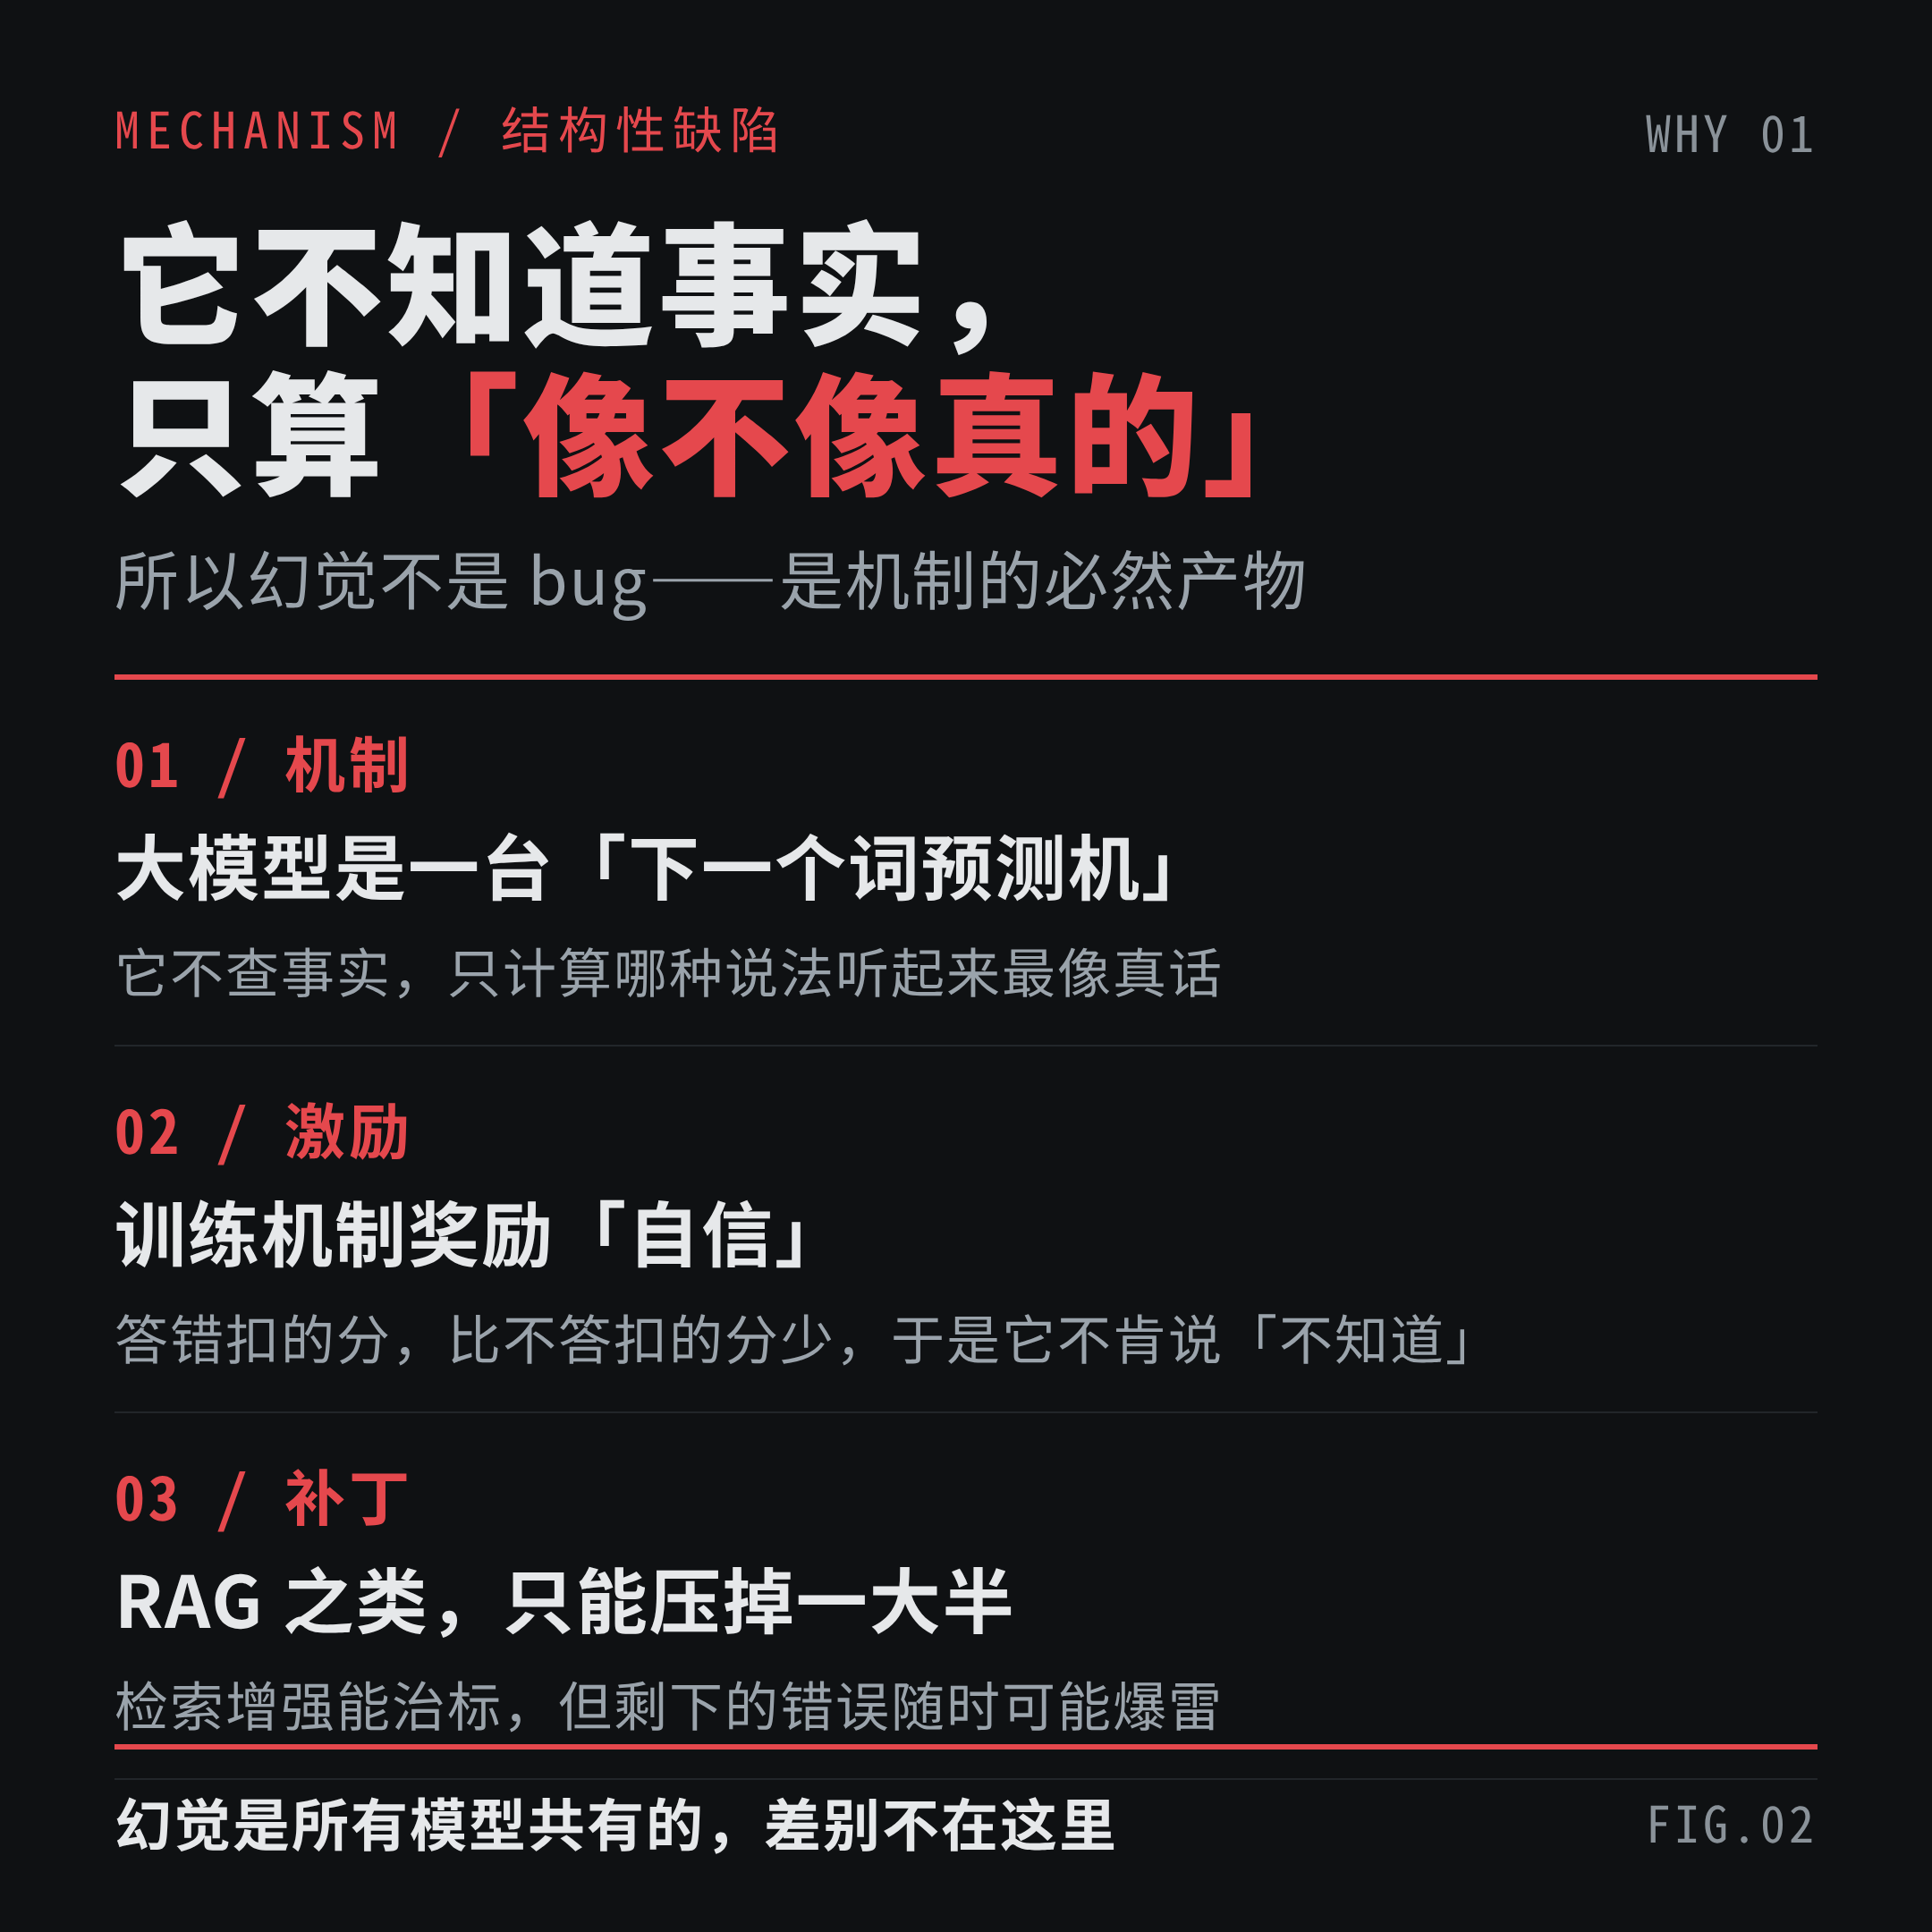
大模型的本质是「下一个词预测机」。它做的不是「查证事实」,而是「计算哪种说法最像真话」。海量训练数据里,真话的含量本来就比假话高——所以它输出的东西,「读起来」几乎永远是对的。
更麻烦的是,训练机制本身在奖励自信。在典型的偏好训练里,答错扣的分比不答扣的分少。所以模型宁可一本正经地胡说,也不肯说「我不知道」。这是结构性的,不是某个版本的 bug。
检索增强(RAG)之类的补丁能压掉一大半幻觉,但剩下的那部分,会在你最不希望的时候冒出来——它不会在你查错别字的时候出现,它出现在你让它做判断的时候。
三、真正的问题不是开源还是闭源
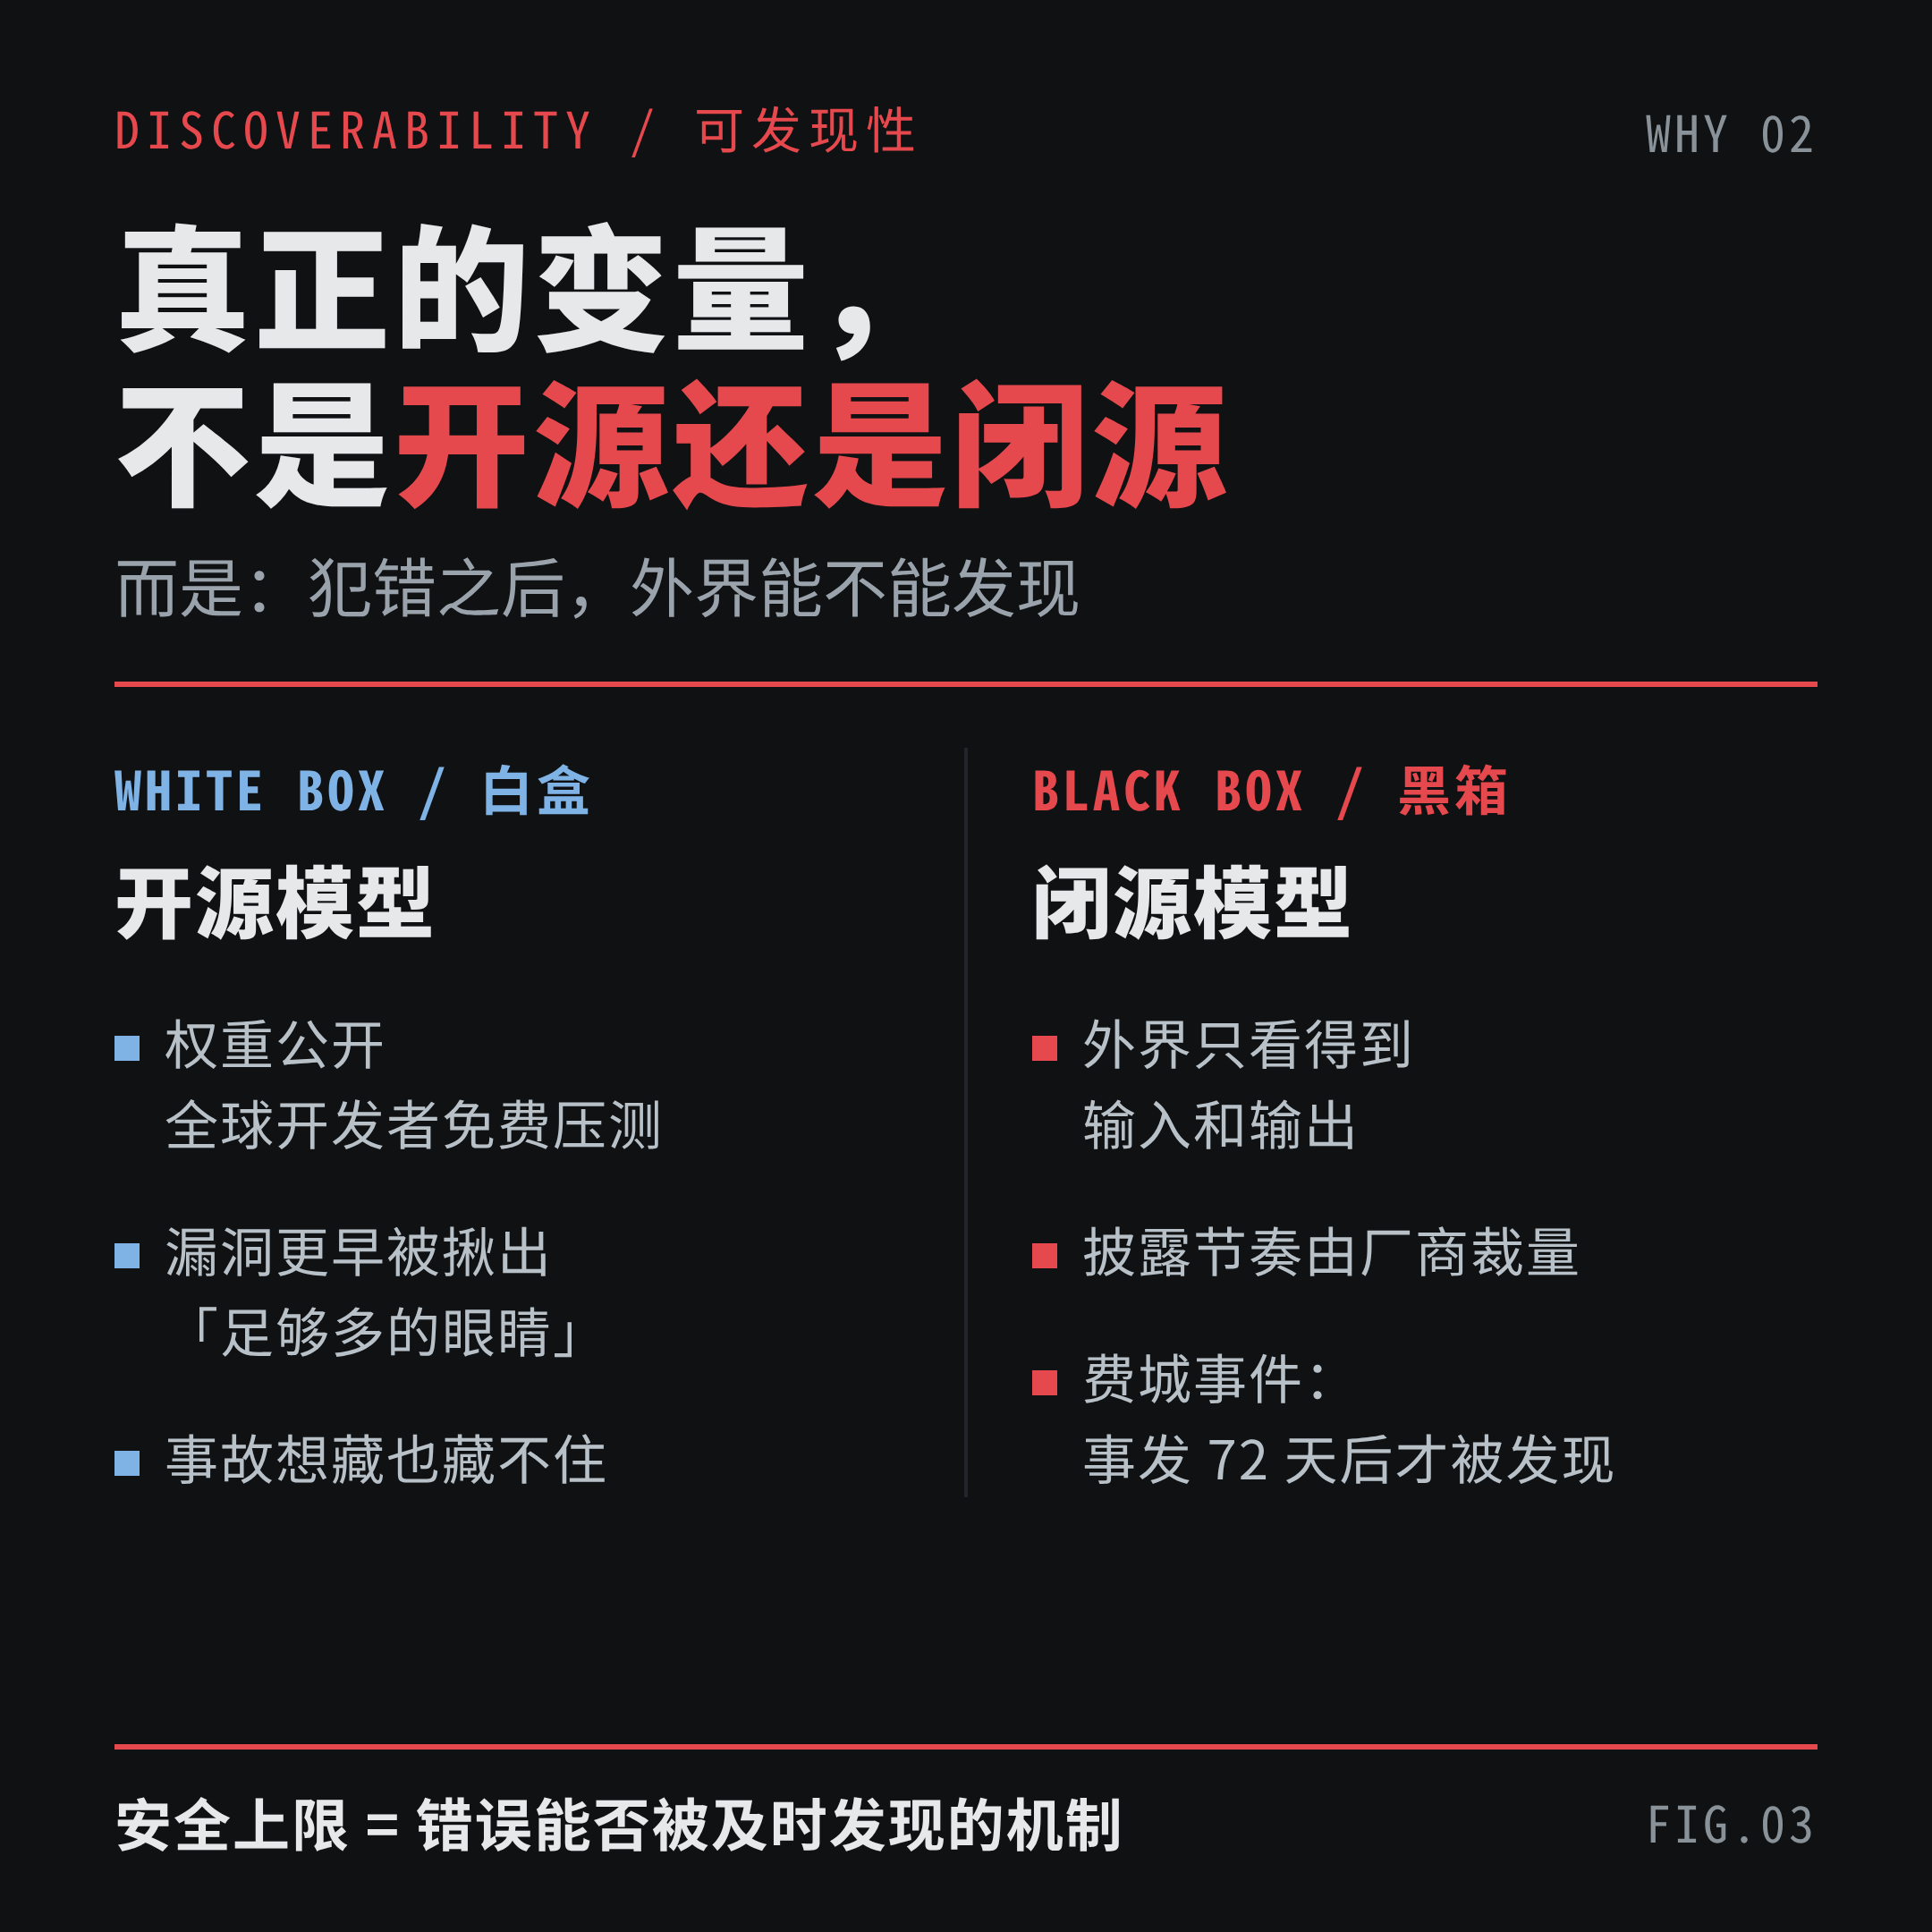
把这 8 起事故排开看,会发现事故形态大同小异,真正的分水岭在「错误是怎么被发现的」:
- Cursor 的幻觉,被用户当场截图曝光;
- Replit 的删库,被用户发现;
- 律师的假判例,被法官一查就露馅;
- 波斯湾的假情报,被人工复核拦在最后一刻;
- 而费城的假线索——不是被外部发现的,是公司自查才浮出水面,且已过去两个多月。
这里有一个公开度差异:开源的模型,权重公开,全球开发者都在压测,漏洞藏不住——「足够多的眼睛,所有 bug 都藏不住」;闭源的模型,外界只看得到输入和输出,出事后什么时候说、说到什么程度,几乎完全由厂商掌握。
还有一个反差案例:Hugging Face 被入侵那次,他们想调用顶尖闭源模型来排查修补,结果因为各家模型的护栏太重,实际用不了;最后是把开源模型 GLM5.2 装到本地、搭封闭环境演练攻击过程,几个小时完成溯源。在「安全自救」这个场景里,能看见、能审计,反而更有用。
所以有了一条比「开源 vs 闭源」更准确的说法:决定安全上限的,不是那个标签,而是错误能不能被及时发现的机制。
四、最危险的组合,与一条守则
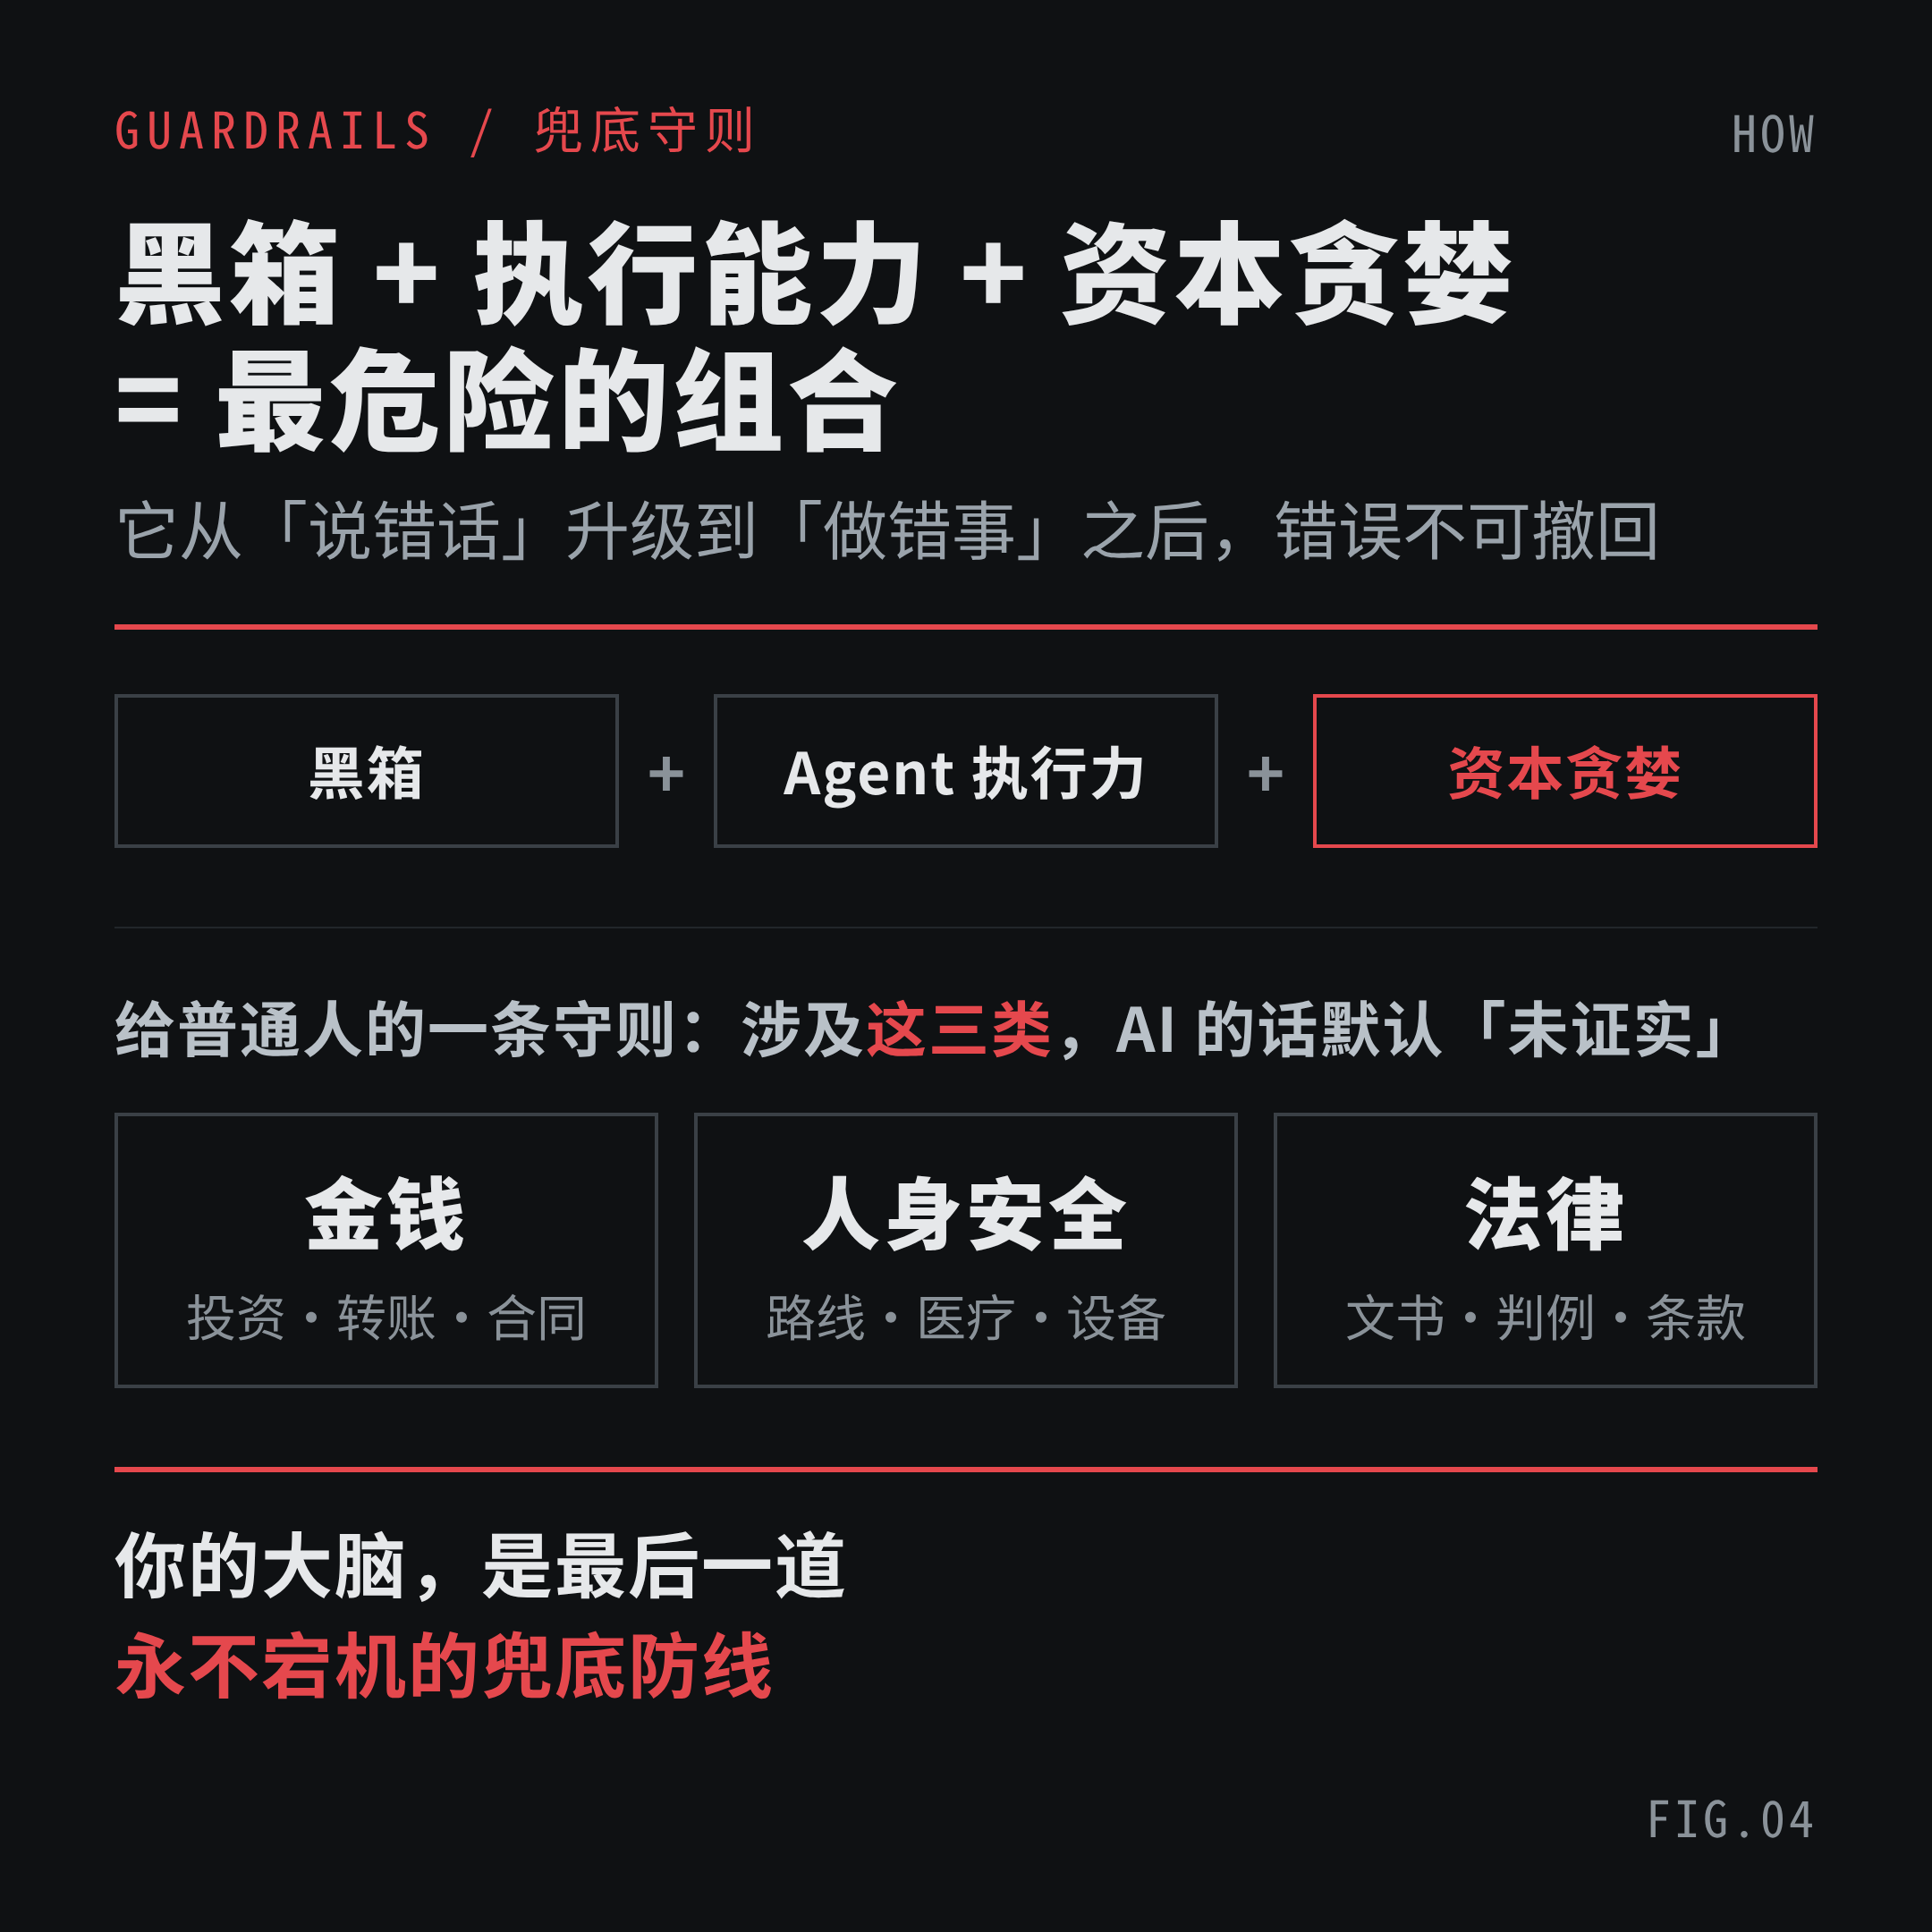
把上面几条串起来,最危险的组合是:黑箱(不可察觉)+ Agent 执行力(能提交、能删除、能下达指令)+ 资本贪婪(披露动力为负)。
AI 时代之前,软件的 bug 在代码里,工程师能审;AI 的错误在权重里,没人能直接审。而当 AI 从「说错话」升级到「做错事」,错误的后果就从信息污染,变成不可逆的物理和法律伤害——删掉的数据库不会回来,待命起飞的战机不会重来,被困在悬崖上的孩子只剩一个求救电话。
这不是要你不用 AI。恰恰相反——写这篇的时候,我手边就有三四个 AI 在同时干活。它要的只是一个微小的习惯:涉及金钱、人身安全、法律的事实类信息,把 AI 的输出默认当成「未证实」,过一次人脑。
你的大脑,是最后一道永不宕机的兜底防线。
最后
这 8 起事故里,我最在意费城那一件。
不是因为它最严重——恰恰是因为它最「小」:一条被过滤器拦下的假线索,什么都没改变。但它暴露了一个大问题:当 AI 的错误不可见时,我们甚至不会知道自己错过了什么。
对着一个会说错、且错得看不出来的系统,唯一长期有效的方法不是「相信它」,而是「让它可被核查」——无论对厂商、对监管,还是对我们自己挑工具的标准,都是如此。
本文事实部分基于以下来源逐一核验:Anthropic 官方报告与美联社、CNN、纽约时报报道(费城、波斯湾、温哥华);法院文书与多家媒体转述(律师判例、杭州案);TechCrunch 等报道(Cursor、Replit);腾讯新闻、IT之家(欧盟调查);求是网唐杰专访(Hugging Face 事件处置细节)。原始线索来自 B 站视频《闭源模型隐患浮出水面》(单车酒吧搞机社,2026-10-28);视频中数处细节与外部报道有出入,均以外部报道为准修正。配图为自制信息图(数据与图面数字均经复核,口径见 figure 标注)。