扩散模型第一次摸到「同规模超越自回归」:Clover-35B 值得相信几分?
昨天,小红书上一篇帖子说:三年内,扩散模型将全面替代大语言模型。
这话放在过去两年,基本会被当成标题党。因为扩散语言模型(dLLM)一直有个尴尬:小尺寸上很惊艳,一到大规模就哑火——速度是快了,能力总差一口气。「扩散能不能在同等规模上追平自回归」,是整个 2026 年悬着的开放问题。
而就在今天,这个问题拿到了第一个像样的样本。
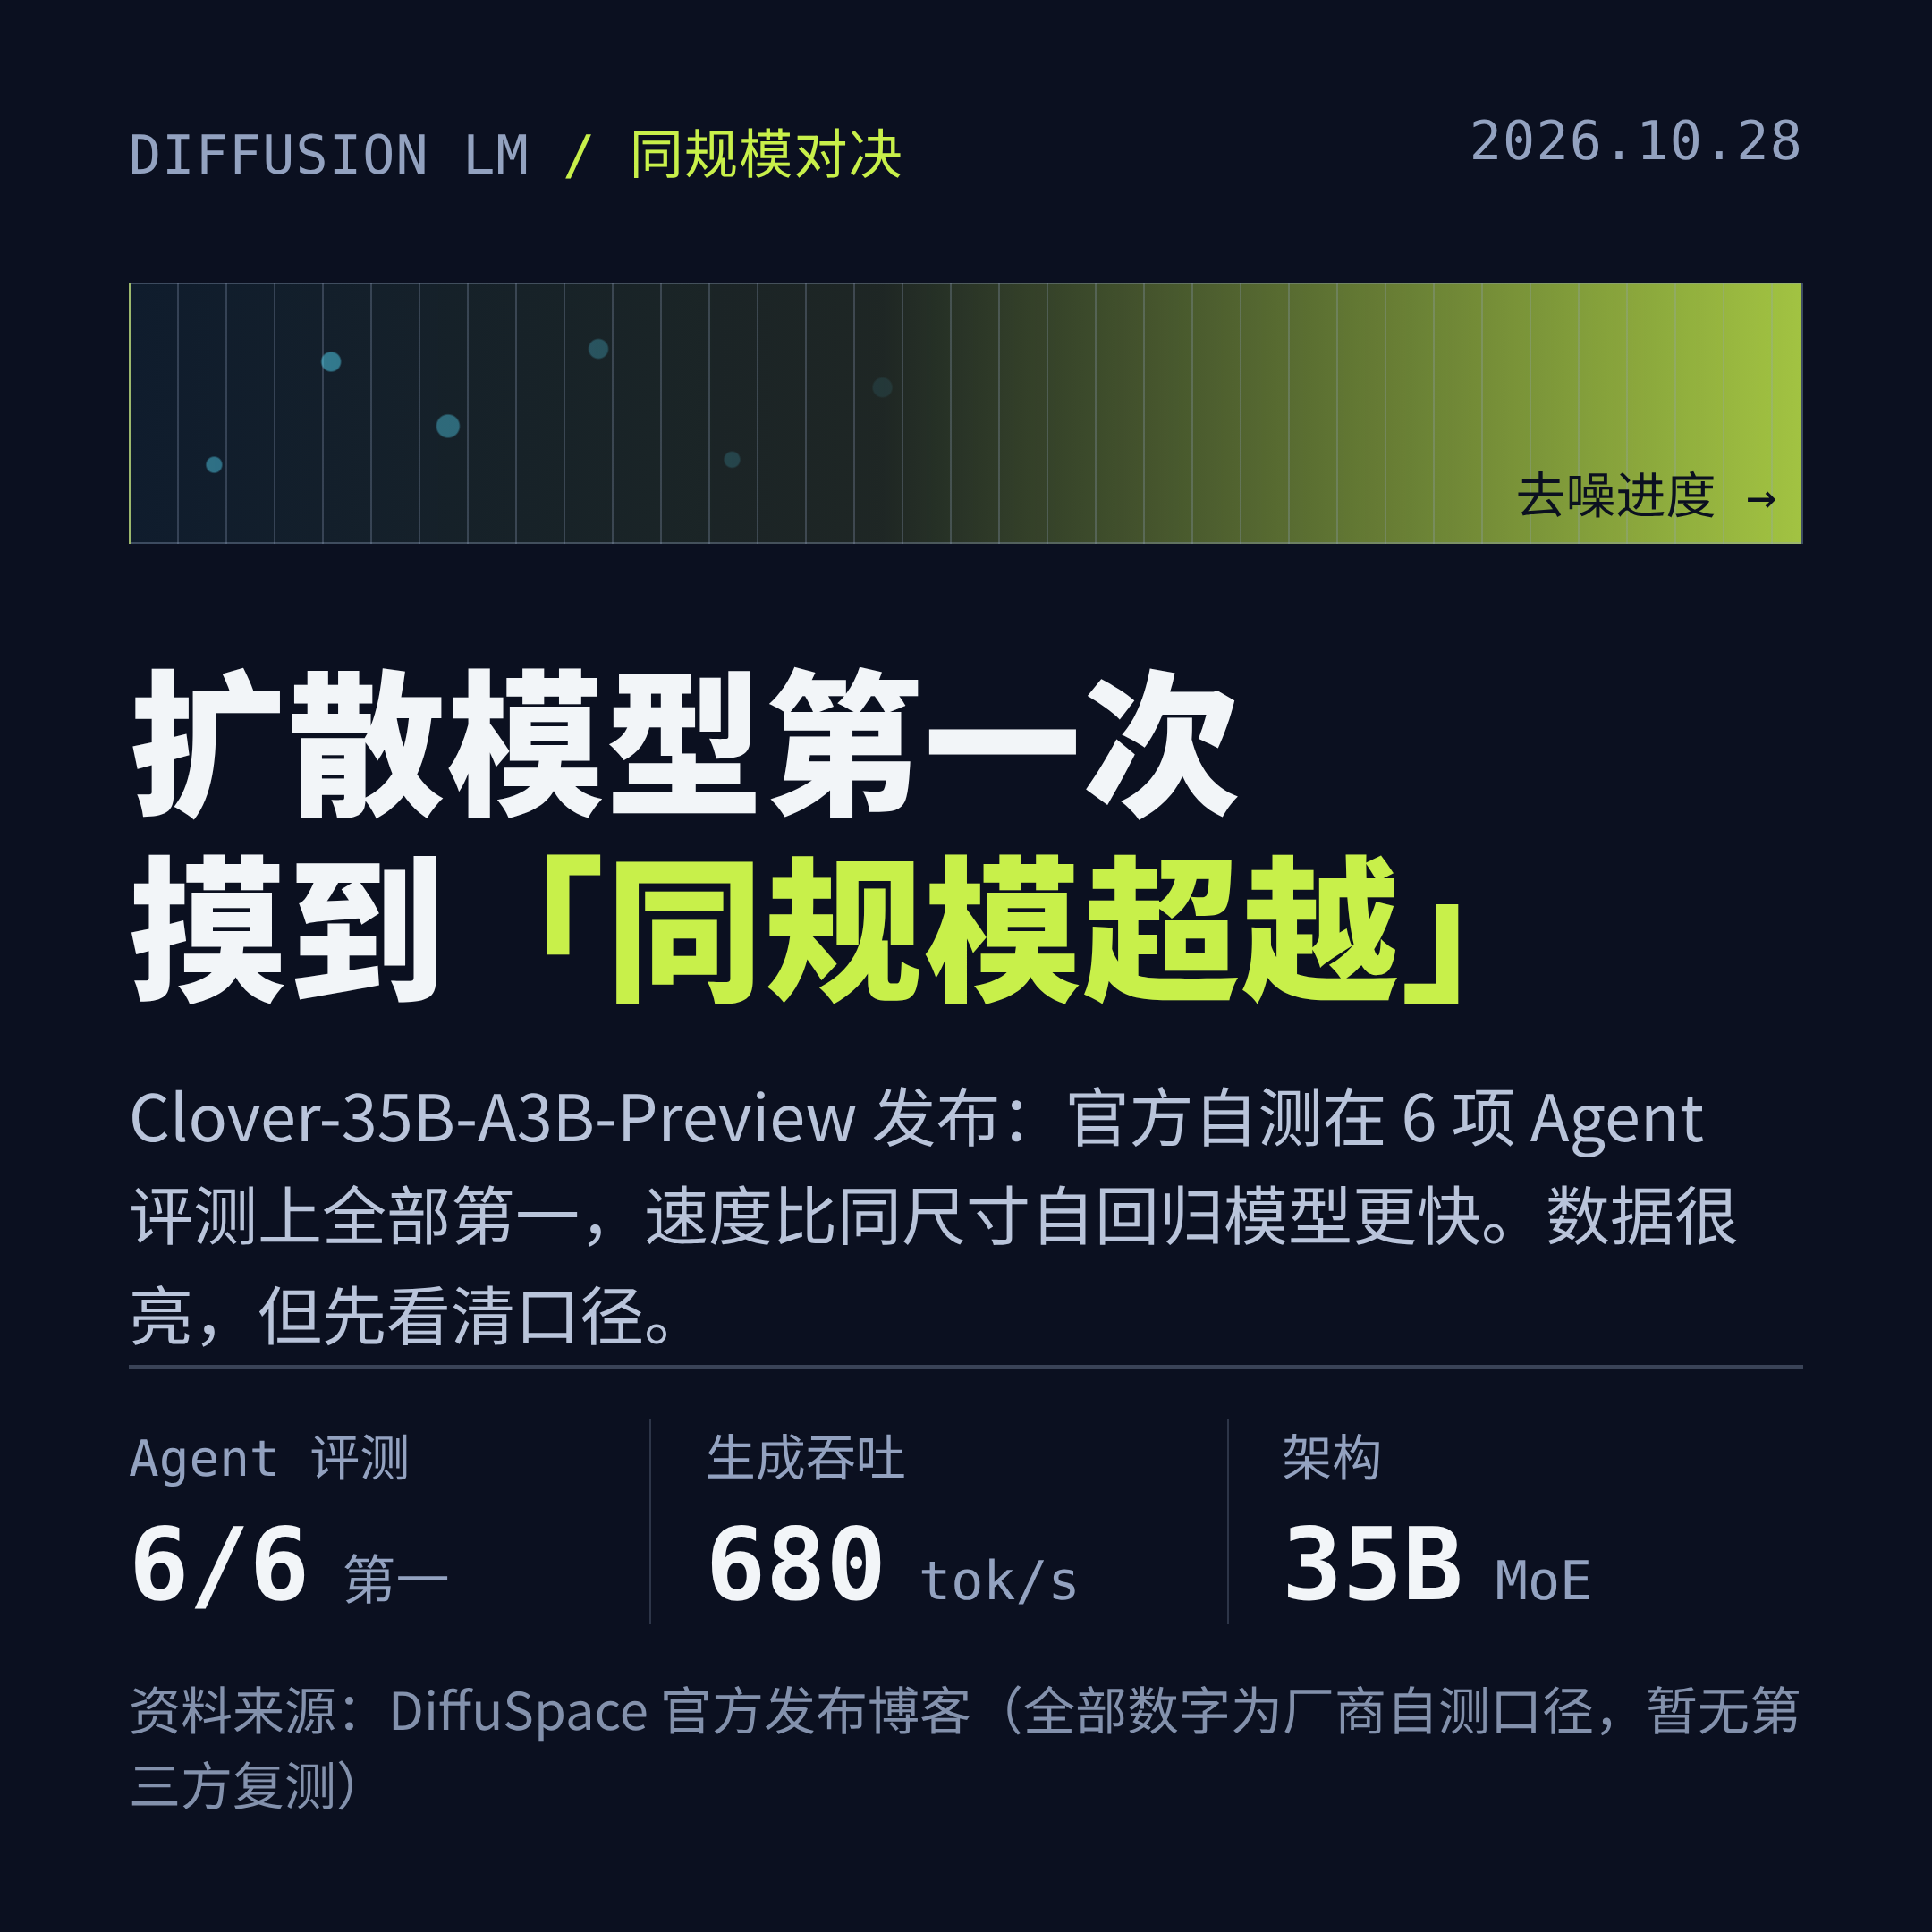
一个叫 Clover-35B-A3B-Preview 的扩散语言模型发布了:35B 总参数、3B 激活的 MoE,官方自测在 6 项 Agent 评测上全部拿到对比组第一,速度比同尺寸的自回归模型(Qwen3.6-35B-A3B)快得多。发布方 DiffuSpace,来自做 Dream 7B 的那支团队。
数据很漂亮。但在你把「三年替代论」当真之前,有几个口径必须先看清楚。这篇把两件事都讲清:它做到了什么,以及它目前还缺什么。
一、先花 30 秒:扩散模型和自回归,到底差在哪
你现在用的所有大模型——GPT、Claude、DeepSeek——几乎都是自回归(AR):像打字一样,一个字一个字往外蹦。生成 1000 个字,就要把模型完整跑 1000 遍。这是写在架构里的串行瓶颈。
扩散语言模型换了个思路:它不逐个预测,而是先铺一整片「掩码」(相当于一片待填的空格),然后一轮去噪同时确定多个位置,几步之内把整段话「擦」出来——像从噪点里显影出一张照片。
好处有两个。一是快:延迟从「字数 × 单次前向」变成「去噪步数 × 单次前向」,而步数远小于字数。二是能改:自回归写下的字不能回头改,扩散的每一步都在全局修改,天然适合「有模板、有结构、要反复调整」的活。
难点也有两个:训练比自回归难得多;生成质量在大规模上一直没证明过自己。这就是今天这个发布被关注的原因。
二、Clover 是什么:Dream 7B 团队的 35B 答卷
先看规格,一次说完:
- 35B 总参数 / 3B 激活的 MoE 架构,纯文本,支持「思考模式」,128K 上下文
- 训练路线:以 Qwen3.6-35B-A3B 的权重初始化,再做扩散训练(而不是从零训扩散模型)
- Apache-2.0 开源:权重已上 Hugging Face / ModelScope / GitHub,推理支持 SGLang 和 llama.cpp
- 微调(SFT)代码、决策模型、Agent 框架「近期发布」
它背后的团队谱系值得单独说:DiffuSeq(教扩散模型「按要求写」)→ DiffuLLaMA(把训练好的自回归模型改造成扩散模型)→ Dream-7B(2025 年,证明了扩散模型能跟自回归正面掰手腕,Hugging Face 累计下载 270 万+)→ Clover(把这条路线推进到 35B MoE)。
一句话:这是一条走了三年的技术路线,把「改造现有 AR 权重」当成了规模化的梯子。
三、官方成绩单:6 项 Agent 评测,全部第一
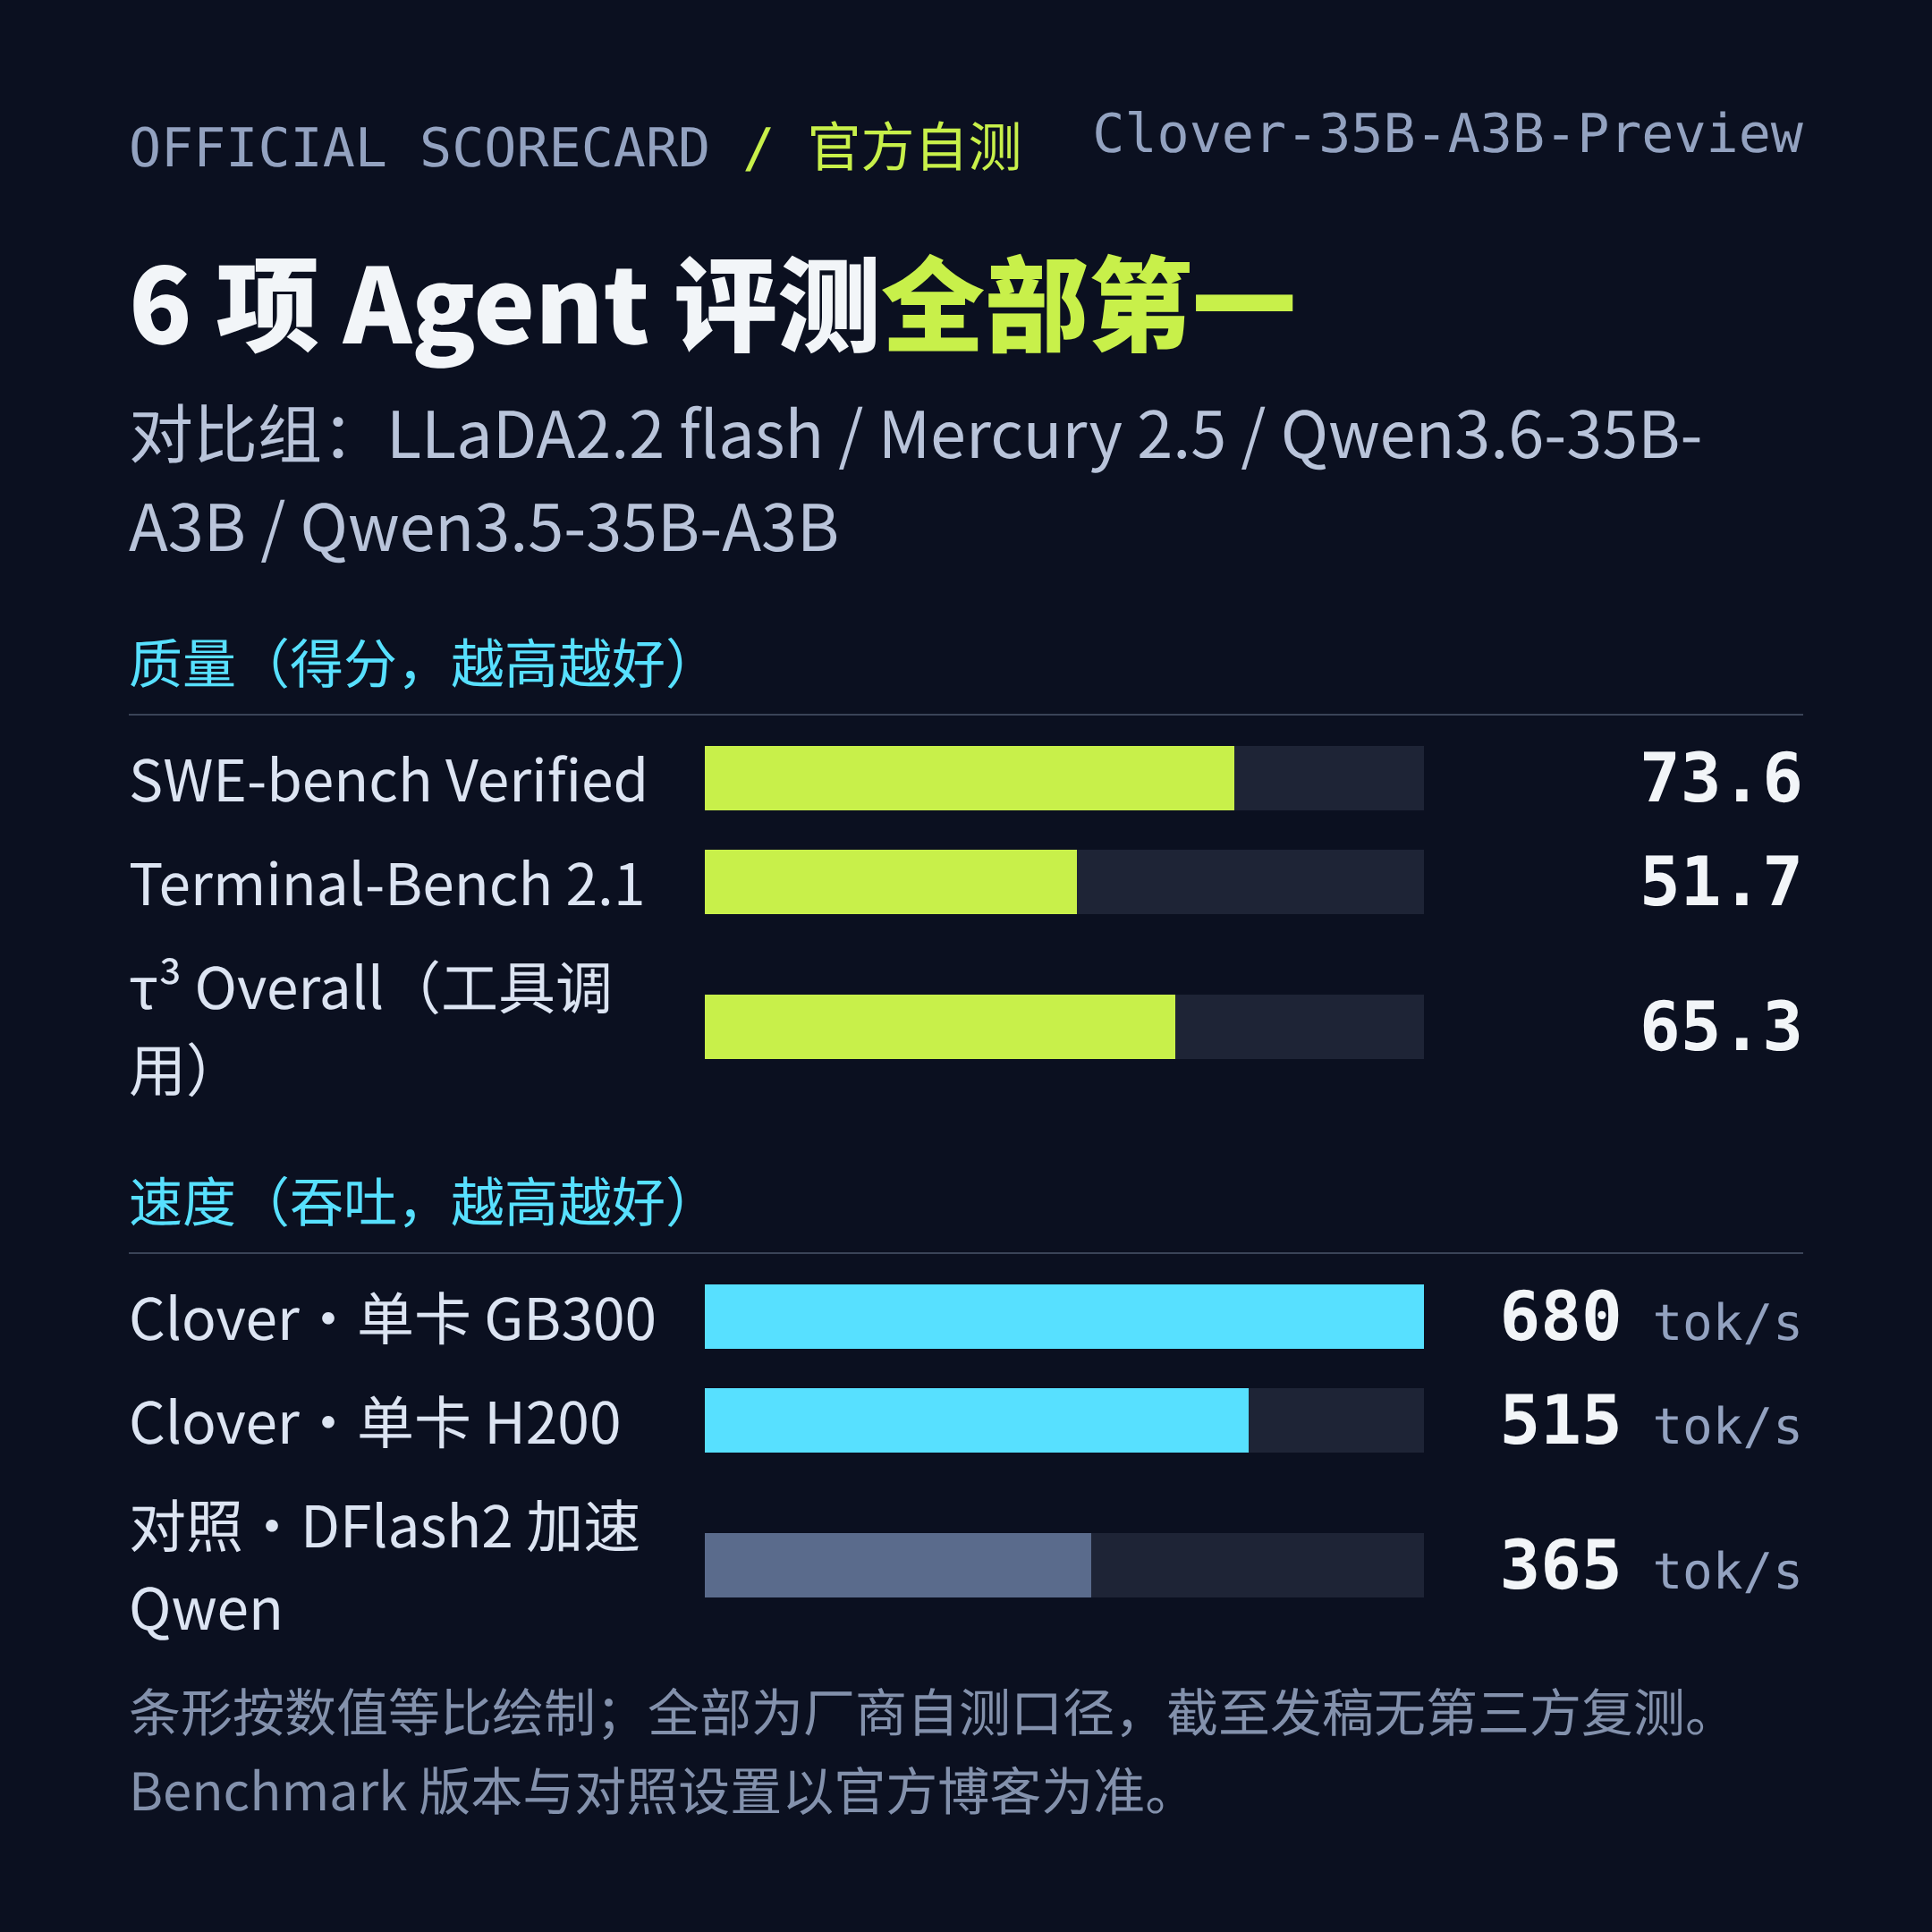
先看质量。官方博客给出的核心数字(对比对象包括同为扩散路线的 LLaDA2.2 flash、Mercury 2.5,以及同尺寸自回归的 Qwen3.6-35B-A3B、Qwen3.5-35B-A3B):
- SWE-bench Verified 73.6(真实软件工程任务)
- Terminal-Bench 2.1 51.7(终端操作任务)
- τ³ Overall 65.3(工具调用)
- 通用能力:GPQA Diamond 83.8、ZebraLogic 95.8、AA-LCR(长上下文)72.0
在官方对比的这 6 项 Agent 评测里,Clover 全部第一。注意修饰语是「官方对比的这些模型、官方自测」——后面会讲为什么这很重要。
再看速度,这是扩散的看家本领:
- 单张 GB300、BF16、batch size=1:680 tokens/s
- 单张 H200 的 Agent 任务:515 tokens/s——对照「DFlash2 加速后的 Qwen」是 365 tokens/s
第二个对比很有意思:DFlash2 是当前给自回归模型提速的先进方案(用块扩散做投机解码草稿)。一个完整的扩散模型,跑得比「自回归+最强调速插件」还快——如果这个数字经得起第三方复测,说明「换个范式」可能比「给旧范式提速」更有效。
还有端侧:INT4 量化后,在 16GB 显存的 RTX 5070 Ti 上跑 MATH-500 达到 101.8 tokens/s(对比组的 MiniCPM/Qwen 是 48.5)。一个 35B 的模型在消费级显卡上跑到 100+ token/s,这个数字比评测分数更让我意外。
四、它是怎么做到的:把 GDN「掰弯」成双向
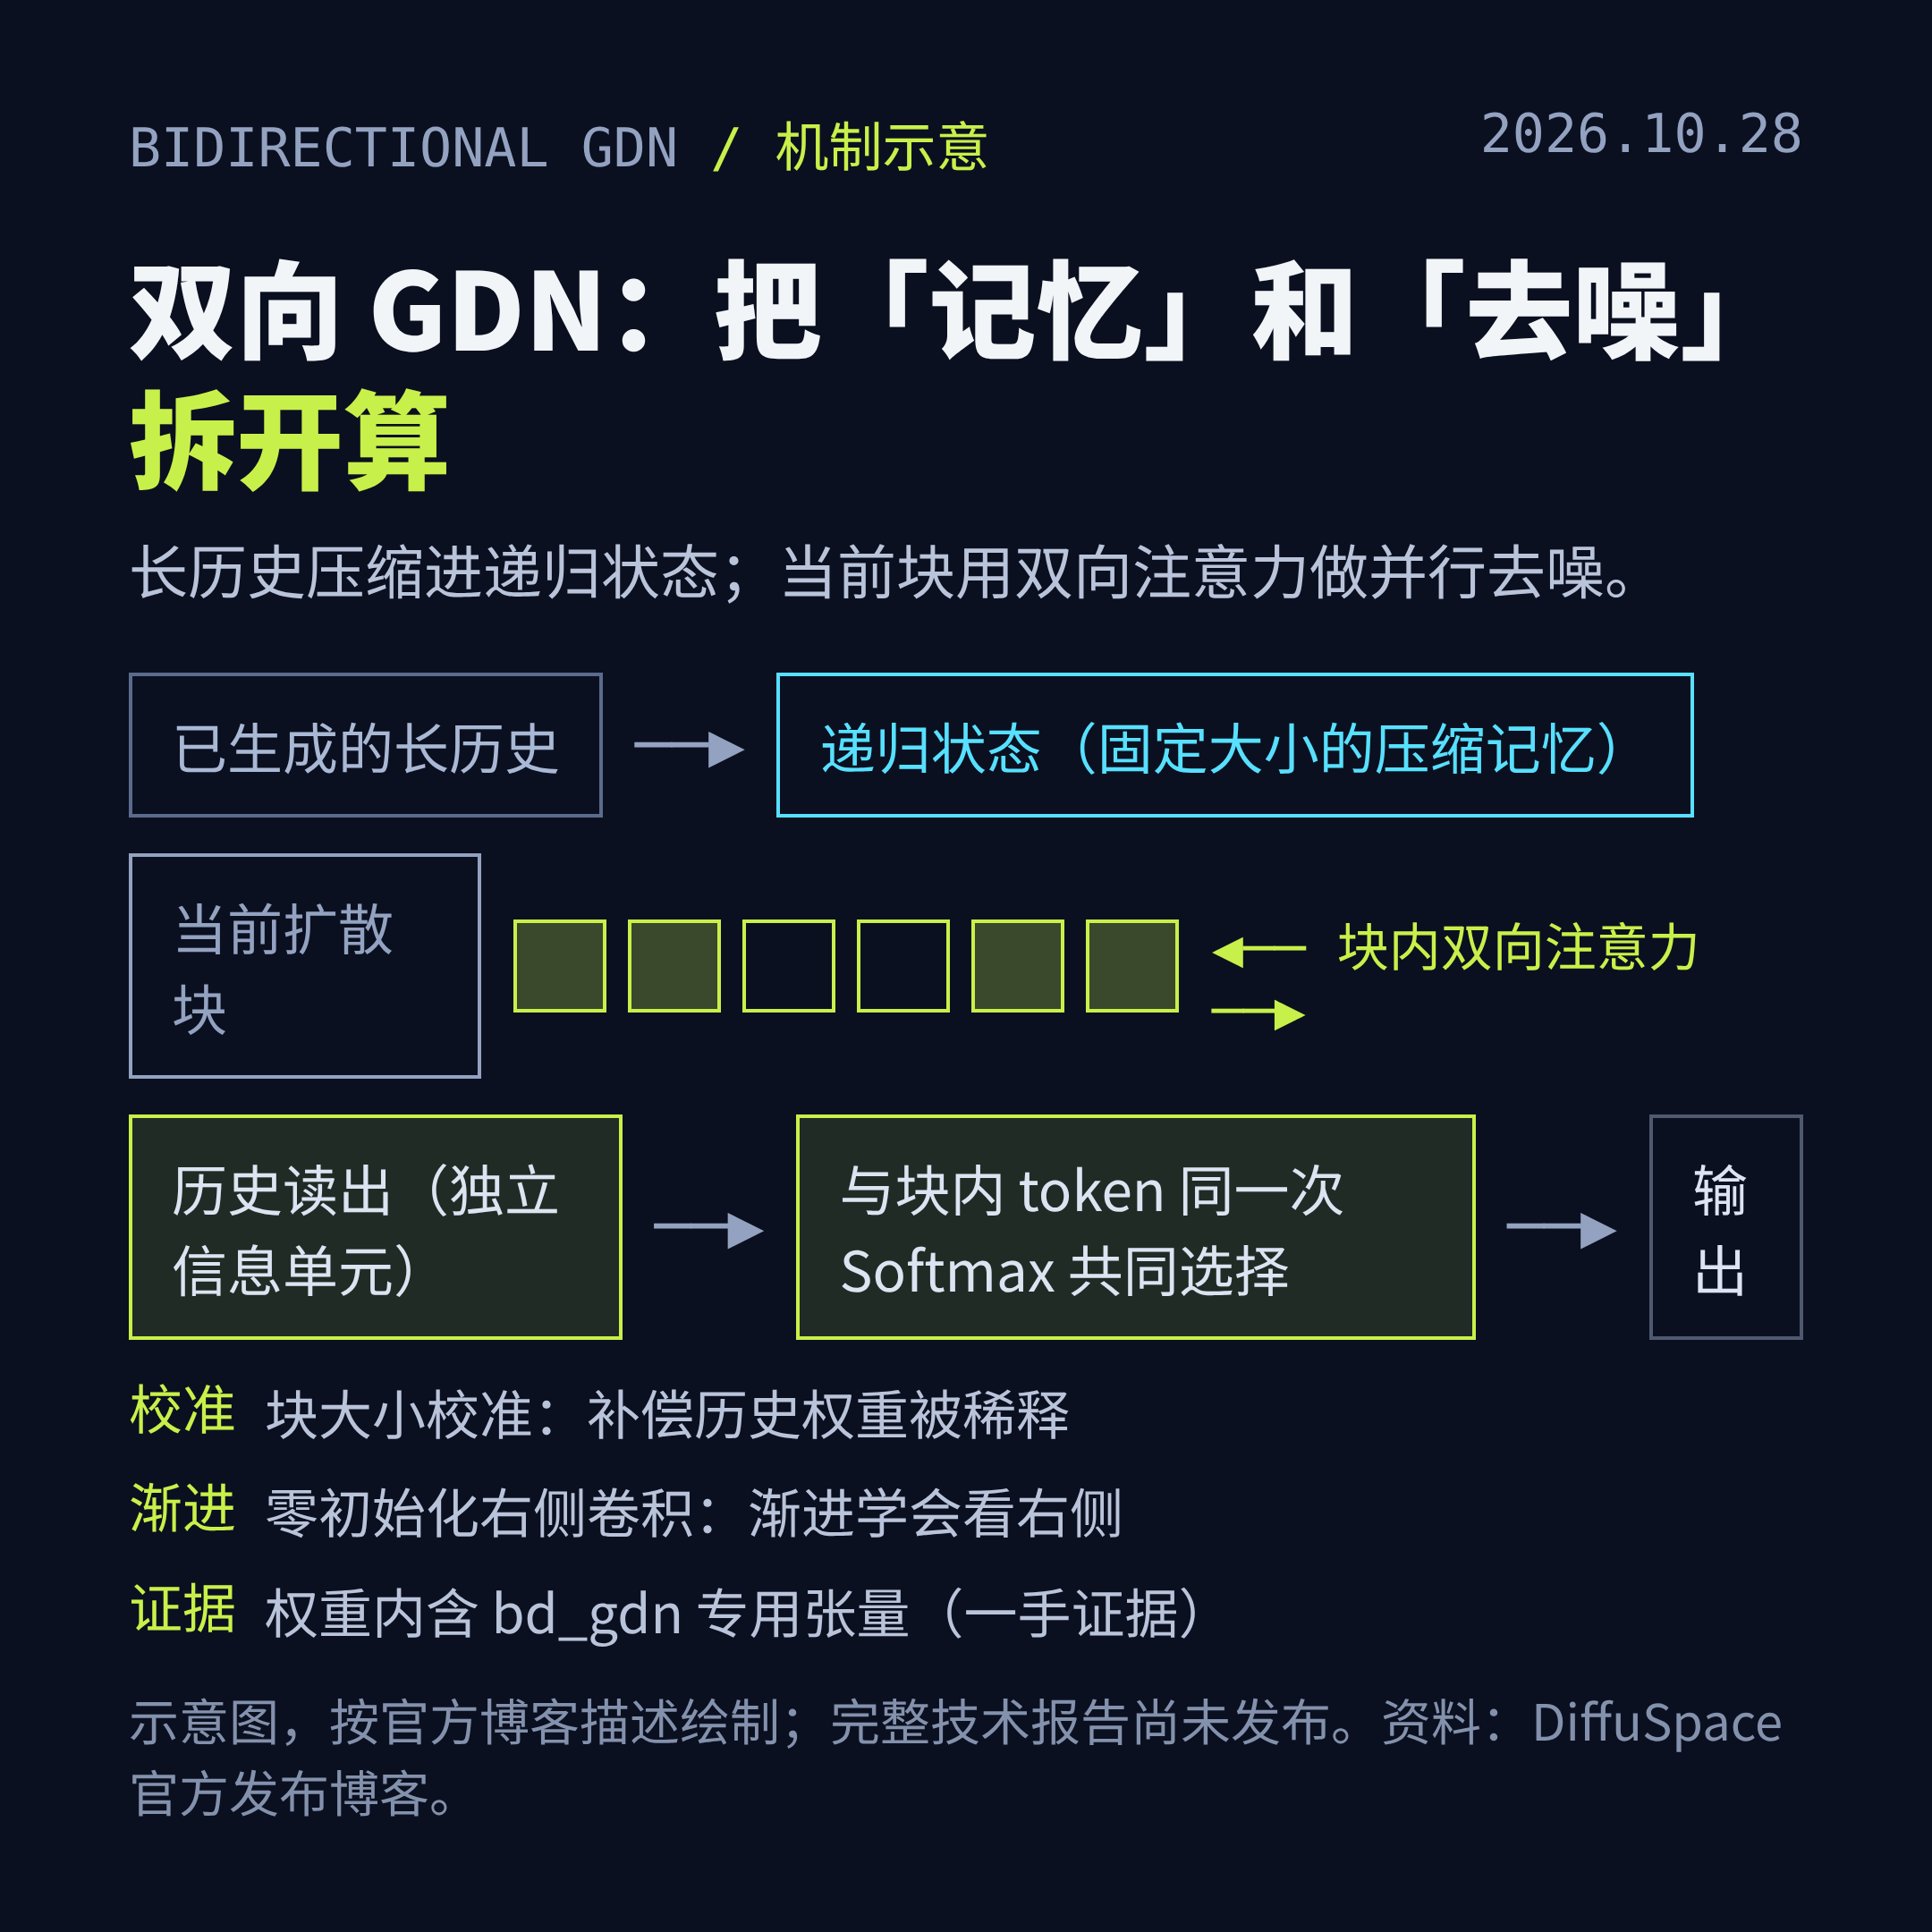
如果你只想记一件事,记这个:Clover 的核心创新叫「双向 GDN」。
解释一下背景。自回归模型为了长上下文效率,流行一种叫 Gated DeltaNet(GDN)的线性注意力结构:把历史压缩成一个固定大小的「递归状态」,像一份随时更新的压缩记忆。但标准 GDN 是严格单向的——只能读历史,不能看未来。而扩散模型恰恰需要块内双向:同一块里的 token 要互相看、一起改。
Clover 的解法是把 GDN 改造出四种「双向能力」:
- 历史压缩不变:已生成的长上下文,继续压进递归状态;
- 块内改双向:当前正在去噪的那一块,用双向注意力让 token 看左右两侧;
- 历史读出作为一个独立「信息单元」参与同一次选择:让模型自己学「什么时候该翻记忆、什么时候信眼前」;
- 块大小校准 + 零初始化右侧卷积分支:块变大时补偿历史权重被稀释的问题;让模型从预训练的单向卷积行为出发,慢慢学会用右侧信息。
效果就是:长历史用紧凑内存存着,当前块做精细的双向去噪。我在官方发布的权重文件里核了对得上的实体证据——模型文件里确实有两个专用张量(bd_gdn_conv_right_weight、bd_gdn_softmax_scalars),对应上述第三、四点设计。架构不是纸面叙事,是已经落地在权重里的东西。
五、值得相信几分:三个口径,和一份待验证清单
好话说完,现在说冷水——这也是我认为这发布最需要被正确理解的部分。
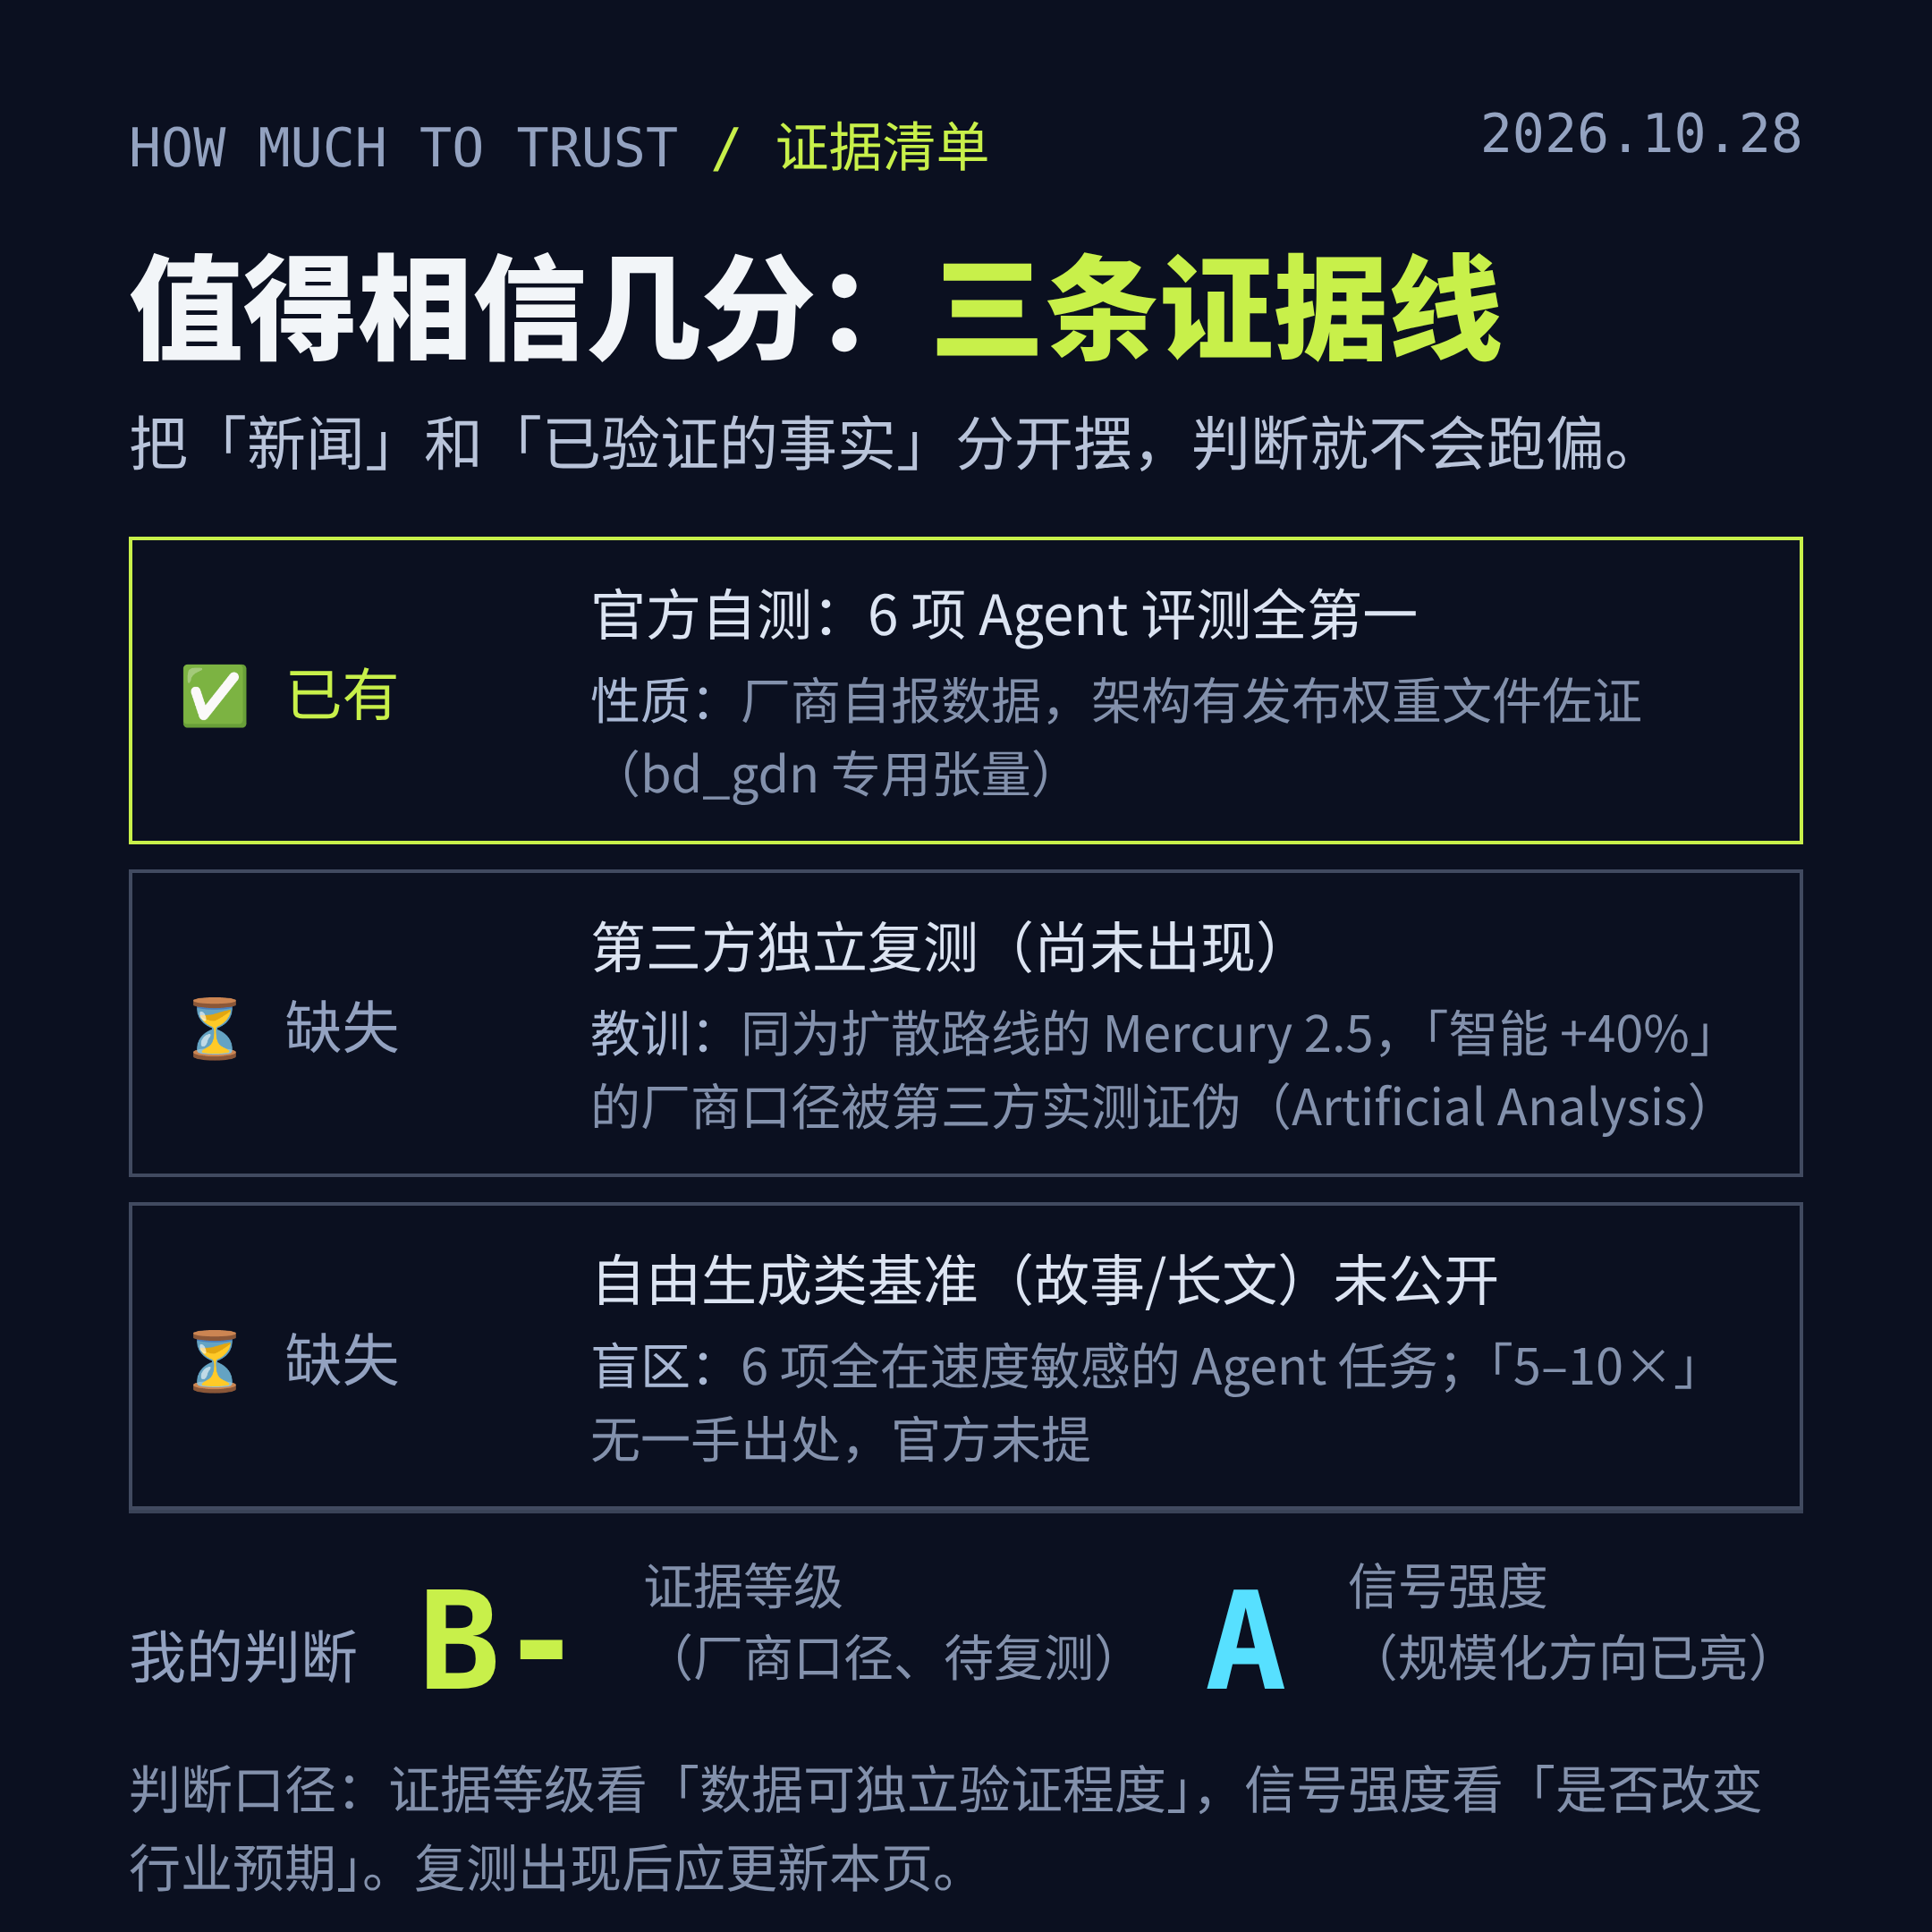
第一,全部成绩是厂商自测。 到今天为止,没有第三方独立评测。这不是吹毛求疵:同为扩散路线的 Mercury 2.5,厂商口径说「智能比上一代提高 40%」,第三方 Artificial Analysis 实测后不但没复现,独立得分还低于同级中位。厂商在你死我活的赛道上说自己第一,先验概率本来就该打折。
第二,速度数字存在口径分歧。 有中文圈文章声称 Clover「速度是 Qwen3.6-35B-A3B 的 5–10 倍」,但官方博客通篇没有这个说法——官方给的是绝对吞吐(680 tok/s)和与 DFlash2 的对照。5-10× 目前找不到一手出处,先按「待核」处理。
第三,评测集的偏向。 6 项全部集中在 Agent/工具调用类任务。这类任务对速度高度敏感(每一步生成都在累积等待),快模型天然占便宜。而扩散模型理论上最弱的「自由度大的长文生成」(故事、长篇论证),恰好不在榜单里。「Agent 全第一」不等于「全面超越」。
所以,我的判断是:这不代表「三年全面替代」,但确实代表「同规模能不能打」这个问题第一次有了正面数据。 上一代的答案是「小模型快、大模型怂」;这一代的答案是「35B 上,官方数据说能打,等第三方的锤子」。
给这个发布打分的话:证据等级 B-,信号强度 A。 等两件事落地再升级判断:①第三方评测(Artificial Analysis 这类)出现;②在自由生成类任务上的公开表现。
六、对我们普通人,这事的信号在哪
抛开「替代论」,这个发布里有一条被低估的信号:速度本身正在变成智能的一部分。
直觉上我们总觉得「聪明的模型可以慢一点」,但在 Agent 时代,这个等式反了——AI 要连续做几十上百步操作(查资料、改文件、调工具、验证结果),每一步的延迟都会沿任务链累积。官方演示里那个例子很典型:同一个网页任务,Clover 用 28 步、169.9 秒完成;对照组是 30 步、578.3 秒,还没做完。快,直接换来了「做完」。
而文章开头那篇中文介绍里有个观察我认为说得很准:文本扩散「极度适配伴写类软件」——光标停下的地方直接补全、按模板把一份公文改出结构、在笔记里整理目录和标签。这些活儿的共同点是「有模板、有结构、输出被输入限定」,恰好是扩散模型最擅长的形状。
所以,短期最可能用上扩散模型的,不是聊天窗口,而是:办公软件的续写、Agent 的工具调用、格式化的内容整理。 这些场景里,「快而够用」正在取代「慢而聪明」。
最后
回到那个热帖。我的答案和发布方自己的措辞一致:三年内会不会全面替代,还很难说;但百花齐放,本身就是好消息——对不同任务,我们多了一个能用的选择,这就够了。
Clover(三叶草)这个名字起得挺妙。它代表的幸运从来不是「取代谁」,而是「在同一个季节里,第一个破土」。
本文来源与说明:核心事实来自 DiffuSpace 官方发布博客(diffuspace.ai/blog/clover-35b/)、GitHub 仓库(DiffuSpace/Clover-35B-A3B-Preview)与 ModelScope 模型卡元数据,三方交叉核验;国内线索来自公众号「刘聪NLP」的体验文(本是他先发现这个模型,文中「5–10 倍」等未经官方确认的说法已单独标注)。所有基准与速度数字均为厂商自测口径,截至发稿尚无第三方复测,引用请带口径。配图为自制信息图。本文不构成任何投资或采购建议。