他写了几个月规格,代码一天比一天烂:DDD 是什么、怎么做,SDD 和信任阶梯各管什么
2026 年初,Matt Pocock(TypeScript 教育者、mattpocock/skills 作者)在 OpenAI 工程师 Sean Grove 的演讲里听到一句话:「规格就是新代码」。
他信了。
那段时间他有一个最得意的项目——一个自己定制的视频编辑器,写作、缩略图、剪辑全在上面做。他把整个项目写成一份大规格文档,想让智能体照着规格把代码写出来。
试了几个月,结果是这样:代码一天比一天差,智能体产出的东西也一次比一次糟。
他最后把规格文档扔了,把注意力放回代码本身,事情才开始动起来。他的原话是:代码本身就是智能体工作和运行的那个环境。如果智能体是那条狗,而周围全是着火的房子,它写不出好代码。
这个故事第一次把「规格驱动开发」的失败讲完整:不是方法不流行,而是少了一环。
少的那一环,是词。
这篇把三件事讲清楚:DDD 是什么、怎么做(这是重点,四步今天就能用);SDD 到底管什么、什么时候不该用;以及为什么「放手让 AI 干」必须一级一级来。
一、先看框架:词、纸、手
我把它总结成三层,顺序不能颠倒:
- DDD 管「词」:把这件事里的名词统一。说不清是什么,后面全是错的。
- SDD 管「纸」:把已经做出的决定写下来。写不住的决定,会在实现时漂走。
- 信任阶梯管「手」:按你的验证能力,一级一级把执行权交出去。
一句话:说不清的词,写不成对的规格;没写住的规格,放不出安全的手。
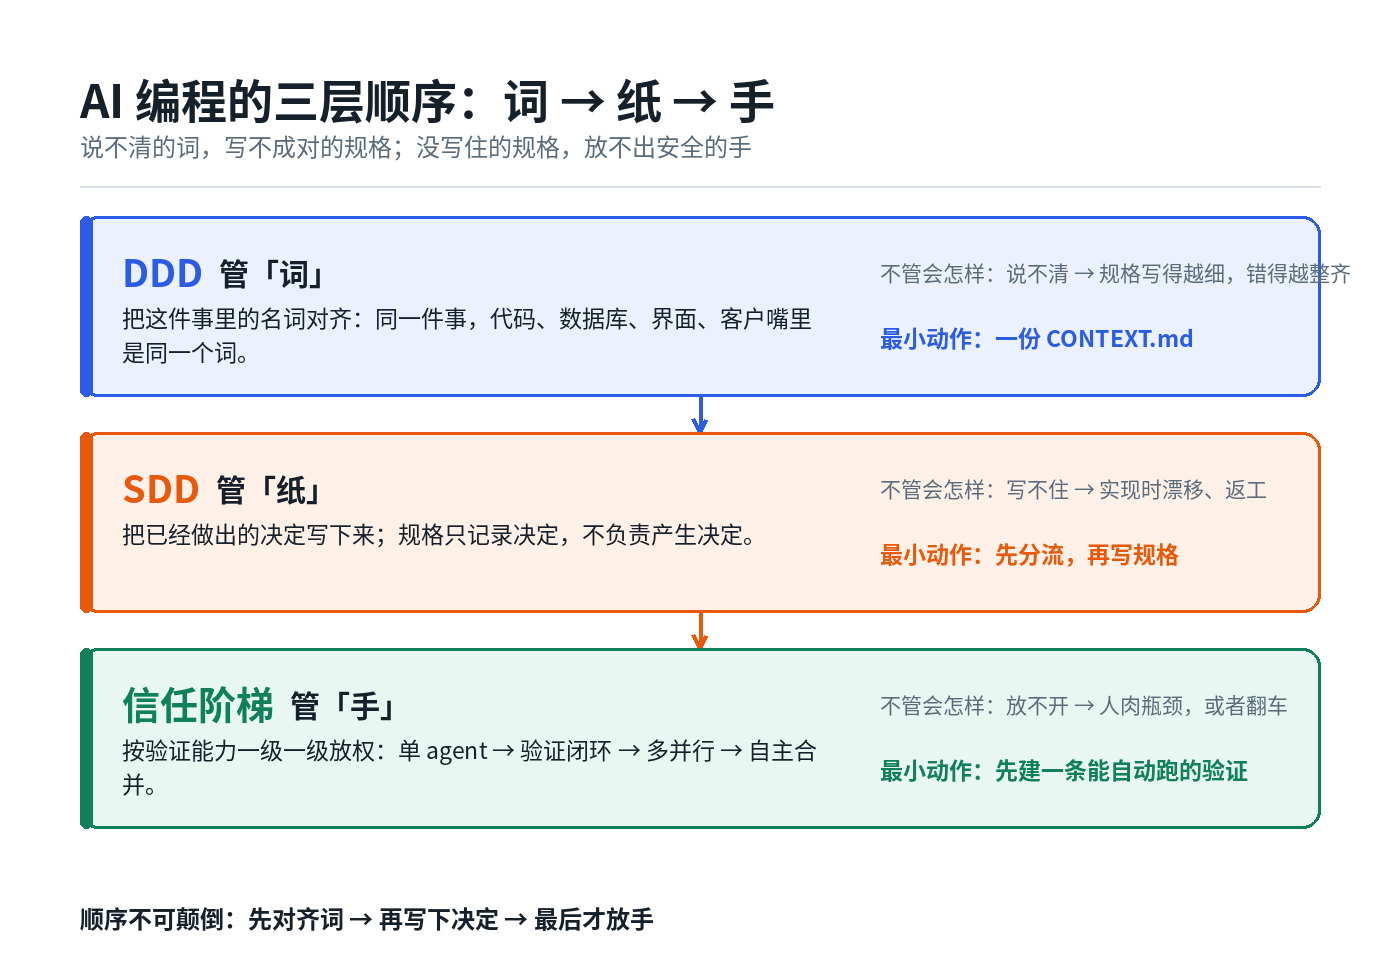
Matt 那几个月踩的坑,本质是拿着第三层的工具(写规格),去补第一层的窟窿(词没对齐)——规格写得越详细,错得越整齐。
下面逐个拆。
二、DDD 是什么:一句话,四个地方
DDD 的全称是 Domain-Driven Design,领域驱动设计。名字很唬人,其实核心只有一句:
同一件事,在代码里、数据库里、界面上、和人聊天时,必须用同一个词、同一个意思。
拿「订单」举例。
如果代码里叫 order,数据库表叫 trade,界面上写「购买记录」,和客户开会时大家说「单子」——四个地方,四套语义。人还能靠经验脑补,AI 不行。AI 只能按它读到的词去猜,猜错也不会告诉你,它会一本正经地写出一套自洽的错误代码。
Matt 的说法更直接:「DDD 与 AI 编程 100% 匹配。」
原因不玄学:智能体的上下文,就是它读到的那些词。词是乱的,它就在噪音里工作;词是准的,它每一次推理都站在同一个地基上。
DDD 其实有两半:
- 统一语言(Ubiquitous Language)——把词对齐。这一半最便宜、最有用、也最被忽略。
- 边界与结构——领域边界、分层、端口与适配器。这一半是等团队和项目变大以后的事。
多数人卡在第一步之前:以为 DDD 是要画一堆分层图,于是直接放弃。其实轻量版的 DDD,只需要一份词汇表。
顺带说一句重版:阿里开源的 COLA 把 DDD 做成固定四层骨架(Adapter / Application / Domain / Infrastructure)加 ArchUnit 自动校验,那是适合团队的"重约束"落地。个人和小项目用不上,但知道有这么个东西,等团队大了再上。
三、DDD 怎么做:四步,今天就能用
第一步:只列名词,不列动词
不要先画架构图,不要先选技术栈,不要先想数据库。
拿一张纸,把这件事里出现的名词全列出来:客户、订单、退款、一次请求、一轮会话、一个快照……
为什么是名词?因为名词划边界,动词不划。「要能看消耗」是动词,它不告诉你任何边界;「一次模型请求是一个会话里的第 N 次 HTTP 调用」是名词句,它立刻划出了 Session 和 Model Request 两个东西。
十分钟,列十个词,就够开始了。
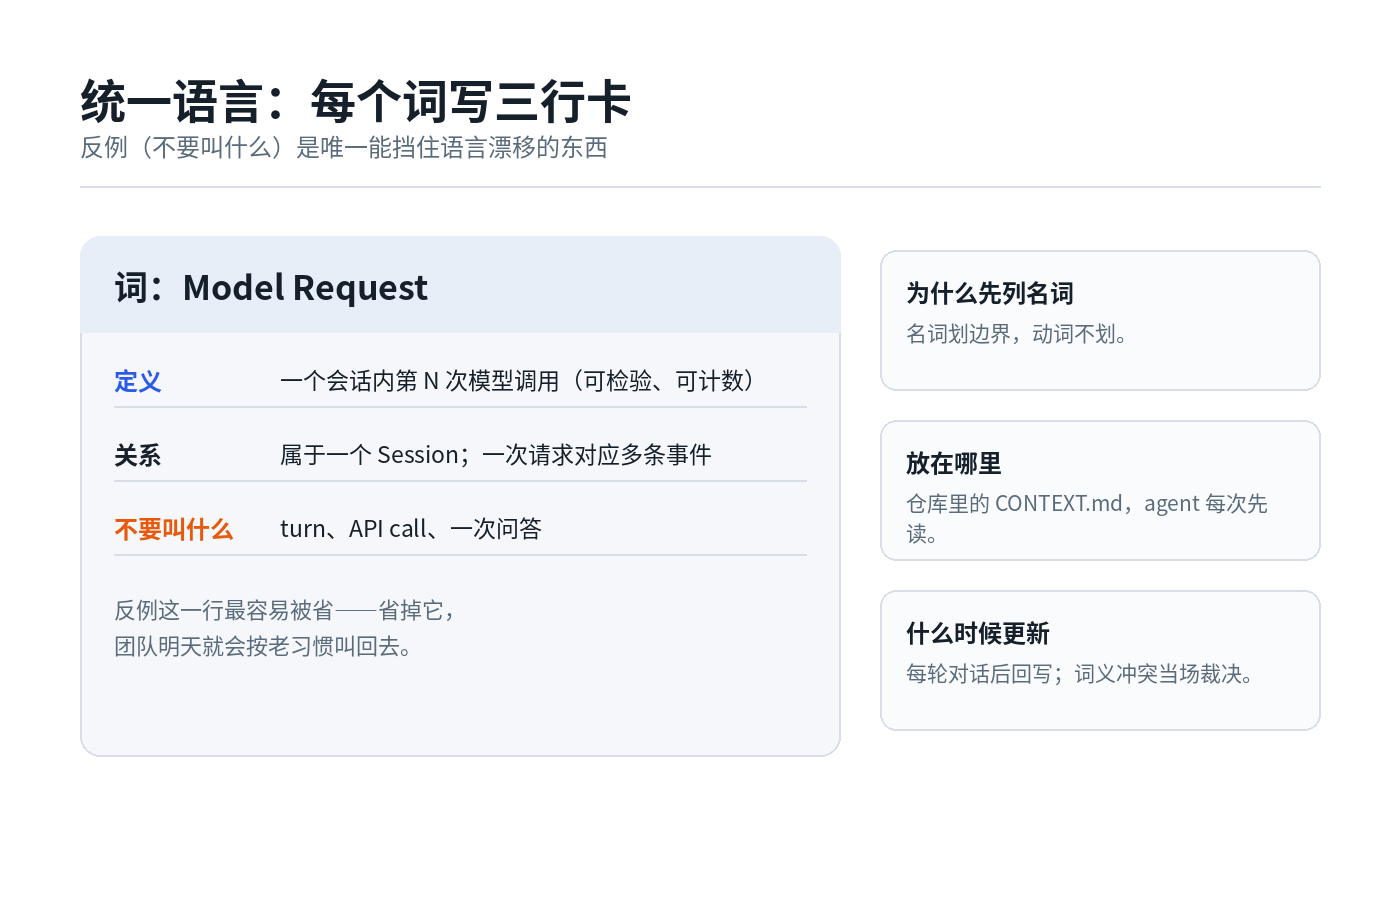
第二步:每个词写三行卡
每个词写三行,一行都不能省:
- 定义:一句话,最好能被检验。「退款:一笔已经支付的订单,被部分或全部退回的动作。」
- 关系:它和谁连着、怎么连。「一个订单可以有多次退款,但累计不能超过订单金额。」
- 不要叫什么(
_Avoid_):这一行最关键,也最容易被省。
为什么反例这么重要?因为词汇表最常见的死法不是"没定义",而是"定义完大家还按老习惯叫"。你写一句「不要叫它 bot、AI 工具、助手」,团队里就没人好意思写「bot 调用了模型」——反例是唯一能挡住语言漂移的东西。
第三步:落成 CONTEXT.md,放进仓库
词汇表不要放 wiki 首页,不要放飞书文档,放进代码仓库,命名 CONTEXT.md。
因为它的第一读者不是人,是 agent。让智能体每次开工先读它,等于给它一份压缩过的世界地图。
Matt 有个很实在的观察:同一句话,用统一语言写是 5 个词,不用是 20 个词。词汇表是最前置的上下文压缩——不用任何算法,只靠把词说对。
第四步:每轮对话后回写
词汇表不是写完就锁死的。每聊完一轮、每做完一个决定,回去看一眼:
- 有新东西没名字?加一个词。
- 同一个词有两种用法?当场裁决,记进「歧义清单」。
- 谁还在用旧叫法?把旧叫法写进
_Avoid_。
这套动作可以固化成技能。Matt 自己有两个:grill me 负责追问你没想到的事,grill with docs 负责在追问的同时把词汇表建起来,一轮一轮长出来。
一个真实例子:词汇表决定了包名
Matt 做过一场零代码的架构直播,给一个 Agent 监控平台做设计。全程没写一行代码,只做两件事:拷问,建词汇表。
事后复盘,9 条架构决策里有 4 条可以直接追溯到某几个术语的关系。几个细节很能说明问题:
- 一个包本来叫
packages/wire,因为词汇表把它定义成「事件」,改名packages/events——命名冲突不是代码问题,是词没定清楚的下游症状。 - 类型叫
NormalEvent,不是为了好看,是为了避开浏览器自带的全局Event。 - 早期「turn」被用来指一次模型 API 调用,裁决后把「一次调用」定名为 Model Request,把「turn」留给用户看得见的一轮——这一个决定,直接决定了后面计费单位和数据模型怎么设计。
这些都不是"写代码时才发现的问题",是"说话时就能发现的问题"。区别是,说话时改,成本是零;写代码时改,成本是重构。
补充一句:什么不算 DDD
- 不需要先学 UML,不需要画几十张图。
- 不需要一上来就改成四层架构。
- 一次性脚本、实验代码,不需要。
DDD 的最小形态,就是一份 CONTEXT.md 加这四步动作。 一份几十行的词汇表,二十分钟;它省下的返工,通常以小时计。
四、SDD:把「决定」写下来——但别让它替你做决定
SDD 是什么
Spec-Driven Development,规格驱动开发:先写规格(做什么、为什么、怎么做),让 AI 照着规格实现。
它火得有道理。Sean Grove 那场演讲的核心论点是:代码是意图的有损投影——你脑子里的意图,经过一层层翻译变成代码,每层都在丢信息。所以不如把源头写清楚:规格才是新的代码。
这套东西在有些场景里极其有效,库里有现成的成功样本:OpenSpec 用增量规格(delta spec)管变更、变更完成后归档,形成可审计的闭环;superpowers 把整个流程拆成七步(拷问 → 写计划 → 执行 → TDD → 代码评审 → 收尾)。有一个从零做网页游戏的案例:238 行设计规格加 1793 行实施计划、14 个 TDD 任务,最后 93/93 测试通过,评审还从规格里抓出 3 个"没写死的洞"。
但它为什么会失败
回到 Matt 的故事。他失败的地方很具体:他写的是规格,做的是决定,而这两件事根本不是一回事。
规格能记录决定,不能产生决定。
尤其是这类问题:「这个界面在特定情况下该长什么样」「这个状态模型在边界情况下怎么表现」。这些问题的答案不在纸上,只能在运行时看到。规格写得再详细,也只是把还没想清楚的东西写得很长。
有一个自查信号特别好用:当你写规格时,总忍不住想去看看代码——说明规格正在替你回避决定。
Matt 最后的结论是:代码才是智能体工作的环境。把环境弄好(能跑、能点、能截图、好修改),比把规格写厚更有效。他自己举了个例子:把一个复杂项目(依赖一堆第三方库、还要本地跑 OBS)改成智能体能自己点开、自己截图、自己跑起来——就这一个变化,产出质量直接上了一个台阶。
正确的用法:先分流,再写规格
按产出物类型分两路:
| 产出物 | 走法 |
|---|---|
| 契约类:API、数据模型、文档、报告、规格本身 | 规格先行(先对齐再实现) |
| 运行结果类:界面、交互、动画、声音 | 先做一次性原型,看到效果,再把决定写进规格 |
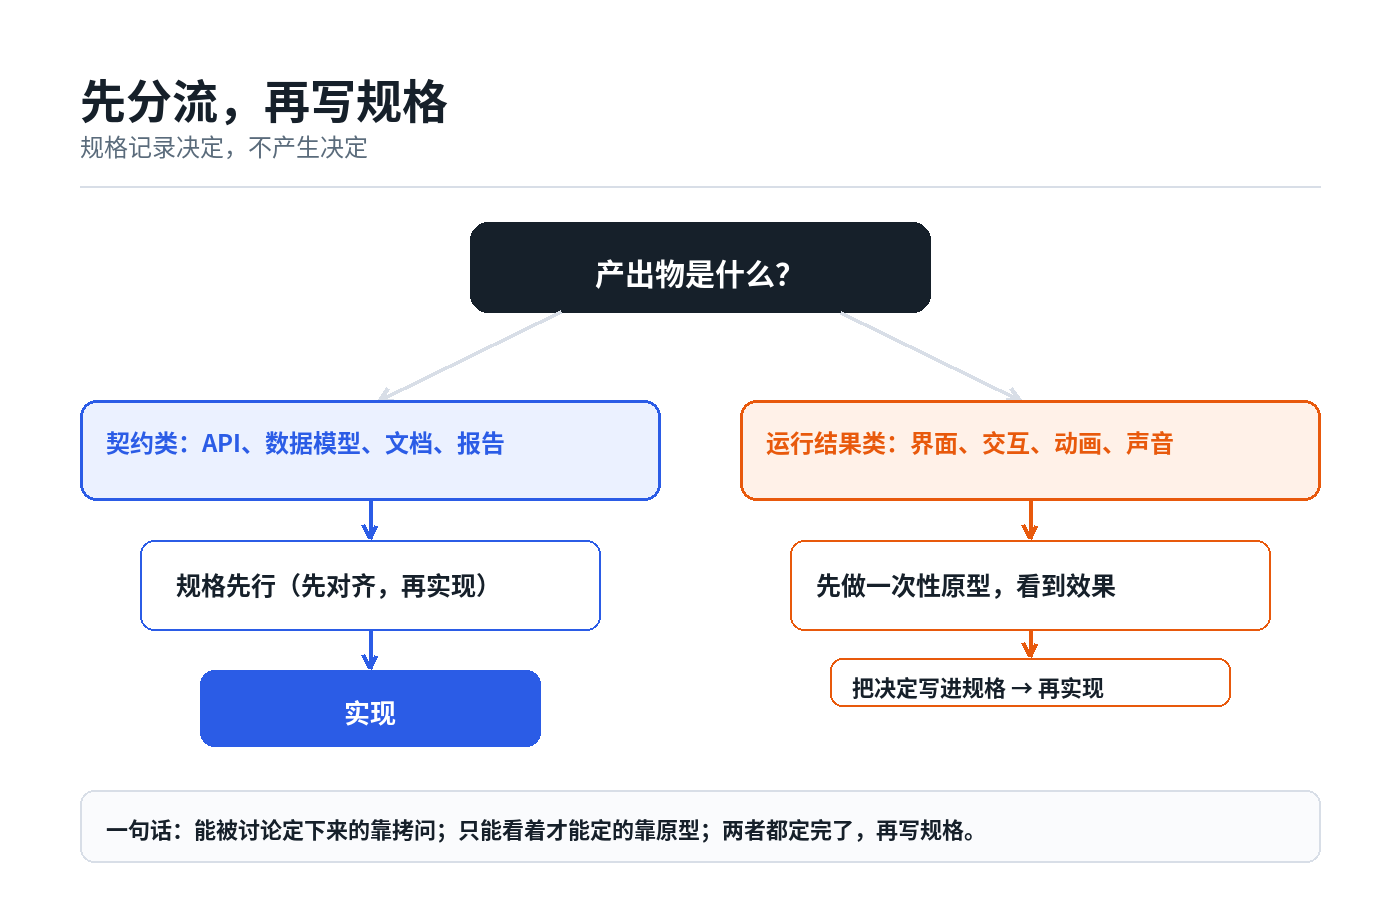
规格的正确定位,Matt 仓库里写得很清楚:规格是记录你已经做出的决定,它不是做决定的地方。
所以完整的顺序是五步:拷问 → 原型(只对谈不拢的)→ 规格 → 工单 → 实现。
一句话记住
能被讨论定下来的,靠拷问;只能看着才能定的,靠原型;两者都定完了,再写规格。
五、信任阶梯:把「手」放出去,一级一级来
前两层解决"说什么"和"写什么",第三层解决"什么时候让它自己干"。
这个概念来自 Lauren Tan(推特名 poteto,Grok Bot 工程师,pstack 作者)。她一个人带一批 agent,公开自述做到过每月两千到两千五百个 PR 进生产——不是什么神奇工具,是把"信任"拆成了台阶:
- 微观管理单个 agent:每一步都人确认。
- 给验证工具,让它自己闭环:能做验证的 CLI、能记住功能地图(Feature Map)、能在云端跑起来。
- 多个 agent 并行:每一级的验证都能独立复跑,才敢开并行。
- agent 自主合并 PR:人睡觉时继续干活,早上采样审查。
每一级台阶的通行证,都是同一个东西:验证能力。
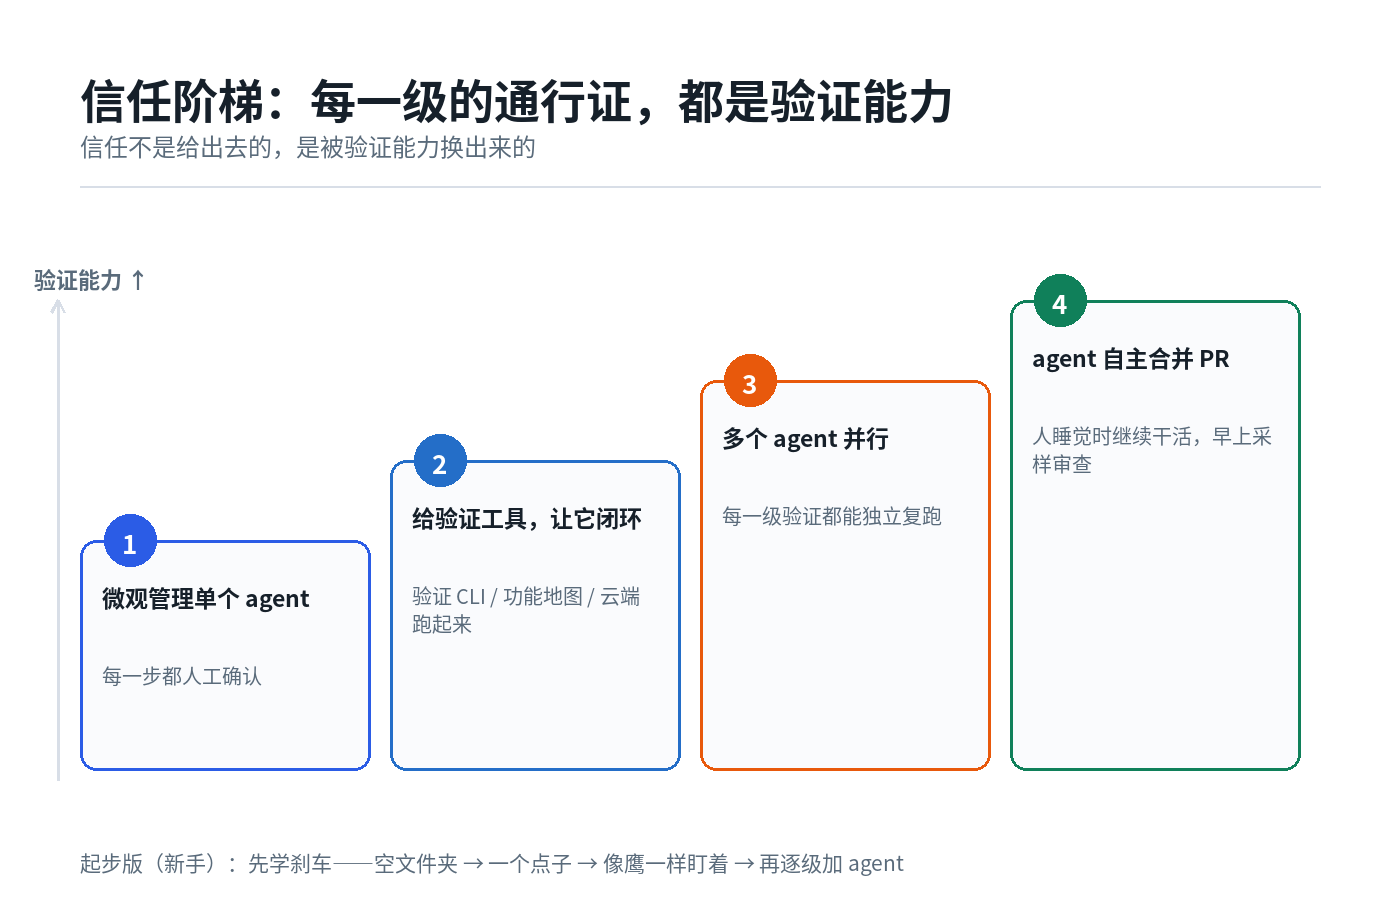
信任不是态度问题,是基础设施问题。你敢不敢放手,取决于它能不能自己证明自己是对的。
Matt 给了一个更适合新手的版本,比喻很准:学开车,先学刹车。
- 打开模型,随便给几个提示词;
- 开一个空文件夹,配 VS Code,做一个自己的小点子(要有理由,反馈回路才强);
- 像鹰一样盯着它,看懂它做的每件事、看懂工具给你的每条信息;
- 什么时候开始信任它,什么时候再加第二个 agent、写第一个技能、连第一个数据源;
- 最后才是把它放进日常:他举的例子是对着手表口述一句话,agent 把它变成待办事项。
新手用第一套(放权版)会跳级;组织用第二套(起步版)会低效。两套的分工,其实是同一个阶梯的起点和终点。
六、三层串起来看
| 层 | 管什么 | 不管会怎样 | 最小动作 |
|---|---|---|---|
| DDD 词 | 说的是不是同一件事 | 规格越详细,错得越整齐 | 一份 CONTEXT.md |
| SDD 纸 | 决定有没有落下来 | 实现时漂移,返工 | 先分流,再写规格 |
| 信任阶梯 手 | 什么时候让它自己干 | 人肉瓶颈,或者翻车 | 先建一条能自动跑的验证 |
顺序不能颠倒:词 → 纸 → 手。
先把词对齐,写下来的决定才是对的;先把决定写下,放出去的手才不会漂;先让验证能跑,放权才不是赌博。
七、今天就能做的五件事
☐ 1. 给你手上正在做的项目,列十个名词(只列名词)。 ☐ 2. 每个词写三行:定义 / 关系 / 不要叫什么。 ☐ 3. 存成 CONTEXT.md,让 agent 每次开工先读它。 ☐ 4. 下次写规格前,先问一句:这是「契约」还是「运行结果」? ☐ 5. 放权之前,先建一条能自动跑的验证——哪怕只是一个能点开页面、截一张图的脚本。
成本账:第 1-3 项一个下午,第 4 项一分钟,第 5 项看你的项目复杂度。都不花钱。
最后
三句话收尾:
AI 不会读心,它只会读你写给它的词。规格只能记录决定,不能替你做决定。信任不是给出去的,是被验证能力换出来的。
如果你在写代码——从那份词汇表开始,比再学一个框架有用。 如果你在带团队——先统一词,再谈流程,最后才谈放权。 如果你刚上手——先学刹车,别急着上高速。
这三层不是三个工具,是一条顺序。顺序对了,AI 才真的替你干活。
评论区见,我每条都看。
—— 时空猫