一个数量级是怎么省的:DeepSeek-V4 的百万上下文三件套
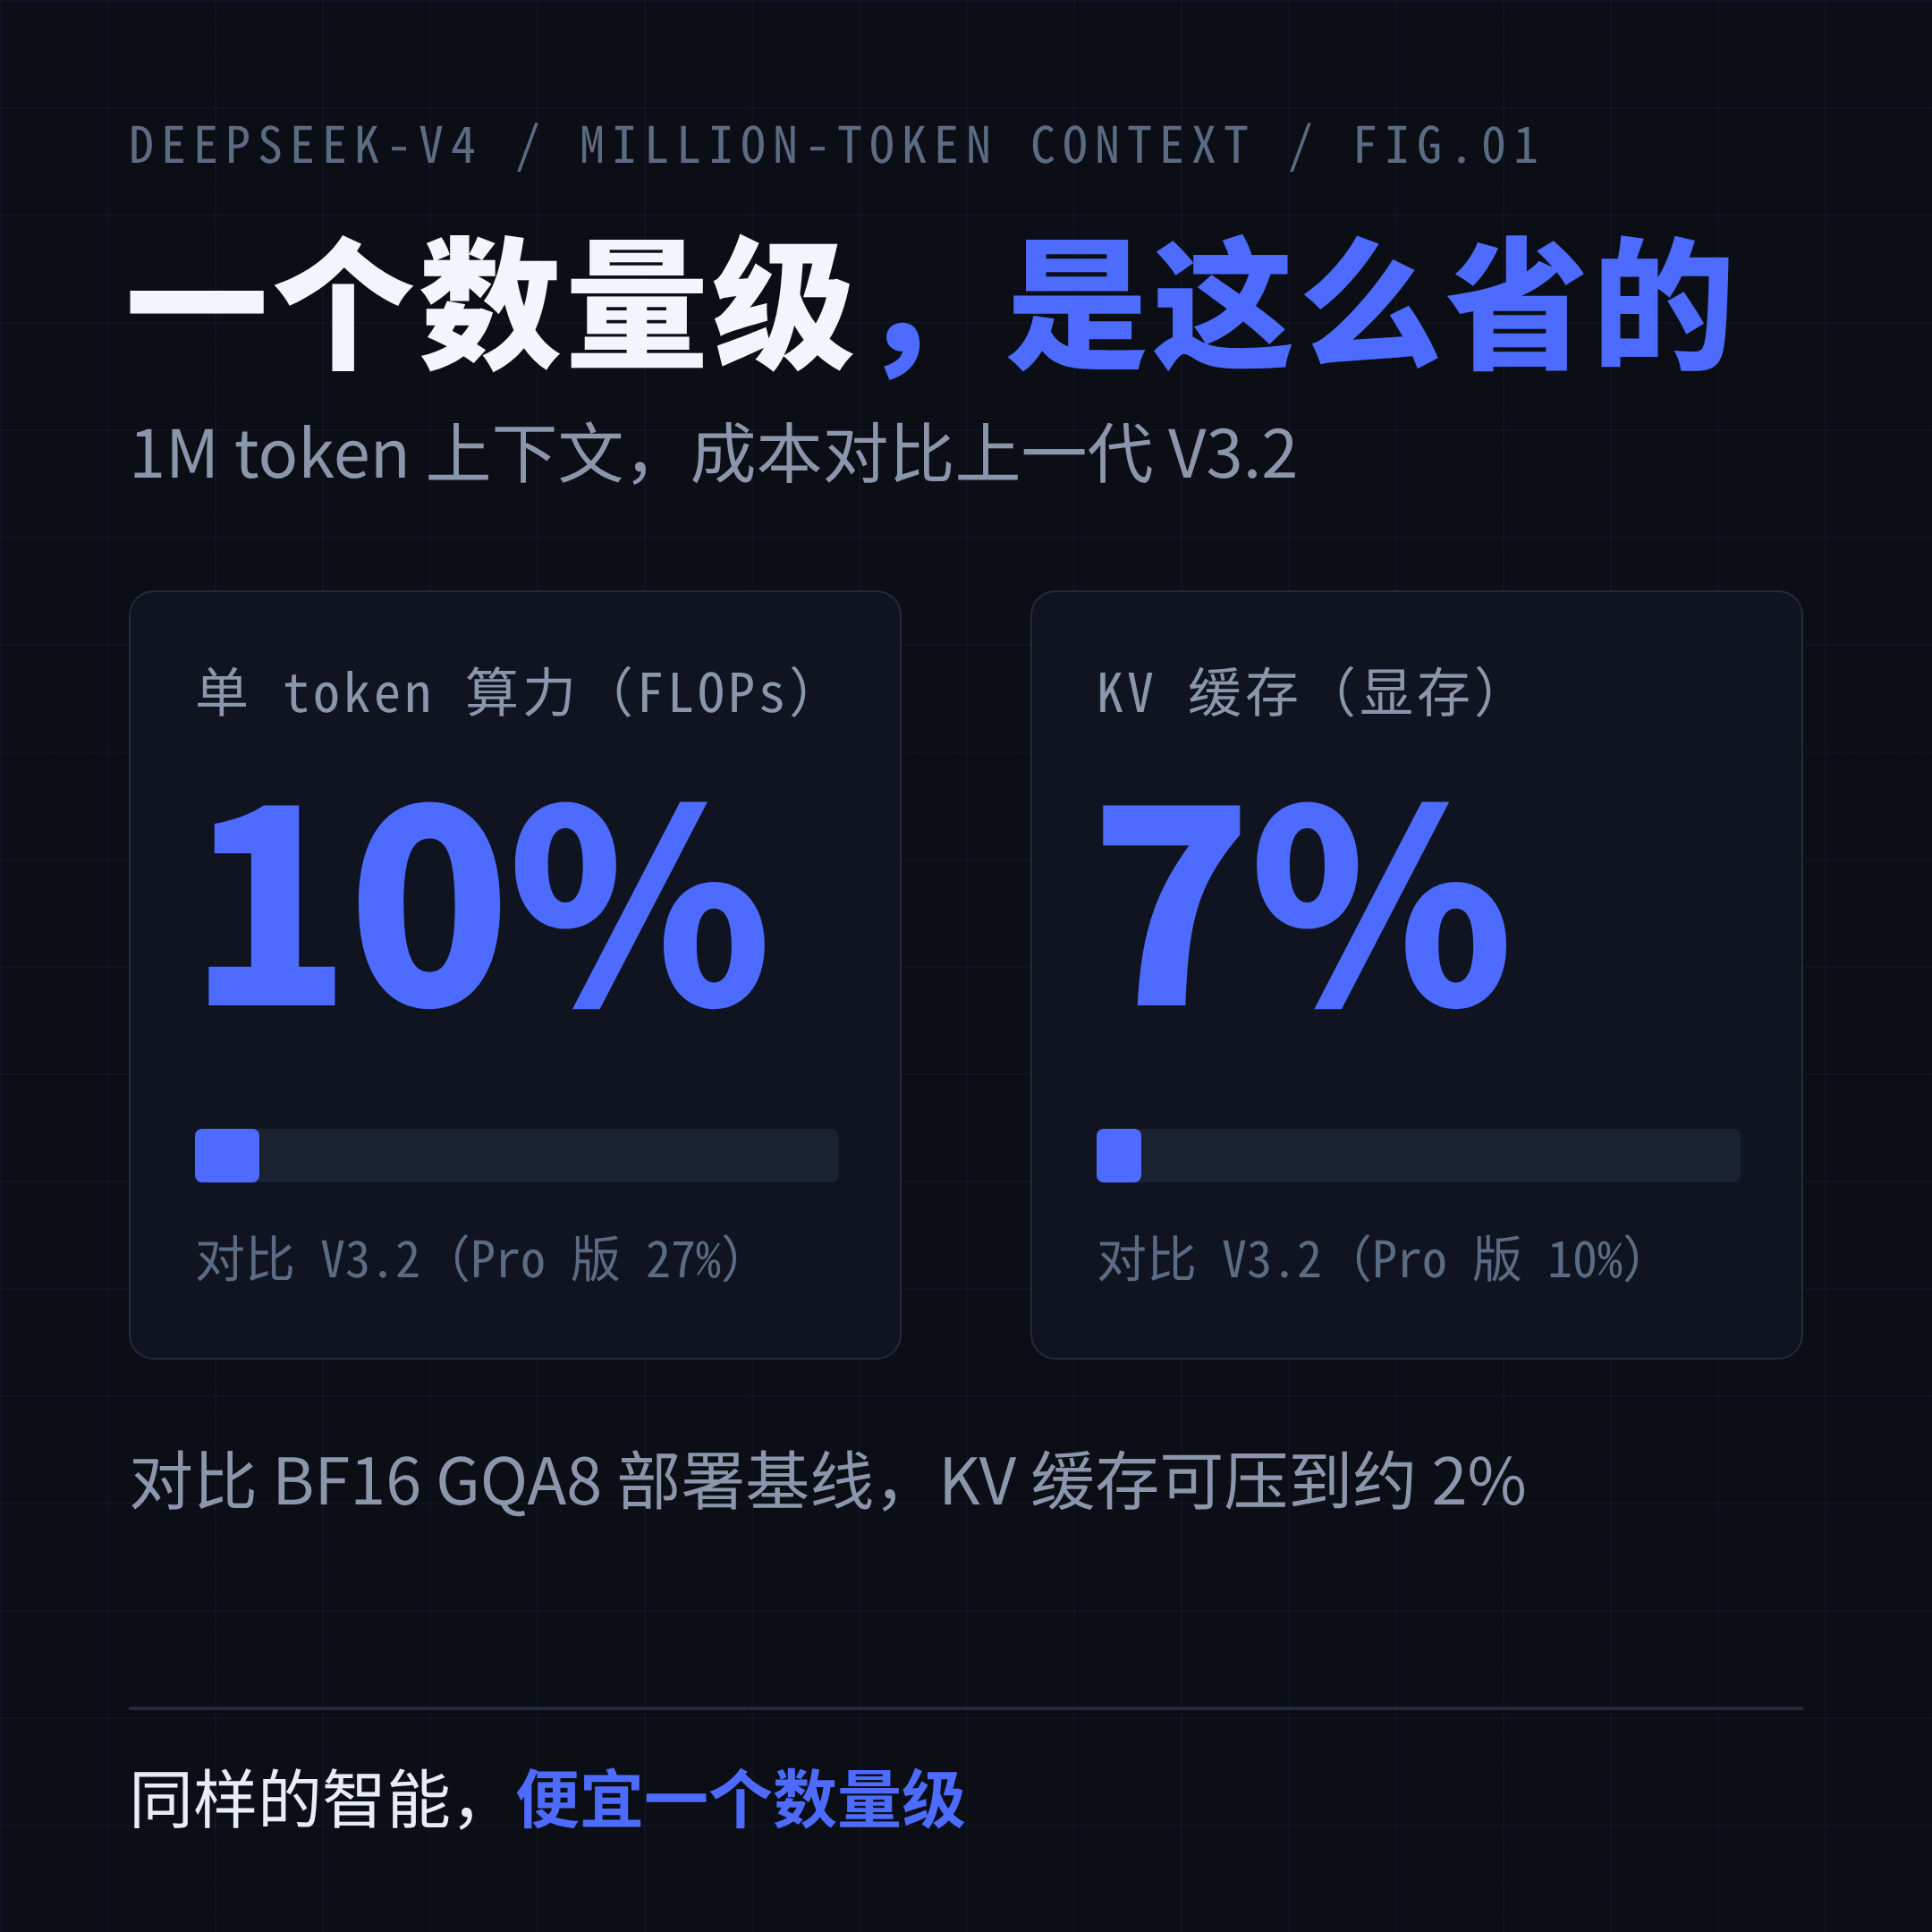
如果只看一个数字,看这个:
同样是 100 万 token 的上下文,V4 的 Flash 版每生成一个 token 的算力只有上一代 V3.2 的 10%,KV 缓存只有 7%;Pro 版是 27% 和 10%。
「把成本压下一个数量级」听起来像营销词。但 V4 的技术报告(arXiv:2606.19348)把这个数拆成了三件具体的东西。这篇把它们一件件拆开——你会发现三件套里真正「省钱」的只有两件,第一件是让另外两件能安全上车的。
一、先搞清:百万上下文到底贵在哪
大模型处理长文本有两笔账,而且性质不同。
第一笔是算力账。 注意力机制里,每生成一个新 token,都要「回看」前面所有内容并计算相关性。文本越长,每次回看的量越大——计算量随长度呈二次方增长。上下文从 10 万涨到 100 万,回看的量涨 10 倍,计算量却涨约 100 倍。
第二笔是显存账。 每个 token 的 key/value 都要存下来(就是常说的 KV 缓存),显存占用随长度线性增长。100 万 token 的上下文,光是缓存就能把一张卡的显存吃干。
两笔账叠在一起,就是「百万上下文很贵」的全部原因。V4 的三件套里,两件冲着这两笔账去,一件负责兜底。
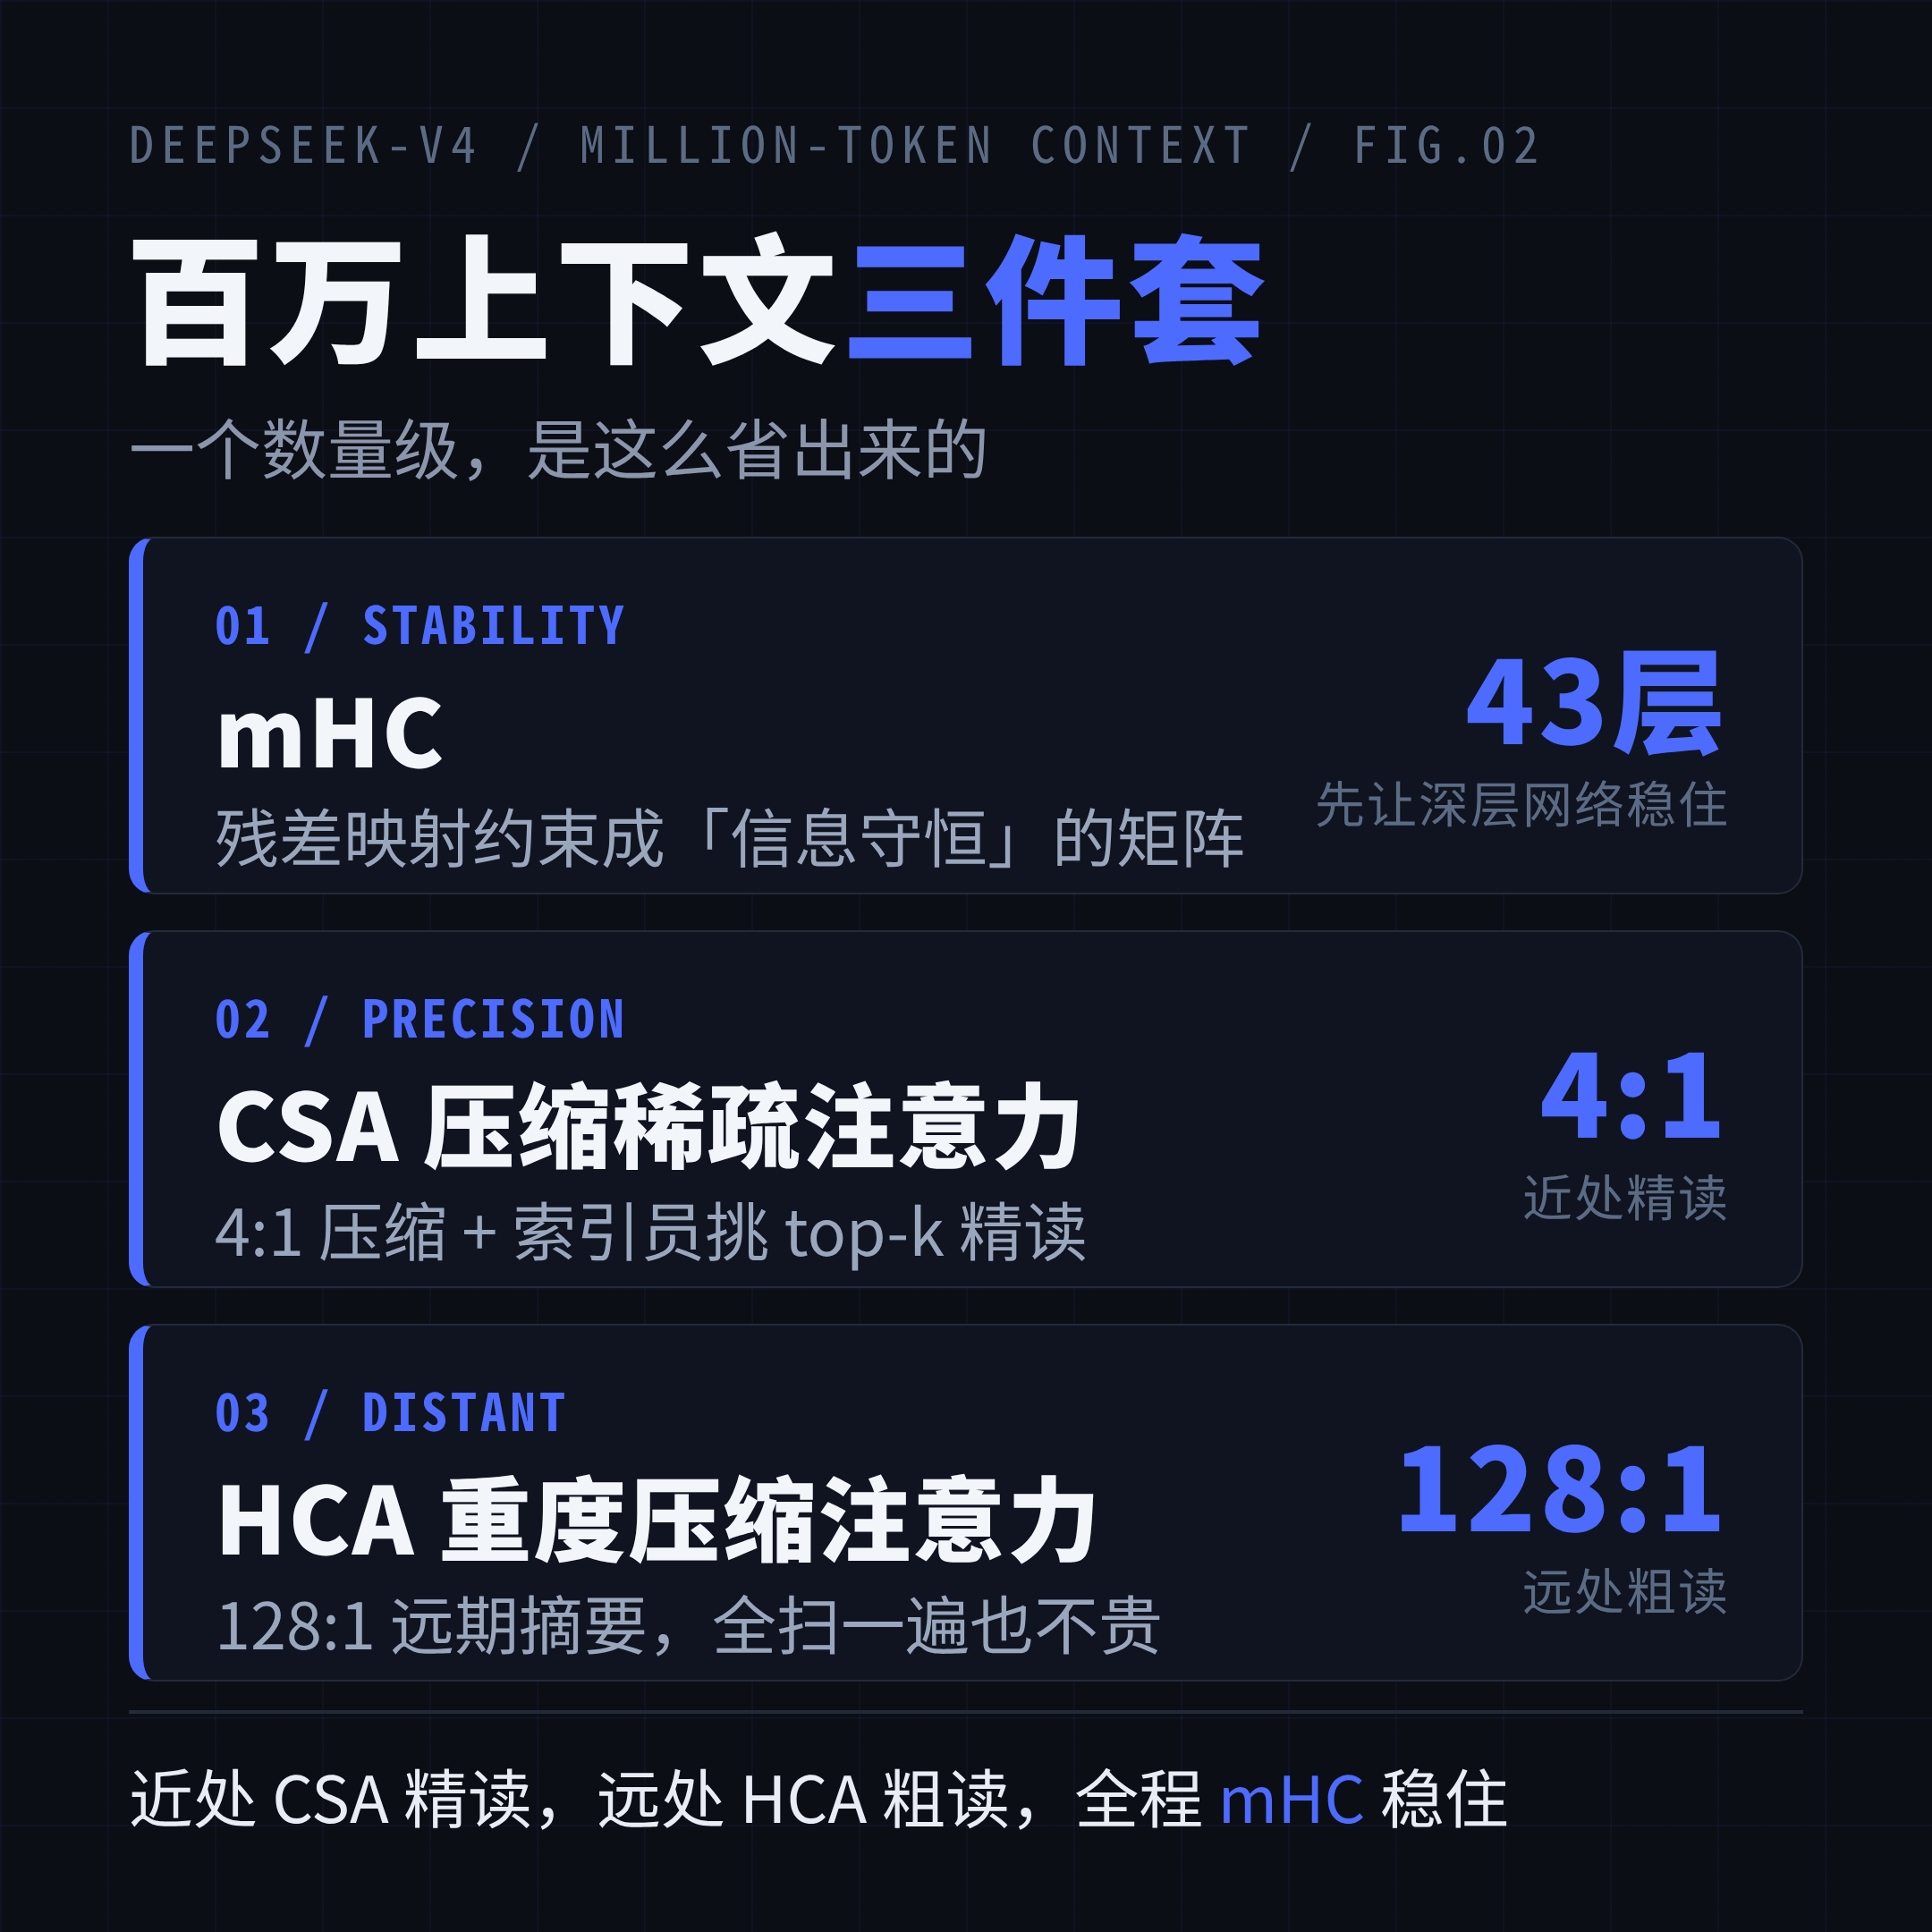
二、第一件:mHC——先让 43 层的网络「稳住」
先说看起来最不像省钱的那件:mHC(流形约束超连接)。
它解决的是深层网络的训练稳定性。V4 的 Flash 有 43 层、Pro 有 61 层,层数一多,信号在层间传递时容易放大或衰减,训练容易「飘」——数值不稳定,损失曲线乱跳。
mHC 的做法很几何:把层间残差连接的映射矩阵,约束到双随机矩阵流形上——这个矩阵的每一行、每一列加起来都等于 1,且所有元素非负(数学上叫 Birkhoff 多面体)。翻译成人话:信息在层与层之间传递时,「加起来」的总量守恒,既不放大也不缩小。
配套还有两个细节:用 Sinkhorn-Knopp 算法把矩阵迭代拉回约束(迭代上限 20 次);这样的矩阵谱范数不超过 1,意味着传递过程是「非扩张」的——信号不会在层间被放大成噪声。
一句话总结:mHC 不省算力,它省的是「训练失败的代价」。没有它,后面两个压缩机制在几十层深度上根本跑不稳。
三、第二件:CSA——每 4 个 token 压成 1 个,再训练一个「索引员」
真正开始省钱的,是 CSA(压缩稀疏注意力)。它把两件事合在一起做。
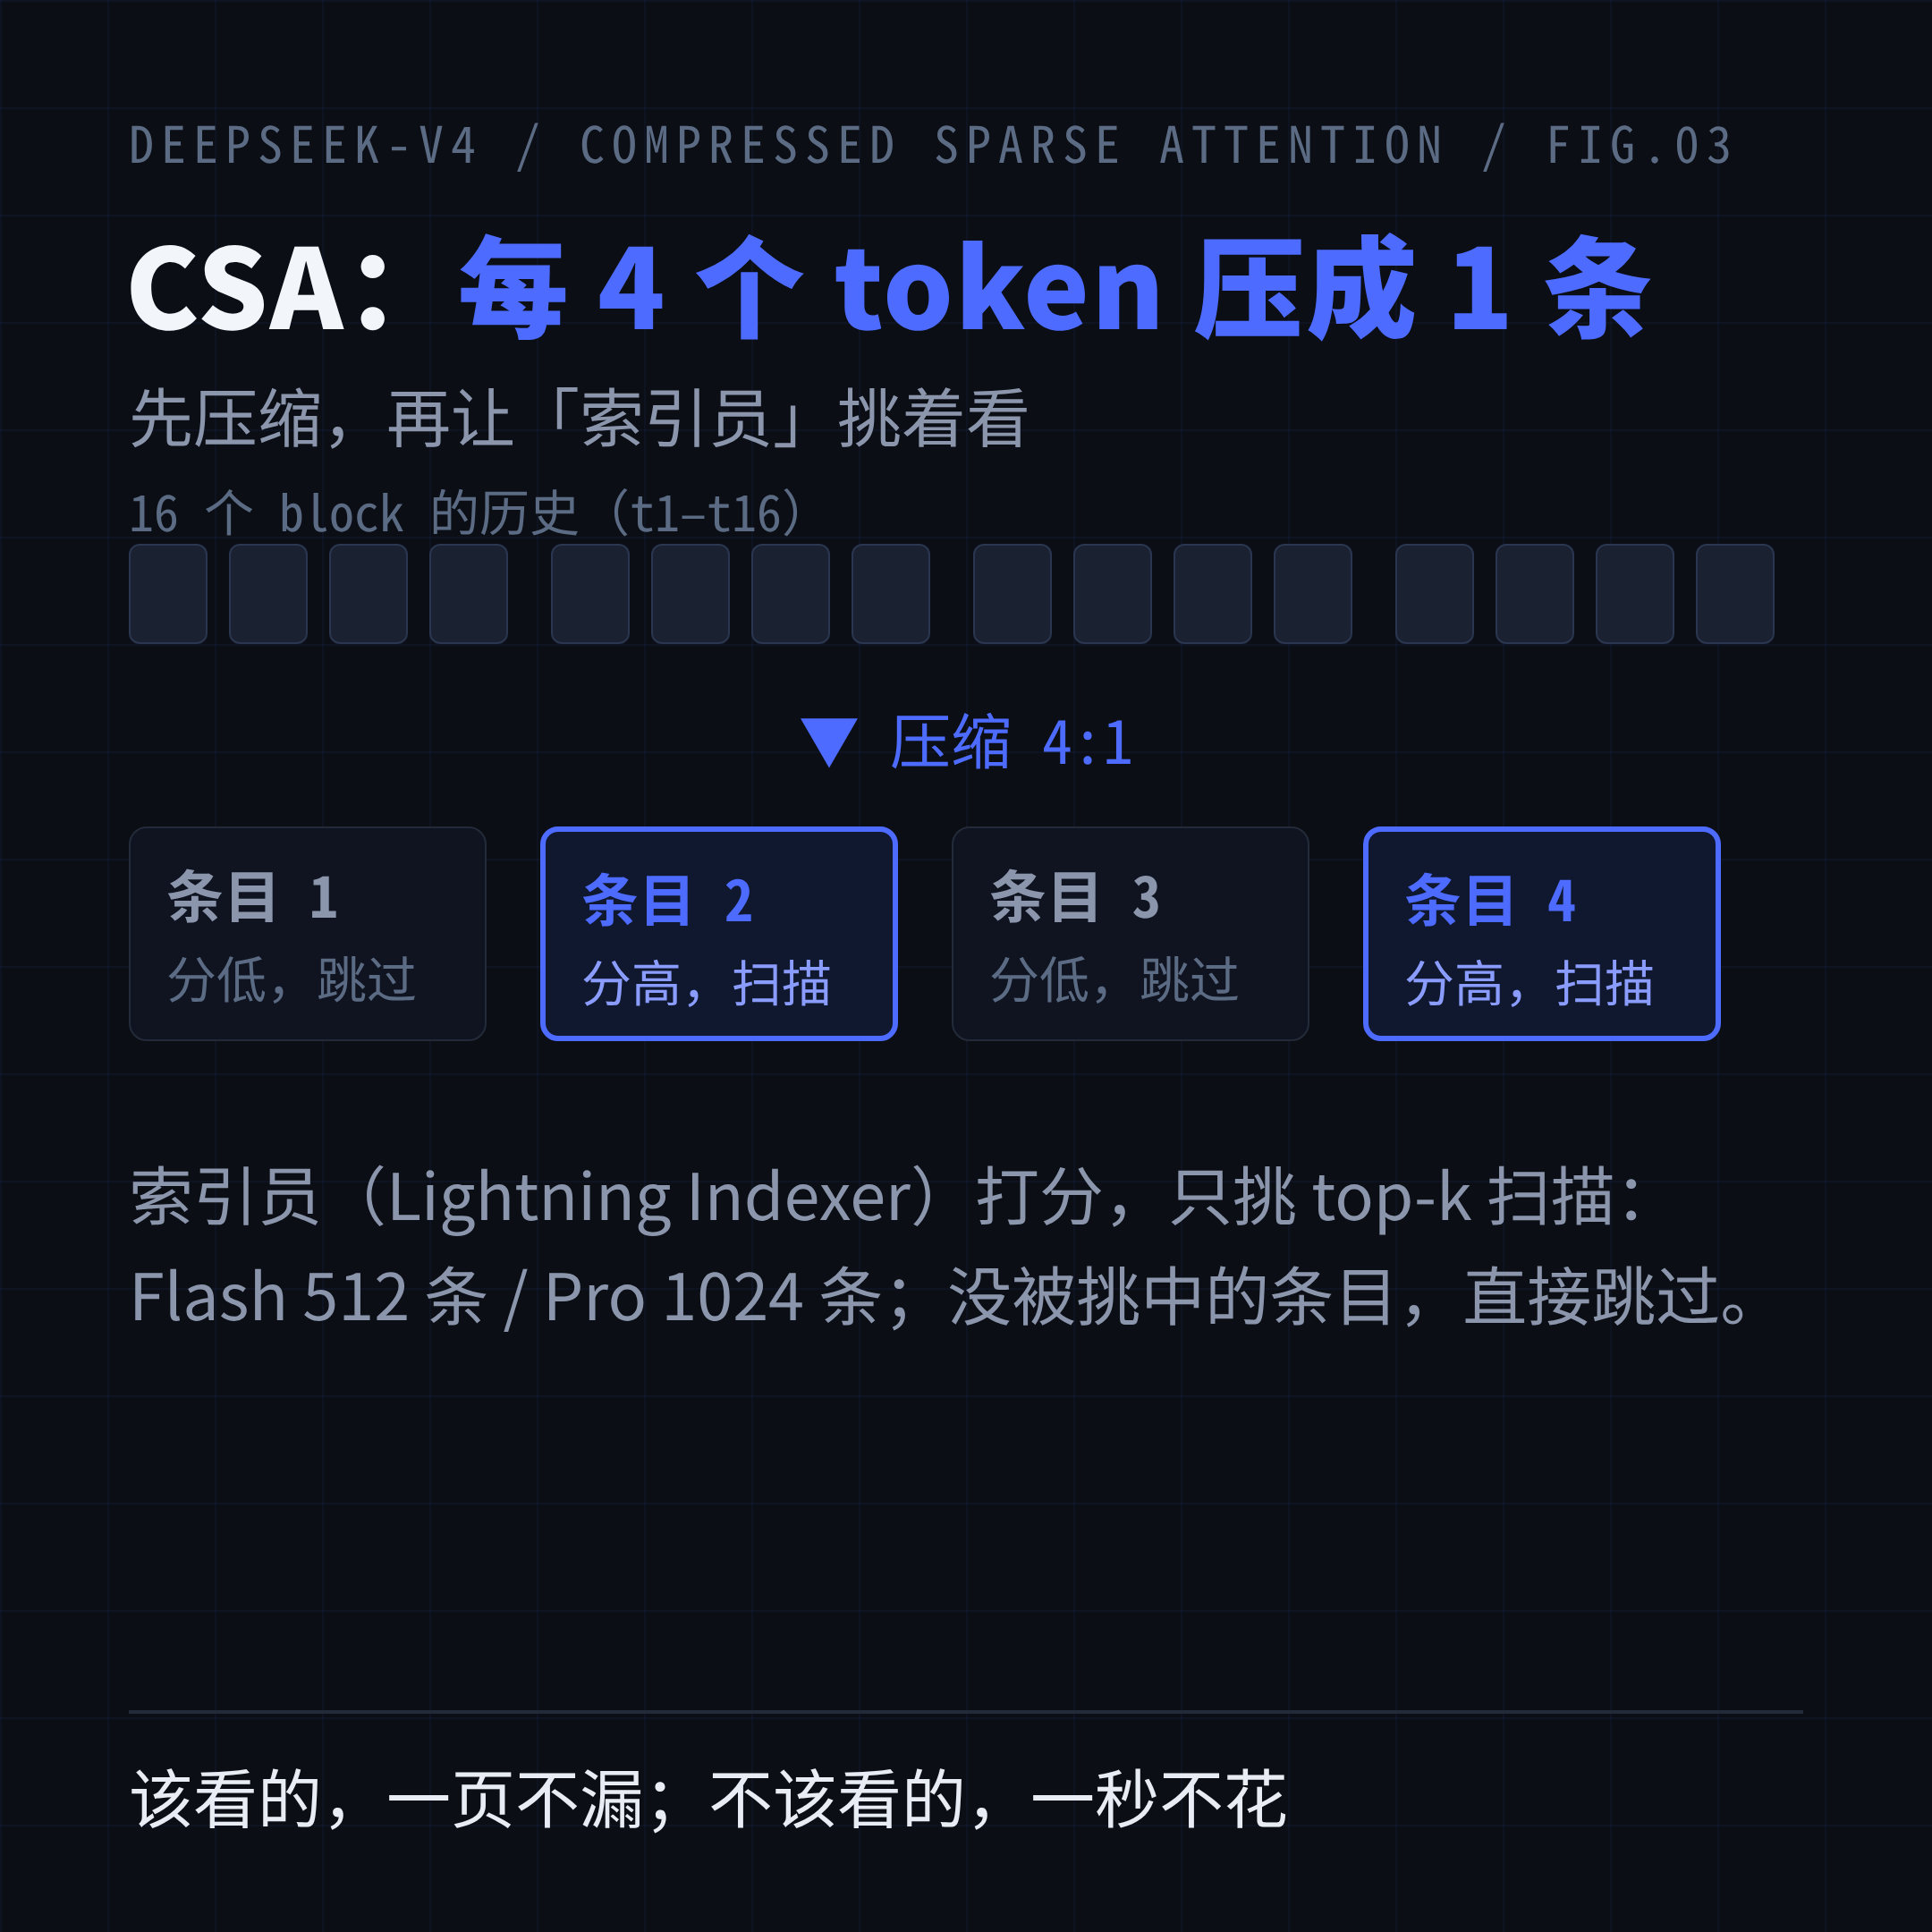
第一步,压缩。 每 4 个 token 压成一个「压缩条目」(论文里 m=4)。原来 16 个 block 的历史,压完只剩 4 个。
第二步,选择性扫描。 光压缩还不够——如果每个新 token 还是要扫过所有压缩条目,省得有限。所以 V4 训练了一个「索引员」(Lightning Indexer):它用低秩 query 给每个压缩条目打分,只挑相关性最高的 top-k 个来扫。Flash 挑 512 个,Pro 挑 1024 个。
举个例子:前面有 16 个 block 的内容,压缩成 4 个条目。索引员看一眼,判断只需要第 2、4 个——那就只扫这两个,第 1、3 个直接跳过。该看的地方一页不漏,不该看的地方一秒不花。
这里有个反直觉的点:这个「索引员」不是写死的规则,是训练出来的。它得学会判断「当前这个词该去历史里的哪里找线索」——这本身就是一种需要学习的检索能力。
KV 缓存本身也做了低精度处理:RoPE 维度用 BF16、其余用 FP8,索引员用 FP4——这也是「缓存只有 7%」的另一半原因。
四、第三件:HCA——128:1 的「远期记忆」
CSA 管的是「精读」,HCA(重度压缩注意力)管的是「粗读」。
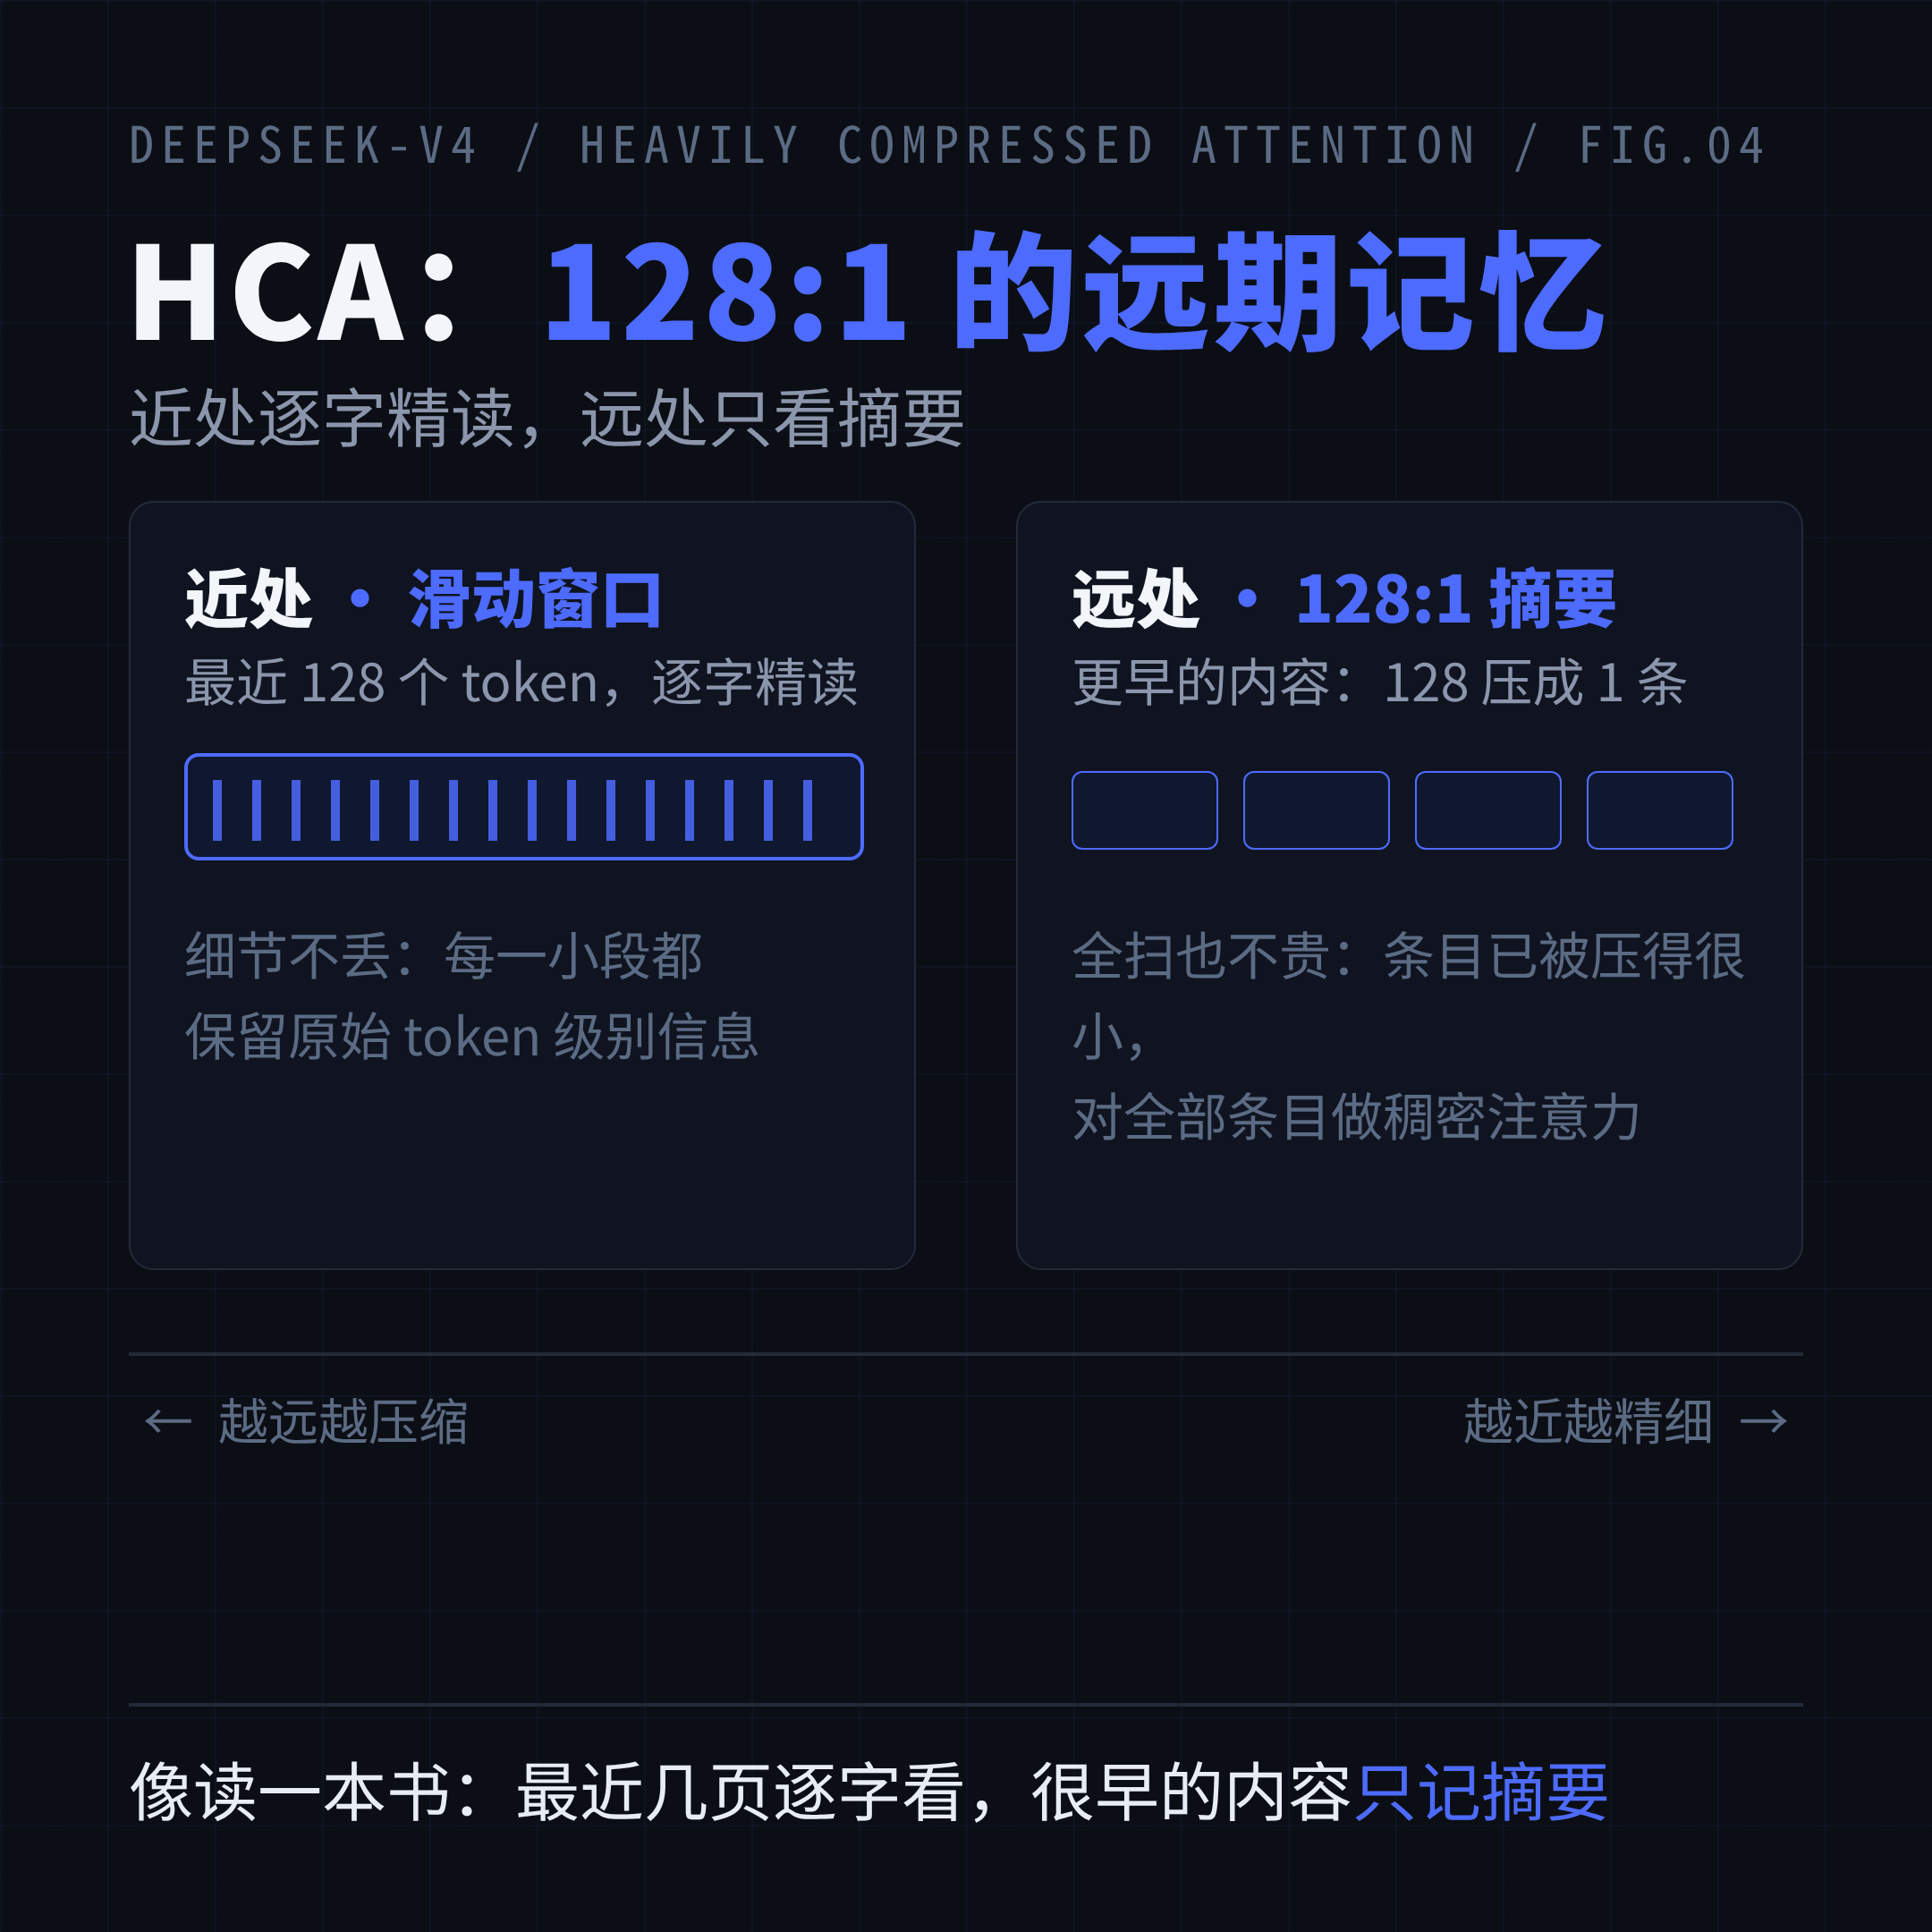
它把 128 个 token 压成 1 个压缩条目(m′=128)——压缩率是 CSA 的 32 倍。但它对全部压缩条目做稠密注意力:不挑不选、全部扫一遍。因为条目已经被压得很小,全扫一遍也不贵。
两者配合的读法很像人读书:
- 近处:滑动窗口(窗口 128 个 token)逐字精读——最近的内容细节不能丢;
- 远处:HCA 的 128:1 摘要粗读——很久以前的内容,记住「大概讲了什么」就够了。
这个结构还有一个细节叫 attention sink——保留对序列开头位置的固定注意力,防止长序列后期「忘了怎么开头」。这些都是长上下文模型的经典工程问题。
五、三件套怎么拼:43 层里的排布
Flash 版的 43 层是这样排的:
- 前 2 层:纯滑动窗口注意力(先打好近处基础);
- 之后:CSA 层和 HCA 层逐层交错(压缩比序列 4、128、4、128……);
- 前 3 个 MoE 层用 Hash routing(另一条线的优化,这里不展开)。
三种机制各管一段:近处 CSA 精读、远处 HCA 粗读、全程 mHC 稳住。再加上 Muon 优化器和整套低精度训练体系,才是「一个数量级」的完整配方。
六、便宜了,然后呢:战果和边界
省钱的另一面是能力有没有打折。V4 报告里的成绩单:
- SimpleQA 85.9——开源模型里的 SOTA(对比 Opus-4.6 的 45.3、Gemini-3.1 的 76.4);
- Codeforces 3206——人类选手前 23 名的水平;
- Putnam-2025 120/120——美国大学生数学竞赛,满分;
- MRCR 1M 检索接近 100%——100 万 token 里的信息检索,基本找得到。
但边界也要说清楚:GPQA 84.4,仍低于 Gemini-3.1 的 93.0。论文自己也承认,知识类任务仍落后 Gemini-3.1-Pro,检索类仍落后 Claude Opus 4.6。所以准确的说法是:部分超越、部分追平、个别仍落后——不是「全面超过谁」。
七、更值钱的是第二幕:V4 → V4.1 的工程复利
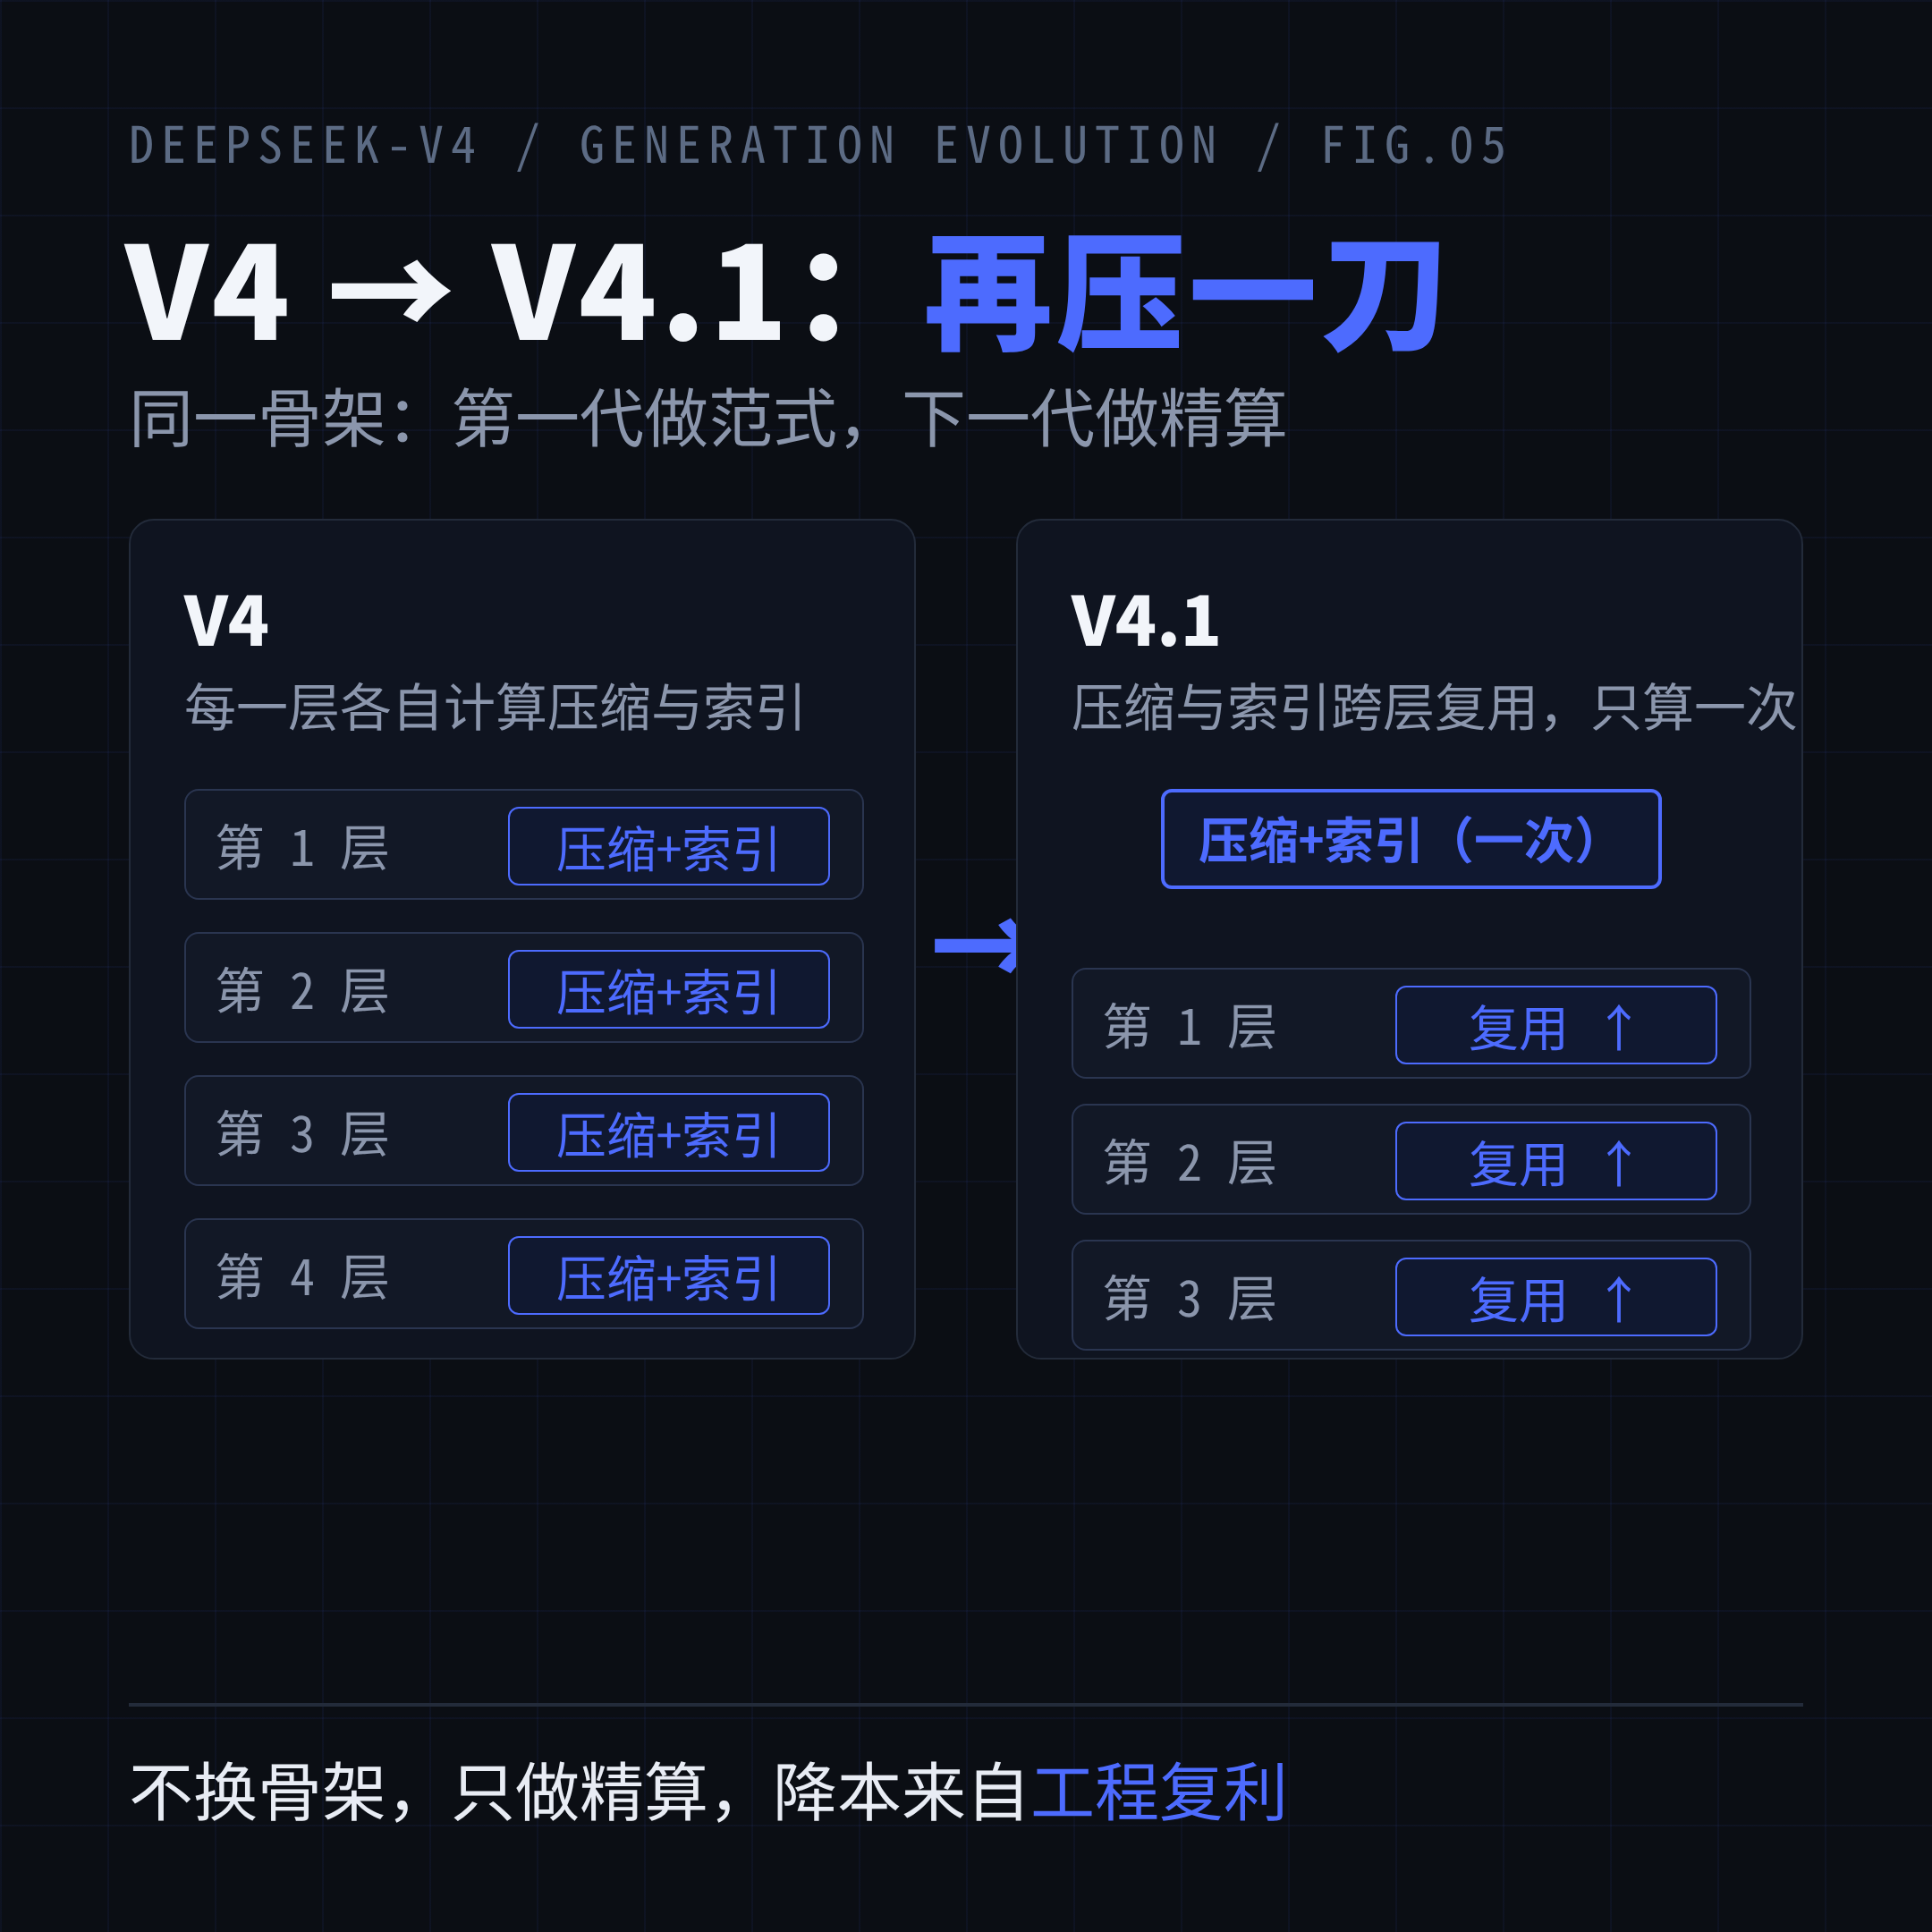
这套三件套最值得注意的地方,是它没有停在 V4。
V4 里,每一层都要各自计算自己的压缩和索引。到了 V4.1,这套机制被改成跨层复用:层与层之间不再重复算同样的东西,直接复用。
同一个骨架,不做架构级重写,只做「精算」——再把成本往下压一刀。这就是 DeepSeek 这条线的模式:第一代把新范式做出来,下一代把同一个范式榨到极致。对跟踪这条技术路线的人来说,「不换骨架、只做精算」本身就是信号:框架级范式短期不会变,降本来自工程复利。
八、为什么这个时间点值得看
把这篇放进当下的大背景里,多了一层意思。
2026 年下半年,内存和存储正在涨价周期里。对做长上下文应用的人来说,这是个坏消息——显存和存储的成本被推高。而 V4 这份报告给的是另一条路的对冲:不靠采购谈判,靠算法把同样的上下文压到十分之一的成本。
算力侧的账也一样:百万上下文 + 缓存压到上一代的 7%–10%,意味着「长上下文」从「demo 里能跑」变成「账上算得过来」。
用一句话总结这份报告的姿态:它换来的不是「更聪明」,而是「同样的智能,便宜一个数量级」。
数据来源说明:本文全部数字对照 DeepSeek-V4 技术报告(arXiv:2606.19348)原文与官方开源的 config.json 逐项核对;「10% / 7%」等比例均为 1M 上下文场景下对比 V3.2 的口径,以论文原文为准。
评论区见,我每条都看。
—— 时空猫