世界模型第一次「开口说话」:Genie 4 的三个真进步,和四个还没答的问题
先看一个细节。
沃顿商学院的 Ethan Mollick 拿到内测资格后,只写了一句「一只友好的水獭 NPC 走过来问问题」。几十秒后,街角真的跑出一只穿马甲的水獭,用伦敦腔开口:「打扰一下,旅行者。」
不是字幕,是声音。而且这句话不在任何脚本里——是他写下提示词之后,世界自己长出来的对白。
另一段演示更直观:王家卫风格的香港大桥飙车,后座女孩刚喊完台词,测试者敲进两行字「背景发生爆炸」「毁灭世界的巨型外星触手」。维港天际线当场火光冲天,触手从天砸落,路灯的橘色拖影和女主的表情都没崩。
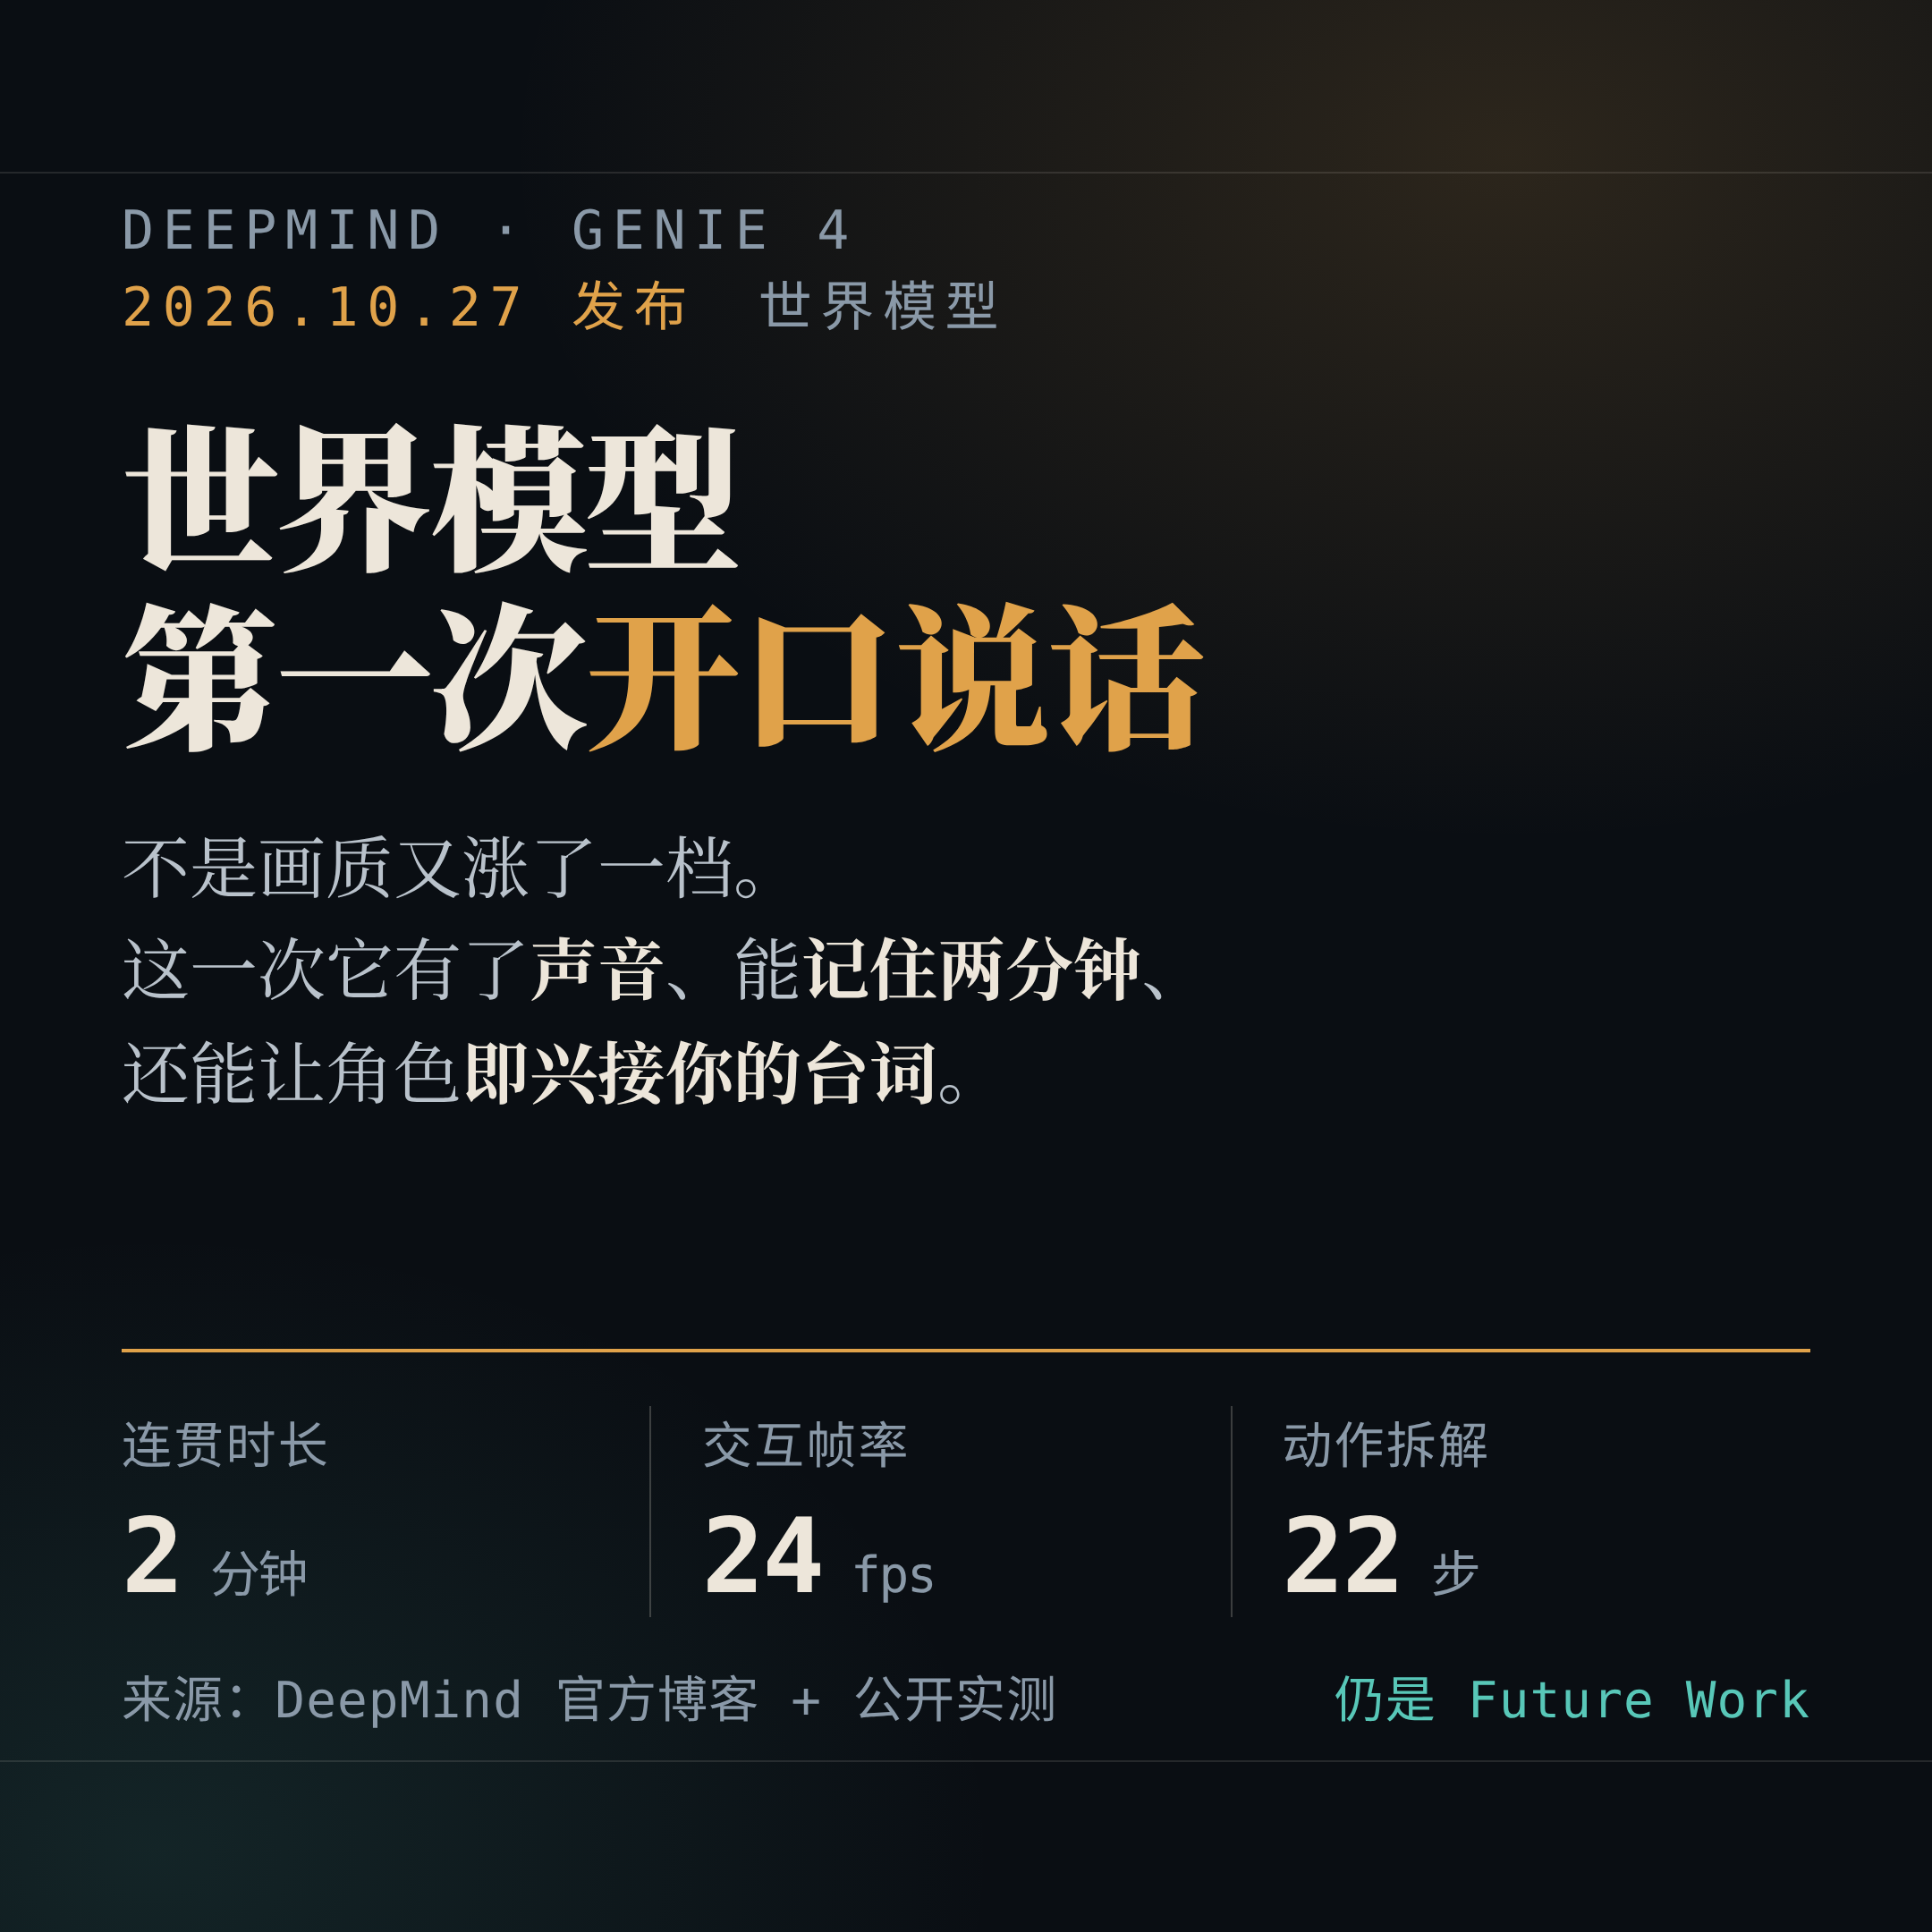
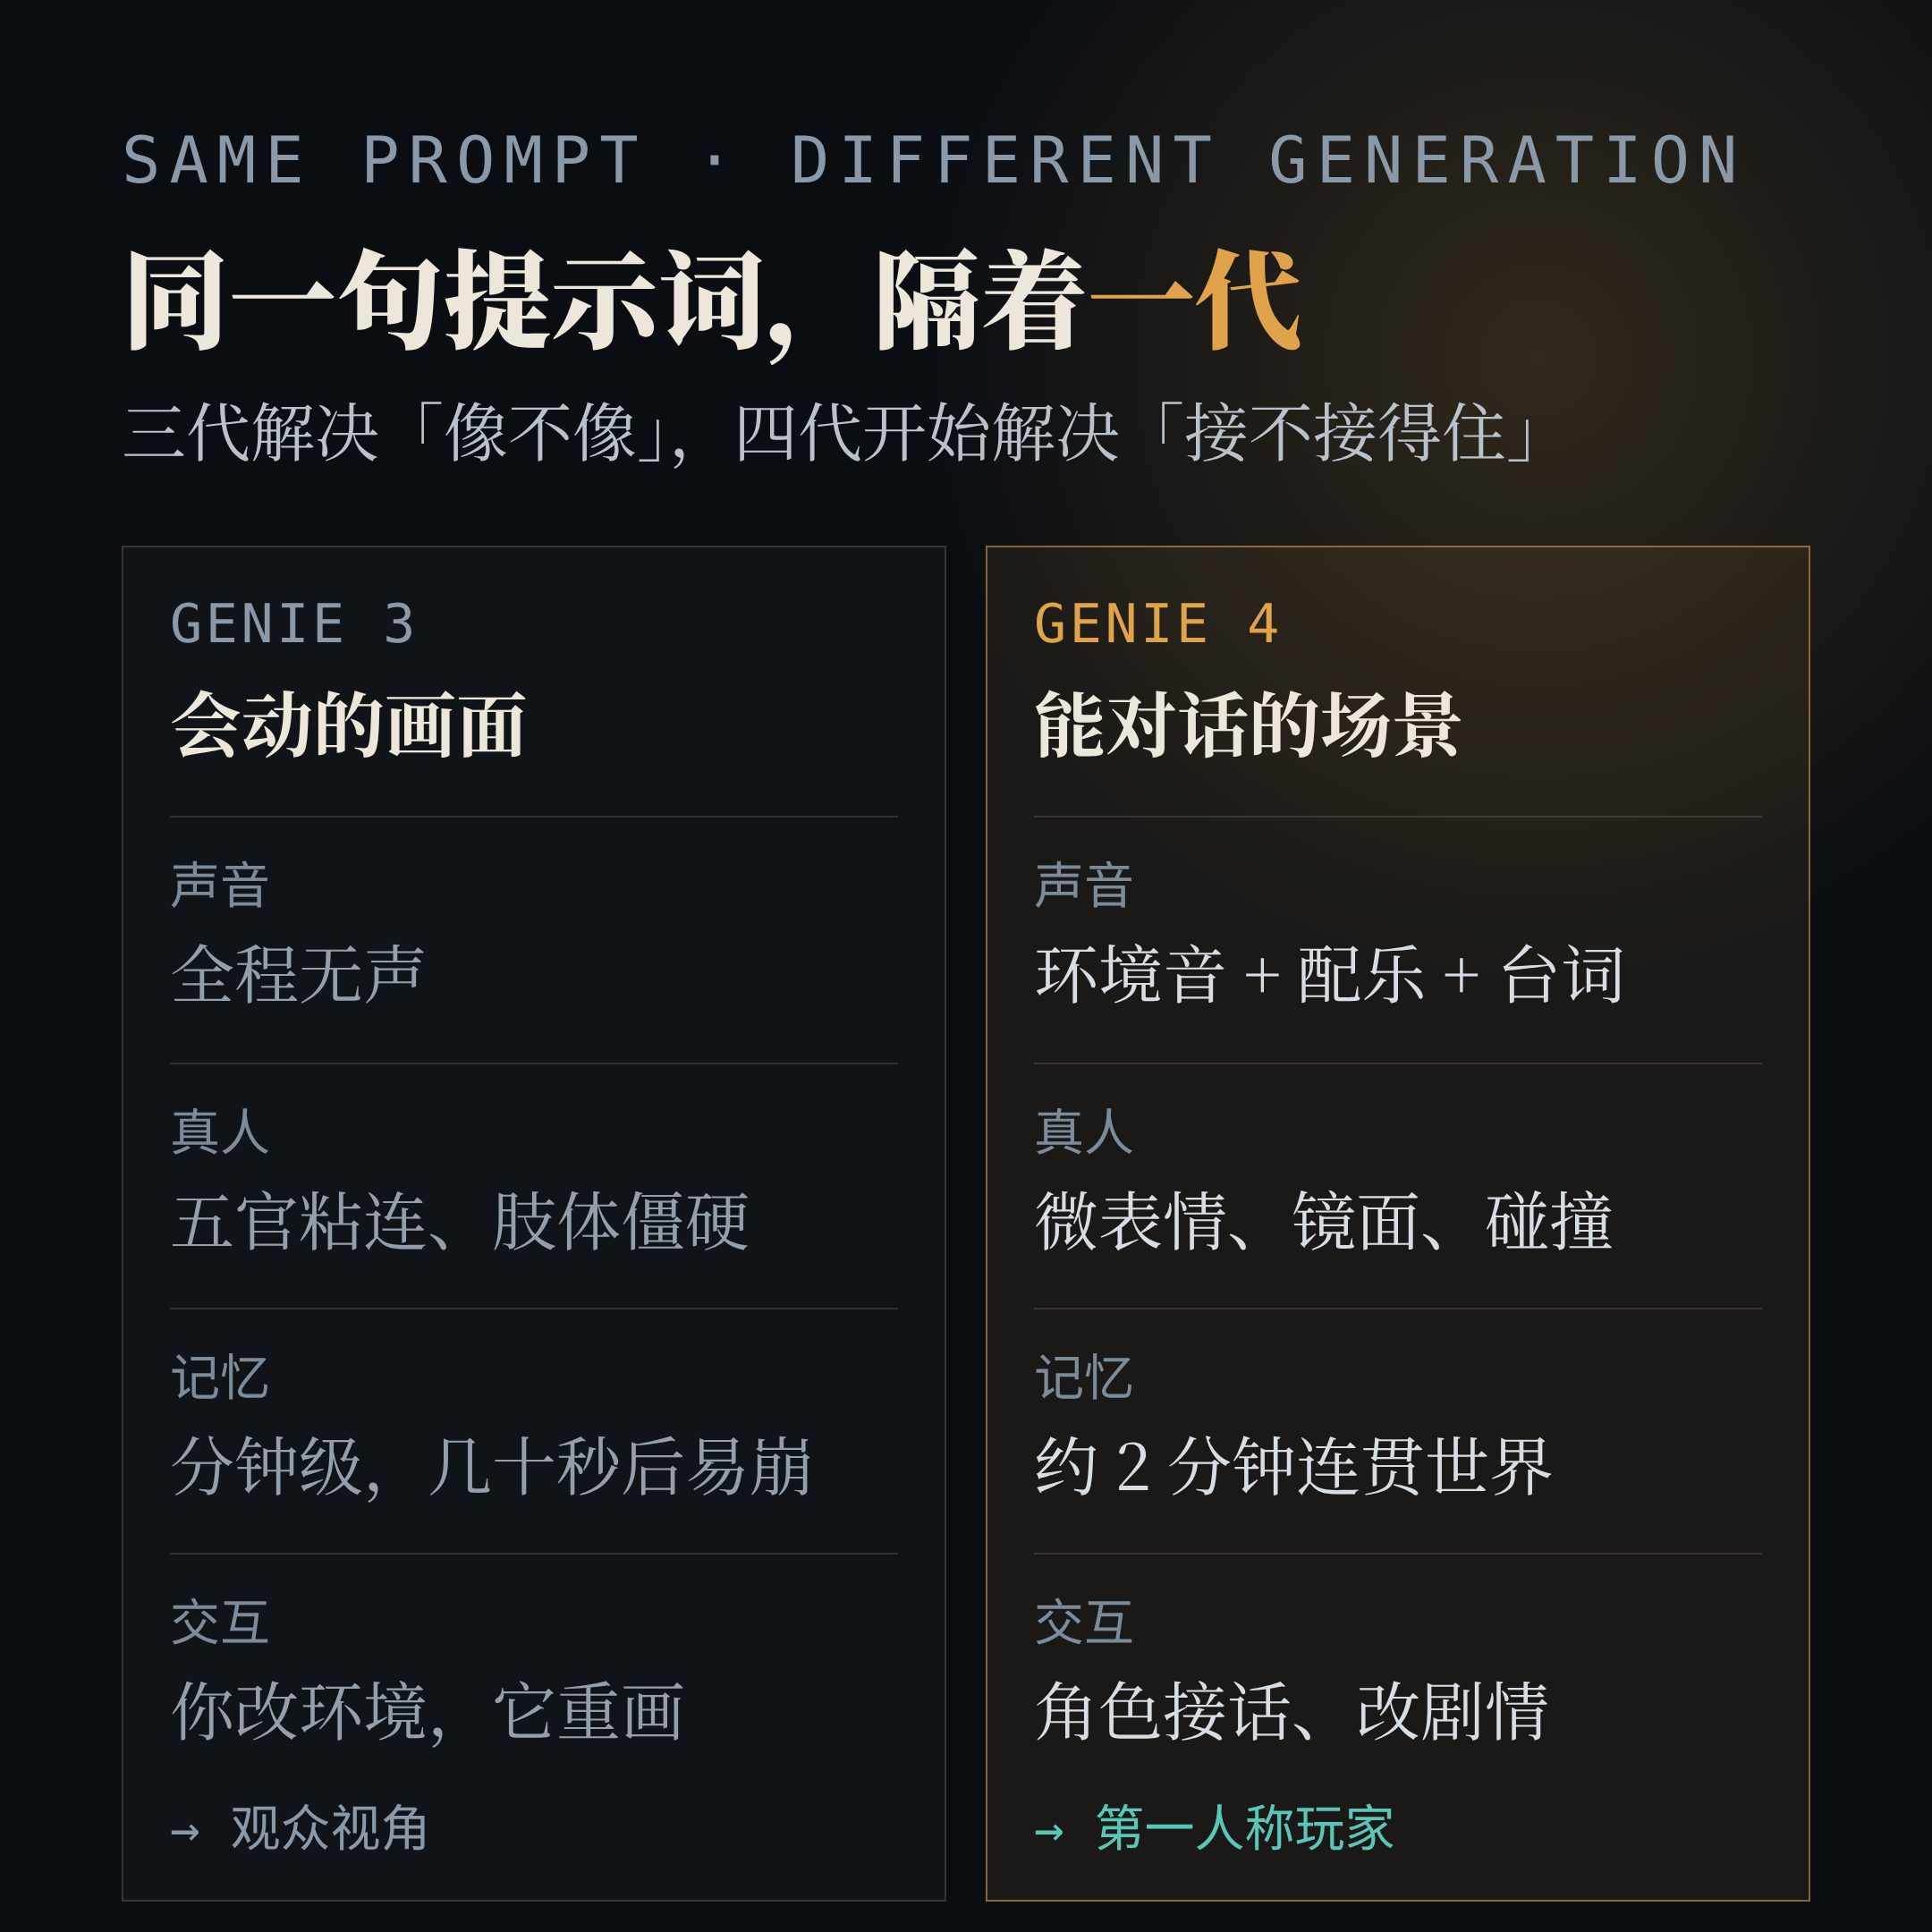
这两段之所以值得看,不是因为画面更漂亮,而是因为它们同时动了两样东西:声音和当下的因果。Genie 3 能把画面动起来,但它是一部默片;Genie 4 开始让世界对你说的话做出反应。
不过,先别急着转发「通用世界模型来了」。这篇想做的,是把这次发布拆成两部分:哪些是真进步,哪些还只是方向。
一、三个真进步,都不是「画质」
1)从默片到有声:声音是最难补的一块
视频模型生成声音,难点从来不是「配一段音」,而是三件事同时成立:
- 音画同步:脚步、碰撞、水流要对得上画面里的动作,差半拍就假;
- 环境层与事件层分开:背景要有持续的环境音,事件发生时要叠加对应的声音;
- 对白要接得住上下文:角色得知道刚才发生了什么,才能即兴回一句合理的话。
Genie 4 第一次把这三层一起做了:官方说它能同步生成环境音与配乐,角色还能根据突发状况即兴交谈。这比「给视频自动配 BGM」难一个量级——后者是贴一条音轨,前者是世界内部产生了声音事件。
2)两分钟连贯 + 24 帧:从「能看」到「能玩」
官方给的数字是:单次连贯世界维持时间翻倍到约 2 分钟,实机画面稳定在约 24 帧/秒。Mollick 自己实测的单帧延迟落在 23.4 到 25.3 帧之间。
这两个数字要分开读:
- 24 帧是交互门槛。低于这个数,你改一句、世界要等半秒才反应,人就会立刻出戏——它就从「游戏」退回「视频」;
- 2 分钟是记忆上限。注意,是「连贯世界」的时长,不是「这个场景永久存在」。两分钟之后,状态会重置或漂移。
也就是说,它现在能撑住一个短镜头、一次单场景互动,但还撑不住一集叙事。这个边界很重要,后面会再讲。
3)人和物开始「符合常识」
第三代生成真人时五官容易粘连、肢体僵硬。第四代借 Gemini Omni 做「现实锚定」,微表情、镜面反射、碰撞反应都上了一档。
这一条听起来像加分项,其实是可用性前提:如果世界里的人一看就是假的,你不会把它当环境,只会把它当特效。世界模型要当训练场,第一关就是「进去之后不觉得是在看动画」。
二、真正的结构变化:给世界模型外挂一个「导演」
比上面三条更值得注意的,是架构上的变化。
纯像素预测有一个老毛病:它能画出下一帧,但记不住「我要干什么」。做几步之后目标就丢了,画面开始章鱼式翻滚。业内的说法是「缺长程逻辑规划」。
Genie 4 的解法不是把模型做得更大,而是在外面挂一个语言模型当导演:
- 你只写一句话:目标进来,不写镜头、不写台词;
- Gemini Flash 当循环导演:实时看画面、把目标拆成步骤、回读生成帧确认哪一步做完了,你一干预它就改计划;
- Gemini 4 Argon 拆动作:把「跟对面下跳棋」拆成 22 步毫米级动作,用文字指令实时注入;
- Genie 4 负责渲染:画面、环境音、台词;Gemini Omni 负责让物理和人物符合现实常识。
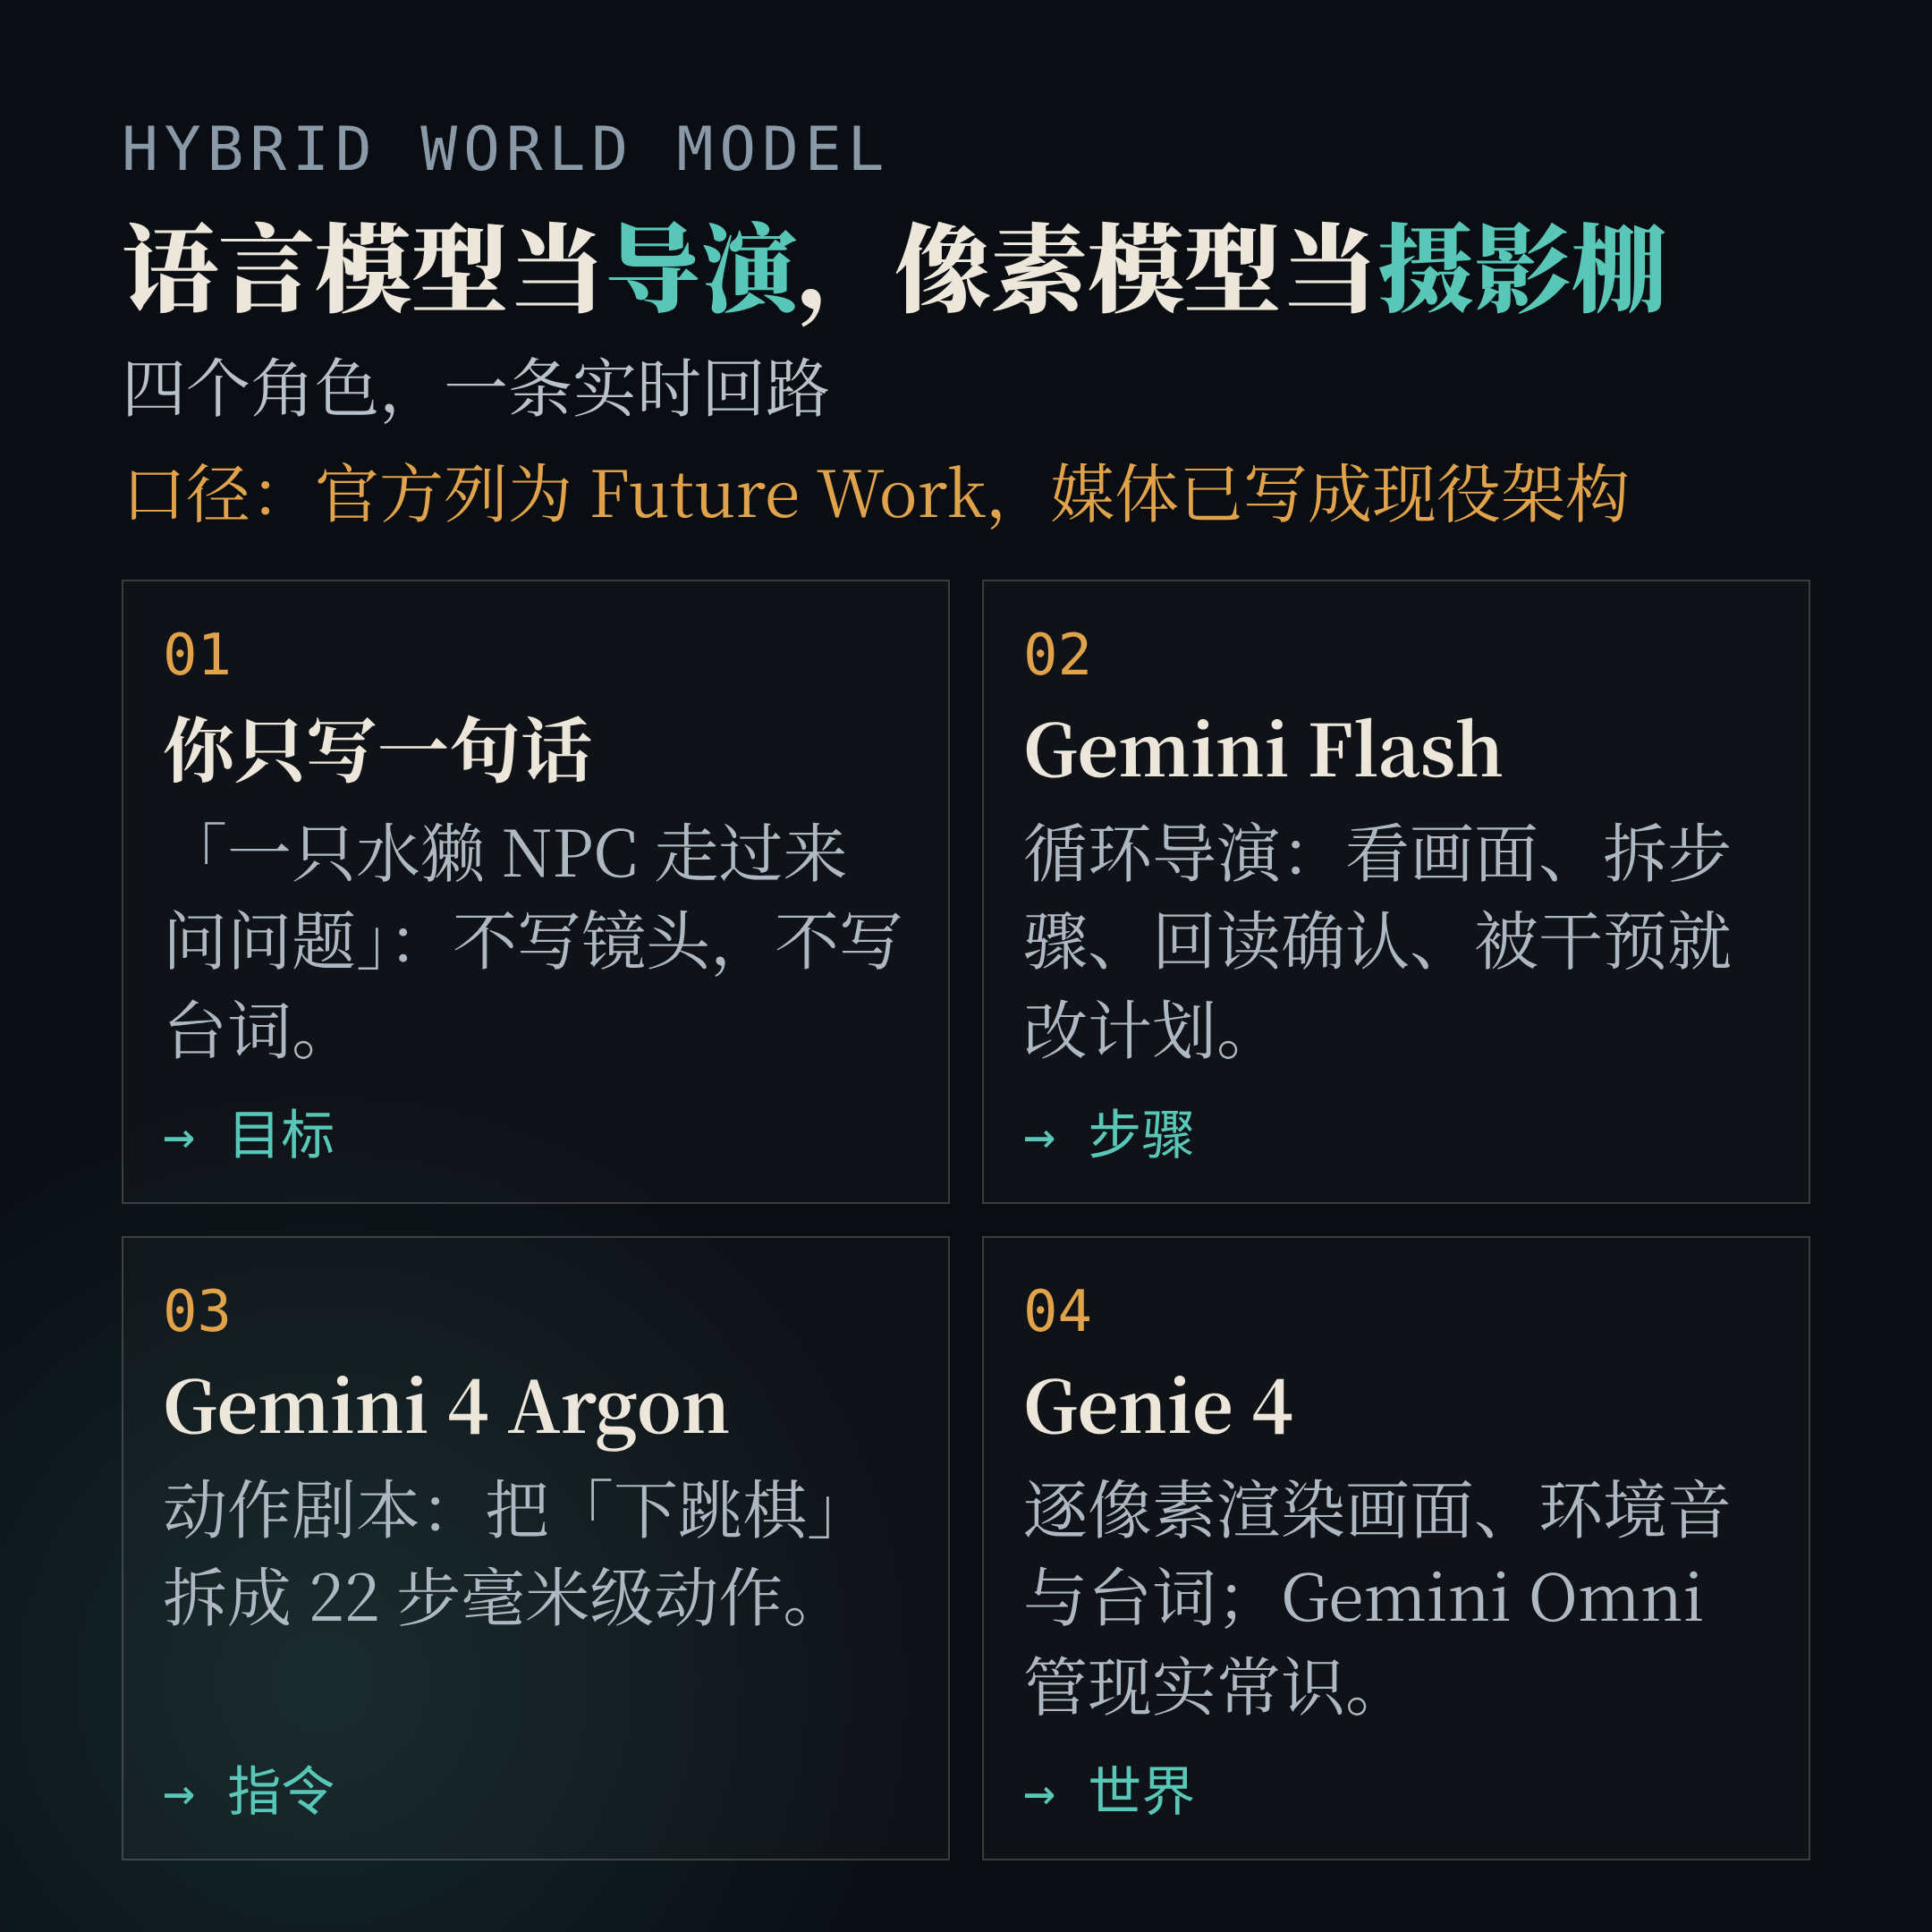
这条路线官方叫「混合世界模型」(hybrid world models):语言模型管逻辑与计划,像素模型管感官现实。
但这里有一个必须说清的口径差。 官方博客把它写在「Future Work」一节,原话是「让 Genie 和 Gemini 走得更近,是朝这个方向迈出的早期一步」。而不少媒体在标题里已经把它写成 Genie 4 的现役「架构」。
差别在哪?如果它是现役架构,那意味着这套回路已经在产品里跑通、延迟和成本都可接受;如果它只是方向,那我们现在看到的,是一批精心挑选的 demo。官方自己选了后一种说法。
对一个要判断「能不能用」的读者来说,这个区别不是文字游戏,它决定了你该等什么。
三、四个还没回答的问题
我把官方口径、公开实测和演示里能查到的信息对了一遍,发现有四个关键数字都还没出现。它们不出现,就还不能说「可用」。
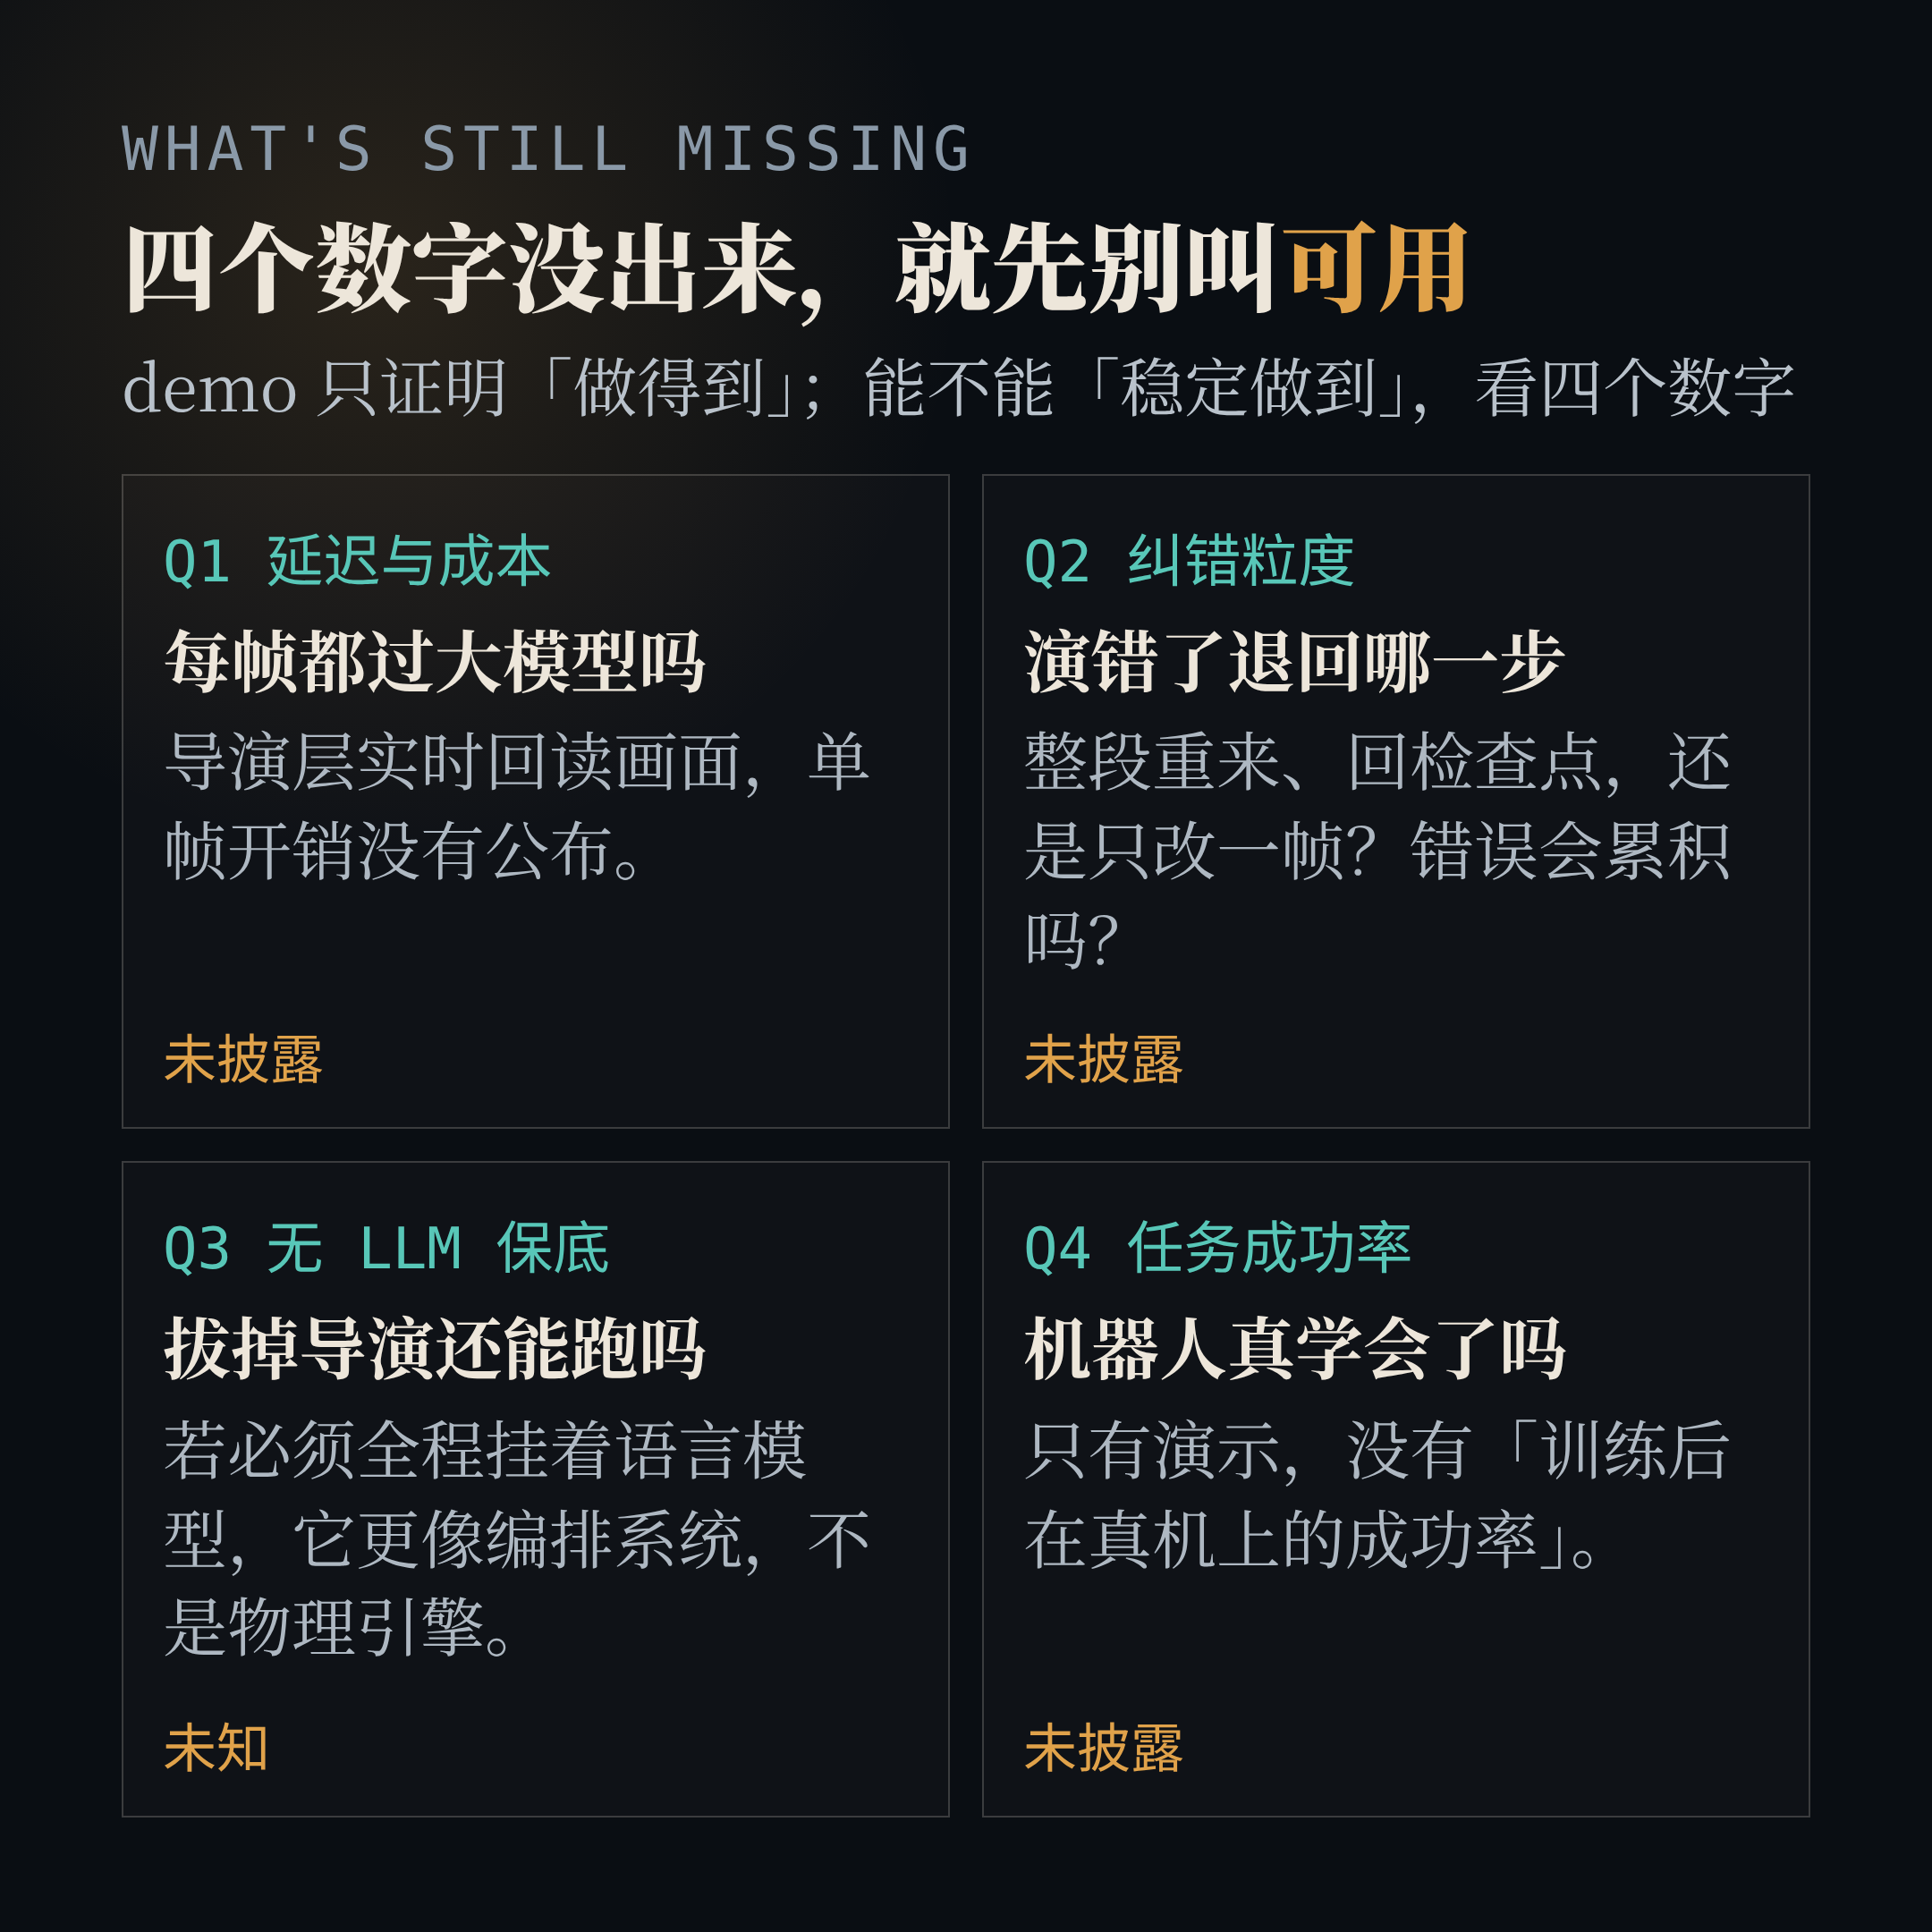
Q1:延迟与成本——每一帧都过一次大模型吗? 导演层要实时回读画面、判断步骤是否完成。如果每帧都走一遍,成本会非常高;如果是隔几帧抽查,那「验证」的可靠性就要打折。官方没有公布这套回路的单帧开销。
Q2:纠错粒度——演错了退回哪一步? 整段重来、退回上一个检查点、还是只改一帧?错误会不会随步数累积?这决定了它能不能做多步骤任务——下跳棋这种 22 步的动作,任何一步错了都要有明确的回退策略。
Q3:无 LLM 保底——拔掉导演还能不能跑? 如果必须全程挂着语言模型,它更像一个「编排系统」,而不是独立的物理引擎。这两者的工程含义完全不同:前者依赖 API 和算力,后者可以本地部署。
Q4:任务成功率——机器人真的学会了吗? 官方演示了 Apollo 人形下跳棋、UR5 精密移液,但没有给「用世界模型训练之后,在真机上的成功率是多少」。没有这个数字,「无限试错的仿真场」就还只是一句愿景。
这四个问题不解决,demo 只能证明「做得到」,不能证明「稳定做到」。而工程上,后者才是分水岭。
四、给你一把尺子:看世界模型只看四个轴
如果你不想每次都被发布会带着走,可以记住这四个轴。它们比「画质排名」有用得多。
① 可交互时长:能连续维持多久而不崩?注意区分「单次连贯时长」和「世界是否持久」。2 分钟够拍一个镜头,不够拍一场戏。
② 可改写性:改一句话,世界是「局部重画」还是「整体自洽地改写」?前者是视频编辑,后者才是世界模型。
③ 一致性:同一把椅子转个角度还在不在?物理规则在镜头切换后是否守恒?这一条最容易被 demo 掩盖,也最影响可用性。
④ 可评测性:有没有任务成功率,而不只是好看片段?一个能给出失败率的系统,才值得被放进生产流程。
用这四个轴去套,你会发现 Genie 4 在 ①②③ 上都明显前进,但 ④ 还是空的。这不是唱衰——恰恰相反,前三项已经足够让它成为一个很好的「创意工具」和「早期训练环境」,只是还不该被当成「通用世界模拟器」。
五、对我们意味着什么
对内容生产:从「渲染」变成「运行」。 过去做一条视频,是写脚本、排时间线、渲染输出;世界模型的路子是「跑一个世界,然后录下来」。我们本机这套代码生成视频的流程(Hypit、HyperFrames 那条线)本质上还是前者——每一帧都要算出来。世界模型如果真做到实时,生产的瓶颈会从「算力」移到「场景设计」:你能不能写出一个值得被跑的世界。
对机器人:从「采数据」变成「设计课程」。 如果「无限可变仿真」成立,具身数据的来源会多一条:不再是纯靠真机采集或人类第一视角视频,而是用世界模型合成场景、再用语言模型写剧本化课程。那时候稀缺的不是数据量,而是「设计出有效课程」和「验收训练结果」的能力。
对普通读者:现在最该做的是「会用」,不是「会信」。 把它当成一个能实时响应你的创意沙盒,去试「改一句话世界怎么变」这件事本身,就足够有价值。别把它当成已经可依赖的物理世界——两分钟的记忆,注定它现在只适合短场景。
最后
Genie 4 最让人震动的,确实是一句话生成一个世界。但真正决定它能走多远的,是另一件事:这个世界的边界在哪里,什么时候会崩,崩了以后怎么修。
发布会回答的是第一个问题。后两个,还得等那四个数字。
在那之前,我建议把 Genie 4 记成一句话:它已经不是默片了,但离「可依赖的平行宇宙」还有一段要量出来的距离。