AI 写不了长篇,不是模型记性差,是你没给它一个世界
先说结论。
AI 写不了长篇,往往不是模型记性差。
是你从来没把「世界」交给它。
你是不是也遇到过:写到第十八章,师门突然不见了?
那这篇讲的就是你。
一、那个消失的师门
第三章,你写主角出身青崖剑宗。
师父是个瘸腿老头,剑法很好,脾气很差。
到第十八章,你让 AI 写一场山门大战。
它写:主角回到家中,与父亲商议对策。
宗门没了。
师父没了。
你前面搭的世界,在它眼里从来没存在过。
多数人的第一反应是「模型记性差」。
然后去等更长的窗口,去换更强的模型。
我也这么想过。
直到我看了一个开源工具的设计,才意识到这个归因从头到尾都错了。
不是它记不住,是你没给过它。
二、窗口解决的是「能装多少」
上下文窗口变长,确实能让模型看到更多历史。
但它解决的是容量,不是结构。
一份几十万字的小说稿全塞进去,会发生三件事。
第一,成本按字数线性上涨。
每一章都在为早就不需要的第三章付钱。
第二,注意力会稀释。
文本越长,模型对中段信息的利用越差。
你以为它在读全书,其实它在读开头和结尾。
第三,也是最要命的:错了没法改。
设定藏在第三章的某段对话里。
到第四十章你发现它理解歪了。
你唯一的手段,是再强调一遍,然后祈祷它听进去。
没有任何一个地方能打开来,把「青崖剑宗」这个词的定义改掉。
窗口解决的是「能装多少」,不是「该装什么」。
所以真正的解法不是给它更多文本。
是把世界从对话里搬出来,变成一份它可以查、你可以改的结构。
这个故事,我在一个叫「故事熔炉」的开源项目里看到了完整实现。
StoryForge,纯前端、本地运行、MIT 协议。
作者是知乎上的 Alongsin。
我写这篇时,它在 GitHub 上有 943 star,当天还在推代码。
先声明:我没有实测它。
我只读了作者的设计说明和仓库元数据。
所以下面讲的不是「这个工具多好用」。
是它的设计里那套可以拿走的方法,以及我不信的部分。
三、一条单向依赖的九步链
多数 AI 写作工具给你的是一堆并列功能。
续写、润色、扩写、起名。
功能之间没有关系,你爱用哪个用哪个。
StoryForge 的做法反过来。
它把创作拆成九个步骤。
后一步的输入,必须包含前一步的输出。
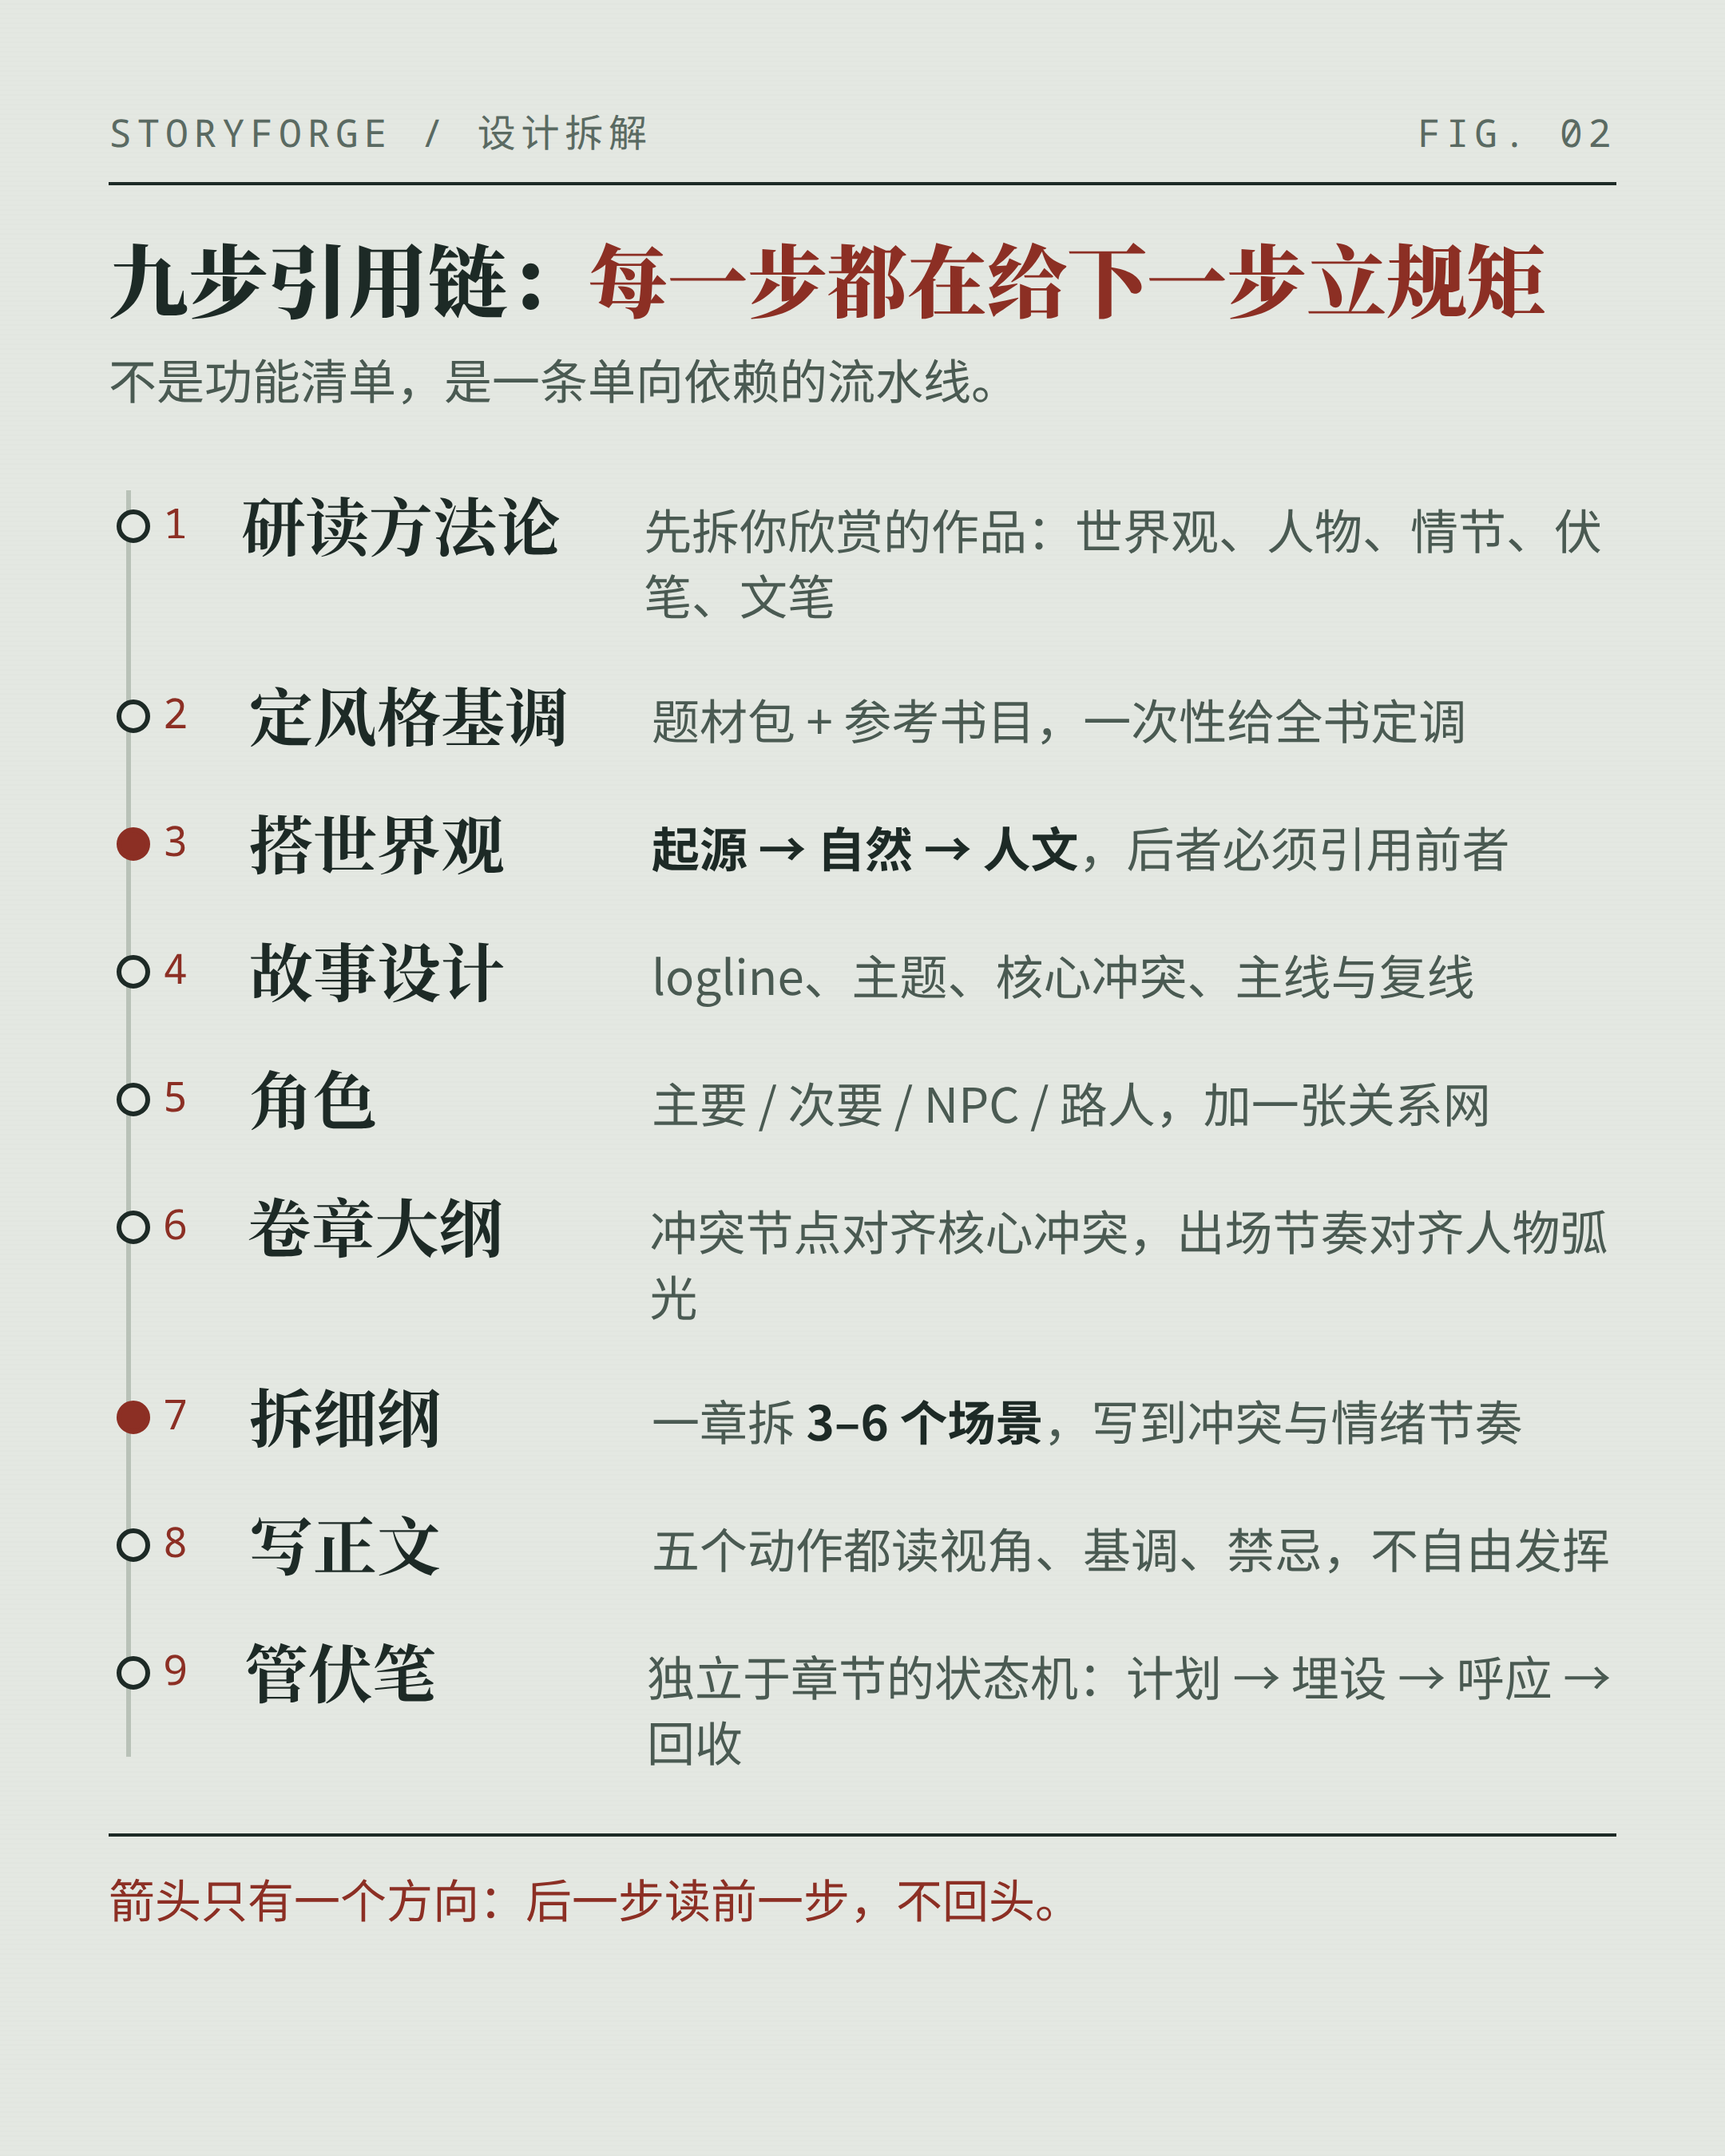
研读方法论,定风格基调,搭世界观。
故事设计,角色,卷章大纲。
拆细纲,写正文,管伏笔。
每一步都在做同一件事。
把上一步的结论,变成这一步的约束。
举三个具体的地方。
第一,世界观本身也是链。
先填世界起源,再填自然环境,最后填人文环境。
作者的逻辑很实在。
如果这个世界是灵气复苏后的现代,地理就该有灵气分布的逻辑。
而不是随机生成一套普通地理。
第二,细纲必须拆到场景。
选定一章,AI 把它拆成 3 到 6 个场景。
每个场景写清楚标题、概要、出场人物、地点、冲突、情绪节奏、预估字数。
到这一步,写正文就不再是自由发挥。
是让它填一张已经画好的表。
第三,正文的五个动作都带规则。
写、续写、润色、扩写、去 AI 味。
每个动作都读取你设定的视角、基调和禁忌。
你规定第一人称,它不会混进第三人称段落。
这套东西听起来朴素。
但它解决了一个很实际的问题。
生成的边界,从「模型的即兴」变成了「你填过的表」。
四、真正值钱的是状态卡
如果只有上面那条链,它仍然只是一个更细的提示词模板。
链能保证生成时有上下文。
保证不了上下文是对的。
真正让我停下来看的,是它的状态表机制。
更新日志里管这叫「按需召回注入」。
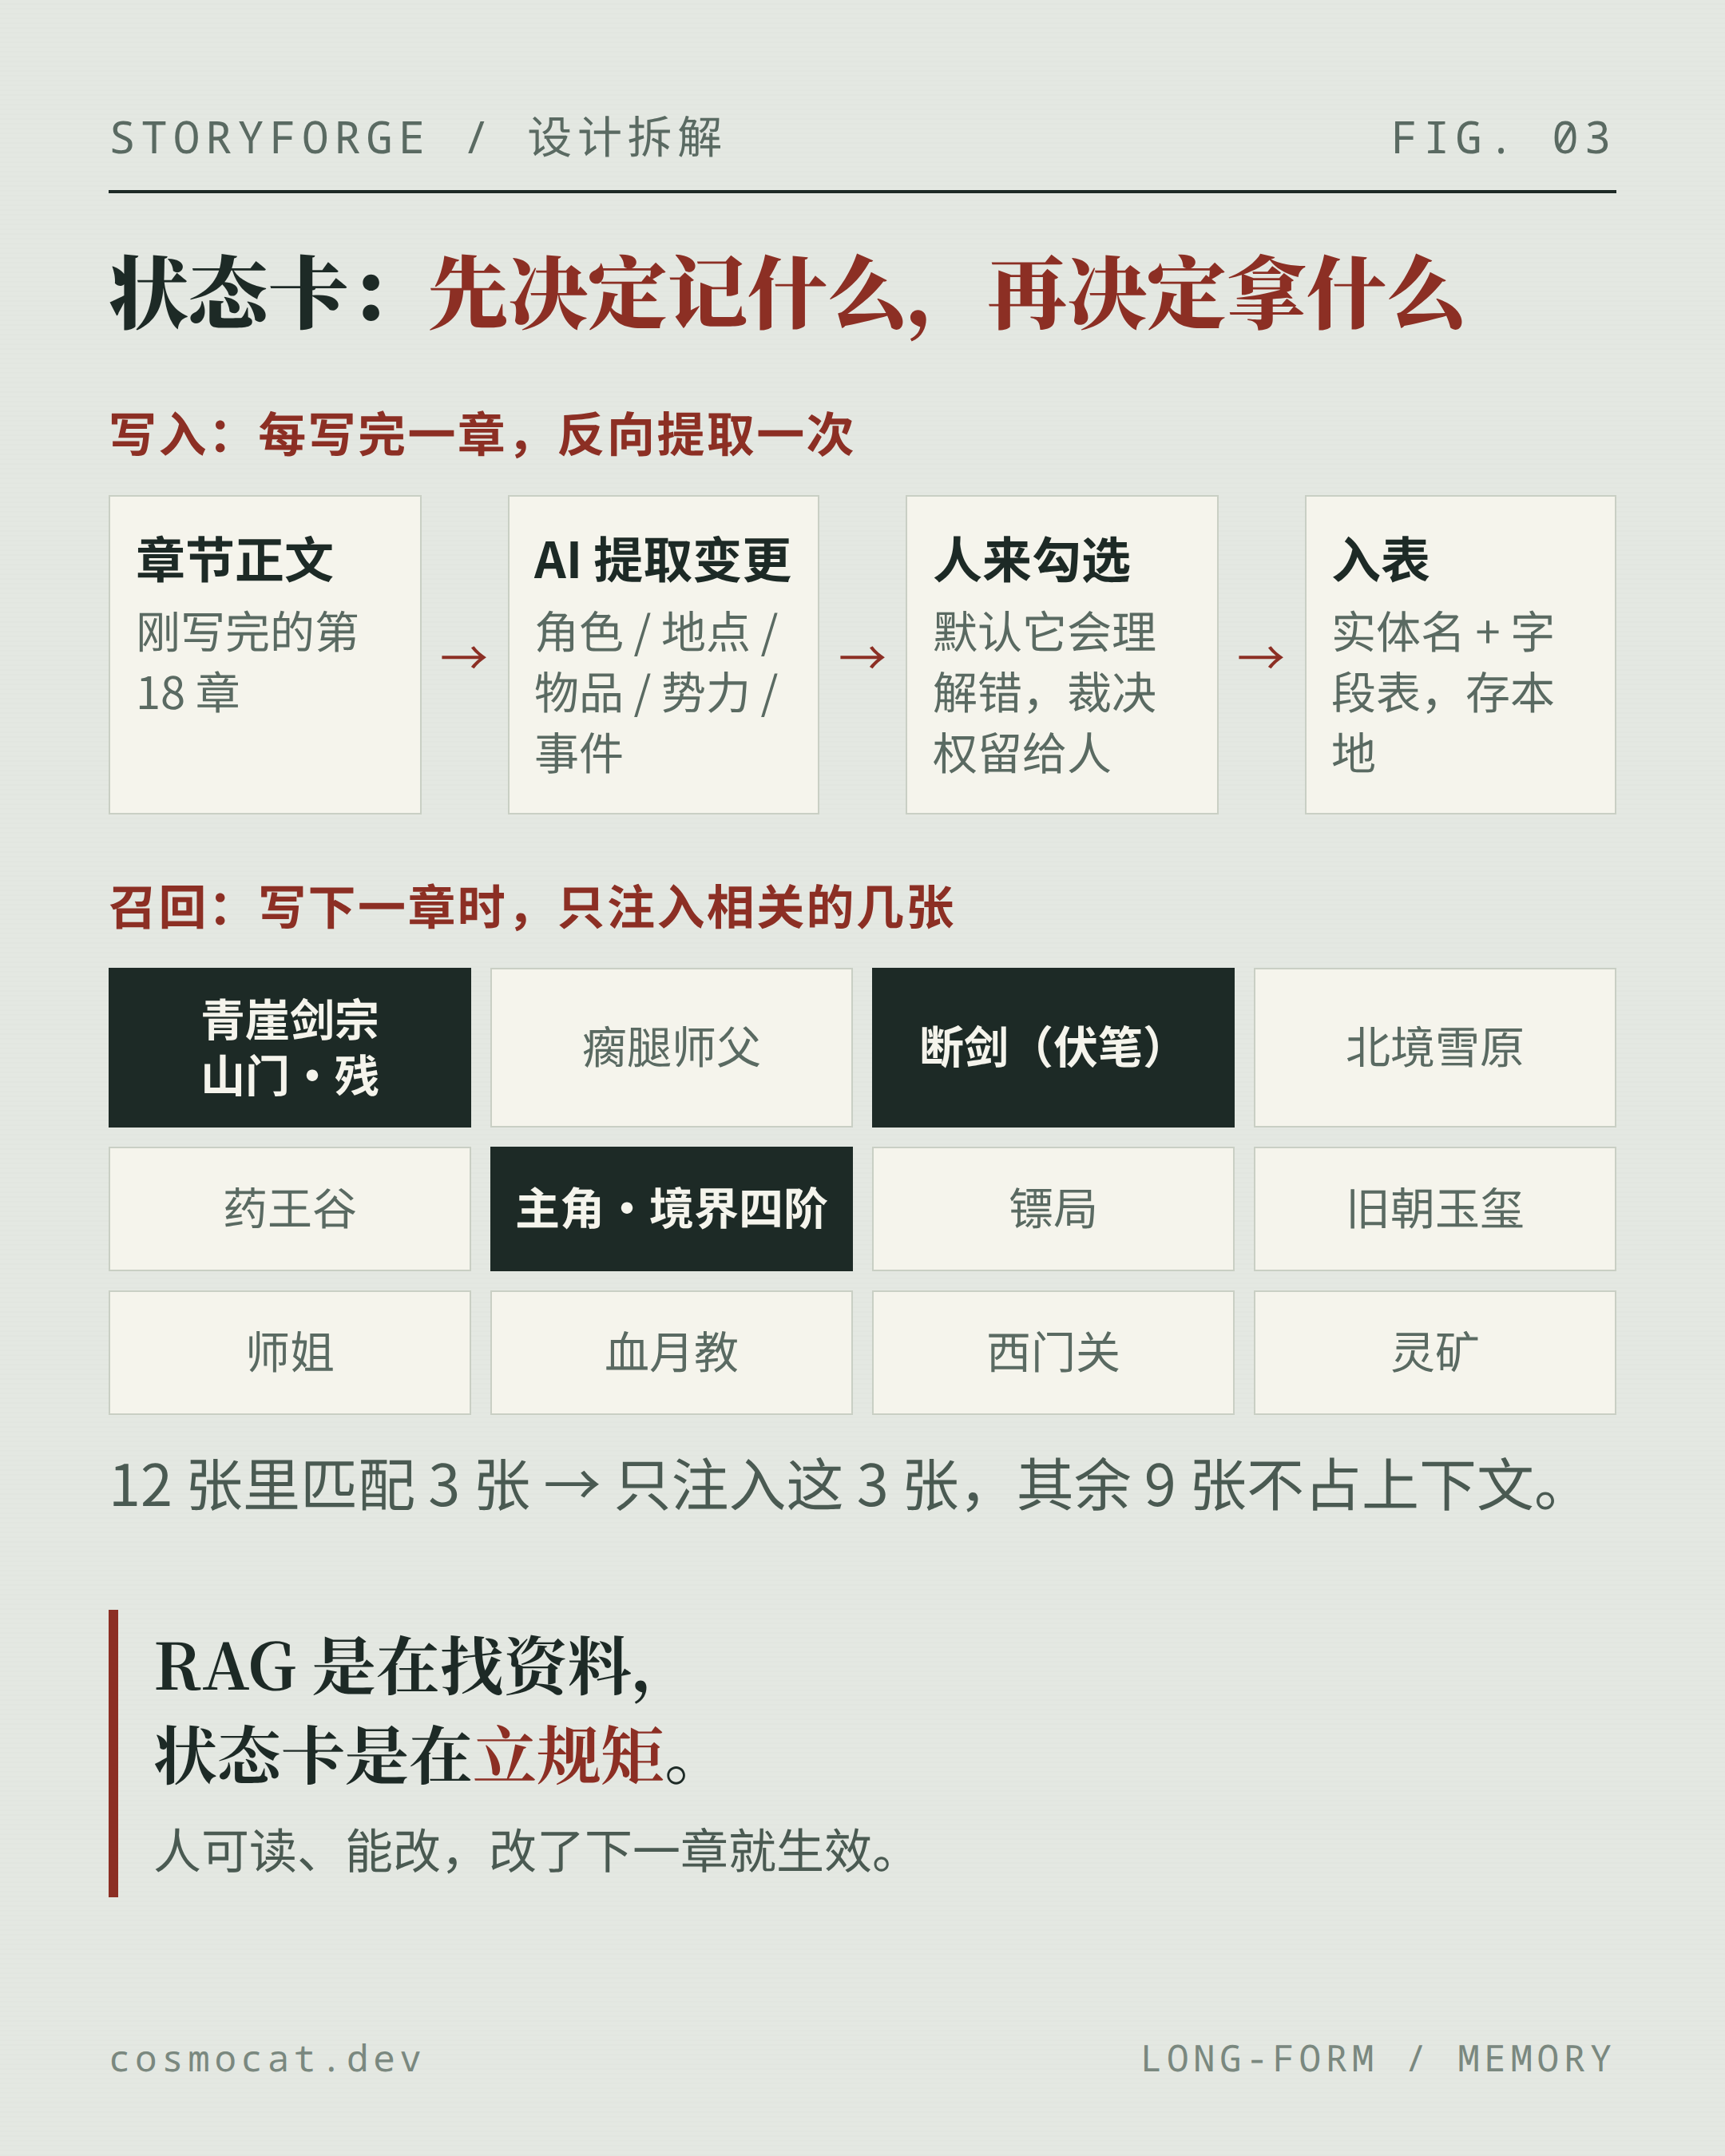
流程有四步。
第一步,写完一章,反向提取状态变更。
AI 读这一章的正文。
找出角色、地点、物品、势力、事件这五类实体的变化。
列成候选。
第二步,人来勾选。
弹窗列出所有候选变更。
你确认哪些真的进了故事。
这一笔很关键。
它默认 AI 会理解错,把最终裁决权留给人。
第三步,入表。
确认后的内容变成一张张状态卡。
实体名,加一组 key-value 字段。
存在本地,刷新、换会话、换模型都不丢。
第四步,生成时按需召回。
写下一章时,不是把全部状态卡塞进去。
而是按当前场景匹配。
比如 12 张卡里只注入 3 张,你还可以手动加选。
这四步里,最容易被低估的是写入和召回的分离。
现在大多数「记忆」方案只做召回。
把历史丢进向量库,生成时按相似度捞几条。
这解决的是「找得到」。
不解决「记得对」。
相似度高的片段,未必是当前场景要遵守的设定。
而且向量库里的东西,你没法打开来改一行字。
StoryForge 的做法土得多。
一张人可读的表,一个手动的确认键。
但恰恰是这个「土」,让状态可审计。
设定冲突了,你能看见是哪张卡写错了。
改掉它,下一章就生效。
RAG 是在找资料,状态卡是在立规矩。
五、伏笔当成状态机
长篇最容易翻车的不是设定,是伏笔。
埋了没收。
或者收的时候,已经忘了当初怎么埋的。
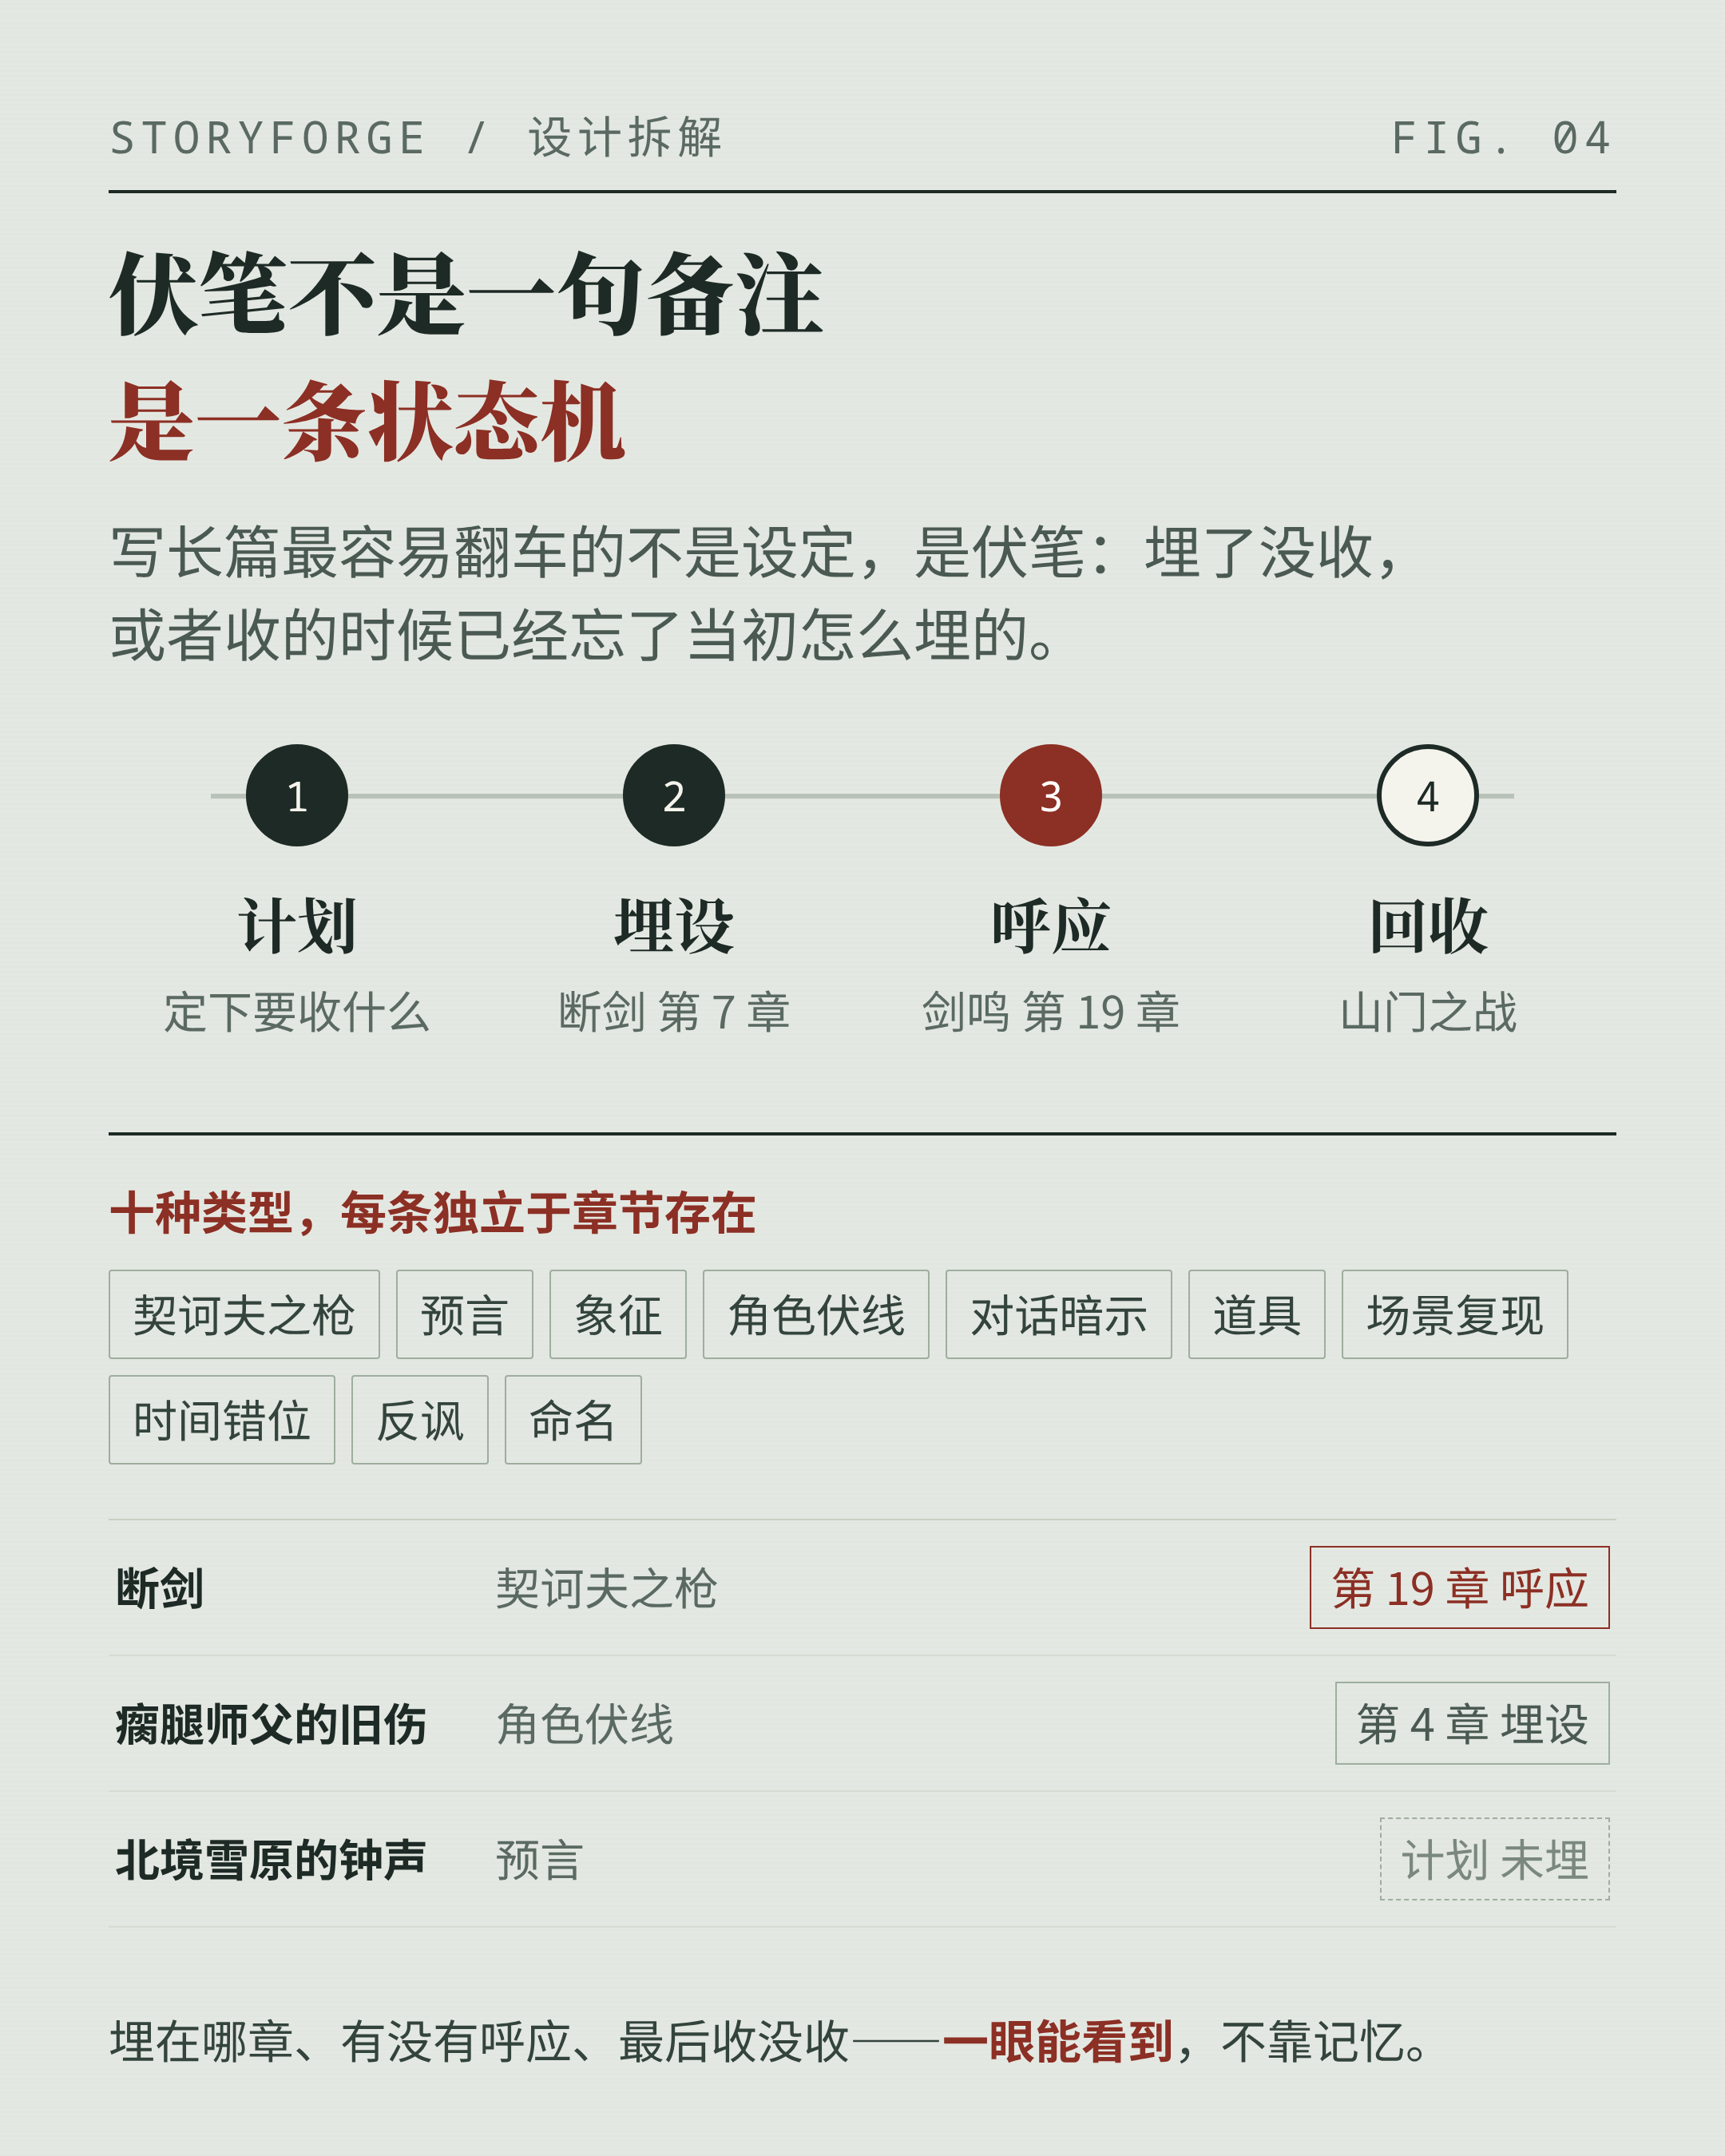
它把伏笔做成一个独立于章节的状态机。
十种类型,契诃夫之枪、预言、象征、角色伏线、对话暗示……
每条有四个状态。
计划,埋设,呼应,回收。
你可以随时看到:
哪条线埋出去了。
埋在哪一章。
有没有呼应。
最后有没有收。
到这一步,它管的已经不是「写作」。
是一个几十万字项目的状态一致性。
六、我不信的部分
写到这里必须泼冷水。
否则这篇文章就成了软文。
第一,它没有证据。
整篇文章没有任何一致性实测。
没有成品样本。
没有「用与不用」的对照。
所有效果都是作者的设计陈述。
状态卡能不能真的压住漂移,召回准不准,维护成本多高。
全都要自己跑一遍才知道。
第二,它解决不了「值得读」。
设定自洽不等于小说好看。
文笔、节奏、人物弧光,这些是模型能力和作者判断的事。
工具一个字都帮不上。
平台每月拒签十几万本低质书,其中不少设定也很自洽。
第三,作者自己也不推荐一键生成整本。
他的原话大意是:小说是个人表达。
全靠 AI,那还有自我么。
这句话我认同。
也是这个项目里唯一让我觉得可信的地方。
一个做工具的人肯给自己的工具划边界,通常说明他真的用过。
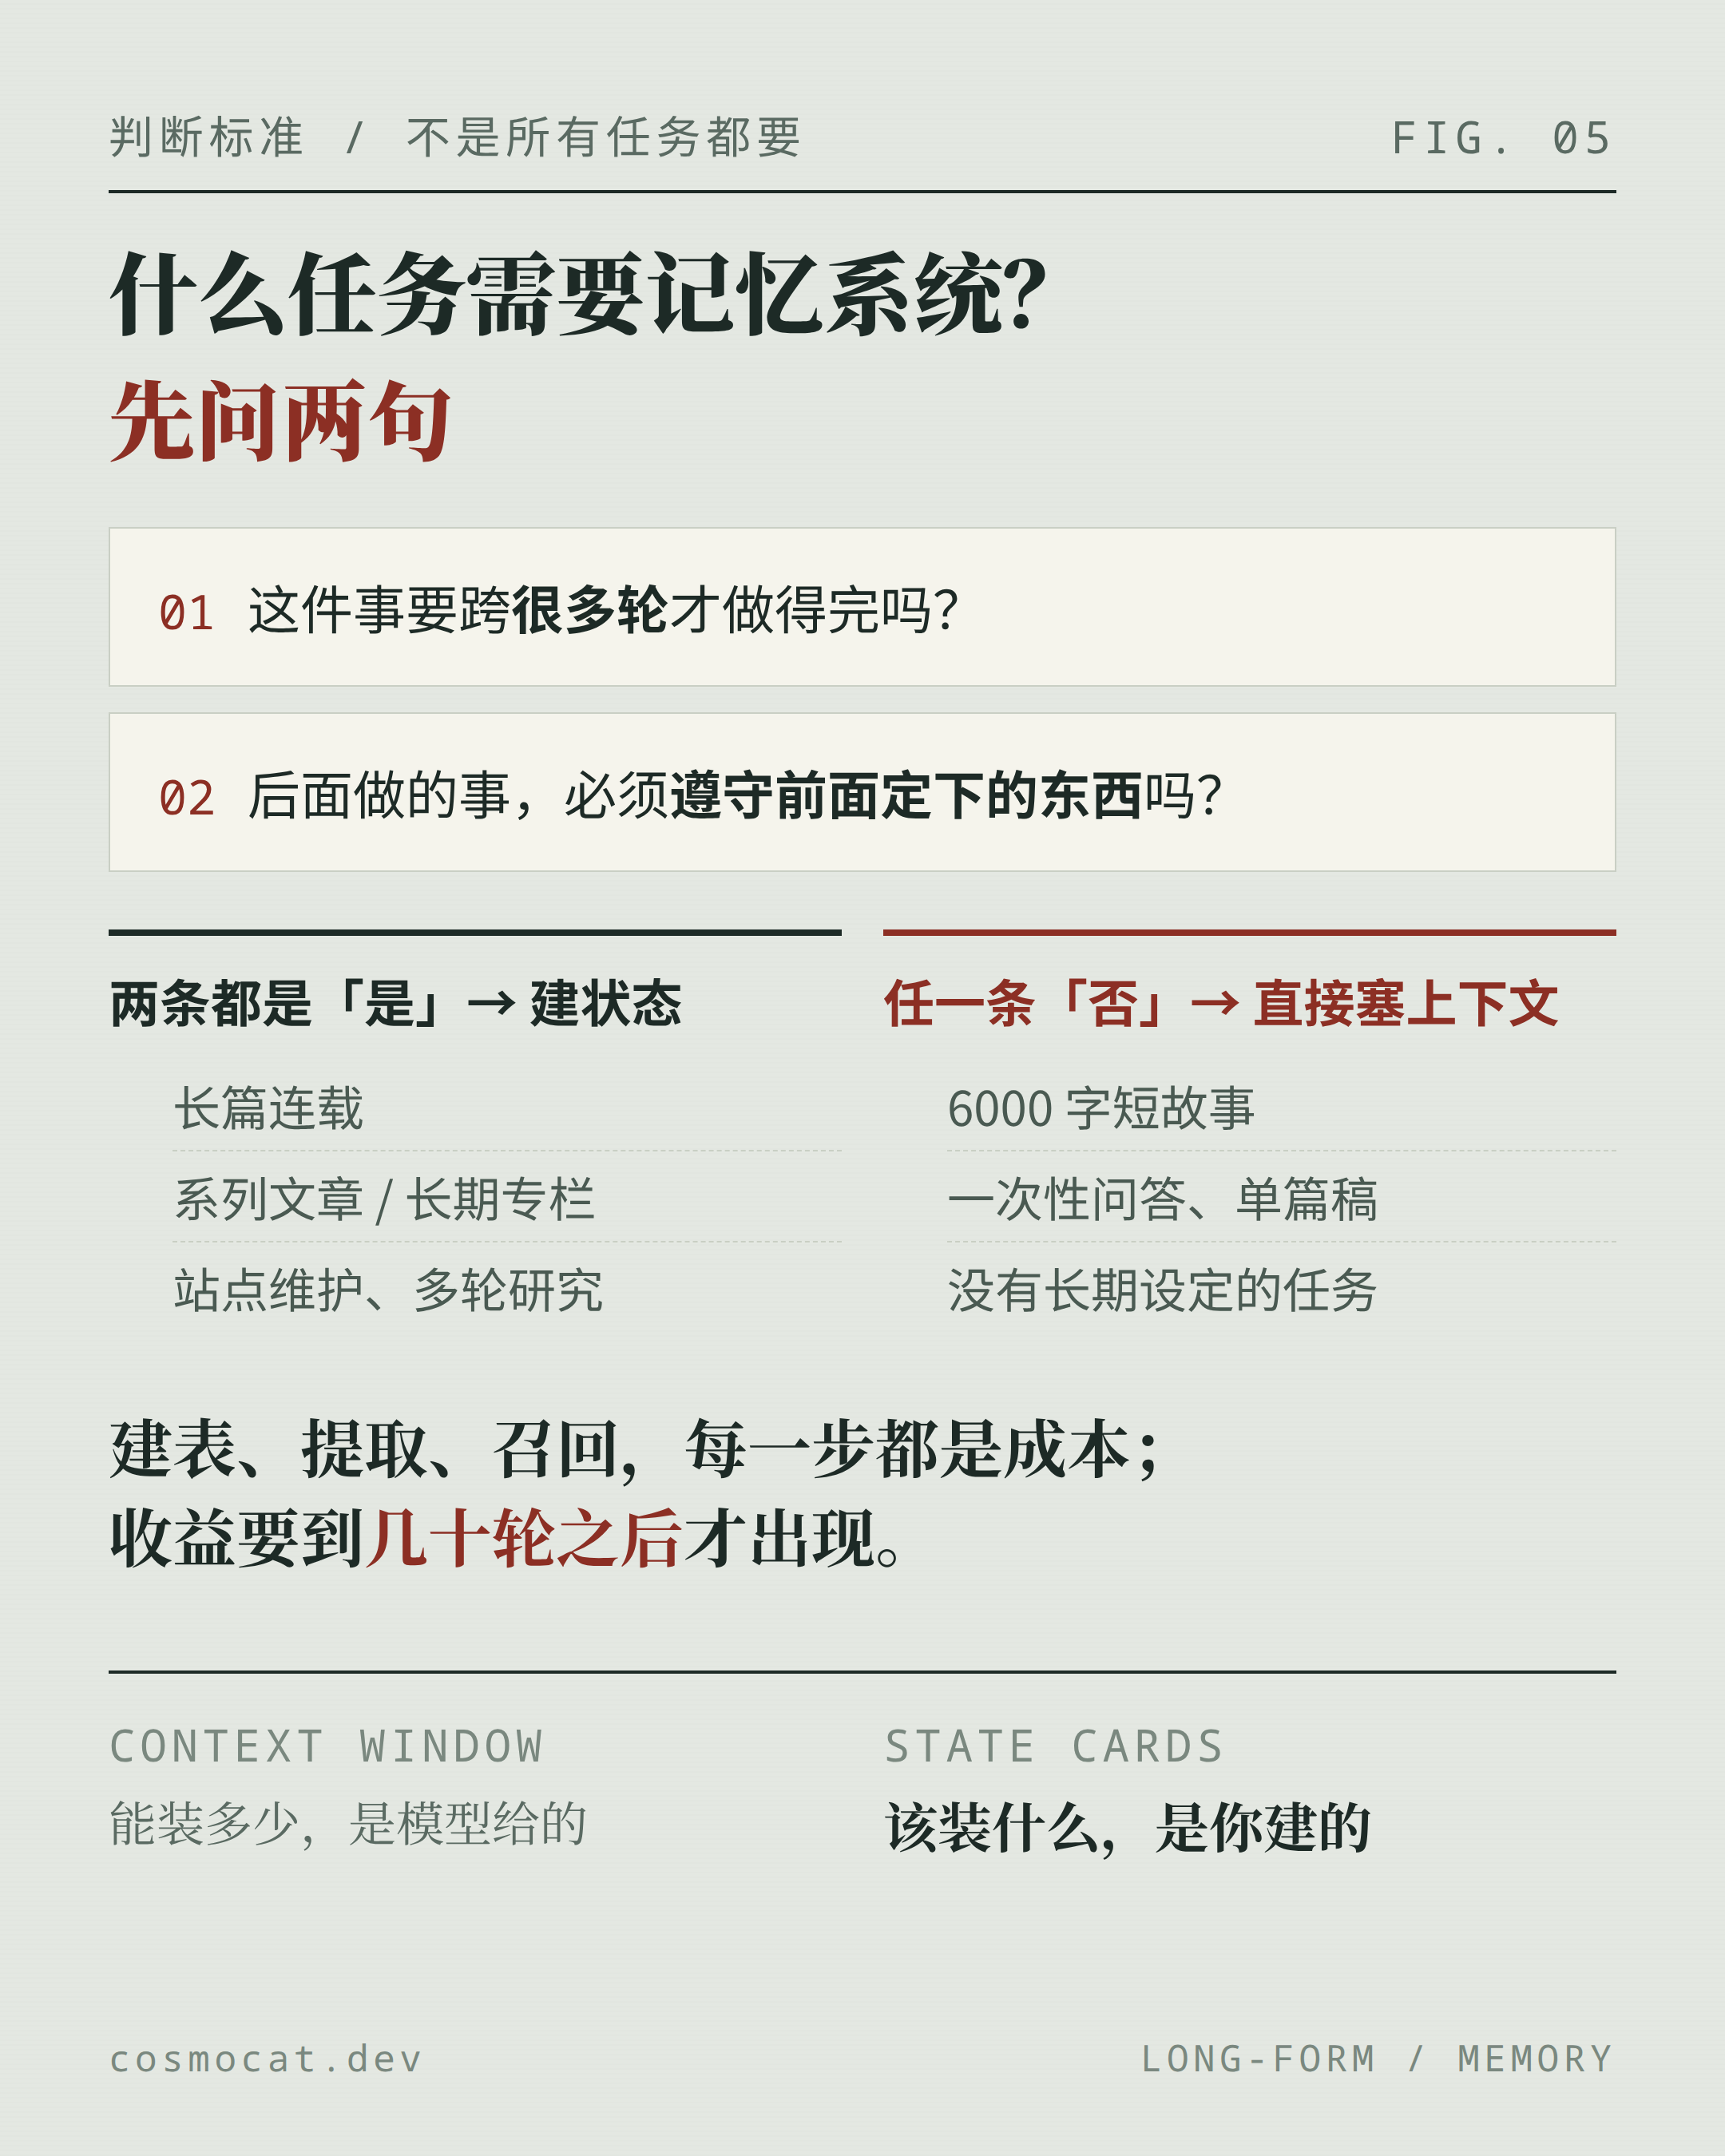
第四,它有适用范围。
如果你写 6000 字短故事、单篇公众号、一次性问答。
这套东西全是负担。
建表、提取、确认、召回,每一步都是成本。
收益要到几十章之后才出现。
七、跟写小说没关系的人也该看
我关心的其实不是小说。
是它背后那个更通用的命题。
长周期任务里,让模型记住,不如让系统记住。
只要一件事满足两个条件。
一,要跨很多轮才做完。
二,后面做的事必须遵守前面定下的东西。
你都会遇到同一个问题。
模型没有状态,只有这一次的输入。
写系列文章是这样。
维护一个站点是这样。
做一份持续几个月的研究也是这样。
我自己维护知识库和博客的流水线,本质上是同一套东西。
文件是状态。
索引是召回。
每次只读相关的那几页,而不是把整个库塞进去。
差别只在于,我的状态卡是 Markdown 文件。
它的是表格。
形式不同,道理一样。
先把「什么值得记」定下来。
再决定「这次要拿什么」。
最后保证「记错了能改」。
这三件事,比换一个更长的上下文窗口有用得多。
窗口是别人给的,状态是你自己建的。
最后
回到开头那个场景。
青崖剑宗为什么会在第 18 章消失?
因为从第 3 章到第 18 章,它一直只存在于一段对话里。
对话会被截断、被压缩、被新的指令挤走。
它不是被模型忘记的。
它从来没被真正保存过。
AI 写不了长篇,很多时候不是它不行。
是我们给它的东西太轻了。
给它一个世界,它才可能在里面住下来。
工具:StoryForge(故事熔炉),MIT 开源,纯前端本地运行,自带 API Key。
仓库:https://github.com/yuanbw2025/storyforge
原文出处:知乎专栏 Alongsin《故事熔炉(StoryForge)——一款免费开源的AI小说撰写工具》。