答错一道题,往回追到最上游:一个把 K12 知识拆成依赖图的工程样本
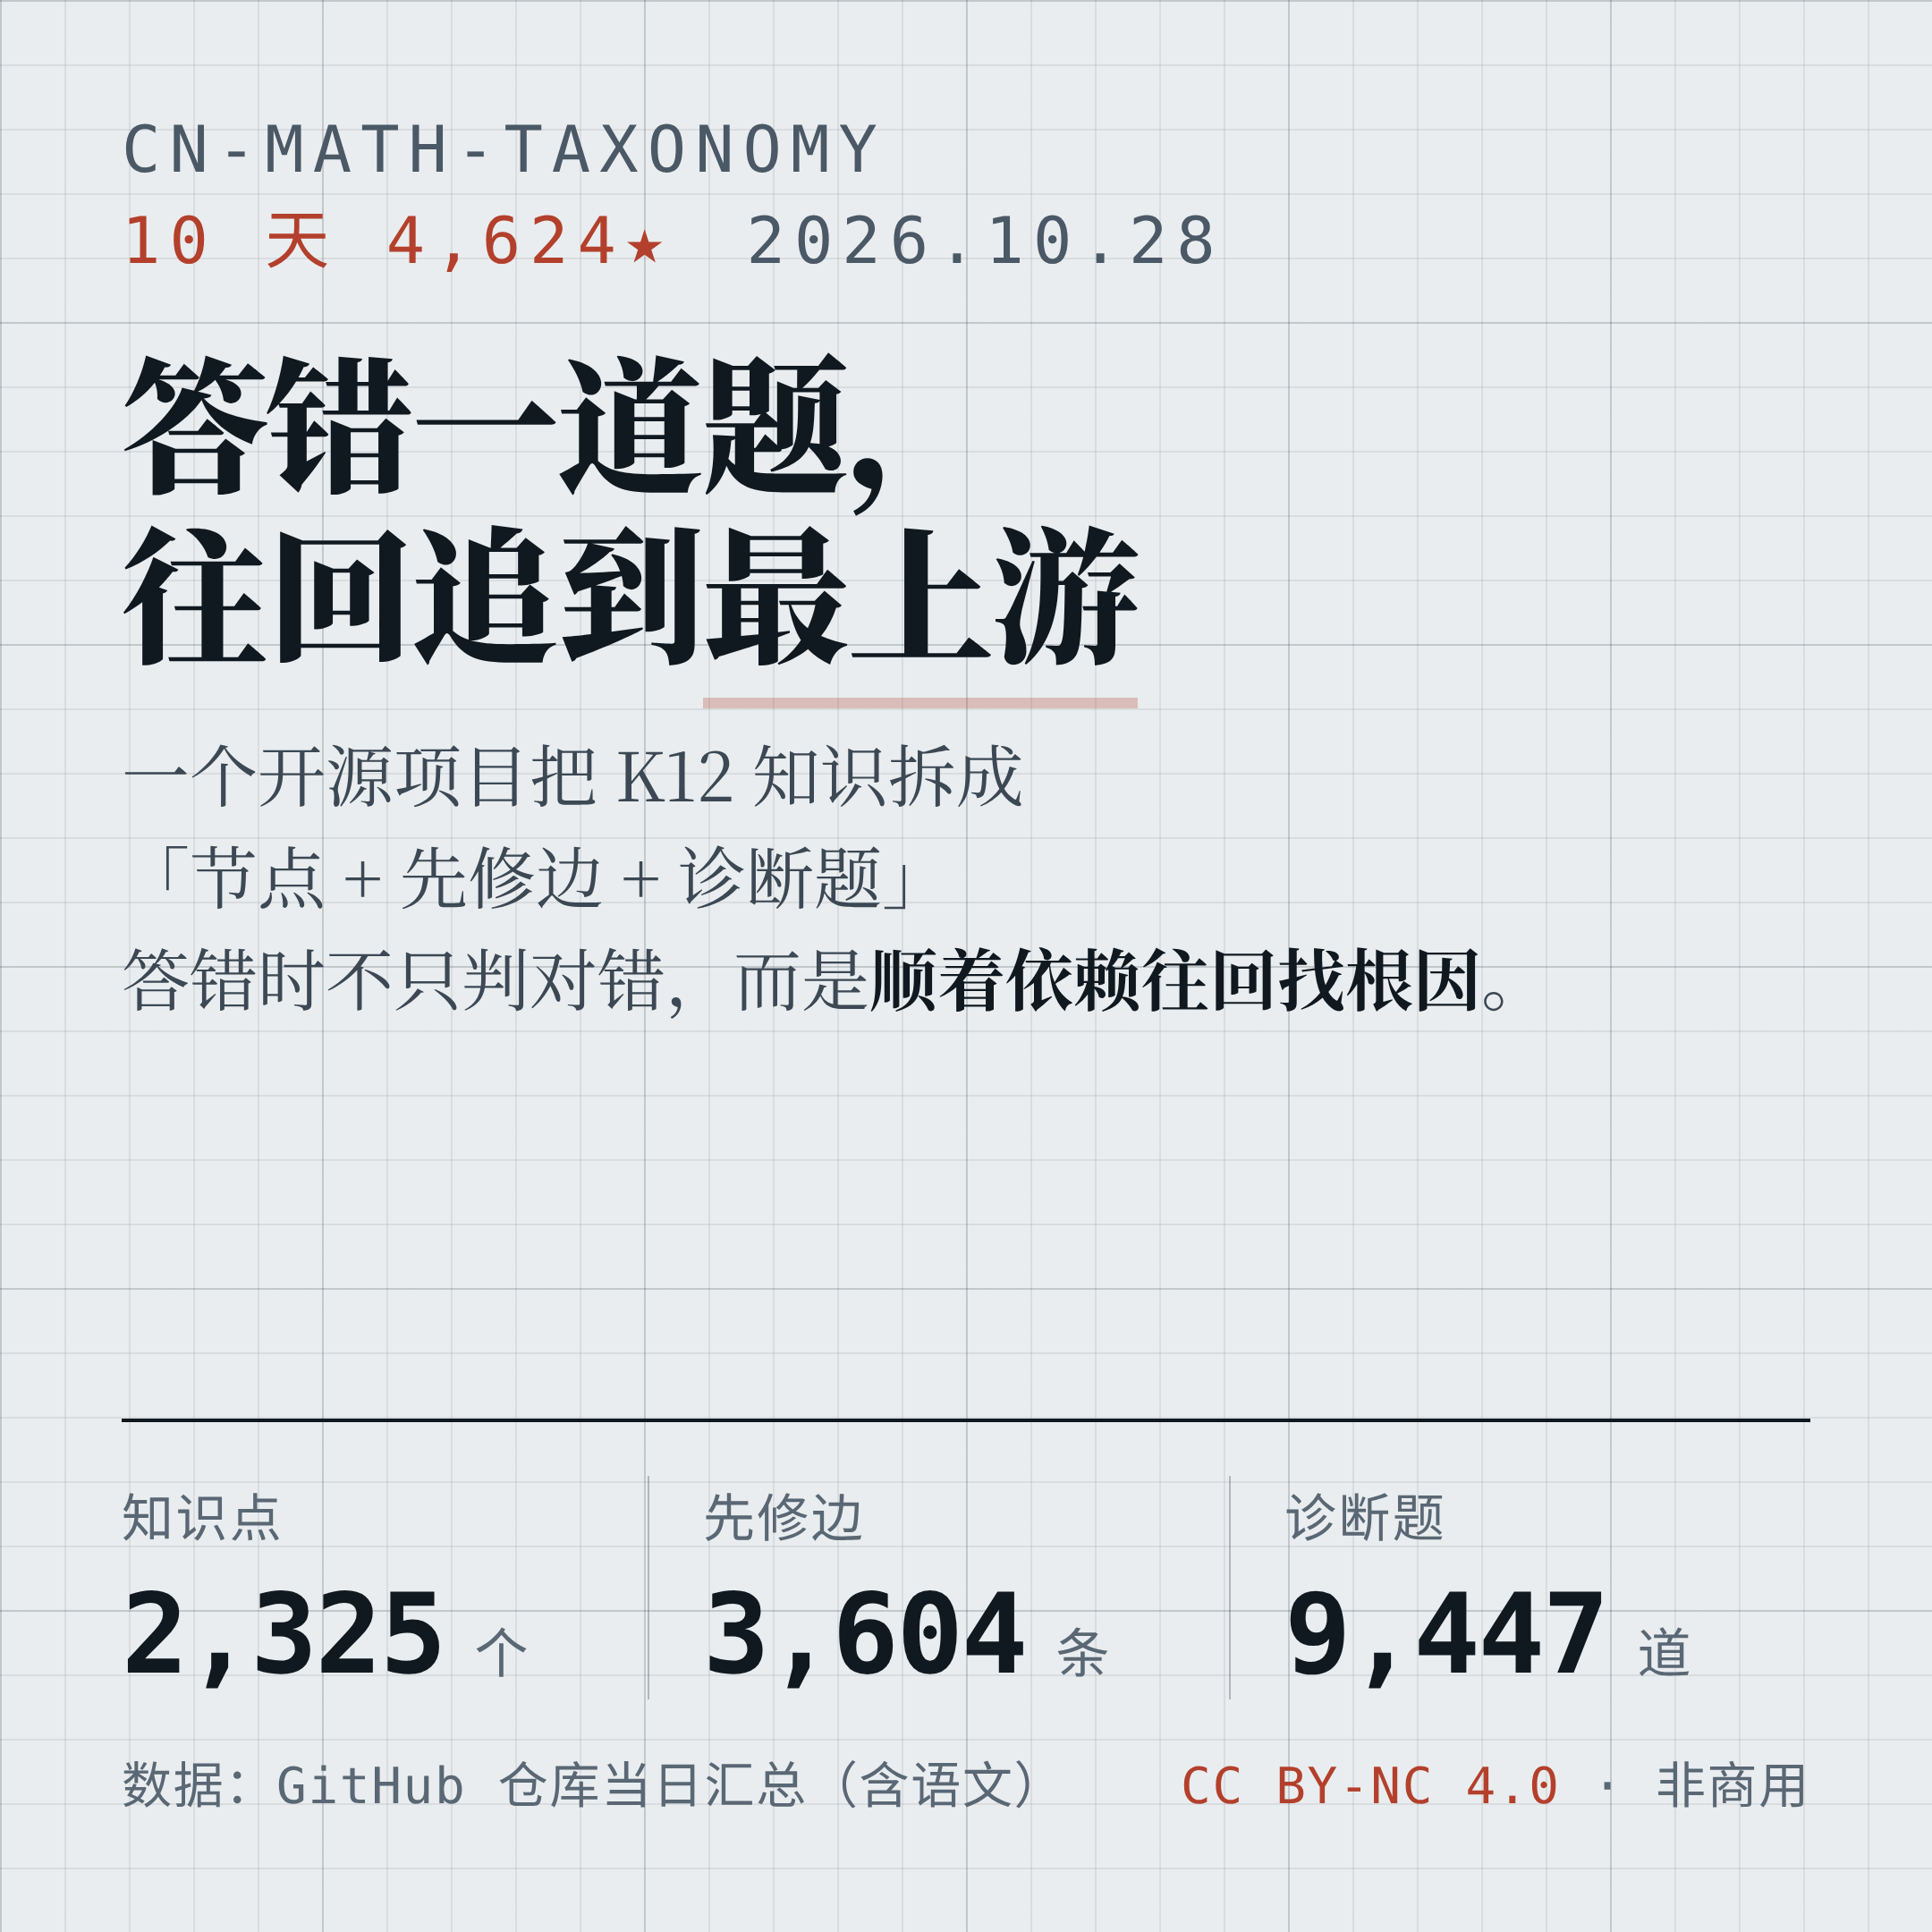
10 月 18 日建仓,到 10 月 28 日下午,GitHub 上的 cn-math-taxonomy 已经攒了 4,624 颗星、1,171 个 fork。仓库做的事听起来不新鲜:把 K12 的知识点整理成数据库。但它真正有意思的地方不在这里。
它把知识点连成了一张有方向的图——每个节点标注「学它之前必须先会什么」,每条先修关系还分硬、软两种强度。答错一道题时,系统不只告诉你错了,而是先补一道确认题,再沿着依赖边往回追,最后给出 2-3 个最上游的根因。
这更像一套故障诊断系统,只是被装进了教育场景。
一、一次答错,先别急着判「基础差」
先看一个人人都遇到过的场景:孩子做分式方程,错了。
常见的处理方式有三种:再讲一遍解法、骂一句粗心、或者直接判定「分数基础没打好」,从分数四则运算重头补。第三种最省事,也最伤——因为它跳过了最重要的一步:这次错,到底是手滑,还是真不会?
这个项目的诊断引擎把这一步做成了规则。同一知识点要连续答对几道确认题才判「掌握」,默认是 3 道,可以设成 2、3 或 5。答错之后也不是立刻回溯,而是先出一道同级或更简单的确认题:
- 确认题答对 → 判「不稳」,可能只是看错题干或紧张,不回溯;
- 确认题也答错 → 判「薄弱」,这才沿着先修边往回追。
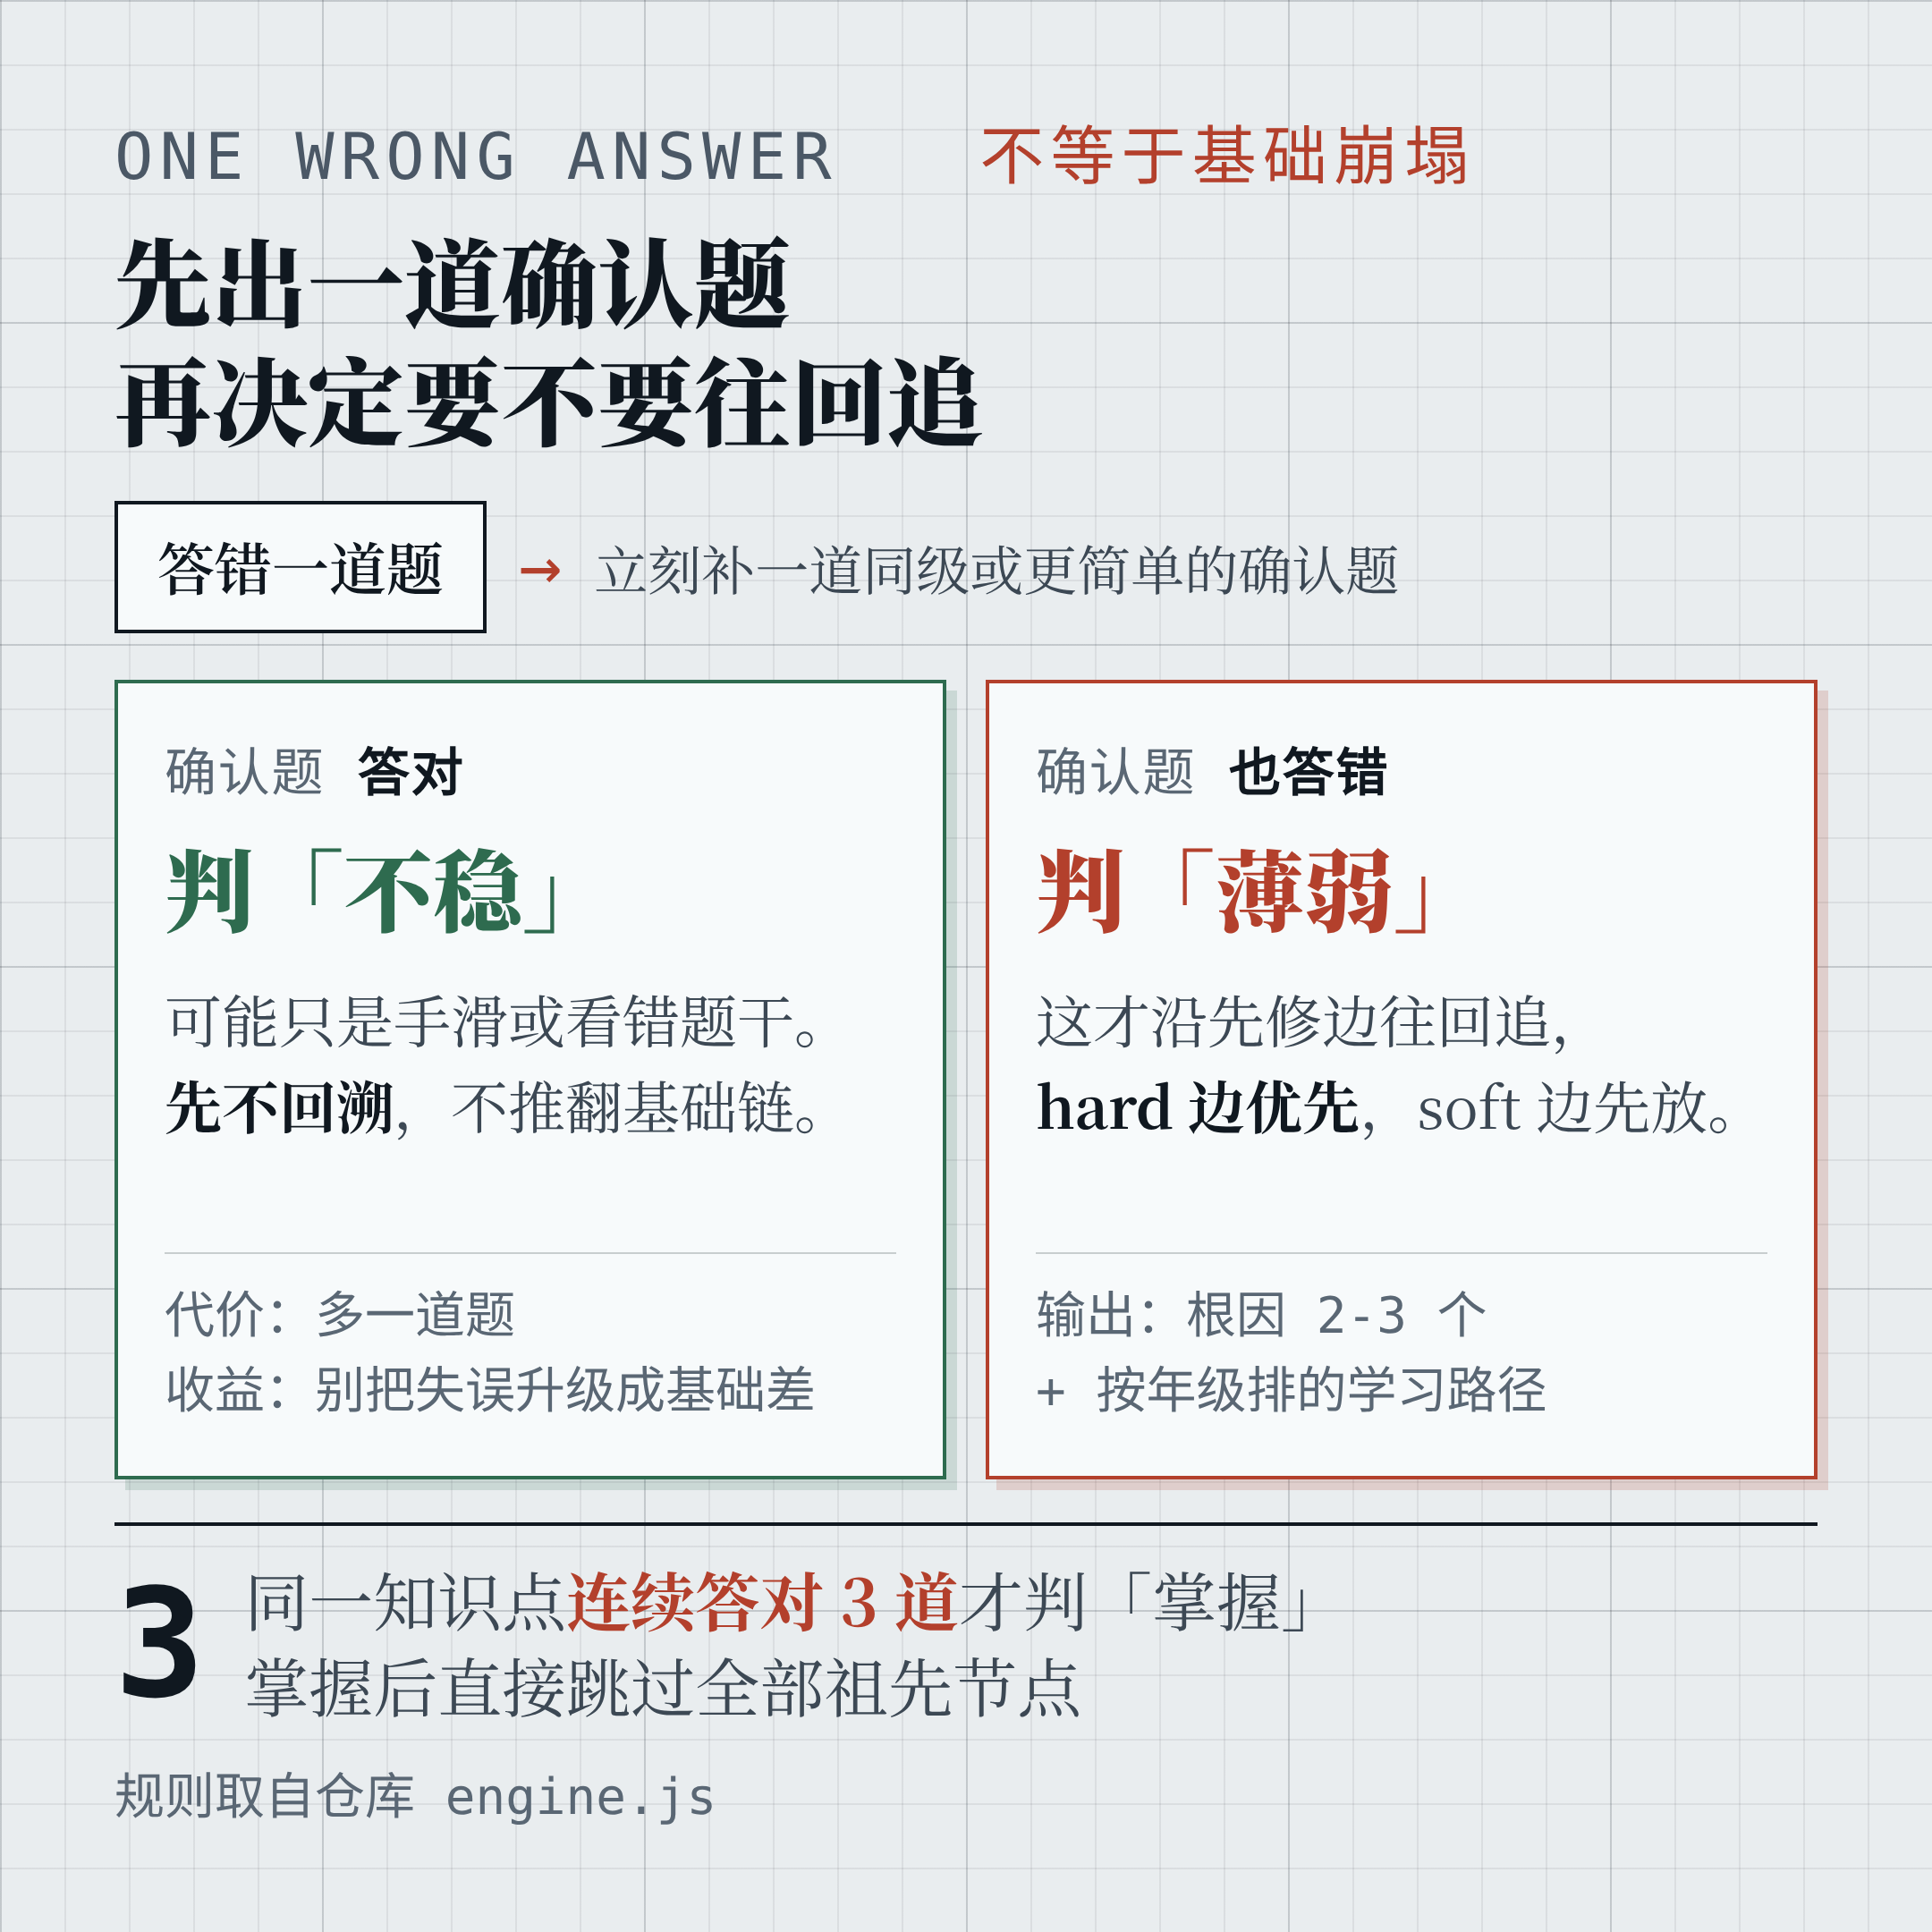
这个设计看着只是多问一句,实际决定了整套系统可不可信。没有确认题,一次打字错误就会被判成「基础缺失」,然后系统会把你送回去重学半个学期——用两次之后,没人会再信它。
诊断系统的第一原则不是「找得准」,而是「少冤枉人」。 这条原则放在教育、客服排障、线上事故定位里都一样。
二、知识不是清单,是一张有方向的图
翻开仓库的数据,结构很简单,三份 JSON:
topics.json:知识点本身,含 id、名称、年级册章、领域、掌握标准、课标映射;dependencies.json:先修关系,每条记录「谁依赖谁」、强度是 hard 还是 soft、以及理由;questions.json:诊断题,含难度、题型、答案、解析。
全库现在是 2,325 个知识点、3,604 条先修边、9,447 道诊断题。分科看,数学 839 个、英语 724 个、物理 269 个,文章没提到的语文也已经补到 493 个。
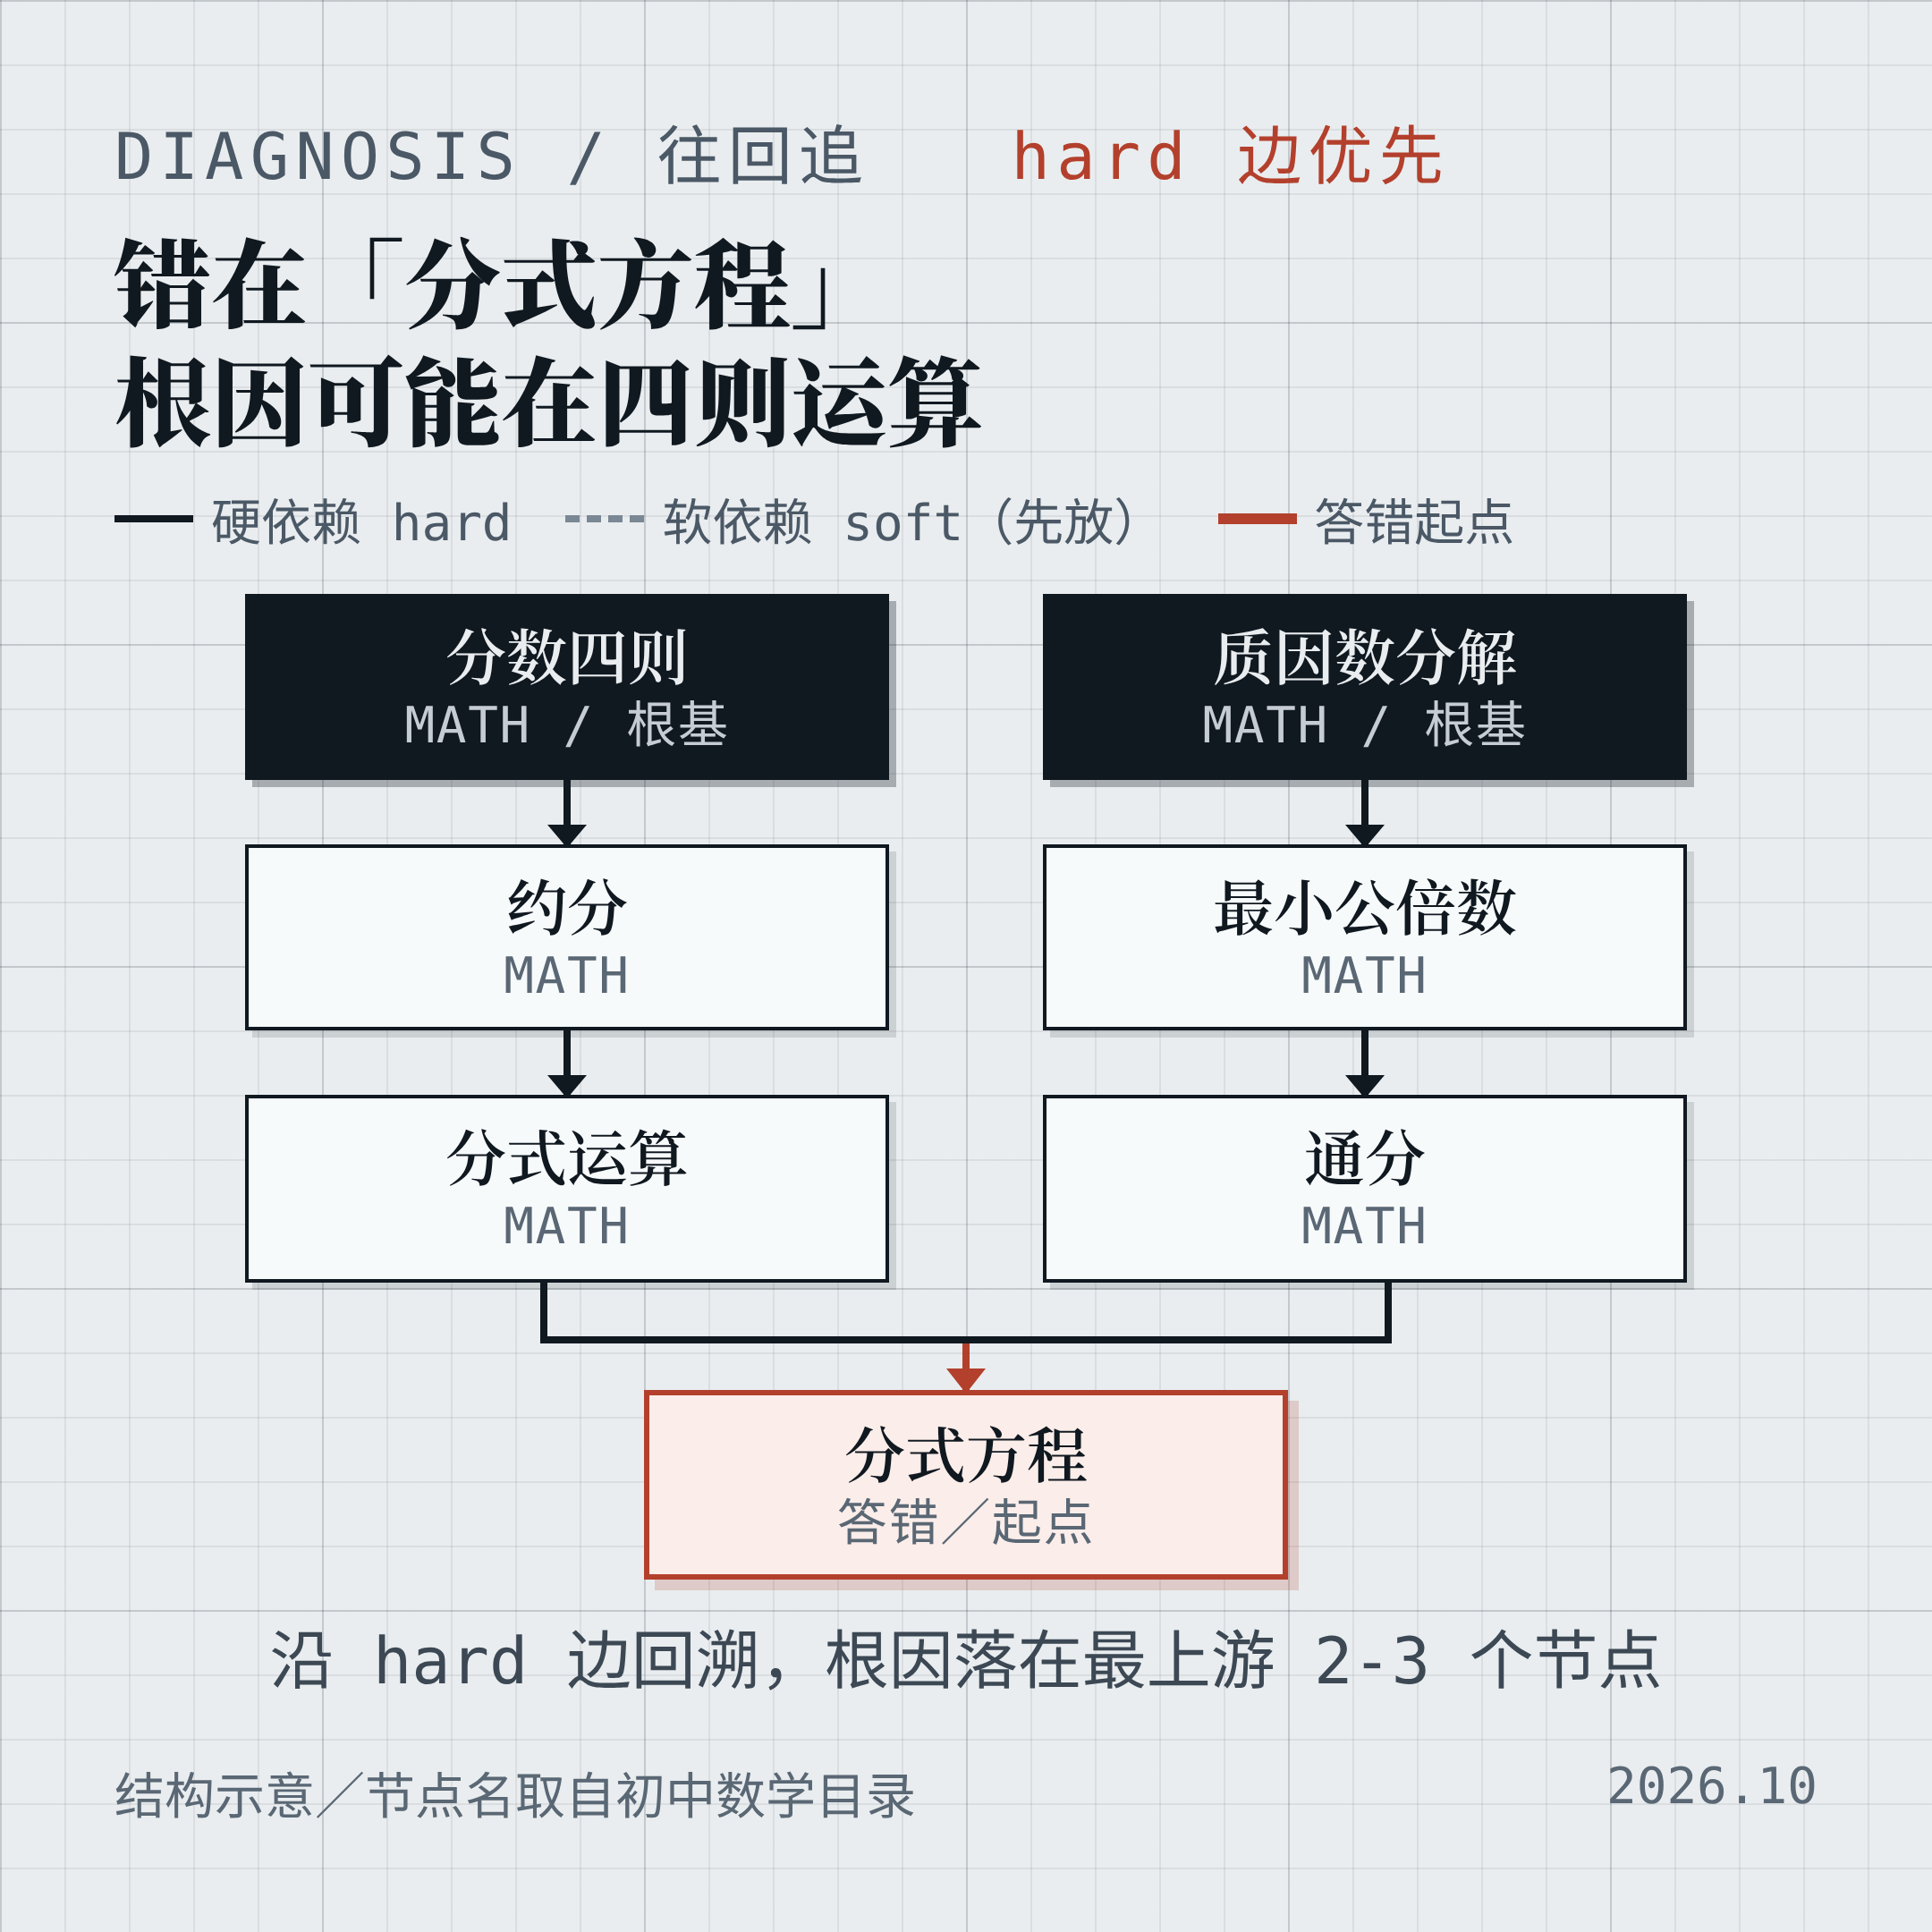
「hard / soft」这个区分是这张图最有价值的部分,也是最容易被忽略的部分。
- hard:不会 A 就学不了 B。比如不会分数四则运算,分式运算基本无从谈起;
- soft:会 A 对学 B 有帮助,但不是门槛。比如会用计算器,对理解小数除法有好处,但没有也不挡路。
回溯时 hard 边优先,soft 边先放。这一条让诊断结果从「你有一堆洞」变成「先补这两个,其他的以后再说」。对学习者来说,前者是打击,后者才是路径。
图还有两个工程上的必要条件:节点 id 唯一、边两端必须存在、不能有自环、整张图不能有环。仓库里的 validate.py 每次提交都跑这四项。原因很实在——先修关系一旦成环,诊断就会无限回溯,页面直接卡死。依赖图的第一行代码不是查询,是环检测。
三、五条规则,构成一个能用的诊断闭环
把引擎规则逐条拆开,其实就五条:
- 连续答对才判掌握:默认 3 题,掌握后跳过它全部祖先节点,不重复消耗时间;
- 答错先出确认题:确认对判「不稳」,确认错判「薄弱」;
- 回溯 hard 优先:先追硬依赖,软依赖只记录;
- 难度流转:首题标准难度,连对后出挑战题做确认,答错先补基础题;
- 输出四样:薄弱清单(标最上游根因)、不稳清单、按年级排序的学习路径、对应课标原文。
第 5 条最容易被做成「给个分数就完事」。但一个诊断如果不告诉你下一步做什么、以及凭什么这么说,它就只是评分,不是诊断。
这也是我觉得这套结构值得抄的原因:它把「结论」和「依据」绑在了一起。课标原文、年级位置、先修理由,都跟着结果一起出来。你可以不同意它的判断,但你知道它在拿什么做判断。
四、真正值钱的不是 K12,是这套结构
把教育的外壳去掉,剩下的是三个可复用的部件:
① 依赖图:任何有「先会 A 才会 B」关系的领域都能用——乐器技巧、编程语言特性、产品功能模块、甚至一份文档里的概念依赖。
② 确认机制:一次失败不算数,用一次低成本的复测区分「偶发」和「系统性」。这是所有诊断系统都该有的降噪步骤。
③ 最小可修复点:不追求把整条链补齐,只输出最上游的 2-3 个根因。修复成本低,反馈快,人才愿意继续用。
放到工程场景里,这就是一份排障树:报错是叶子,根因是上游节点,hard 边是「不解决它后面一定复现」,soft 边是「相关但可以先绕过」。放到内容或产品上,它也能回答一个常见问题:用户卡住的那一步,到底是哪一步?
五、三条边界,用之前必须先看
这套东西做得不错,但它的边界写得很清楚,读的时候不能略过。
第一,许可证是 CC BY-NC 4.0,禁止商业使用。 拿它做课程推荐、自适应练习产品,需要另外获得授权。GitHub 的 license 字段显示的是 NOASSERTION,只有 README 的 badge 才露出真实协议——这种地方最容易踩坑。
第二,仓库自己声明:这是 AI 生成的初稿,未经任何教师审核。 先修关系的强弱、掌握标准、题目答案,都还需要一线教师过一遍,才适合真正用于教学和路径推荐。
第三,质控是分层的,不是全量。 仓库里的核验报告显示,9,399 道题里格式错误为 0,自动核验覆盖 8,867 道(94.63%),不一致为 0,另有 532 道无法自动核验、逐条列出了 ID。小学数学题做了自动核验和独立程序复核,初中数学另有盲解复核,高中与英语题没有盲解。课标条文的高中部分也标了「非逐字引用、页码待核」。
换句话说:它是一张很好的地图,但不是一本可以照本宣科的教材。 地图能告诉你往哪走,不能替你确认路上有没有坑。
六、怎么用:四个动作
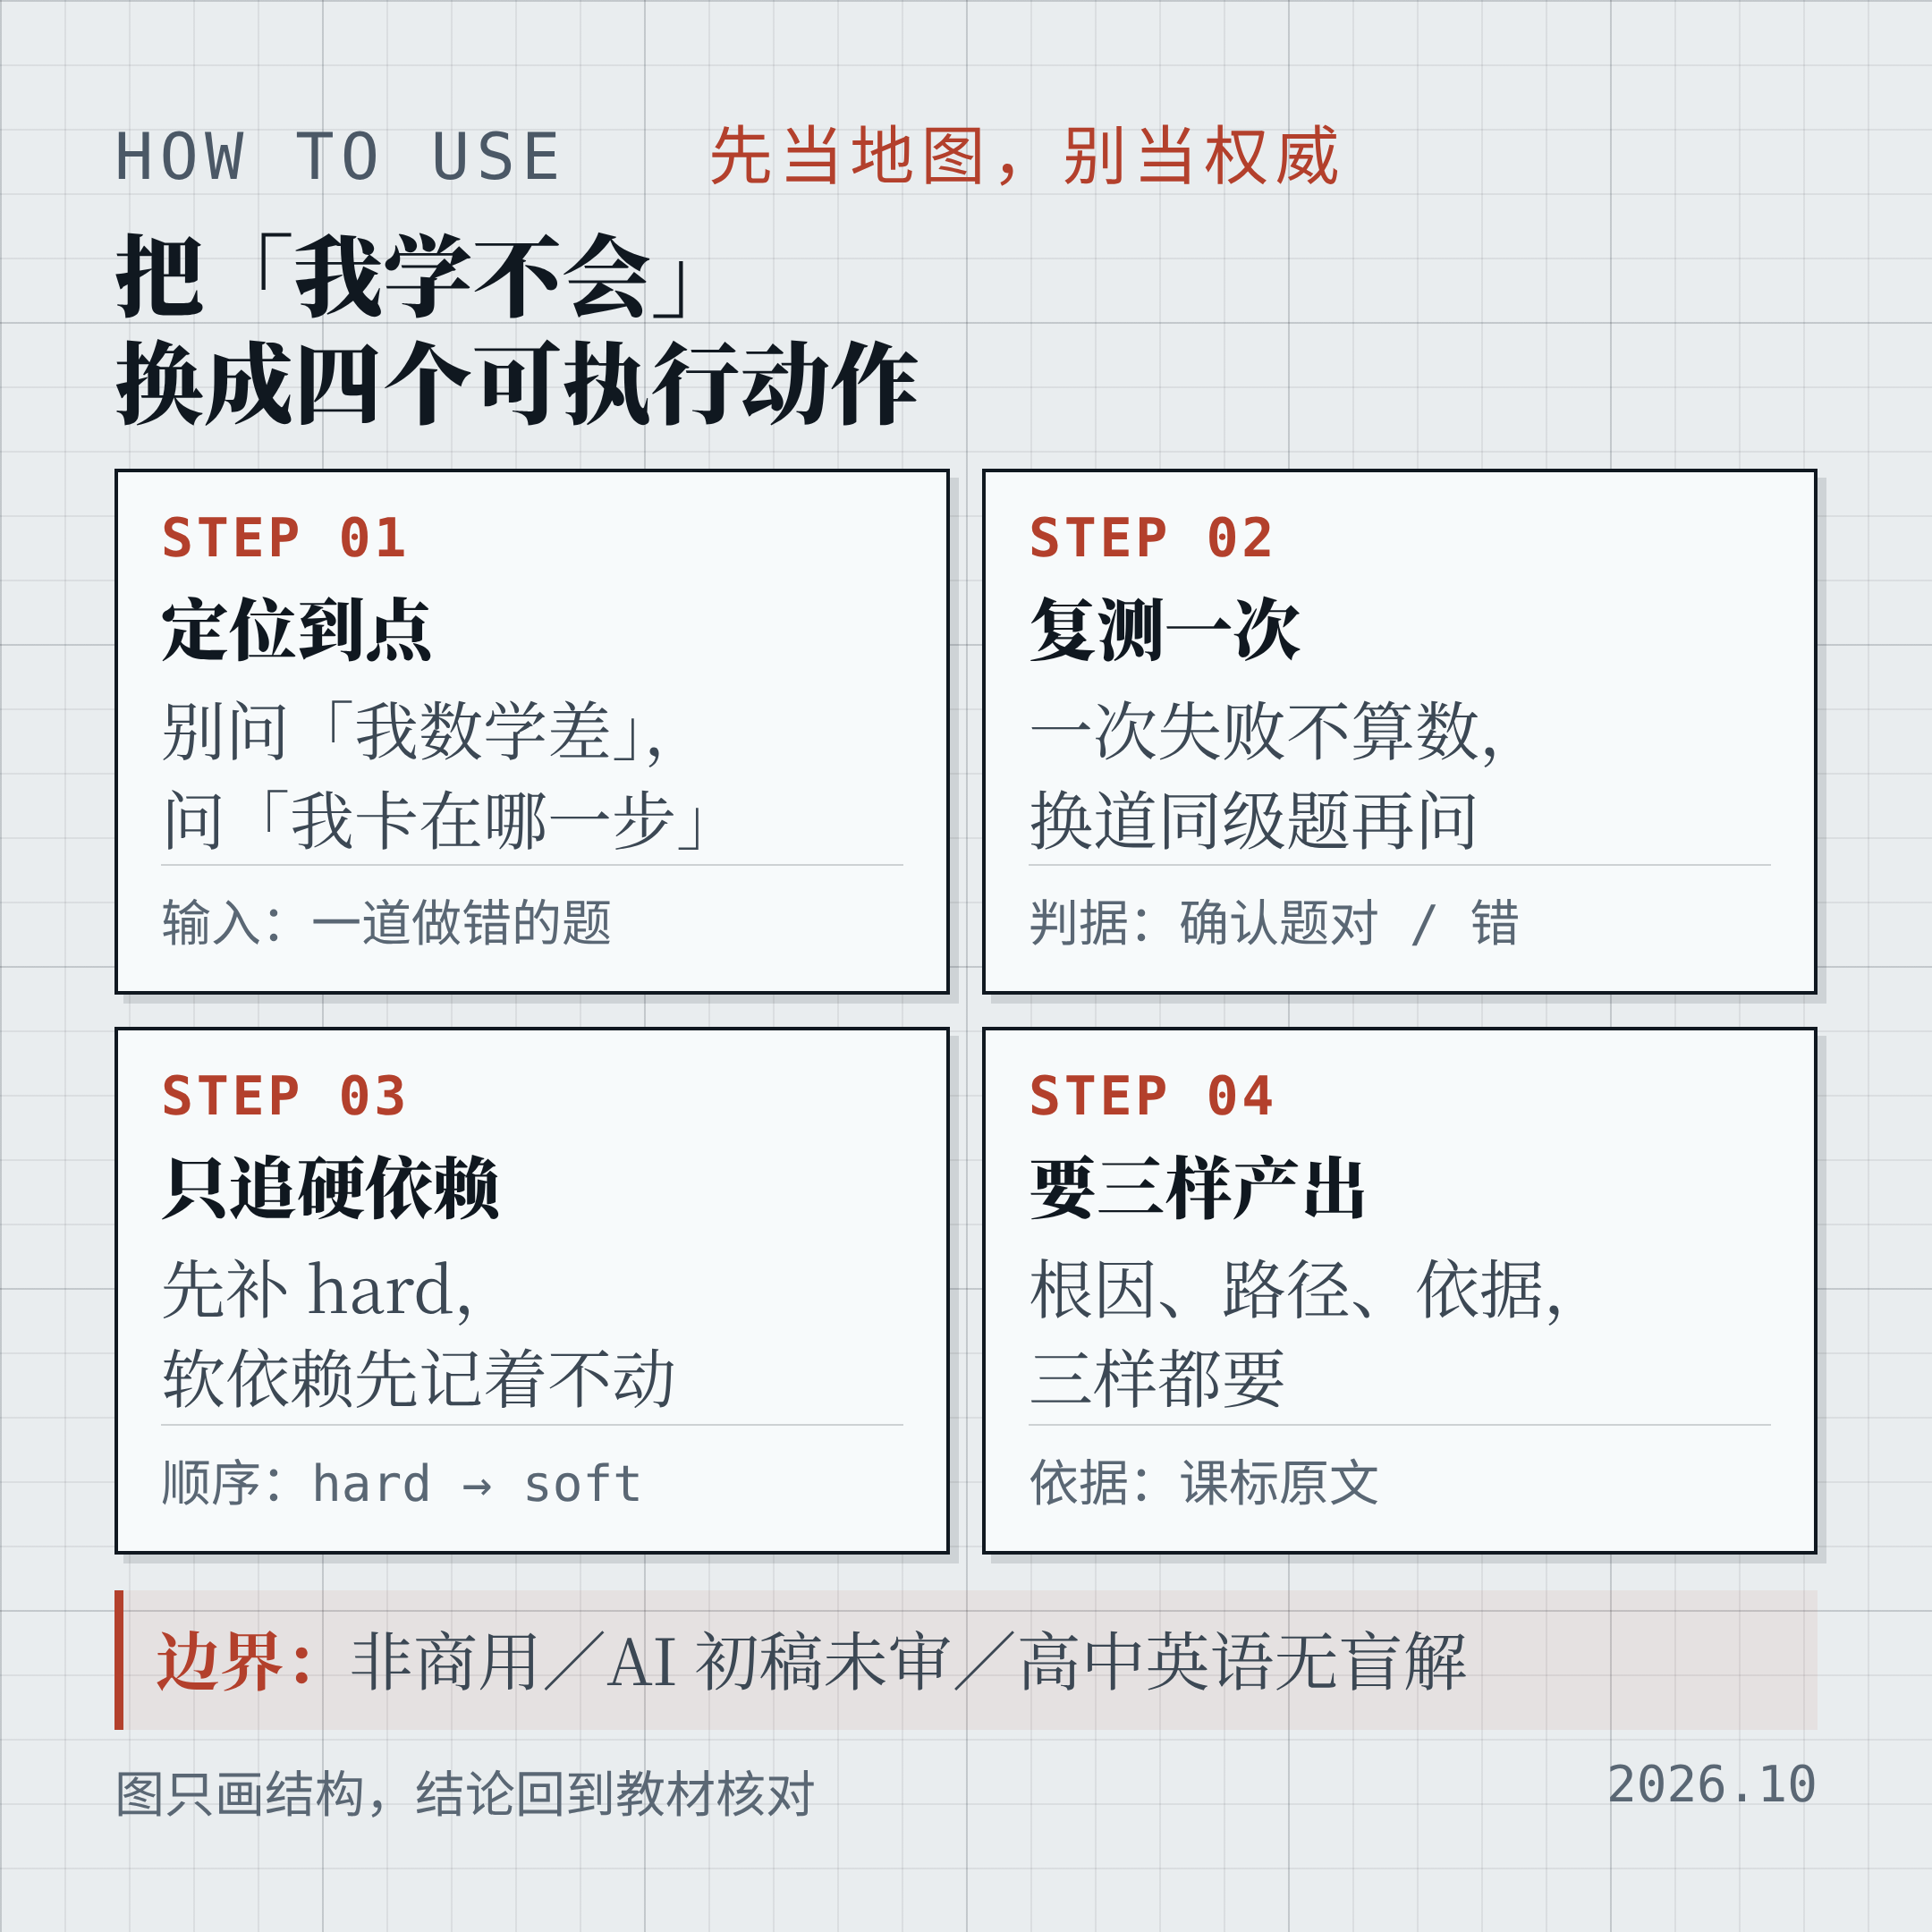
如果你不想部署整套系统,只借用它的思路,可以按这四步做:
- 定位到点:别问「我数学差」,问「我卡在哪一步」。一个具体知识点,才追得动。
- 复测一次:一次失败不算数,换一道同级题再问,排除手滑,再决定要不要补基础。
- 只追硬依赖:先补不补就学不下去的那几个,软依赖先记着,不打断当前进度。
- 要三样产出:根因(2-3 个)、路径(按年级或按依赖顺序)、依据(课标或文档原文)。少一样都不算诊断。
回到开头那个问题:为什么一个「整理知识点」的项目能十天涨到 4,624 星?
我的判断是,它踩中了一个普遍痛点——大多数学习产品在解决「讲得清不清楚」,少数在解决「知不知道该学什么」,几乎没有在解决「怎么知道问题出在哪」。 而后者,恰恰是每个卡住的人最想问的。
诊断的价值,从来不是给出答案,而是把「我不行」缩小成一个具体、可修的点。
本文只做工程结构拆解,不构成对任何学习效果的承诺。数据来源:GitHub 仓库 xiaoyang111222/cn-math-taxonomy(2026-10-28 当日读取)、仓库内 topics.json / dependencies.json / questions.json / diagnose/engine.js / data/verification_report.json、README 与 LICENSE。星数为 2026-10-28 16:15 前后快照,会继续变化。