DeepSeek 没变笨:OpenCode 把同一个模型,分给了 8 台服务器
深夜十一点,你已经跑了四十五分钟。
Bug 找到了,修法也想清楚了。然后模型开始原地打转:重复刚才的推理,怀疑自己三步前的判断,最后忘了自己要改哪个文件。
你盯着屏幕,第一反应是「这模型今天怎么这么笨」。
第二反应是「是不是给我换了个便宜版本」。
这两个反应,可能都不对。
真正发生的事情更无聊,也更值得知道:你选的不是一台服务器,是一个名字。 名字背后站着八套配置不同的后端,路由器把每个请求分给其中一个。你偶尔撞上的,是那台不擅长长对话的机器。
这不是「AI 公司良心坏了」的故事。它是一个关于平均值如何骗人的故事。
一、先把最流行的指控证伪
社区里最响的指控是:厂商偷偷跑了一个压缩版模型。
逻辑听起来很顺:价格这么低,肯定是在权重上动了手脚,把 4-bit 压到更低,换出一个「看起来像 DeepSeek、其实更笨」的模型。
这个指控在 DeepSeek V4.1 Flash 上不成立。
原因有点反直觉:这个模型官方发布的时候,专家权重本来就是 4-bit。 它采用 763B 参数的混合专家架构,每个 token 只激活其中约 16B;官方下载包是 551GB,而不是全精度的 763GB。也就是说,所谓「激进压缩」这一步,DeepSeek 自己已经做完了。
再往下压,不是「悄悄优化」,而是会在基准测试里现形。
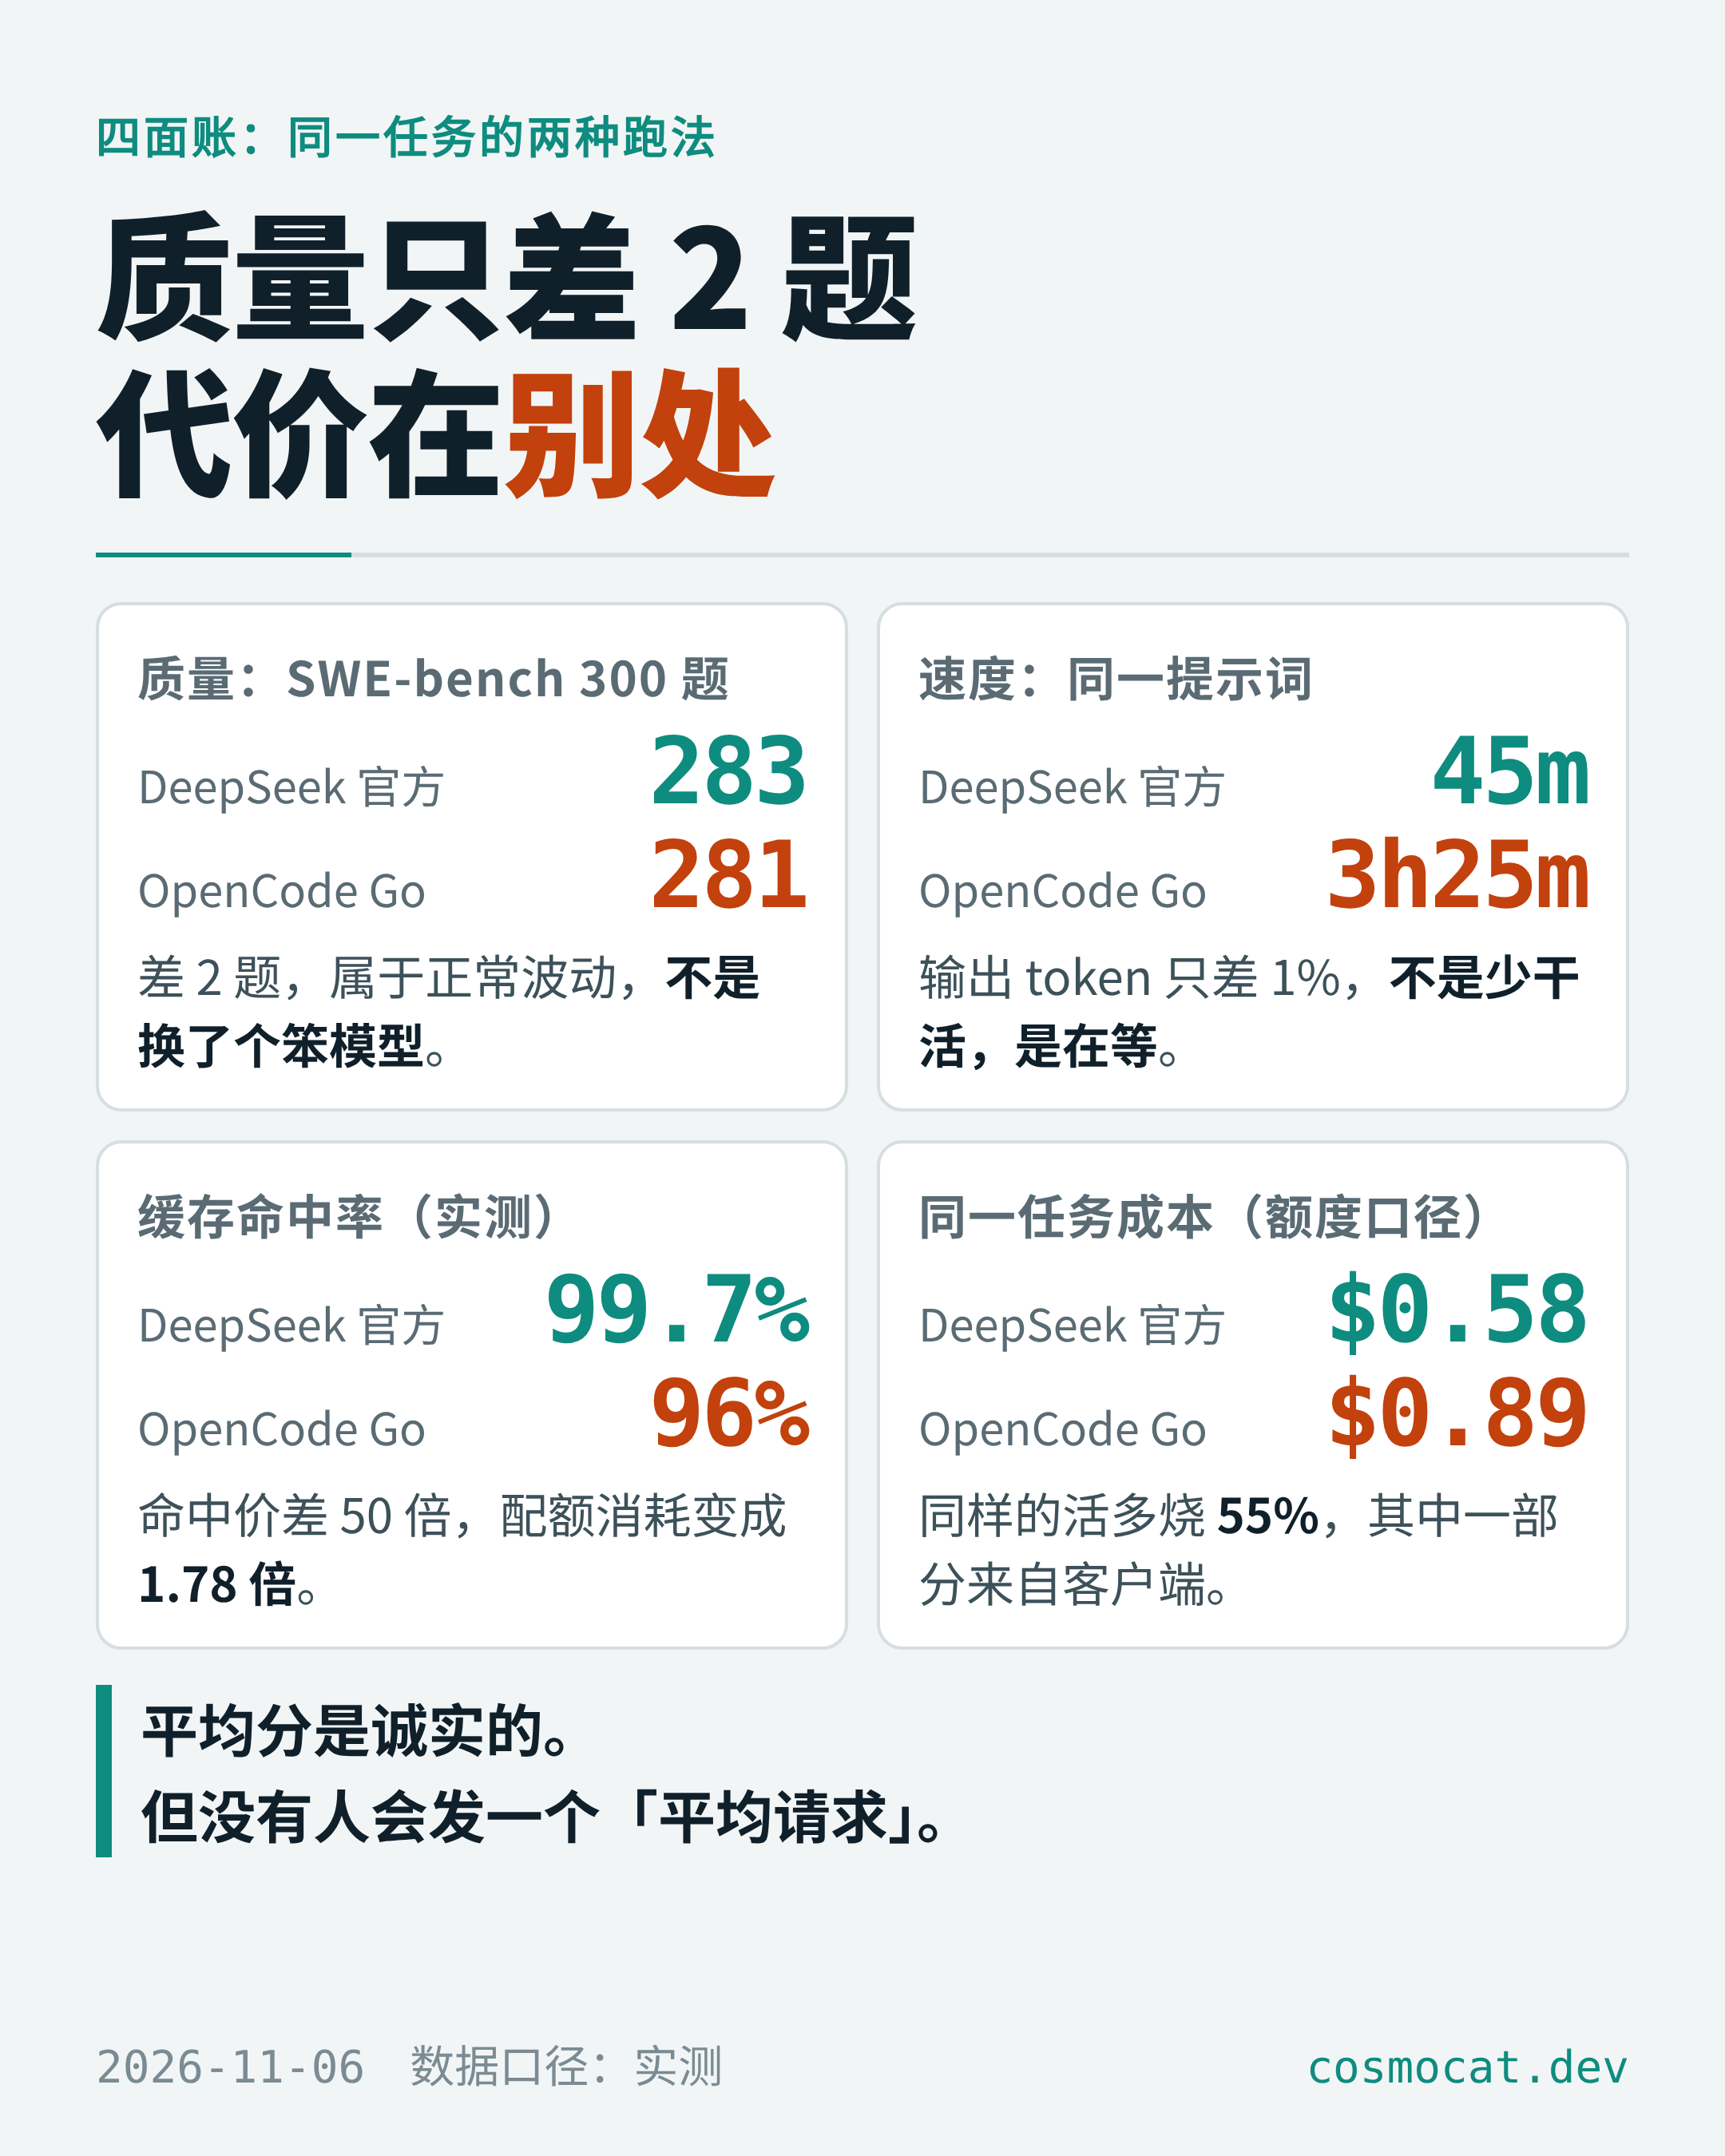
一位开发者拿 SWE-bench Verified 的全部 300 个任务跑了两边:官方 API 解决 283 个,OpenCode Go 解决 281 个。
差 2 个。
这不是「换了个笨模型」的差距,这是同一梯队在两次考试里的正常波动。
连最早发视频吐槽「被量化」的那位用户,后来也公开更正了:之前说量化,是错的。
所以问题不在权重。问题在别处。
二、一个名字,八台服务器
OpenCode Go 的定价页写着:每月 10 美元,约 30 个模型,按每个模型的美元额度扣费。DeepSeek V4.1 Flash 的额度是 100 美元——不是打错字,10 美元买 100 美元的 DeepSeek 用量。
官方算过一笔账:按 DeepSeek 自己的价目表,一次典型的编程会话(输入约 7.17 万 token),5 小时窗口能发约 4300 次请求。
这个数字被截图、被转发、被质疑「不可能」。
质疑的人没错,但质疑错了地方。
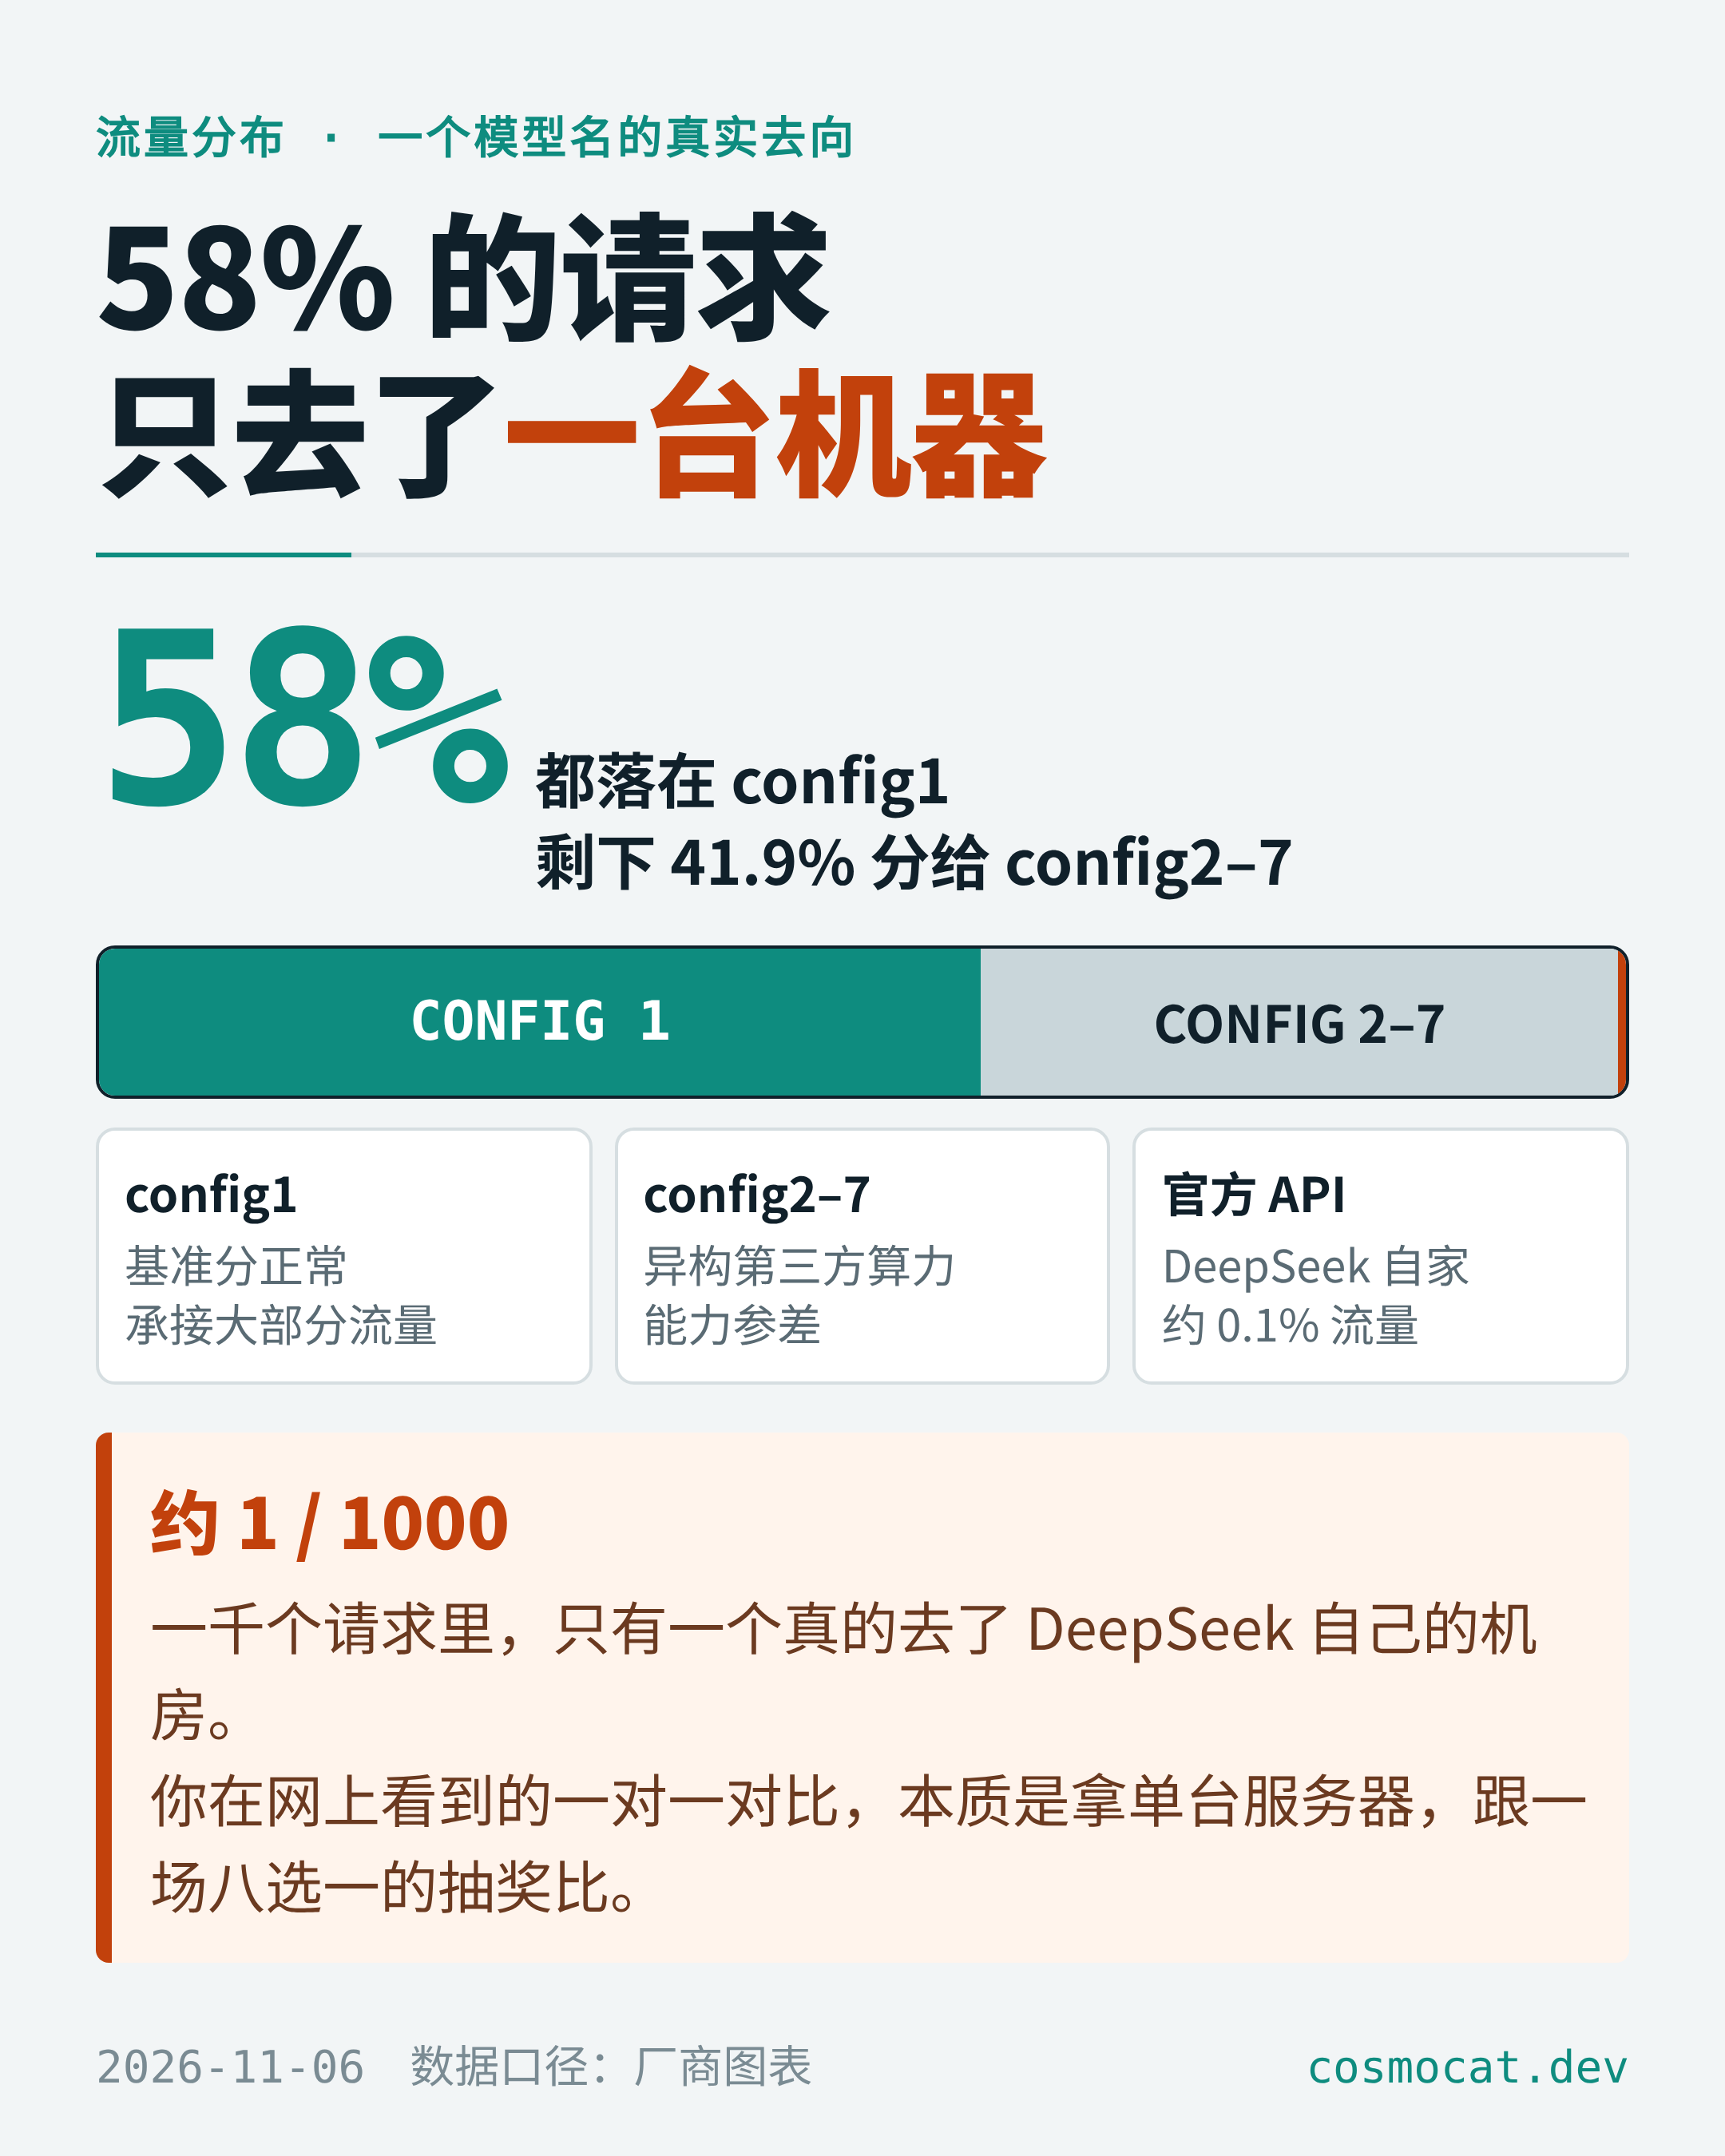
创始人在 10 月公布的一张图里,多了一列几乎没人注意的东西:流量(traffic)。
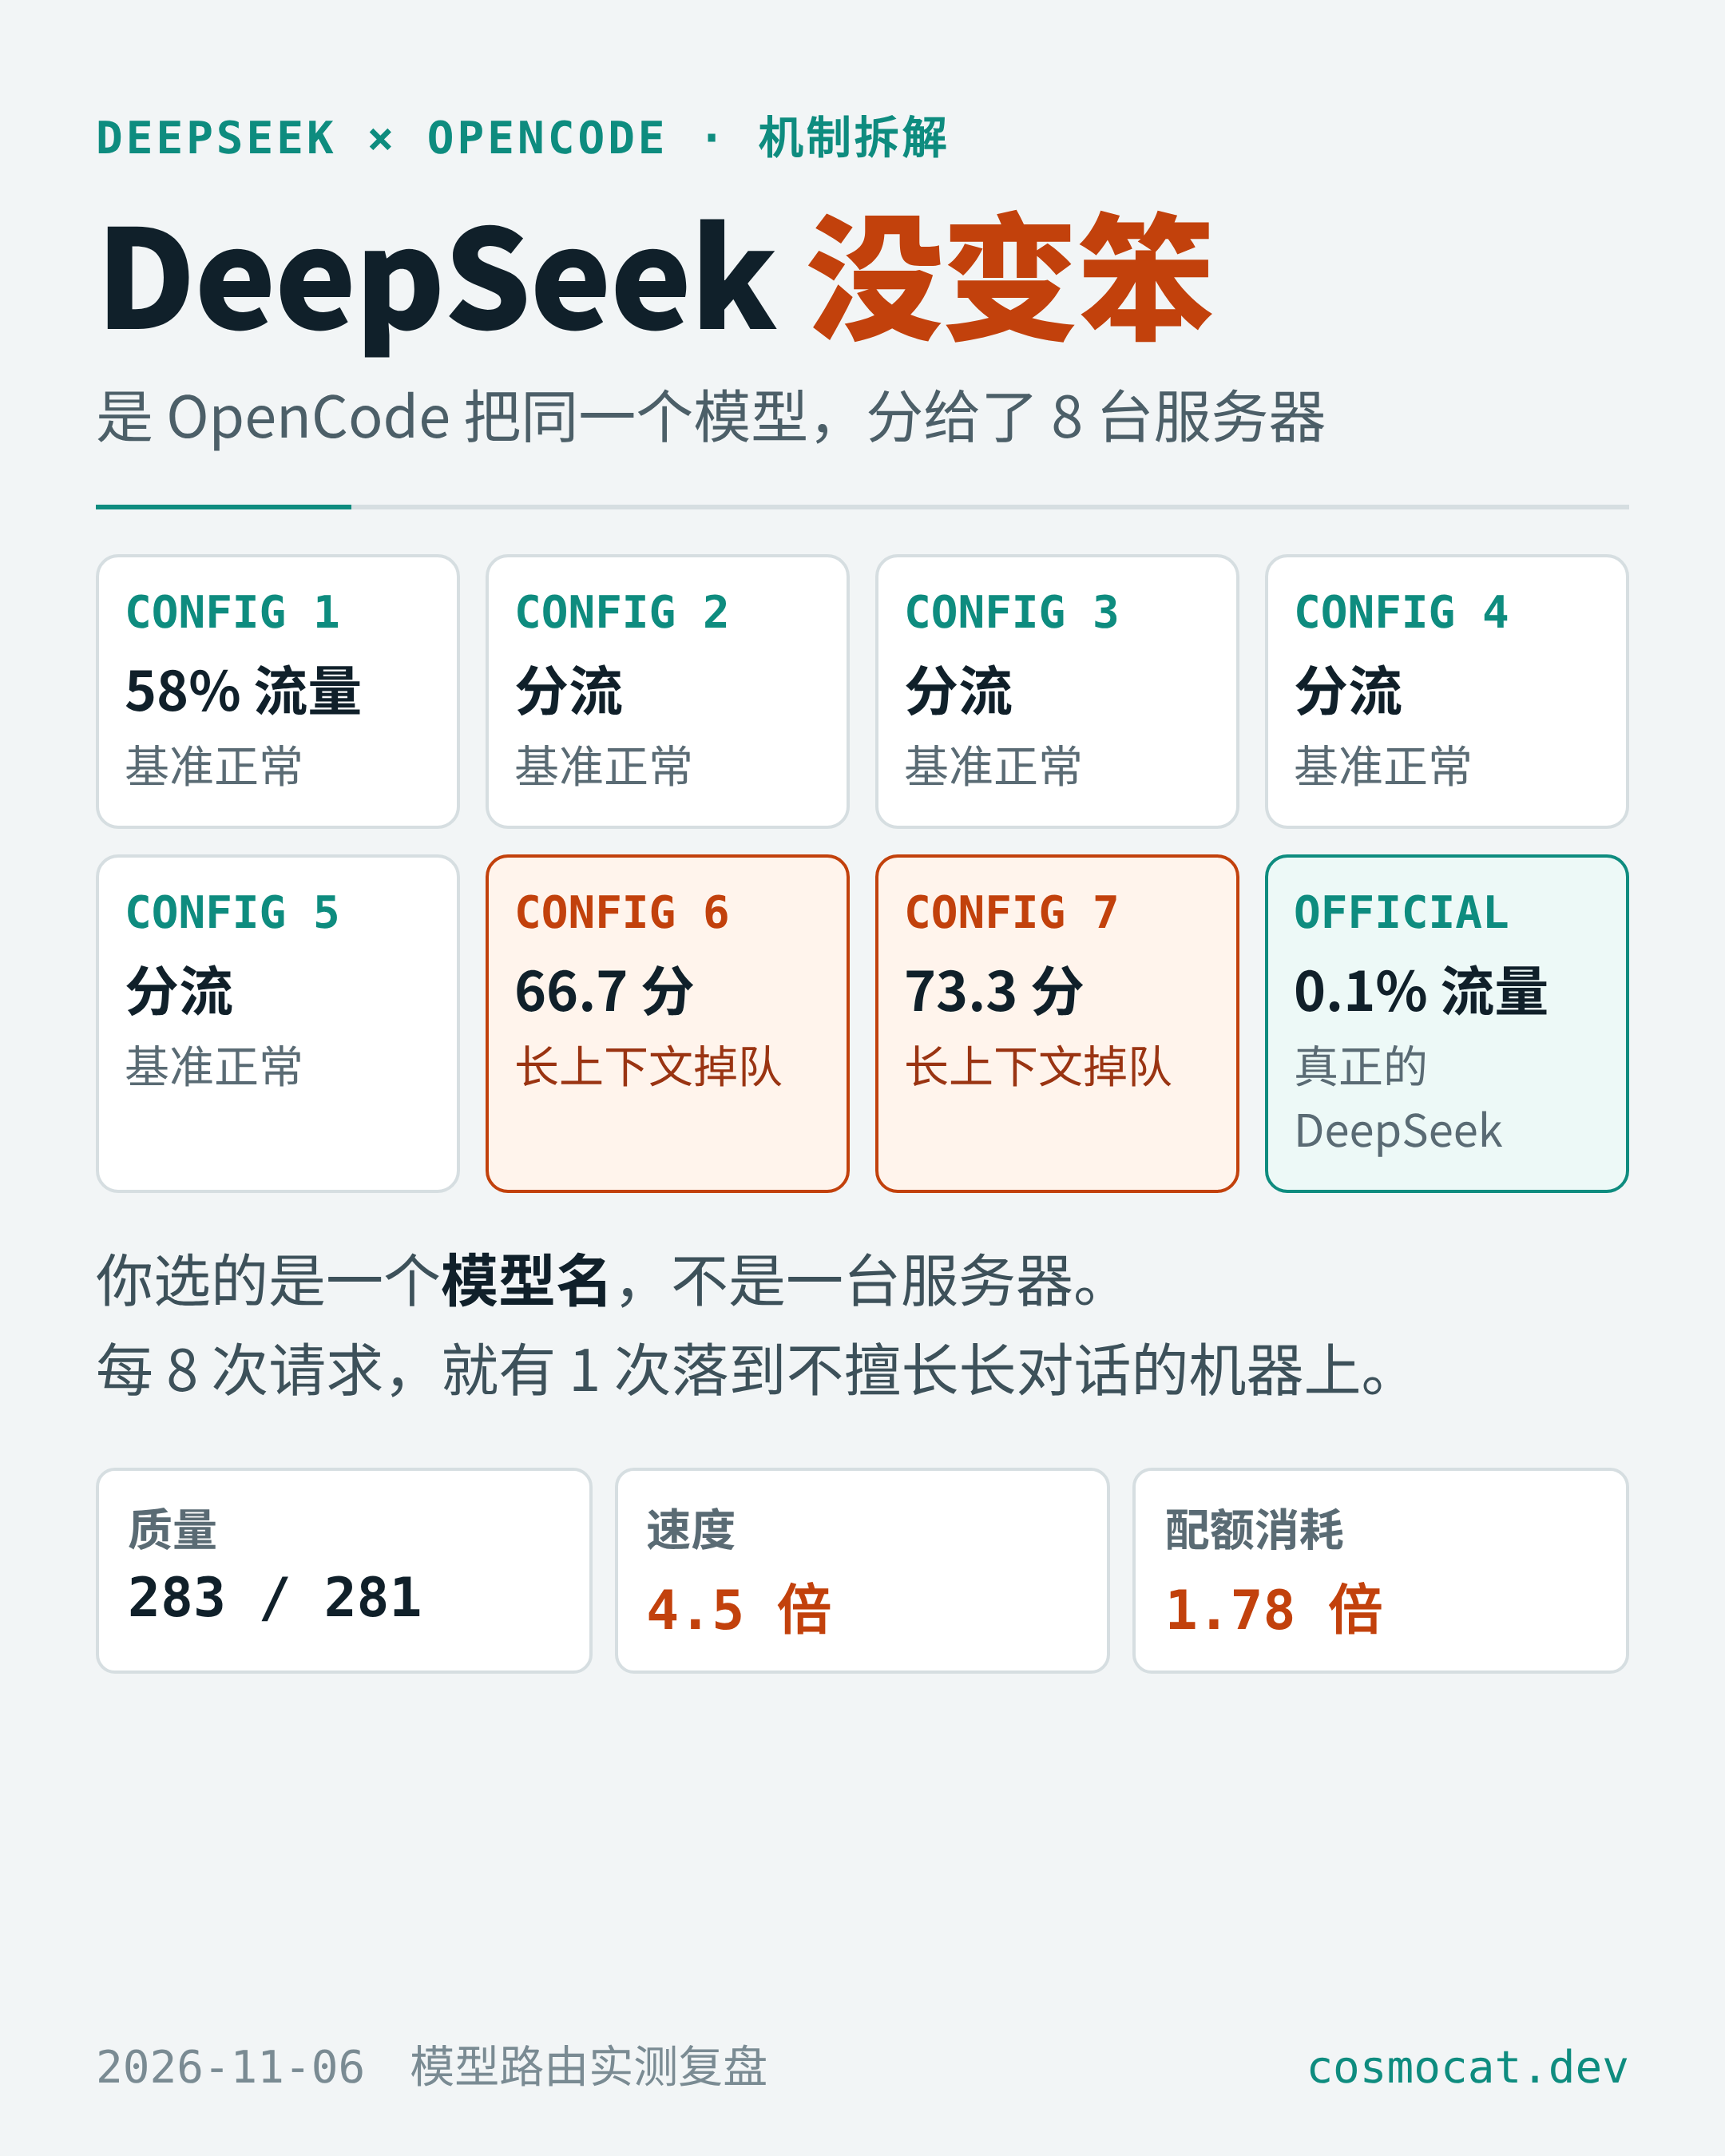
它揭示的机制是:当你在 OpenCode Go 里选 DeepSeek V4.1 Flash,你选的不是一台服务器,而是一个名字。后台有一个路由器,把每个请求分给 8 种配置之一——硬件不同,供应商不同。有些是签了批量协议的第三方算力,有些是 OpenCode 自己的机架。
流量分布是这样的:config1 吃掉 58% 的请求,config2 到 config7 分走剩下的大部分,而标注为「DeepSeek 官方」的那一行,只拿到约 0.1%。
一千个请求里,大约只有一个真的去了 DeepSeek 自己的机房。
所以你在网上看到的所有「一对一对比」,本质上都是拿单台服务器,去和一场八选一的抽奖比。
三、平均值是诚实的,但没人发平均请求
把创始人的流量分布,乘上他公布的各配置基准分,会得到一个很漂亮的数字:Go Plus 加权平均 90.48,DeepSeek 官方 90.5。
统计上,这是一回事。
创始人说「Go Plus 的平均请求表现和 DeepSeek 一样好」,这句话没有撒谎。
但接下来是整件事的核心:没有人会发一个「平均请求」。
你发的是你的请求。在你的会话里,在那个当下。
平均值可以完美,特定区间可以完全崩掉。就像一条河平均水深三英尺,不代表没人会在里面淹死。
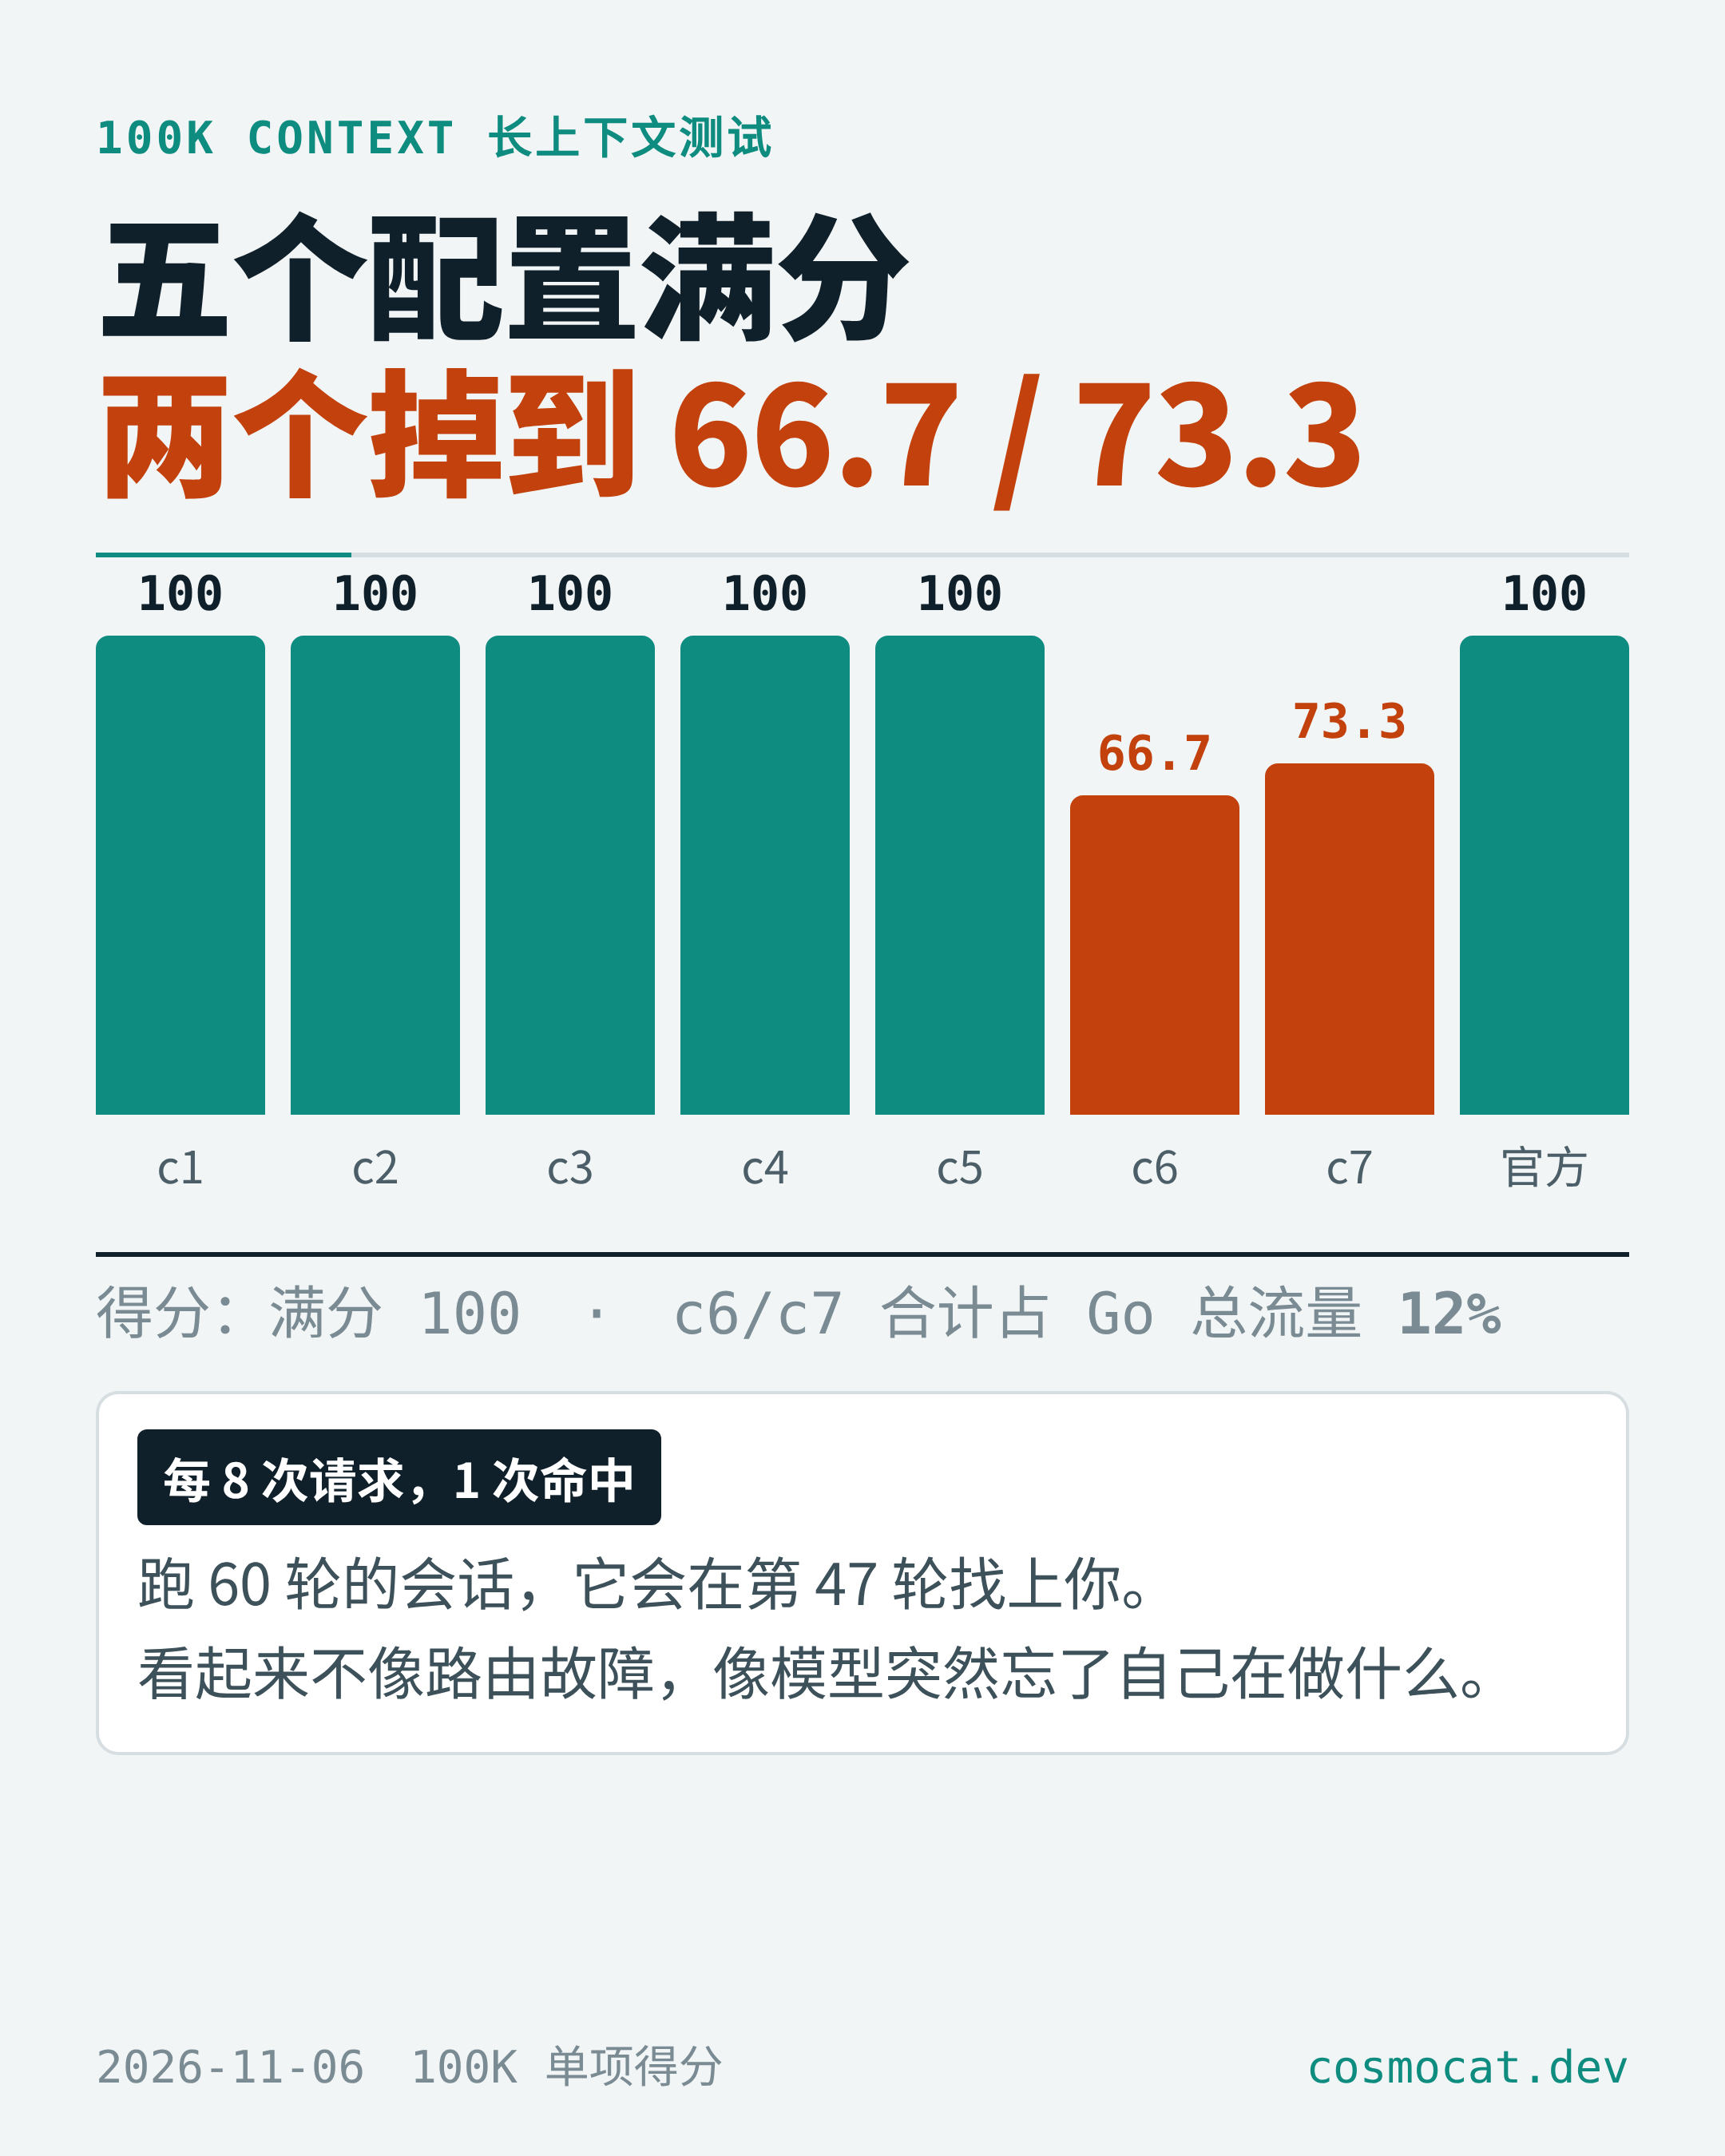
八套配置里,有一项测试和别的都不一样,叫 100K context:检查对话长度到 10 万 token 时,模型还能不能正确工作。
八个配置里的五个,加上 DeepSeek 官方 API,得分都是 100。
config6 得 66.7,config7 得 73.3。
也就是说,这两种配置在长上下文任务里,有四分之一的活干不成,最差的那个接近三分之一。
而它们俩加起来,占 Go 总流量的 12%。
每八次请求,就有一次被送到「不擅长长对话」的机器上。
创始人承认了这一点,说这是两个低流量配置的特定问题,将被移除。但问题是:外部没有任何人能核实它们是否真的被移除了,因为没有公开的逐配置审计。
四、为什么偏偏是「第 47 轮」变笨
这里要理解编程 Agent 的工作方式。
它不是只发你最后那句话。每一轮,它都会把完整的对话历史重新发一遍。定价文档里的假设是:一次 DeepSeek 请求携带约 7.17 万 token 输入。
普通聊天用户几乎永远碰不到 10 万 token。但一个跑了两小时的 Agent 会话,每一轮都在那个量级附近。
所以 12% 的尾部流量,落到重度用户身上,不是「偶尔命中一次」。
它会在一场 60 轮的会话里,命中在第 47 轮。
而在你看来,它不像一次路由故障。它像模型突然变笨、忘了自己在做什么、开始原地打转地推理。
这就是为什么「变笨」从来不是错觉,而是尾部效应。
五、4.5 倍的等待,和两次三分钟的冻结
同一个提示词、同一个测试框架、同样的推理力度,一边走官方 API,一边走 Go。
官方 45 分钟跑完。Go 花了 3 小时 25 分。
4.5 倍。
但先别急着下结论:看输出 token,官方 226,572,Go 224,378,差距在 1% 以内。模型干的活是一样的,它只是在等。
等在哪里?
首 token 延迟的 P95,Go 是 7.57 秒,官方是 7.58 秒,几乎一样。只看这个数,你会说「两边相当」。
但平均首 token 延迟,Go 是 8.08 秒,官方是 4.24 秒,整整翻倍。
差异来自两个请求:它们分别卡了 195 秒和 256 秒才返回第一个 token。
没有报错,没有超时,什么都没有。你就盯着一个冻结的终端,三分钟,然后它突然又开始工作了。
P95 看不见运行中的两次异常停顿,基准平均数也看不见。只有当你自己成为那个等待的人,你才知道。
六、缓存命中率:一条 50 倍的隐形税率
现在说钱。
一次 Agent 请求的 7 万多 token 里,几乎全是上一轮已经发过的对话历史,只有一点点是新内容。
如果服务端还留着这段上下文,重复 token 按「缓存命中」计费;如果没有,就按「全新输入」计费。
在 DeepSeek 的价目表上,全新输入是每百万 0.15 美元,缓存命中是每百万 0.003 美元。
差 50 倍。
官方那 4300 次/5 小时的估算,背后有一个默认假设:99.4% 的请求都是缓存命中。
实测呢?
Go 的实际命中率是 96%,官方 API 是 99.7%。
看起来只差 3.7 个百分点。但在 50 倍的价差下,99.4% 掉到 96%,意味着同样请求的配额消耗变成原来的 1.78 倍。
4300 次,实际只相当于 2400 次左右。
换成钱:同一个任务,官方 API 花 0.58 美元,Go 的额度口径花 0.89 美元。
同样的活,多烧 55%。
七、一个请求头,决定你多花一半钱
最扎心的是:这 55% 里,有相当一部分可能不是厂商的锅,是你客户端的锅。
OpenCode 的文档里描述了一个特殊的请求头,作用是:客户端在每次请求里带一个稳定的会话 ID,路由器才知道「这个请求和上一个属于同一场对话」,从而尽量把它送回仍然缓存着这段上下文的服务器。
没有这个头,路由器就是盲人摸象。请求可能落到任何一台机器;那台机器从没见过你的对话,所有内容都按全新输入计费,缓存命中率掉下去,预算跟着缩水。
文档列了能正确处理这个功能的客户端:OpenCode 自己、Claude Code、Codex、Hermes。
而在「已知问题」列表里,有些客户端在某些路径下会丢失会话信息。
巧的是,做那次 4.5 倍速度测试的开发者,用的客户端正好在问题名单里。
这也解释了为什么同样的服务,不同人测出来的缓存命中率差那么多——他们测的不是同一个东西。
所以在你怪模型之前,先查一件事:你的客户端,到底有没有把会话头发出去。
一个 header 的收益,可能比换一家服务商还大。
八、思考税:同一张嘴,为什么更爱想
还有一层更隐蔽的成本。
同一模型、同样设置,Go 生成的内容里,51.2% 是推理 token——也就是模型回答前的内部思考链。官方 API 的这个比例明显更低。
按实际返回的有效内容算,Go 为了给出同样的最终答案,要多写 25% 的输出 token。
其中 63% 是思考部分。
而思考按输出计费,每百万 0.60 美元,是缓存命中价格的 200 倍。
模型想得越多,你被两头夹击:token 数量更多,而且用的是最贵的那一档。
为什么同样的模型、同样的投入设置,会更爱想?
最善意的解释:某些配置的默认 effort 设置不一样。
更让人担心的解释,也是大家实际观察到的:会话一旦落到坏掉的长上下文配置上,模型就迷失方向,开始原地打转地推理;一个困惑的模型会生成更多思考,试图理清思路,而这些你都得付钱。
让模型犯迷糊的那次请求,会让你付两次钱:一次是 token,一次是时间。
九、把账算到底:最坏情况,仍然便宜
讲到这里,故事该反转了。
拿最坏的那次测试算:多耗 55% 的额度,慢 4.5 倍。
在官方 API 上,10 美元够跑这项任务 17 次。
在 Go 里,10 美元换 100 美元额度,够跑 110 次。
即便处处受罚,同样的 10 美元还是换来 6.5 倍的工作量。扣掉现金惩罚,那 100 美元额度折算成 DeepSeek 的实际用量,价值仍约 65 美元。
所以这里没有人被坑。
它确实在打折,只是折扣没有宣传的那么大。
这也解释了商业模式:8 月公布的数据是 30.1 万名 Go 活跃订阅,每人 10 美元,月收入约 300 万美元。如果每个人都把 100 美元额度用满,按牌价算,OpenCode 每月要付 3000 万美元。
差距靠三件事填平:批量折扣、预留 GPU、以及大多数人用不满。
这和健身房、云存储、自助餐是同一套模型,也是订阅制最古老、最成熟的那一套:只要平均用户不把额度用满,它就成立。
钱买的是使用设备的权限,不是保证的效果。
十、谁该走,谁该留
所以,OpenCode Go 到底是不是骗局?
不是。
它卖给你的 DeepSeek,单价只有官方的十分之一,平均用的也确实是同一个模型。
它没卖给你的,是一致性:每次都是同一台服务器、同样的延迟、同样的缓存行为。
长尾效应是真的,评论区的骂声也是真的。但不稳定和欺诈是两码事。
该走的,是这一类人:
让 Agent 无人值守跑几个小时,上下文经常超过 10 万 token。你就是那个「八分之一」。一次四分钟的卡顿,或一轮混乱,损失的不只是那一轮——模型会在退化的上下文里继续工作,后面的每一轮都被污染。
对这类人,直接去用 DeepSeek 官方 API。同一个模型,同一张价目表,实测命中率 99.7%,没有莫名其妙的停顿。
该留的,是另一类人:
做业余项目,晚上玩一玩,跑点短的 Agent 任务,或者探索性编程。Go 目前仍然是 AI 编程里性价比最高、体验也不差的位置。
如果你在做按小时计费的活,逻辑更简单:一次糟糕的运行耗时是平时的 4.5 倍,一个下午的可计费工时,就把订阅省下的钱赔光了。
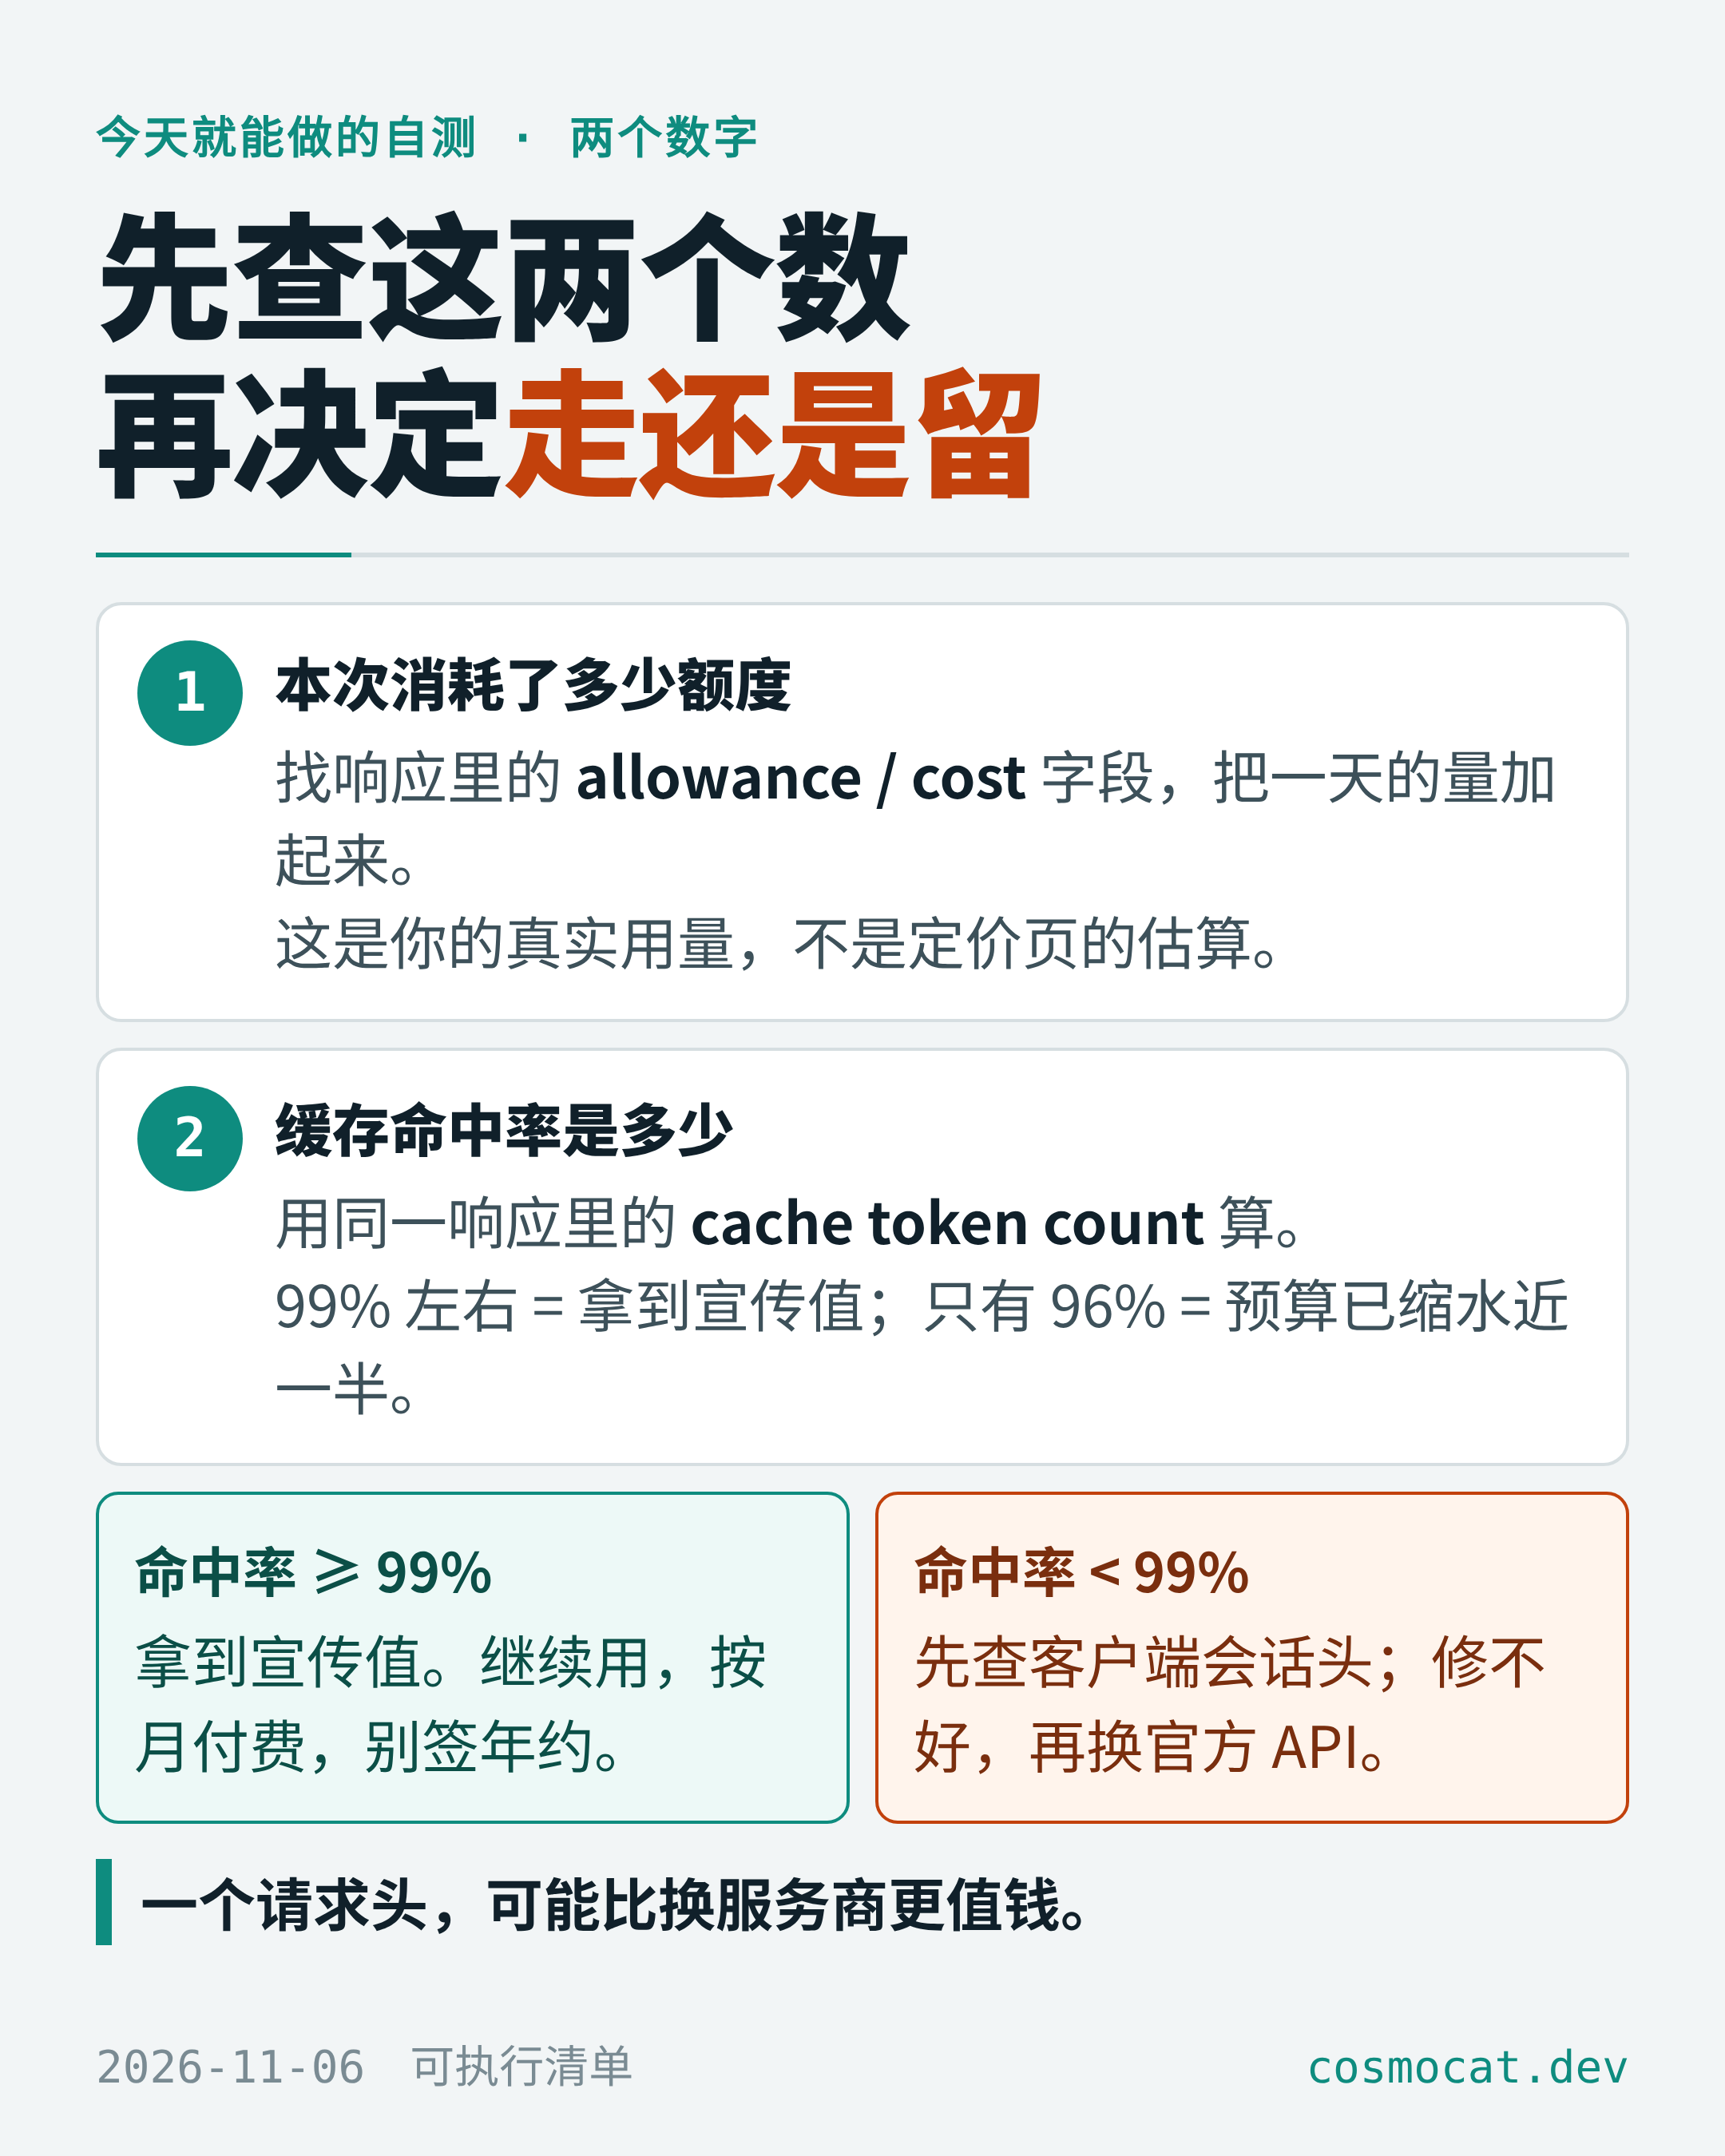
十一、两个数字,今天就能自测
不用信我,也不用信任何测评。你自己有两个数字可以查。
第一个数字:每次响应的 allowance / cost 字段。
它代表这次具体请求消耗了你多少预算。把正常工作日全天的数据加起来,你就知道这 10 美元买了多少真实用量,而不是定价页上的估算。
第二个数字:同一个响应里的 cache token count。
用它算缓存命中率。如果你在 99% 左右,你拿到的就是他们宣传的那个;如果你只有 96%,预算已经悄悄缩水近一半,大概率是客户端没正确发送会话头。
先修 header,再考虑换服务商。
顺序反了,你会花两次钱。
最后
我们习惯把「服务不稳定」理解成「厂商在骗我」。
但这两件事之间,隔着很多层工程细节:路由、缓存亲和、默认参数、后端异构。
理解这些细节,不是为了替谁辩护,而是为了知道自己手里的钱,到底买到了什么。
平均值一直很诚实。问题在于,没有人按平均值写代码。
来源与说明:本文观点与数据整理自 Kai 的公开测评《Is OpenCode Go a scam? (Stop Using)》(2026-11-04),引文为中文译文;其中流量分布、各配置基准分、100K 上下文得分、延迟与 token 数据来自该测评引用的厂商公开图表与开发者实测,部分数字未获第三方独立审计;缓存单价与倍数关系按文中价目表反推校正。本文为产品机制分析,不构成购买建议,也不构成对任何公司的指控。
相关阅读