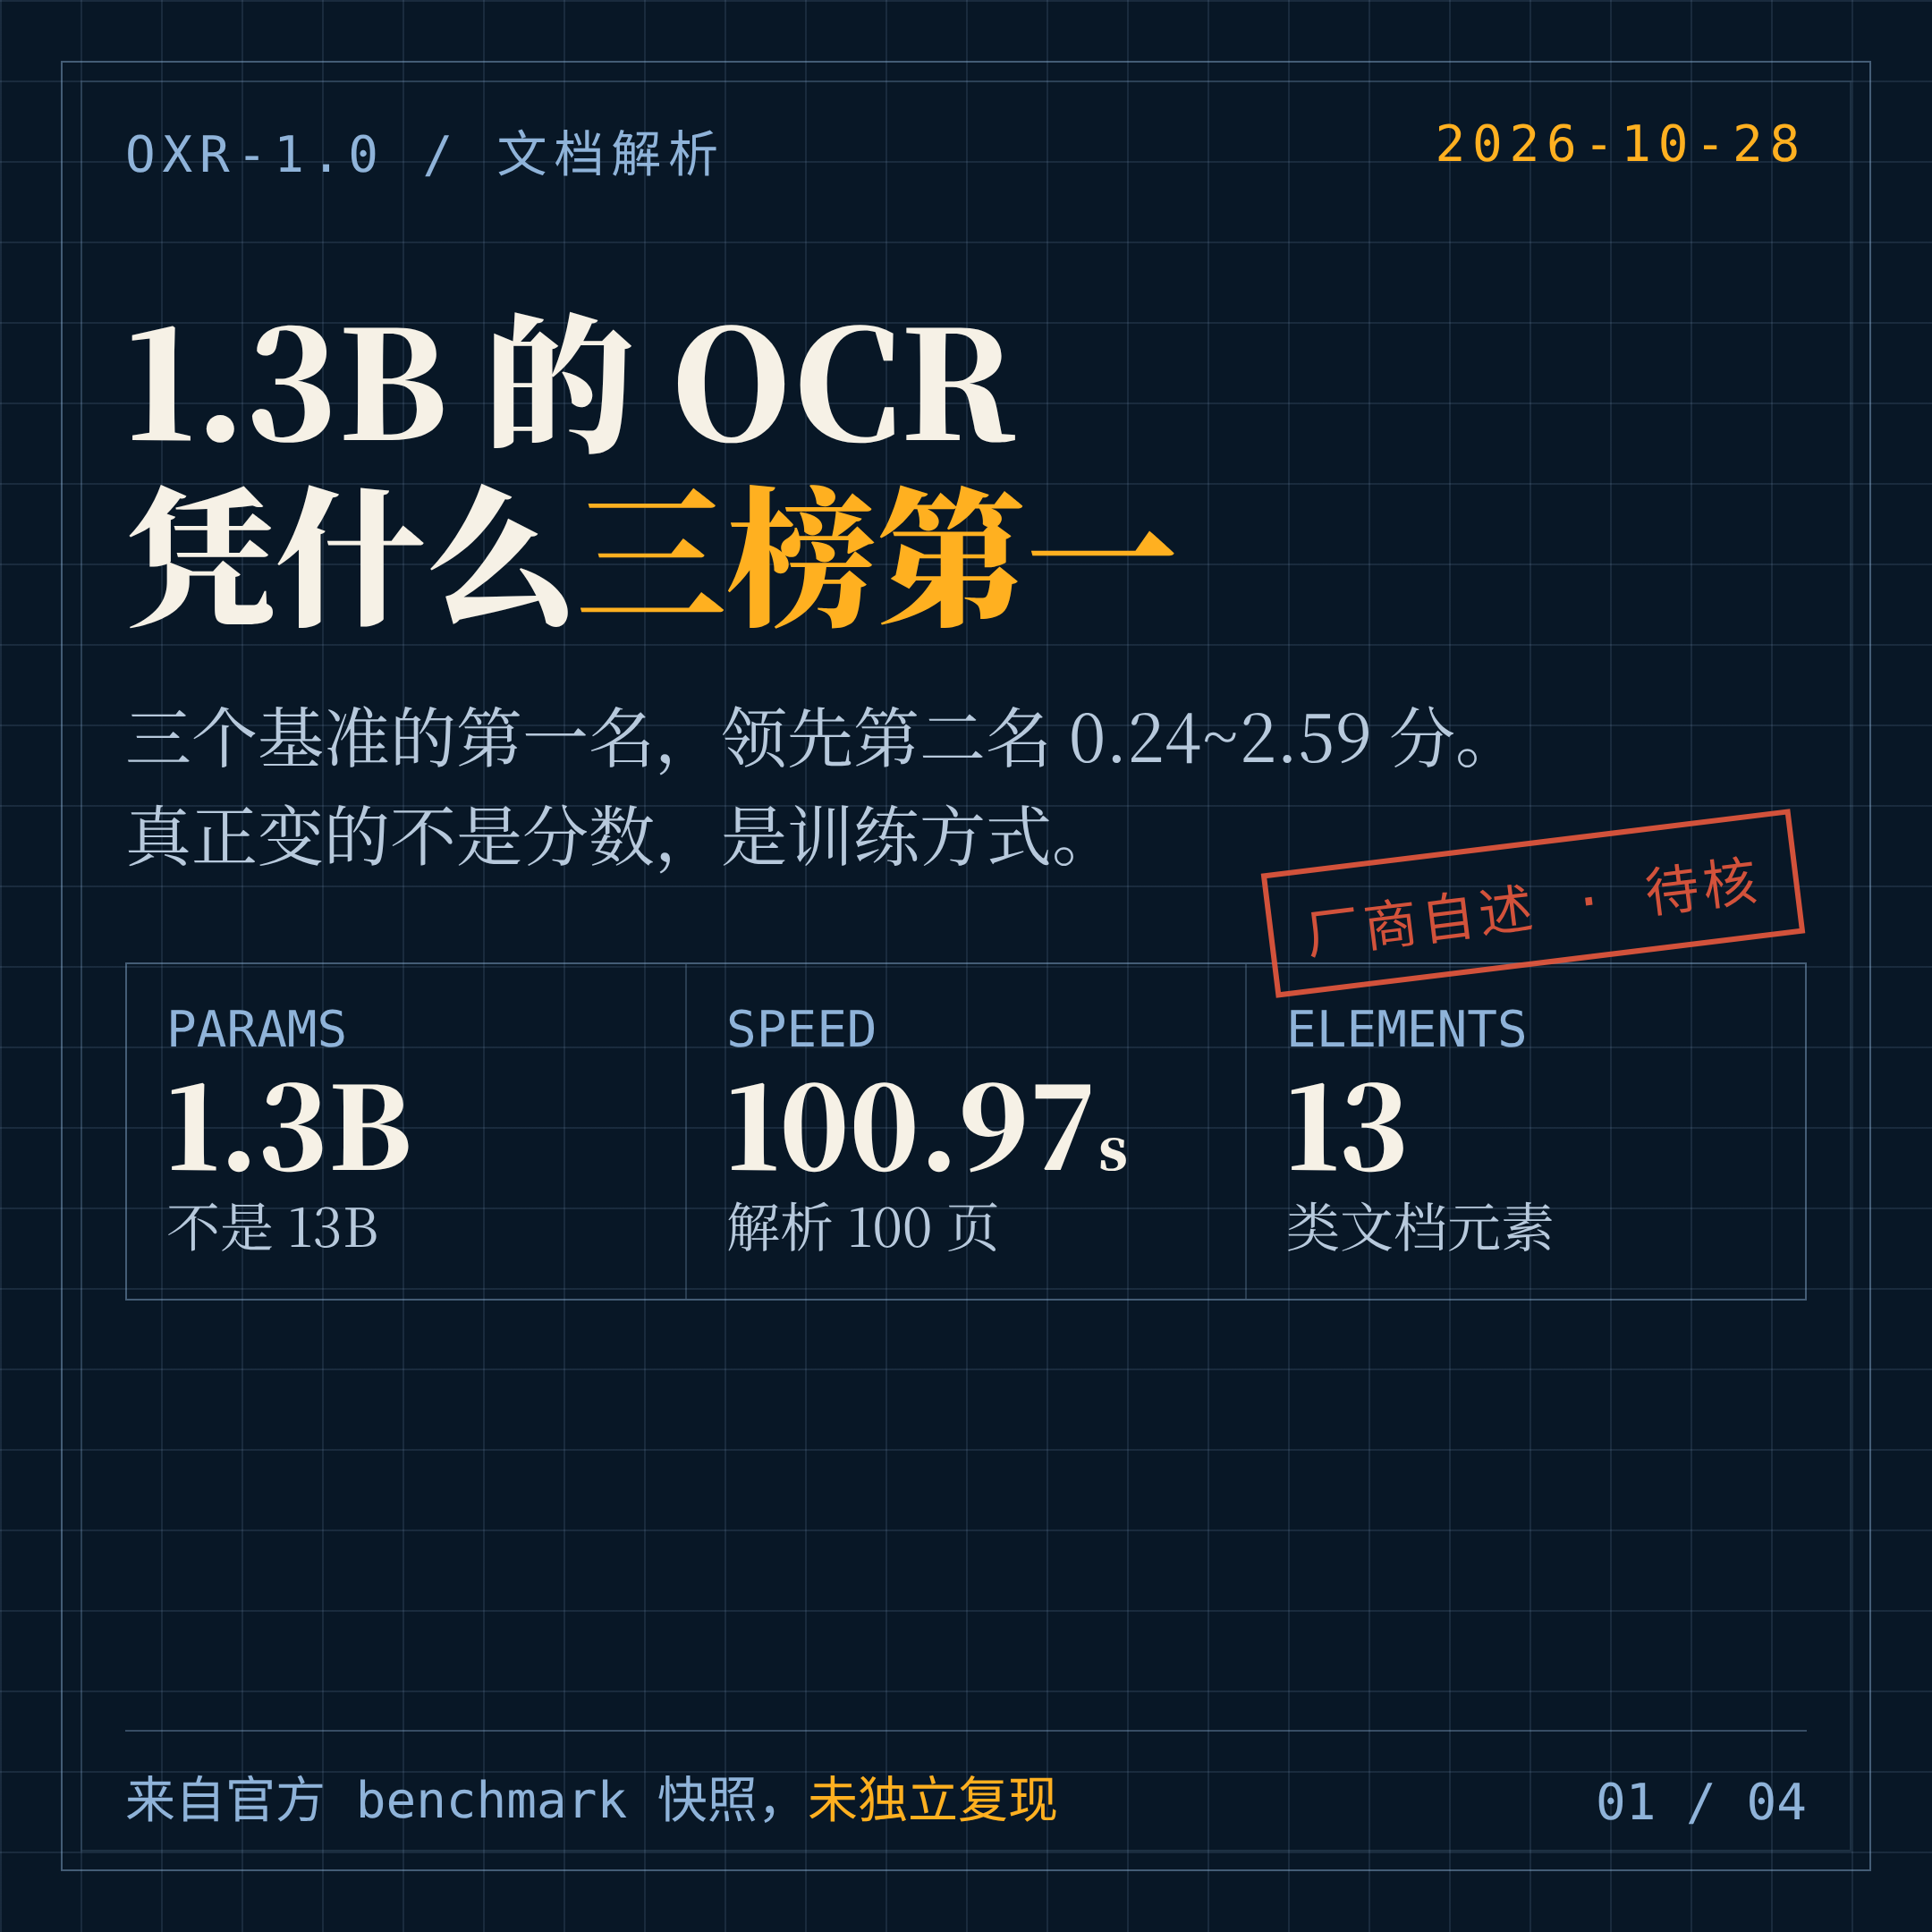
10 月 27 日,SoMark 团队开源了一个文档解析模型 OXR-1.0,参数量 1.3B。
它在三个公开基准上同时排到第一。消息传开的方式很典型:标题写「国产开源登顶全球第一」,评论区开始问「是不是又赢了」。
但这份成绩单里最值得拿走的,不是「第一」,而是它为什么能用一个 1.3B 的模型做到。答案不在模型结构里,在训练数据的生产流程里。
一、先把三个榜摆上桌
三个基准,三个第一,但领先幅度差得很远。
| 基准 | OXR-1.0 | 第二名 | 领先 |
|---|---|---|---|
| OmniDocBench | 97.18 | 96.91(TeleOCR) | 0.27 分 |
| olmOCR-Bench | 87.84 | 87.60(Infinity-Parser2-Pro) | 0.24 分 |
| DocParsingBench | 87.76 | 85.17(PaddleOCR-VL-1.6) | 2.59 分 |
前两个榜的领先只有 0.2 几分,在评测噪声范围内不算压倒性;DocParsingBench 上拉开 2.59 分,才是有意义的差距。
速度那一栏更实在:单张 RTX PRO 6000,解析 100 页用 100.97 秒,官方称比第二名 OvisOCR2 吞吐高 33.5%。测试集是 OmniDocBench 源集分层抽样后冻结的 100 页,清单随仓库一起发布。
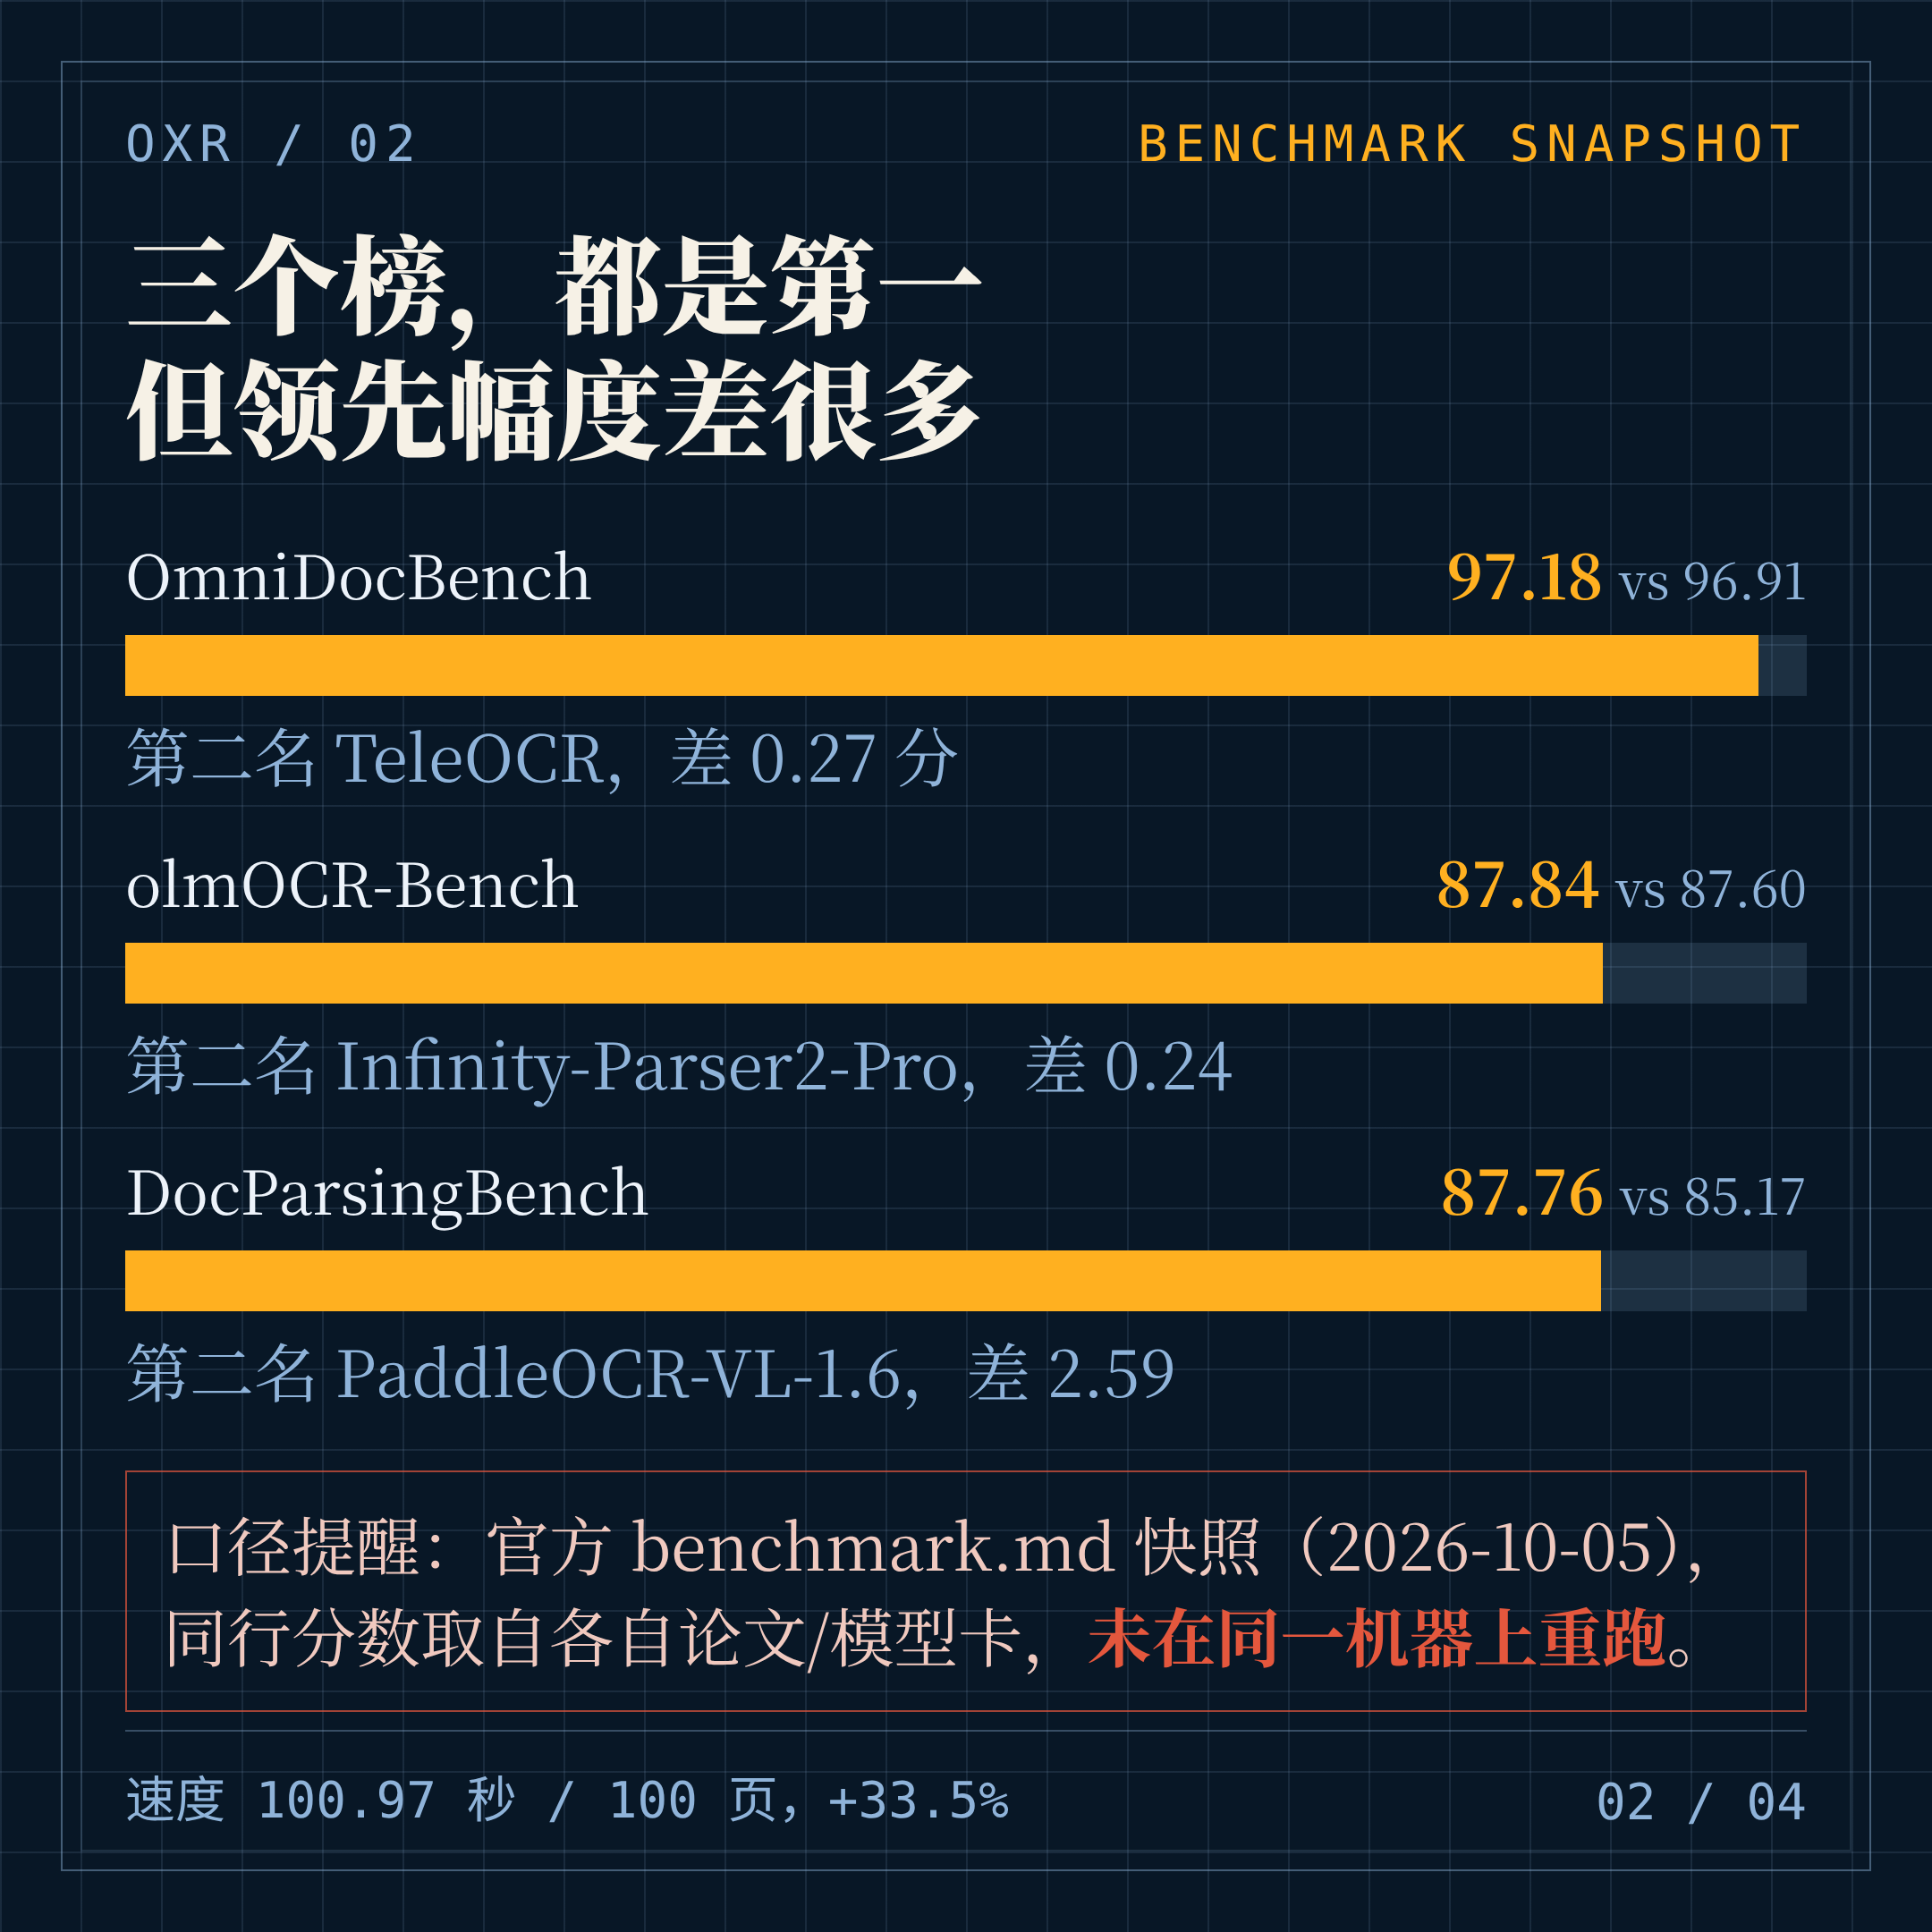
这里要先说清楚一件事:这些分数来自官方 benchmark.md 快照,同行成绩取自各自论文或模型卡,没有在同一台机器上统一重跑。 它证明的是「厂商自述的成绩单长这样」,不是「第三方已复现」。
二、小模型能赢,是因为把「标注」换成了「找错」
文档解析有一个别的任务羡慕不来的性质:每份输入都有客观、确定的标准答案。
一张发票的金额就是那个金额,一个表格的合并单元格就是那样合并。对错可以被机器判定,不需要人来打分。这个性质,决定了它可以跑一种很重的后训练循环。
OXR 管这个叫 RSI(递归自我改进),分三步:
第一步,预测与分类。 先拿海量无标签文档跑一遍解析,再用一个通用 VLM 结合原图、解析结果和评判标准,把样本判成三类:对、错、不确定。
第二步,归因与训练规划。 对判错的样本,让 VLM 逐条写出失败原因——是跨行表格、是手写体、还是公式嵌套。这些自然语言原因经 SigLIP2 提特征后聚类,形成「原因簇」。同一个病因的样本会被放到一起,哪怕它们一个来自财务报表、一个来自化学实验记录。
第三步,数据生成。 原因簇提供结构难点,真实样本池提供版式风格,扰动测试发现的视觉脆弱点被编进合成管线。生成的数据经过校验,再回流训练下一代模型。
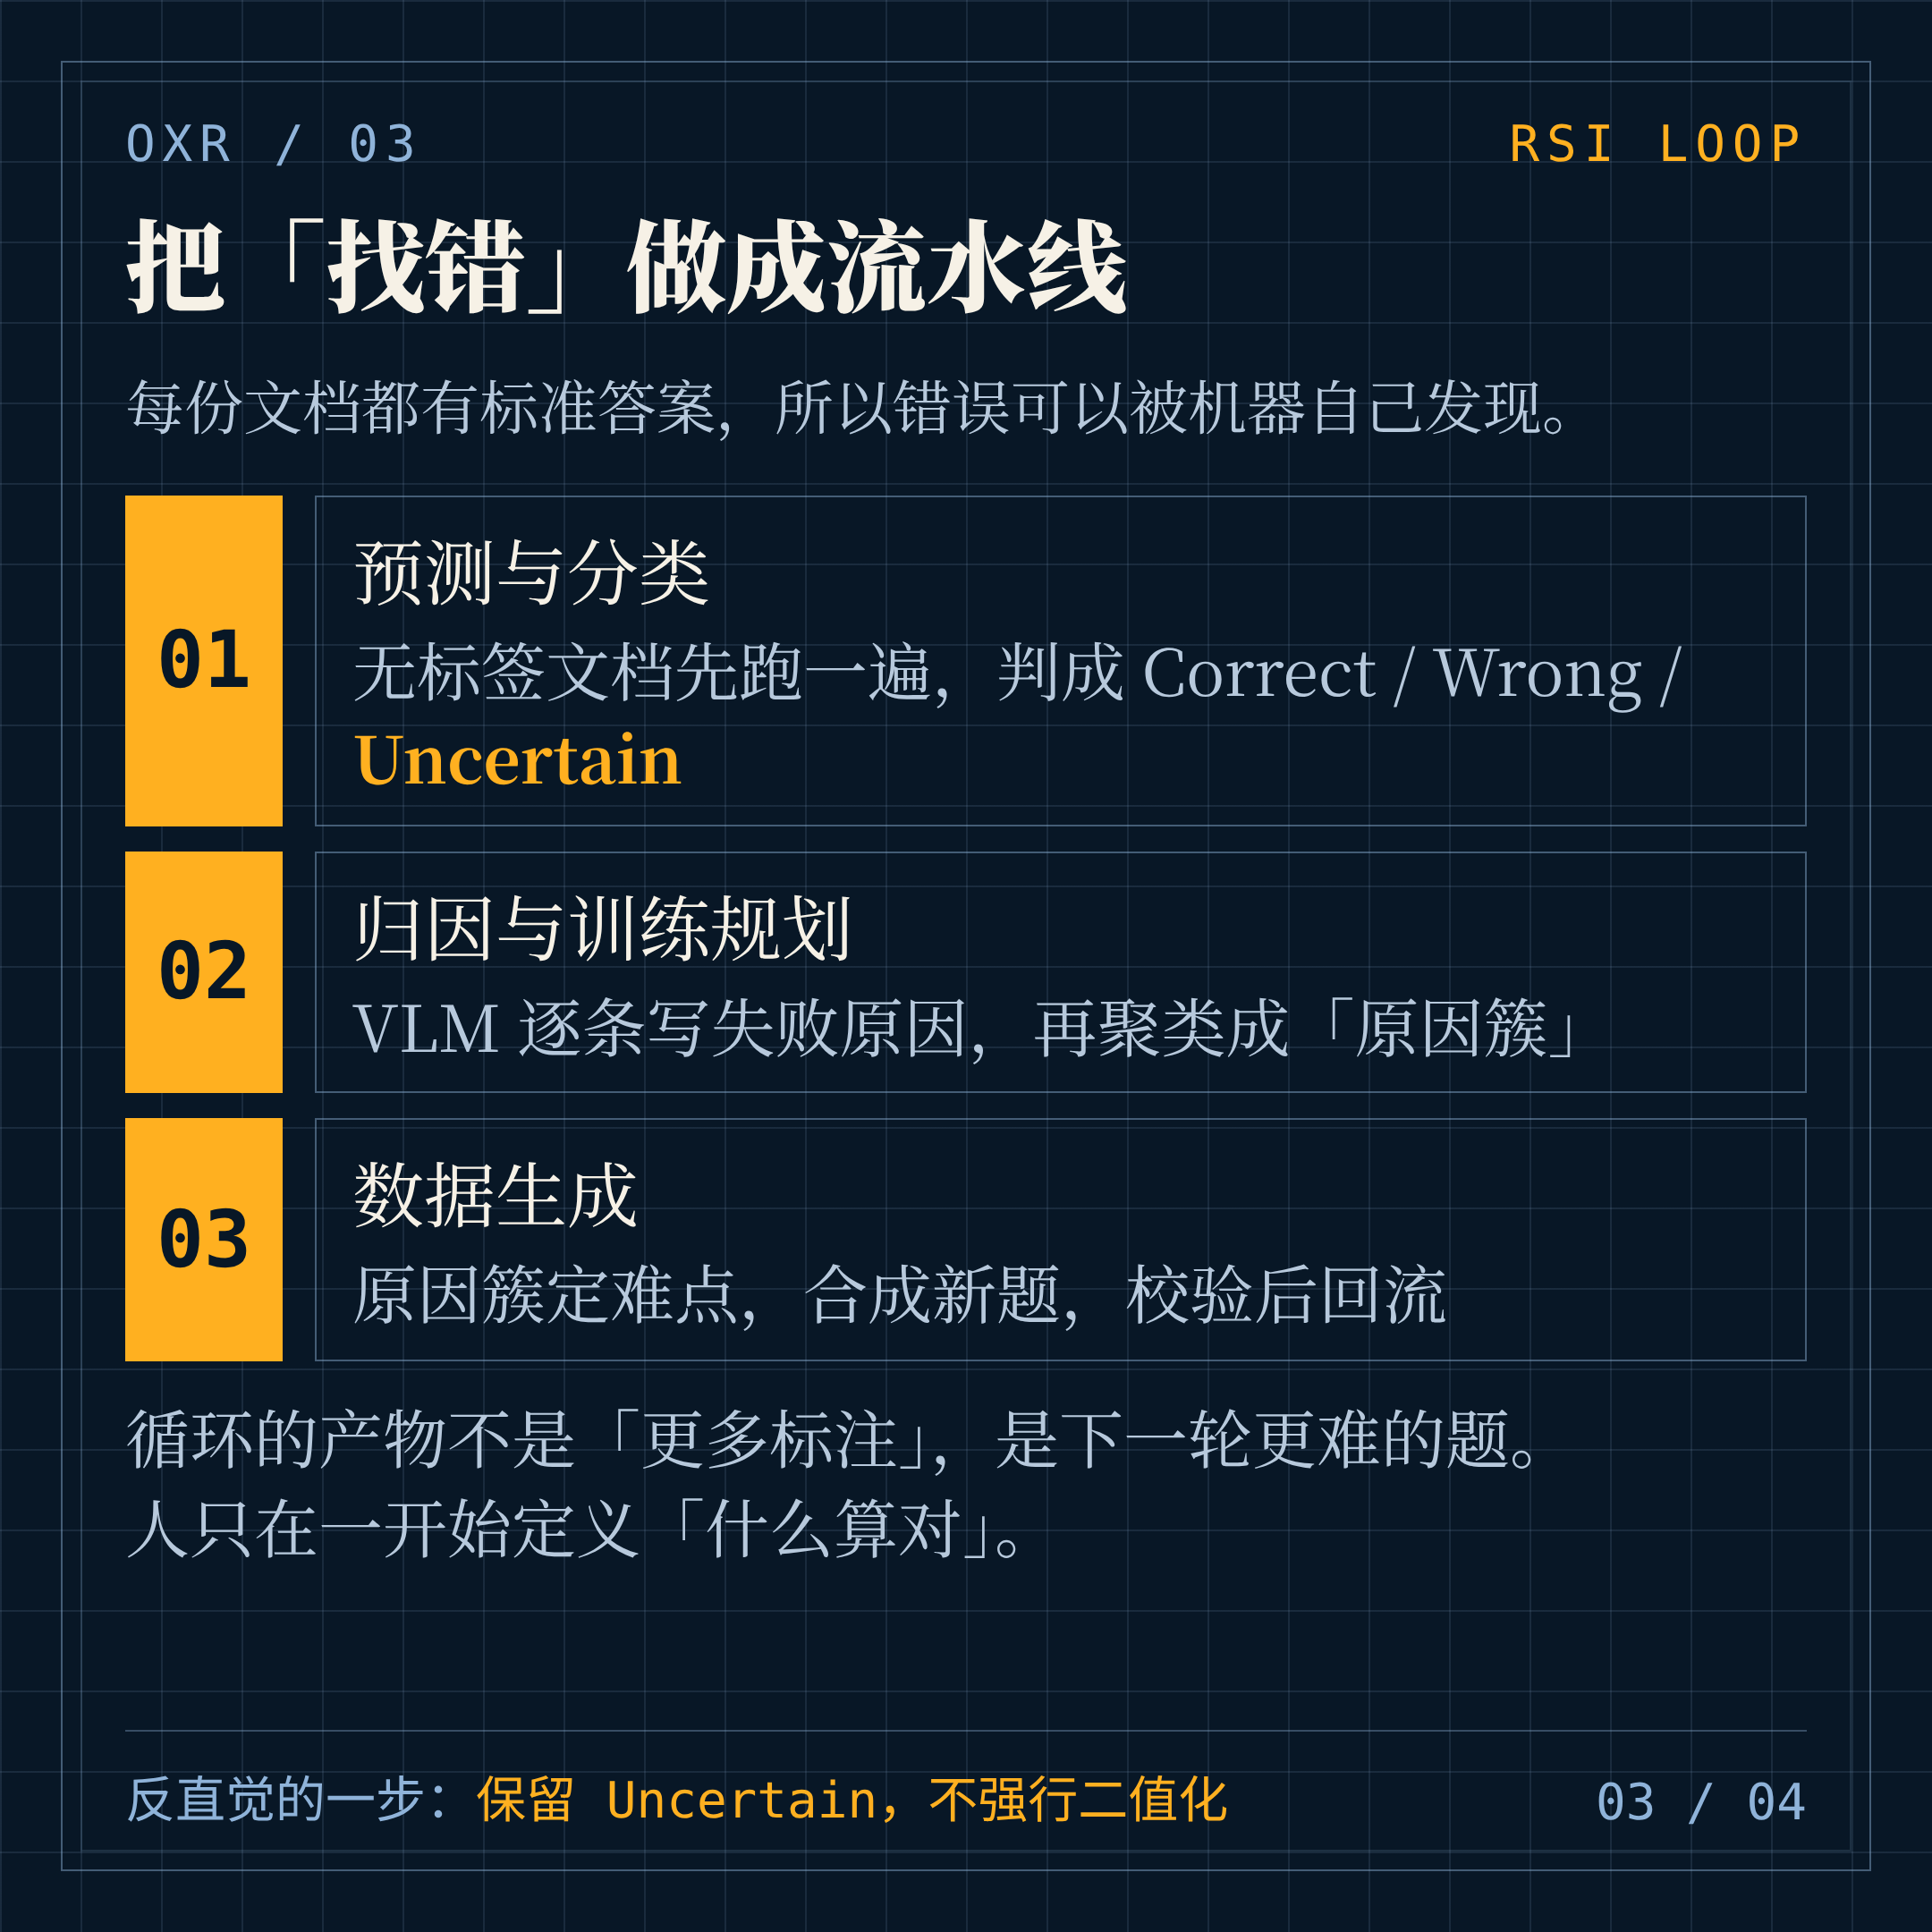
这三步合起来做了一件很具体的事:把数据生产从「人写答案」变成「机器出题 + 机器校验」。
RSI 这个词容易被讲成玄学,好像模型在闭门修炼。这里不是。它更像一条质检流水线:先定义什么叫对,再让流水线自己找出不合格品,分析不合格的原因,然后照着这些原因造更难的题。
三、两个反直觉的工程选择
第一个:保留「不确定」。
分类时最省事的做法是二分类,对或错。但很多样本是「模型自己也不确定」——多次 rollout 结果不一致,或者轻微缩放、压缩、模糊之后答案就变了。硬把它塞进「错」,等于给模型喂了毒标签。
OXR 的做法是把这类样本单独放进 Uncertain:不做二值化,而是当作需要更多证据的区域。扰动测试也被用来定位视觉脆弱点——改一下图像就分歧扩大的地方,就是模型真正的盲区。
第二个:把版面分析拆出去。
多数文档解析模型把版面分析(LA)和阅读顺序(RO)塞进一个小模型里。OXR 反过来:LA 做成独立可插拔的轻量检测服务,主模型只负责识别和阅读顺序。
好处很实际。古籍、医疗单据、特殊票据这些版式,可以换一个私有 LA 模型,后面的识别能力照用;阅读顺序并入主模型后,也省掉了一道额外耗时。
这两个选择都不新鲜,但放在一起说明一件事:它优化的不是单点指标,而是「让这条数据流水线能持续转」的工程条件。
四、这套方法能搬到哪,不能搬到哪
判断标准只有一条:这个任务的「对」能不能被自动判定。
能判定的,就有机会跑类似循环——
- 文档解析:标准答案就是原始结构化内容;
- 代码:编译、测试、类型检查会告诉你对错;
- 数学:Lean 形式化之后,证明可以通过机器检查;
- 表格与数据抽取:字段值可以与源数据逐项对账。
不能自动判定的,硬套就会退化——
- 文案、设计、战略:没有客观判据,只能人来评;
- 「更好的摘要」「更有创意的标题」:连评分标准都不稳定,模型自评只会放大偏好。
所以「RSI 让模型自己变强」这句话,边界比听起来窄得多。它真正成立的地方,是那些错误可以被廉价、可靠地发现的任务。文档解析恰好是其中之一,而且是一块很大的之一。
五、先看边界,再谈第一
如果你想把 OXR 放进自己的工作流,先看这几条:
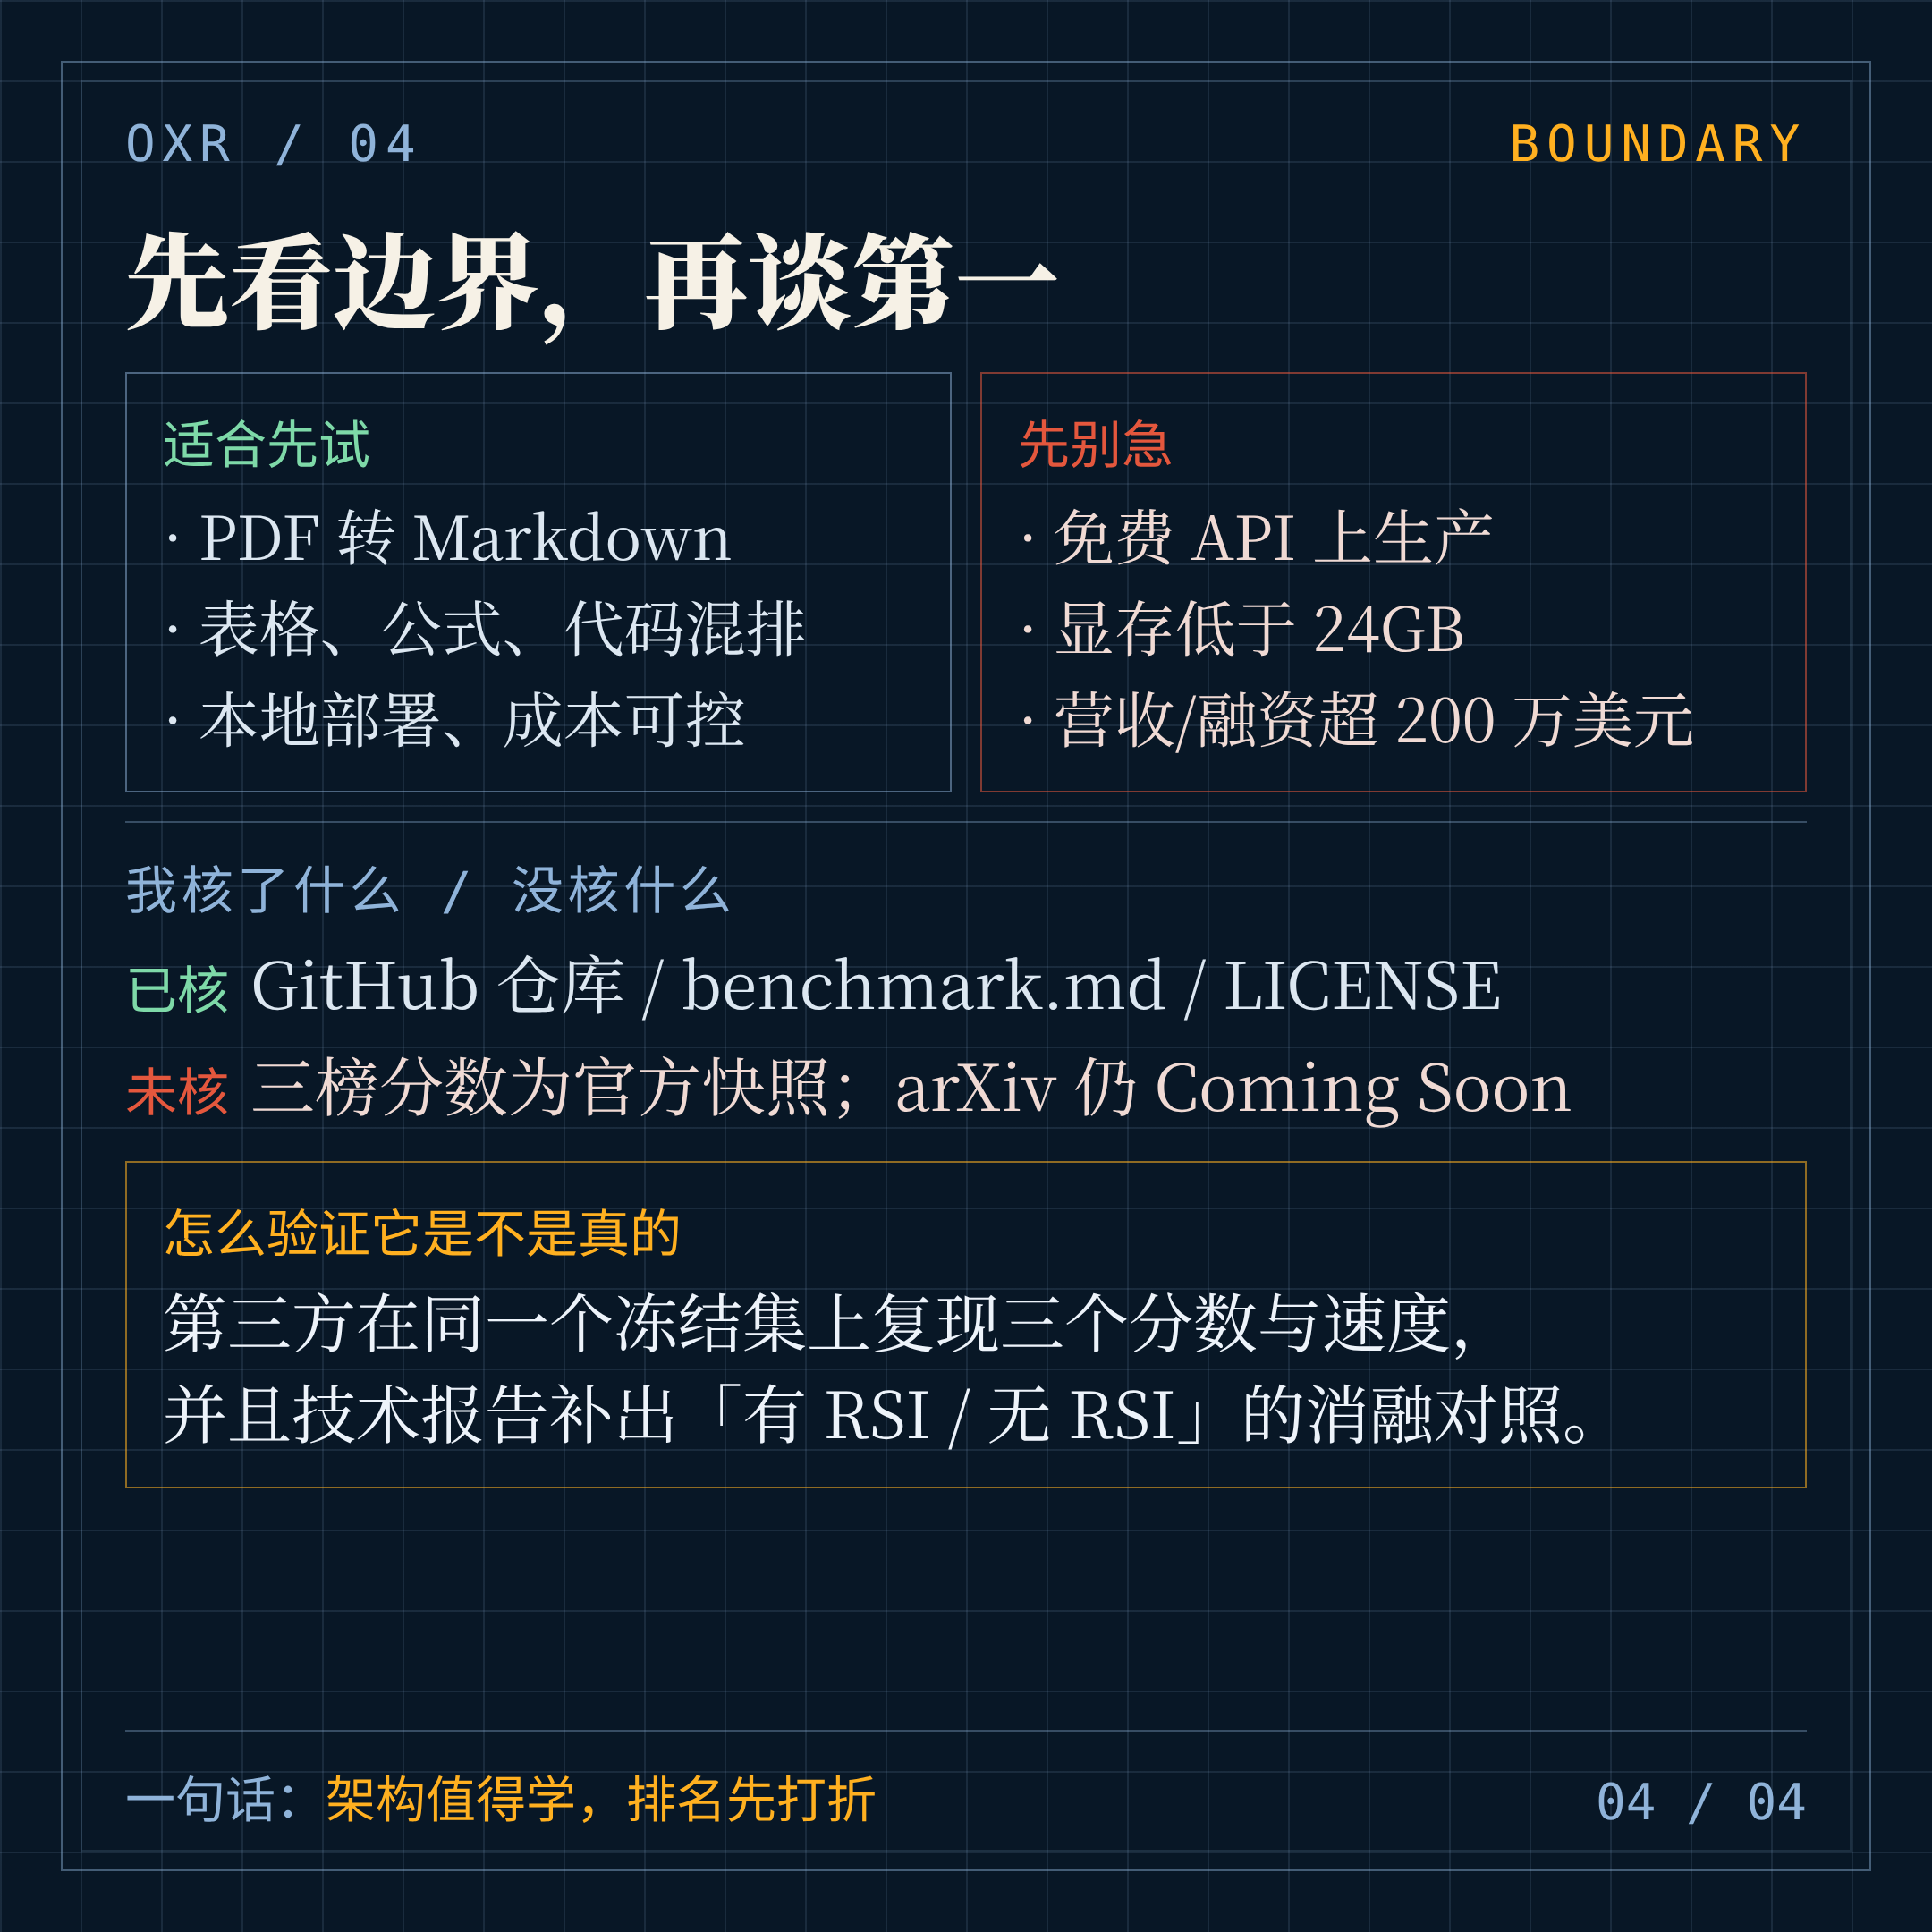
硬件。 本地部署 24GB 显存起步,官方推荐 48GB 以上。它不是那种能在笔记本上随手跑的小工具。
免费 API。 官方提供免注册的免费接口,但同时明确说不建议生产使用——要排队,不保证稳定。适合先验证效果,不适合直接接业务。
许可证。 LICENSE 是 Apache 2.0 加附加条款:公司及关联方合并口径下,融资不超过 200 万美元、营收不超过 200 万美元,才可以免费商用,超出需要商业许可。这一点原文报道没有提,但会直接影响能不能用。
论文。 仓库里的 arXiv 标记仍是 Coming Soon,没有技术报告可查。也就是说,「RSI 贡献了多少、数据规模贡献了多少」这个最关键的消融问题,目前无法回答。
那这份成绩单该怎么读?
我的读法是:架构和训练范式值得学,排名先打折。 一个 1.3B 模型能在三个榜上排到前面,至少说明小模型加高质量数据在这类任务上没有天花板问题;但「第一」能不能站住,要等第三方在同一个冻结集上复现,以及技术报告补出有 RSI / 无 RSI 的对照。
六、真正的信号
把这条新闻放回今年的上下文里,会看到一个更清楚的方向。
上半年大家比的是长文档、无限视野、吞吐;现在开始比「数据怎么自己长出来」。百度 Unlimited OCR 2 用无限视野解决「一页装不下」的问题,OXR 用 RSI 解决「标注不够」的问题,路线不同,但都在回答同一个问题:当公开数据被吃完之后,训练数据从哪里来。
对做产品的人,这件事的启发不在「要不要换 OCR」,而在评估一个模型时多看一层:它有没有把「错」变成可以回收的燃料。
榜单会变,这套流程会留下。
来源与相关
- 量子位报道:《RSI 立大功!国产开源登顶全球第一,1.3B OXR 重塑 OCR》
- 开源仓库:SoMarkAI/OXR(Apache 2.0 + 附加条款,stars 数据截至 2026-10-28)
- 站内相关: